VLA 대화 정리 2
VLA 대화 정리 2 · 음성 세션

굴착기의 머리는
누가 맡을까

범용 LLM이 로봇에 내려온 방식, 세 층 구조, 후보 비교, 안전과 영상 데이터

2026.11.15
이한민 · hmlee@kimm.re.kr
01

전체 흐름

큰 모델은 손이 아니라 머리 · 어디에 앉히고 무엇으로 검증할지
01큰 모델기능을 골라 부르는 머리 · 입출력과 한계
02세 층숙고 · 직관 · 반사
03후보세 쌍 · Molmo · 비교 실험
04안전거르는 층 · RL로 다듬기
05영상CCTV에서 행동 얻기
02

3분 요약 영상

손그림으로 보는 머리 · 몸 · 반사 · 소리 있음
03

1. Gemini Robotics 2의 구성

실제로 쓸 수 있는 건 ER 2뿐 · 아래층은 우리 것을 붙인다
Gemini Robotics 2 · 2026.7.30 발표ER 2체화 추론 모델무엇을 할지 정한다연속 영상으로 진행 추적API로 공개VLA행동 모델어떻게 움직일지 만든다탁상 양팔 → 전신으로협력사만온디바이스로봇 안에서 도는 VLA통신 없이 실행새 양팔 로봇에 빠른 적응신뢰 테스터만ER 2 = Gemini 3.5 Flash 기반 · 지연에 민감한 로봇용 스트리밍 모델이 따로 있음역할 분담은 1.5세대부터: ER이 무엇을, VLA가 어떻게
온디바이스 모델 카드: 주된 평가는 서 있는 양팔 조작, 학습 분포 밖과 고자유도 제어에는 한계
04

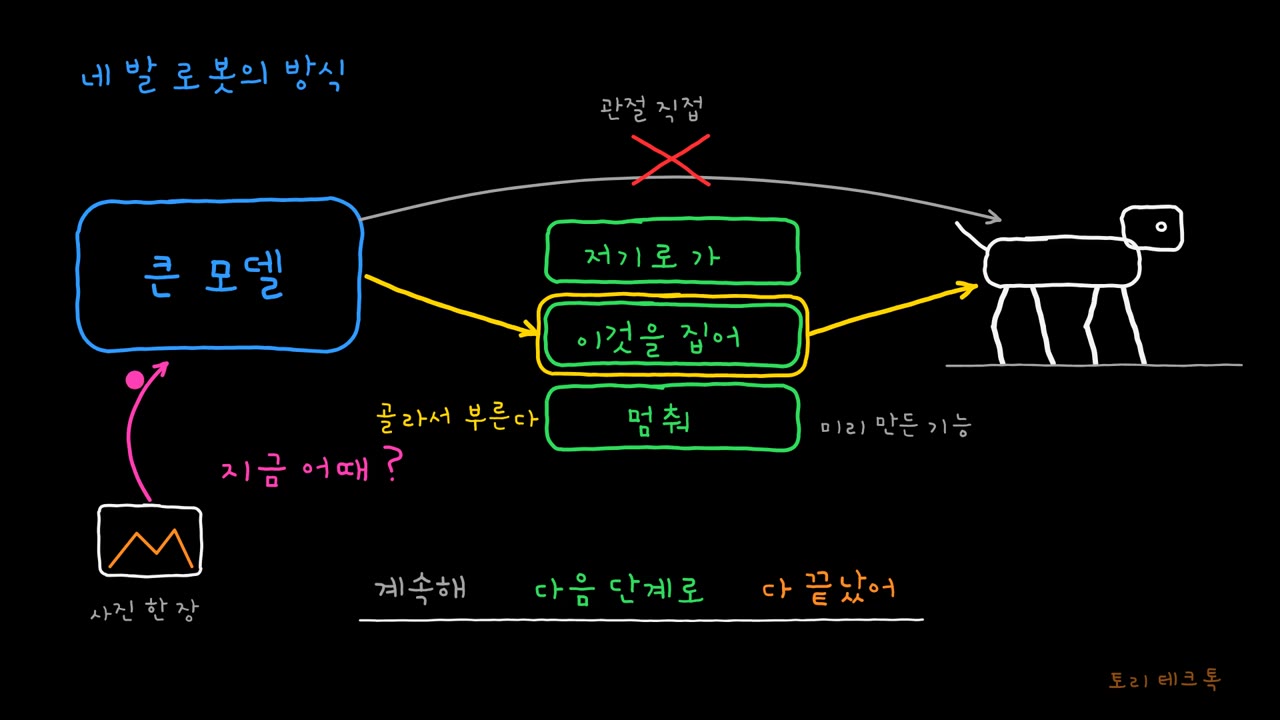
2. 네 발 로봇에서 쓰는 방식

관절을 움직이지 않고 미리 만든 기능을 골라 부른다
05

3. 묻고 답하는 루프

ER 2가 스스로 깨닫는 게 아니라 우리가 주기적으로 묻는다
로봇센서 · SDK · 제어기ER 2 스트리밍웹소켓 세션 유지출력은 글뿐JPEG 초당 1장 이하 · 음성 16 kHz · 글tool_call · 기능 이름과 인자tool_response · 실행 결과주기적으로 묻기(하트비트)의 답 세 가지ack잘 진행 중 · 계속run_instruction이 단계 끝 · 다음 단계로reset목표 달성 · 사용자에게 알림물리 동작은 BLOCKING으로사진만 보내면 추론이 시작되지 않음묻는 도중 또 물으면 취소됨
권고: 날것의 관절 제어를 도구로 노출하지 말 것 · 각 도구가 입력 범위, 타임아웃, 작업 영역, 안전 전제 조건을 스스로 강제
06

4. 영상을 이해한다는 것

이미지 여러 장에 세 가지가 얹힌다
시간 표시몇 번째 프레임인지 붙인다시공간 압축연속 프레임의 같은 자리를 한 토큰으로스트리밍본 것은 캐시에 두고 새 프레임만t1t2t31258 토큰 / 프레임저해상도 설정은 66캐시(다시 계산 안 함)과거만 보는 한 방향 어텐션오래된 프레임은 뒤에서 버림바탕은 "이미지 여러 장" · 미세한 변화는 압축에서 뭉개진다 → 빠른 일은 아래층이
ER 2 내부 구조는 공개되지 않음 · 프레임 묶음 안은 양방향, 묶음 사이는 한 방향으로 두는 절충이 흔함
07

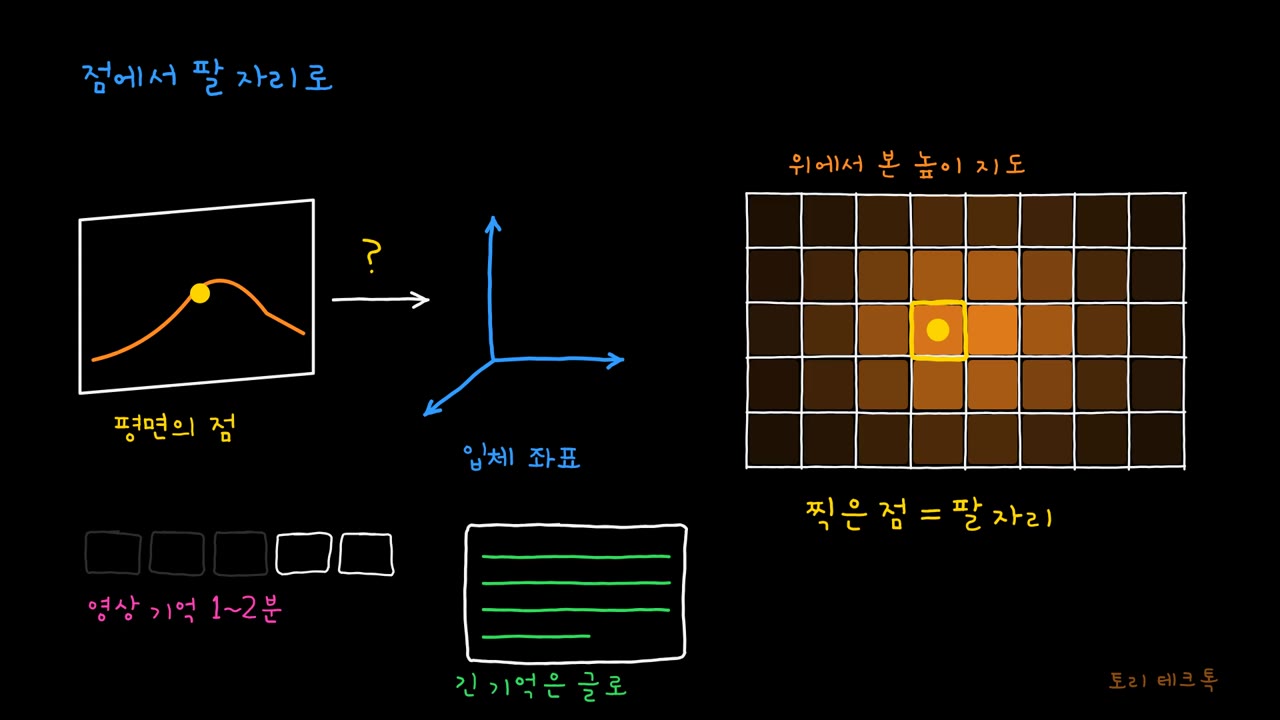
5. 토큰으로 본 기억의 길이

영상은 지금 이 순간을 보는 눈 · 긴 기억은 글로 관리한다
프레임 한 장258 토큰768 타일 하나
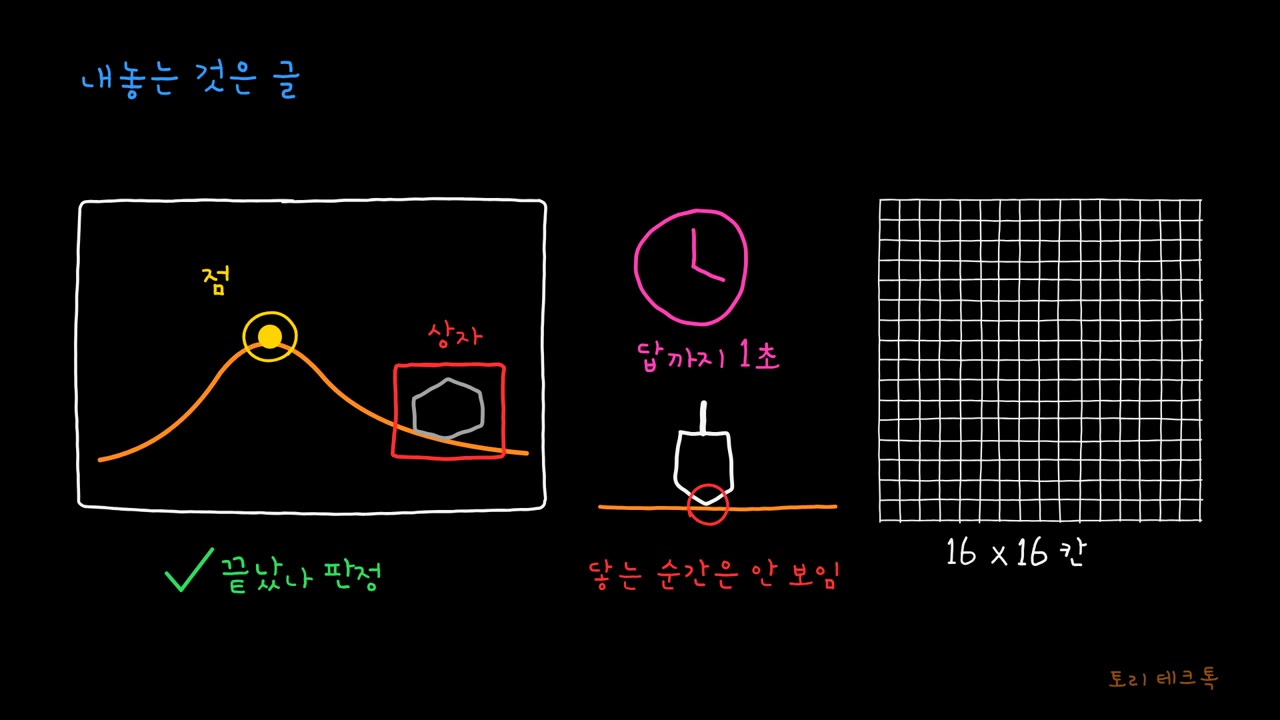
약 16×16 칸으로 본다
영상 1초약 300초당 1프레임 + 음성
1분이면 1.8만 토큰
스트리밍 영상 세션2분압축 없이 쓸 때 기본 한도
문맥 창이 작게 잡힘
길게 쓰려면슬라이딩문턱에 닿으면 오래된 토큰을 버림
남길 양을 직접 정함
굴착 한 사이클 15초 ≈ 4,500 토큰 · 사이클마다 "3번 칸 40 cm 완료, 남은 구역 2개" 같은 한 줄을 글로 넣는다
08

6. 내놓는 것은 글

점 · 상자 · 판정 · 기능 호출까지 · 궤적은 거친 힌트
09

7. 평면의 점을 팔 자리로

위에서 본 높이 지도를 보여 주면 찍은 점이 곧 격자 좌표
10

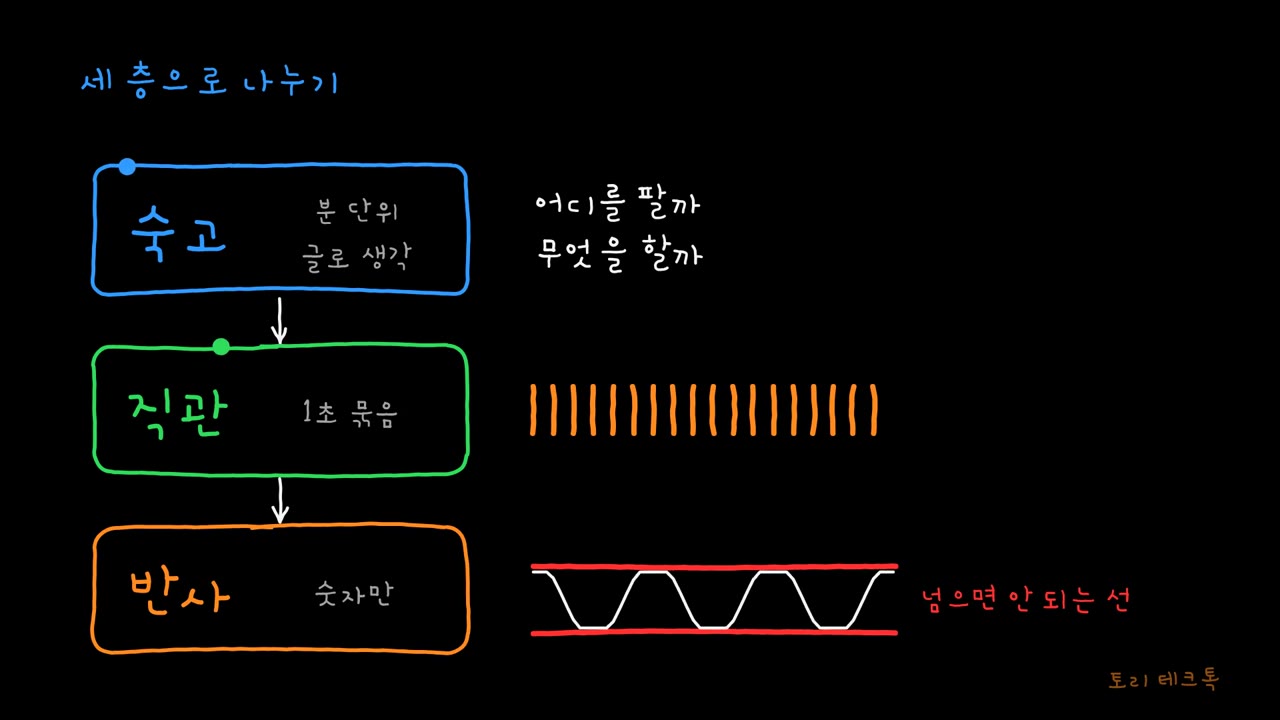
8. 숙고 · 직관 · 반사

VLA 전체가 직관 층 · 숙고는 그 위에 따로 있어야 한다
11

9. VLA 안의 VLM과 숙고 층은 왜 둘 다 필요한가

겹쳐 보이지만 크기와 시간 축이 다르다
VLA 안의 VLM숙고 층 (ER · 큰 모델)
크기2~3B · 행동 주기에 묶임몇 배 큼 · 생각하기 모드
보는 시간현재 프레임 한두 장최근 영상 + 글로 된 기록
파인튜닝 뒤굴착 특화 인코더로 변함세상 지식을 유지
말하기지시를 받기만 함되묻고, 멈춘 이유를 설명
내다보는 범위한 묶음, 몇 초사이클 여러 개, 분 단위
GR00T N1.7의 "System 2"는 속도 구분도 숙고도 아닌 지각 모듈 · 굴착처럼 반복 작업이면 숙고 층의 몫이 작을 수 있다 → 실험으로 확인
12

10. 위층과 아래층의 세 쌍

오픈 두 쌍은 파인튜닝과 현장 배치가 된다
구글숙고Gemini Robotics-ER 2API · 파인튜닝 불가직관Gemini Robotics VLA협력사만VLA를 못 받아 섞어 써야 함엔비디아숙고Cosmos Reason (큰 버전)오픈직관GR00T N1.7오픈 · 3B전부 오픈 · 같은 계열Ai2숙고Molmo 2-ER오픈 · Apache 2.0직관MolmoAct2오픈전부 오픈 · 같은 뇌를 공유
그 밖: RoboBrain, Embodied R1, Robix 등 · 범용 GPT·Claude에 좌표를 찍게 하는 방식은 전용 모델에 밀림
13

11. Molmo 2-ER

어디를 찍어라에 강하고, 열린 질문에 글로 답하는 데는 큰 모델에 밀린다
크기4.85B현장 PC 한 대에서 실행
Apache 2.0
13개 벤치마크 평균63.8ER 1.5 Thinking 61.3
GPT-5 57.9
학습 데이터330만포인팅 · 미터 단위 공간
자기 기준 좌표계
약한 곳 (ERQA)46.8GPT-5 59.0
ER 1.5 Thinking 54.8
ER 2와의 직접 비교는 아님 · 스트리밍·도구 호출 루프는 직접 짜야 할 가능성이 큼
14

12. 특화 후 복습

처음부터 섞는 것보다 먼저 세게, 나중에 짧게
1단계 · 특화체화 데이터만 · 2만 스텝2단계 · 복습50 : 50 · 1,500 스텝새 능력범용 능력굴착기에 옮기면1단계 · 굴착 영상에 공격점 · 깊이 · 흙 상태를 붙인 데이터로 세게2단계 · 원래 학습 데이터를 반반 섞어 짧게 → 굴착도 알고 세상도 아는 위층
파인튜닝하면 세상 지식이 깎이는 문제의 해법 · 비율과 스텝 수가 공개돼 있음
15

13. MolmoAct2의 깊이 토큰

굴착 장면은 버킷 근처 몇 칸만 바뀐다 · 지형 정보가 들어갈 자리가 이미 있다
깊이 토큰 10 × 10바뀐 칸만 새로 계산앞 프레임과 유사도 0.996 미만칸마다128가지코드 중 하나 (VQ)행동 전에글자처럼 생성층별 게이트가쓰는 양을 학습라이다 높이맵추정 대신 측정값을그 자리에 넣는다네 번째 주입 방식한 칸이 수십 cm로 거침
게이트 값을 읽으면 어느 층이 지형을 얼마나 쓰는지 숫자로 나옴 · 정밀한 지형은 점군으로 따로 주는 조합
16

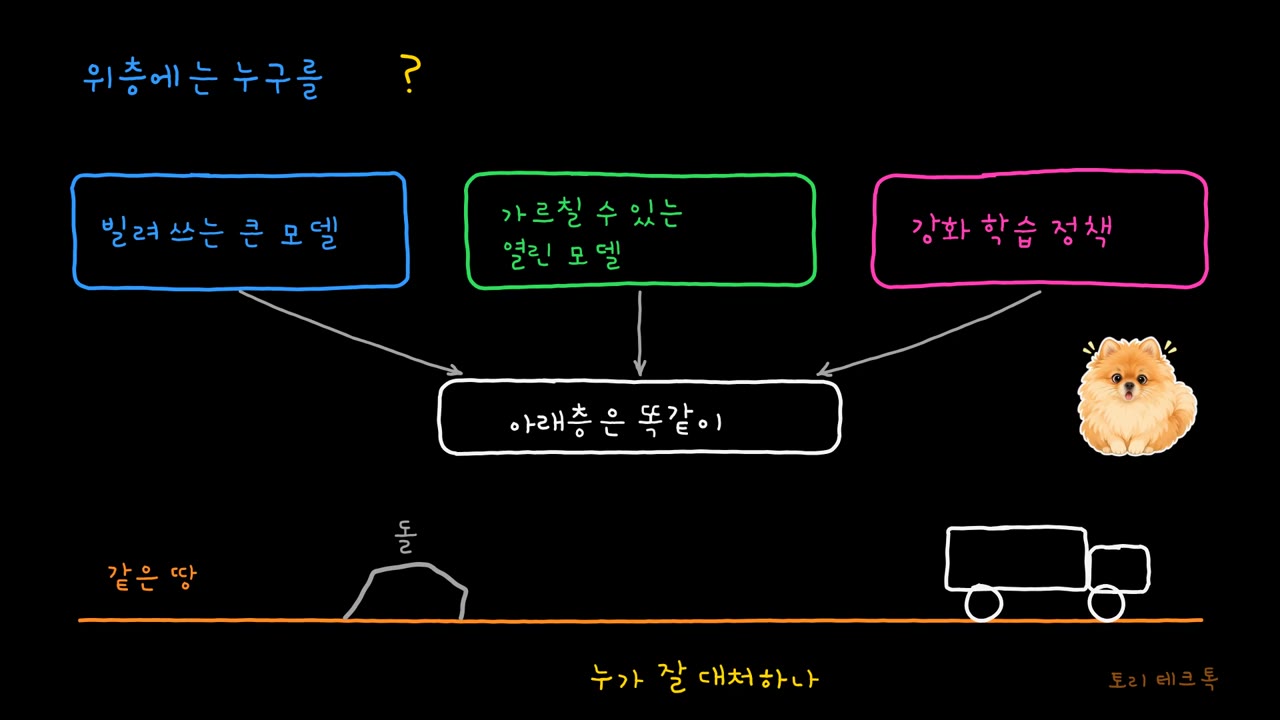
14. 위층만 바꿔 가며 같은 땅을

승부처는 처음 보는 상황에서의 복구
17

15. 비교 실험 설계

질문은 하나: 굴착기에 숙고 층이 필요한가
직관 층 고정 · 같은 VLA, 같은 도구 집합, 같은 묻는 주기A위층 없음지시문 하나로 VLA만BRL 정책사이클마다 공격점·깊이CER 2프롬프트로만 굴착 지식DMolmo 2-ER파인튜닝 전과 후E후보 + 심판고르는 일만 제브에게지표목표 지형 오차사이클당 굴착량지시 따르기교란 뒤 복구율공정성Molmo도 파인튜닝 없는 조건지연을 뺀 실험과 넣은 실험모두 같은 함수를 부르게둘째 층: 위층을 고정하고 GR00T · π0.5 · MolmoAct2를 같은 굴착 데이터로 비교
18

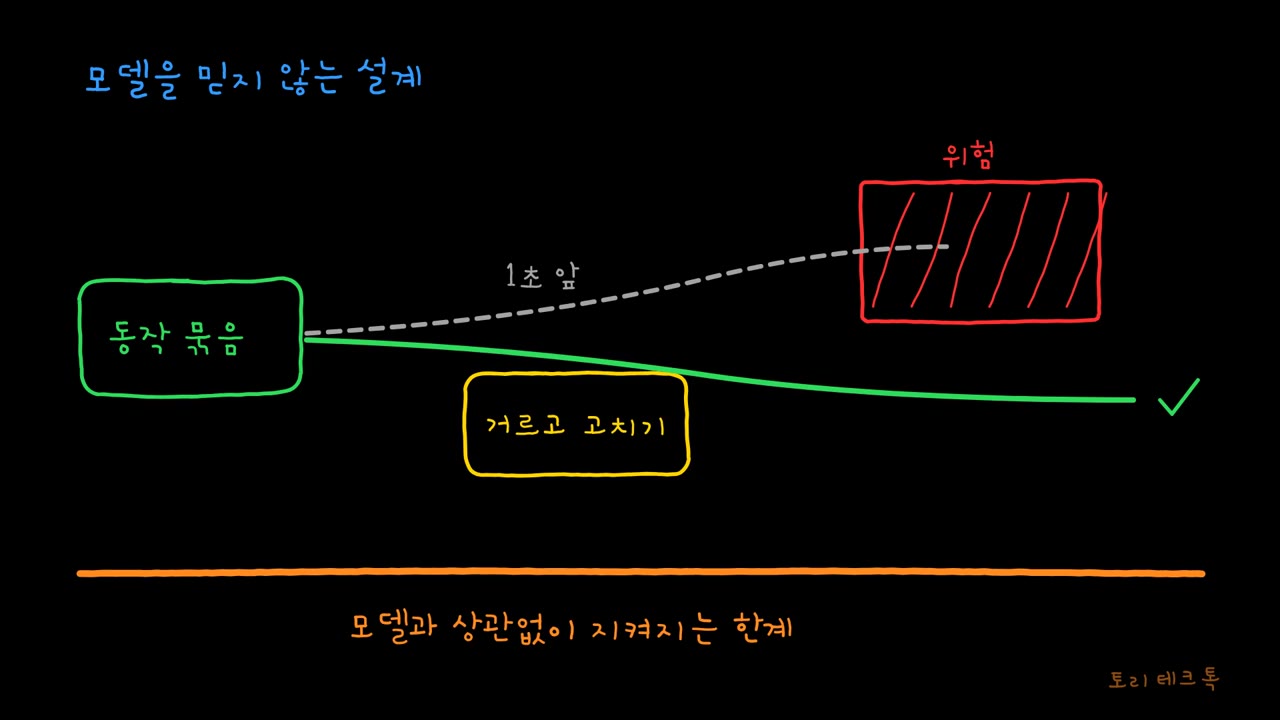
16. 모델을 믿지 않는 설계

1초 묶음은 미리 볼 구간을 준다 · 걸러서 최소한만 고친다
19

17. 실장비 전 검증 세 단계

필터 개입 횟수가 기준 아래로 내려가면 단계적으로 푼다
01나쁜 묶음 넣기시뮬레이터에서 VLA 출력에 노이즈·엉뚱한 방향
필터가 다 잡는지 확인
02섀도 모드사람이나 기존 정책이 운전
VLA는 출력만, 필터에 걸린 횟수 기록
03제한 권한 투입속도 상한 절반, 좁은 작업 영역에서 시작
점차 확대
논문 자리: VLA 묶음에 대한 MPC 안전 필터, 흙 반력 불확실성 고려 · 지형 월드 모델로 반력을 예측해 필터에 넣는 안
20

18. 강화학습으로 VLA 다듬기

데이터가 적은 분야에서는 모방만으로 성공률이 안 오른다
A온라인 RLπ-RL · SimpleVLA-RL
시뮬레이터에서 박힘·튐을 보상으로
B선호로 다듬기FlowPRO · 보상 설계 없음
조종사가 개입해 고친 것이 곧 데이터
C월드 모델 안에서WoVR · RLinf
지형 예측기를 빠른 시뮬레이터로
주의: 보상만 쫓으면 지시 따르기가 무너짐 → VLM은 얼리고 행동 쪽만, 또는 원래 데이터를 섞어서
21

19. 행동 압축과 월드 모델 결합

굴착기에 현실적인 건 후보를 내고 미리 돌려 고르기
압축FAST 토큰궤적을 주파수로 바꿔 압축(JPEG와 같은 원리)
급한 동작은 잘려 나갈 수 있음
고르기후보 3~5개 평가지형 예측기로 결과 지형·압력을 예측
좋은 것 고르기와 위험 거르기를 한 번에
예측다음 장면을 그리는 VLA연구 흐름의 중심
범용 영상 예측은 흙에 약함
요즘은 VLM이 FAST 토큰으로 행동을 배우고, 실제 출력은 플로우 매칭이 내는 구조가 주류 (π0.5 · MolmoAct2)
22

20. 영상에서 행동까지: 파이프라인

CCTV에서 배우는 건 동작 리듬과 작업 순서
01사이클 자르기ER 모델로 구간 나누고 지시문 붙이기
02관절 뽑기키포인트로 잡고 모델 피팅으로 다듬기
03행동 라벨다음 관절값을 행동으로
04지형비워 두거나 단안 깊이로 거칠게
05사전학습그 뒤 우리 데이터로 파인튜닝
키포인트 검출기는 시뮬레이터 렌더링으로 학습 데이터를 만든다 · 관절각 오차 몇 도, 버킷 끝 수십 cm 수준을 기대
23

21. 단계마다의 선택지

논문 질문: CCTV 사전학습이 적은 데이터에서 성능을 올리는가
행동세 가지 라벨다음 관절값(기본) · 역동역학 모델
잠재 행동 LAPA(보조)
지형입력을 맞추는 법높이맵 자리를 비우고 섞어 학습(권장)
단안 깊이 · 담긴 흙의 양으로 가중
검증데이터 곡선우리 데이터 10 · 30 · 100%
사전학습 있음과 없음 비교
역동역학 모델은 CCTV 영상이 우리 데이터보다 수십 배 많아야 값어치가 있음 · 레버 대신 실린더 속도처럼 기종 중립적인 양으로
24

다음 걸음

뽑힌 논문 주제 다섯
01숙고 층이 필요한가위층만 바꾸는 비교 실험
02지형 정보 넣기깊이 토큰 자리까지 네 방식
03안전 필터흙 반력 불확실성을 고려
04RL로 다듬기시뮬레이터 + 조종사 개입
05CCTV 사전학습적은 데이터에서의 효과
25

출처

음성 대화 중 검색으로 확인한 자료 · 수치는 원문 재확인 필요

Gemini Robotics 2 · ER 2
Google DeepMind 발표(2026.7.30) · 개발자 문서의 스트리밍·Live API 안내

스팟 데모
구글 공개 샘플 저장소 · 에이전트 서버, 도구 선언, 임바디먼트 어댑터

토큰 수치
Gemini 문서 · 프레임 258 토큰, Live API 세션 한도와 압축 설정

MolmoAct2 · Molmo 2-ER
Ai2 논문과 공개 가중치 · 특화 후 복습, OpenFAST, MolmoThink

RL 다듬기
π-RL · SimpleVLA-RL(ICLR 2026) · FlowPRO · WoVR / RLinf

행동 압축
FAST · 주파수 변환 + 바이트 쌍 인코딩

영상에서 행동
VPT(역동역학 모델) · LAPA(잠재 행동) · Depth Anything

앞선 정리
VLA, 구조에서 굴착기 적용까지 (2026.11.14)

링크는 이 덱에 옮기지 못함 · 제브(결정 전용 모델)는 10월 대화에서 다룬 내용을 그대로 인용
26