Baidu 자율굴착 논문 핵심 분석 2019-2024
Baidu 자율굴착 논문 핵심 분석 2019-2024
[!abstract] 문서 목적 Baidu 폴더의 연구 논문 20편을 기존 정리본의 정보 밀도에 맞춰 다시 분석했다. 각 논문은 대표그림 - 요약 - 방법 - 토의 순서로 정리했으며, 방법은 실제 재현에 필요한 입력·전처리·모델/알고리즘·학습/계획/제어·평가 절차를 중심으로 썼다.
[!tip] 읽는 법 - 대표그림은 결과 화면보다 시스템·모델·알고리즘의 내부 구조를 우선했다. - 요약은 목적, 핵심 새로움, 가장 중요한 검증 결과만 남겼다. - 방법은 논문을 직접 재현한다는 관점에서 순서를 복원했다. 원문에 없는 값은 추측하지 않고 원문 구현 세부 확인 필요로 표시했다. - 토의는 논문이 직접 밝힌 한계/향후 연구와 이 문서의 해석·연구주제 제안을 구분했다. - 본문 수치와 주장의 근거 페이지는 HTML 주석으로 남겨 화면을 복잡하게 하지 않으면서 추적 가능하게 했다.
| 분석 묶음 | 논문 수 | 핵심 범위 |
|---|---|---|
| 통합 시스템·작업계획 | 4 | AES, 계층형 계획, TaskNet |
| 환경인지·자율주행 | 4 | 제진, TNS/TTM, VINet |
| 동작·궤적 계획 | 4 | R-map, 토크/시간 최적화, IL+STOMP |
| 학습·제어·계측 | 4 | 강체 굴착, 체적추정, LPV-MPC, RL |
| 안전·실환경·종단간 시스템 | 4 | 안전 모니터링, 실환경 AES, ExACT |
통합 서론: Baidu 자율 굴착 연구의 흐름과 다음 연구기회
[!info] 근거 구분 아래에서 논문 직접 근거는 20편의 초록·결론·한계·향후 연구에 명시된 내용이다. 종합 해석은 여러 논문의 반복 한계를 연결해 도출한 연구기회이며, 개별 논문의 주장으로 읽으면 안 된다.
2019~2024 기술 흐름
- 2019 - 기구학적 실행 가능성의 압축 표현: Compact Reachability Map은 굴착 동작이 특정 평면에 놓인다는 성질을 이용해 버킷 도달 가능 자세와 이동 능력을 사전 계산하고, 이를 단일 굴착 궤적 생성에 사용했다. 다만 동역학, 상위 작업계획, 실제 굴착기 검증은 후속 과제로 남겼다. (논문 직접 근거)
- 2020 - 토양 상호작용과 시간까지 최적화 변수로 편입: Time Variable Minimum Torque Trajectory Optimization은 기하·기구학 제약에 토양-도구 힘 모델과 가변 시간 간격을 더해 토크와 작업시간을 함께 다뤘다. 후속 과제로 실측 데이터 기반 토양 힘 모델 보정과 실기 검증을 제시했다. (논문 직접 근거)
- 2020 - 개별 알고리즘에서 통합 시스템·장시간 운용으로 전환: AES는 인지-계획-제어를 ROS 기반으로 결합하고 폐기물·토사·암석 작업에 배치했다. 성능이 센서와 인지 정확도에 크게 좌우되고 눈·얼음·가혹 조명은 다루지 못했다는 점도 함께 밝혔다. (논문 직접 근거)
- 2021 - 모듈 스택의 세분화와 완성도 향상: 계층형 작업계획, TaskNet 기반 작업 분해, 제약 기반 궤적 최적화, 영상 제진, LiDAR 버킷 체적 추정, 비전 안전 모니터링이 각각 독립 모듈로 발전했다. 동시에 실환경 AES 논문은 물성·부분 가림·미지 물체·힘 피드백·베이스와 암의 결합 계획·시스템 검증 비용을 통합 시스템의 한계로 정리했다. (논문 직접 근거)
- 2021~2022 - 규칙·모델 중심에서 학습과 하이브리드로 확장: 강체 혼합물에 대한 성공예측+CEM, 순차 굴착 RL, TaskNet, 모방학습+STOMP가 등장했다. 단일 굴착의 탐욕적 선택에서 장기 보상으로 확장되었지만, 데이터 규모·시뮬레이션 의존·실굴착기 이전·반응형 재계획은 계속 후속 과제로 남았다. (논문 직접 근거)
- 2022 - 굴착 암을 넘어 이동성과 지면 적응으로 범위 확대: TTM/TNS는 RGB-LiDAR 의미·기하 융합으로 비정형 지형 주행성을 지도화했고, VINet은 영상-IMU 지형 분류를 제어기 선택과 연결했다. LPV-MPC는 휠로더의 비선형성을 온라인 계산 가능한 추종 제어로 다뤘다. 그러나 위험 지형·다기종·미지 지면·외란·적재량 변화에 대한 검증과 강건성 보장은 제한적이었다. (논문 직접 근거)
- 2024 - 두 방향의 분기: 모듈형 AES는 트럭 적재-주행-트렌칭을 연속 수행하고 비상정지 기능까지 통합한 반면, ExACT는 LiDAR·카메라·관절 상태에서 밸브/관절 명령을 직접 내는 action-chunking 기반 종단간 모방학습을 제시했다. 전자는 통제된 작업장과 제한된 시나리오, 후자는 단순화된 시뮬레이터와 고주파 밸브 제어·실기 검증이 한계다. (논문 직접 근거)
[!abstract] 종합 해석 이 연구군의 성과는 “작동하는 자율 굴착기”를 만드는 데 있다. 다음 경쟁력은 모듈을 하나 더 추가하는 것이 아니라, 미지 재료·변형 지형·사람과 장비가 섞인 현장에서 물리 상태와 작업 성과를 온라인으로 추정하고, 작업계획-궤적-제어를 안전하게 함께 갱신하는 능력에서 갈릴 가능성이 크다.
20편을 아우르는 연구공백
| 연구공백 | 기존 접근의 공통 한계 | 추천 연구문제 | 최소 검증 설계/지표 |
|---|---|---|---|
| 1. 재료 물성·저항력의 온라인 추정과 적응 제어 | 도달성 지도는 기구학 중심이고, 토양 힘 모델은 사전 파라미터나 시뮬레이션에 의존한다. AES·TaskNet·2022 배치 논문은 밀도·강성·점성·경도·저항력 감지와 힘 피드백 활용 부족을 직접 한계로 제시한다. (논문 직접 근거) | 카메라/LiDAR 외에 실린더 압력·관절 상태를 융합해 굴착 중 물성과 저항을 추정하고, 다음 동작의 깊이·속도·버킷 각도·제어 모드를 즉시 조정할 수 있는가? (종합 해석) | 서로 다른 토질·함수비·혼합물 조건에서 고정 궤적/사전 물성 모델과 비교. 물성·저항 추정오차, 버킷 충전율, 소요 에너지 또는 토크, 사이클 시간, 걸림·중단률을 측정. |
| 2. 계획-실행-성과를 잇는 폐루프 굴착 | 궤적 최적화는 정적 swept volume을 대리 지표로 쓰며, 체적 추정은 버킷 밖 돌출물과 동적 LiDAR 잡음에 취약하다. 다수 학습 플래너는 사전 학습 뒤 실행하고 실제 적재량·지형 변형으로 정책을 즉시 보정하지 않는다. (논문 직접 근거) | 매 굴착 후 실제 체적·질량·지형 변화·저항력을 관측해 다음 굴착 위치와 궤적을 재계획하면 장기 생산성과 품질을 높일 수 있는가? (종합 해석) | 동일 작업영역에서 개방루프/단일-step 탐욕/성과 피드백 재계획을 비교. 누적 반출량, 목표 형상 오차, 굴착 횟수, 공회전·실패 횟수, 총 작업시간을 평가. |
| 3. 데이터 효율적이며 안전 제약을 보장하는 sim-to-real 학습 | 강체 굴착 학습과 IL+STOMP는 로봇암 또는 제한된 실험계 중심이고, RL은 시뮬레이션 의존성이 크다. ExACT는 소수 시연의 가능성을 보였지만 단순화된 선형 시뮬레이터에서만 검증했고 고주파 밸브 성분을 충분히 학습하지 못했다. (논문 직접 근거) | 오프라인 실데이터, 시뮬레이션, 물리 제약 최적화를 결합해 적은 시연으로도 실굴착기에 이전되고 관절·충돌·힘 제약을 위반하지 않는 정책을 만들 수 있는가? (종합 해석) | 동일 시연 예산에서 순수 IL, 순수 모델기반, 하이브리드를 비교. 실기 성공률, 제약 위반·안전정지 횟수, sim-to-real 성능 저하, 추가 실데이터 대비 적응 속도, 제어 지연을 측정. |
| 4. 베이스-암-작업 순서를 동시에 다루는 온라인 통합 계획 | AES는 베이스 이동과 암 동작의 강한 결합을 인정하지만 동시에 최적화하지 않았다. 계층형 플래너는 베이스 이동이 2D에 제한되고, TTM/TNS의 기존 플래너는 주행성 지도의 기계 특성을 충분히 활용하지 못한다. RL 연구도 불확실성에 대한 반응형 재계획을 후속 과제로 둔다. (논문 직접 근거) | 변화하는 지형에서 베이스 위치·주행 경로·굴착 순서·버킷 궤적을 하나의 receding-horizon 작업계획으로 갱신할 수 있는가? (종합 해석) | 트럭 적재 또는 트렌칭 전체 작업에서 순차 모듈형 계획과 비교. 작업 완료시간, 베이스 이동거리, 재계획 지연, 유효 굴착률, 목표 형상 오차, 계획 실패율을 평가. |
| 5. OOD 환경과 사람·장비 혼재 현장의 검증 가능한 안전성 | 눈·얼음·비·먼지·강한 조명, 미지 물체, 센서 이상에 대한 일반화가 제한적이다. 안전 데이터셋은 작고, TNS/TTM은 위험 지형·다른 크기 장비·사람 및 타 장비 혼재를 충분히 시험하지 못했다. 2024 다중 작업 시연도 통제된 구역에서 수행되었다. (논문 직접 근거) | 인지 불확실성·센서 고장·동적 장애물을 명시적으로 추적하고, 성능 저하 시 감속-정지-재계획으로 전환하는 검증 가능한 안전 감독기를 만들 수 있는가? (종합 해석) | 날씨·조명·센서 드롭·미지 장애물·사람/장비 진입 시나리오를 체계적으로 주입. 위험 탐지 누락, 오경보, 정지거리, 최소 이격거리, 복구시간, 임무완료율과 장시간 무개입 운용시간을 평가. |
지금 시작할 만한 우선 연구주제 TOP 3
1. 작업 성과 피드백 기반 물성·저항 적응형 폐루프 굴착
- 문제정의: 굴착 전 시각 정보와 굴착 중 압력·관절·속도 신호로 재료 물성/저항을 추정하고, 굴착 후 실제 버킷 충전량과 지형 변화를 이용해 다음 궤적을 온라인 보정한다.
- 왜 지금 가능한가: 이 연구군 안에 이미 의미·기하 인지, 토양 힘 모델, 궤적 최적화, 체적 추정, 순차 RL, 장시간 AES 운용이 각각 존재한다. 아직 이들을 하나의 성과 기반 적응 루프로 닫지 못했다. (논문 직접 근거 + 종합 해석)
- 최소 논문 단위(MVP): 소형 굴착기 또는 계측 로봇암에서 성질이 다른 재료를 반복 굴착하고,
고정 궤적과온라인 저항·충전량 적응을 비교한다. 핵심 지표는 충전율, 에너지/토크, 사이클 시간, 걸림률, 누적 생산량이다. - 차별점: 물성 “분류”에 그치지 않고 추정 → 계획/제어 변경 → 실제 성과 확인 → 다음 행동 보정까지 닫힌 인과 루프를 검증한다.
2. 물리·안전 제약을 내장한 소량데이터 sim-to-real 굴착 정책
- 문제정의: ACT/오프라인 RL의 시퀀스 정책에 기구학·충돌·힘·밸브 응답 제약을 결합해, 적은 인간 시연으로도 강체 혼합물 굴착을 실기에서 안전하게 수행한다.
- 왜 지금 가능한가: 2021~2024 연구는 voxel/point-cloud 표현의 sim-to-real 이점, IL+STOMP 하이브리드, 순차 RL, action chunking의 소량 시연 가능성을 각각 보였다. 동시에 실굴착기 이전과 고주파 제어가 명시적 미완성 과제다. (논문 직접 근거)
- 최소 논문 단위(MVP): 실기 시연으로 정책을 초기화하고 시뮬레이션/오프라인 로그로 보강한 뒤, 순수 IL 및 모델기반 플래너와 강체 혼합물 작업에서 비교한다. 성공률뿐 아니라 제약 위반, 안전정지, 제어 지연, 추가 시연에 따른 향상 폭을 함께 보고한다.
- 차별점: “종단간이면 안전을 설명하기 어렵고, 모델기반이면 상호작용을 모델링하기 어렵다”는 양쪽 약점을 제약 투영 또는 안전 필터가 있는 하이브리드 정책으로 동시에 다룬다.
3. 동적 작업장의 주행성-작업계획-굴착 통합 재계획
- 문제정의: 굴착으로 지형이 바뀌고 사람·트럭·장비가 이동하는 현장에서, 주행성 지도와 작업 진척을 이용해 베이스 위치, 굴착 순서, 암 궤적을 온라인으로 함께 재계획한다.
- 왜 지금 가능한가: TTM/TNS의 실시간 주행성 지도, 계층형 작업계획, TaskNet, 2024 AES의 트럭 적재-주행-트렌칭 연속 시연과 비상정지가 이미 기본 요소를 제공한다. 그러나 이 요소들은 여전히 순차적으로 연결되며, 사람·장비 혼재 협업은 장기 목표로 남아 있다. (논문 직접 근거 + 종합 해석)
- 최소 논문 단위(MVP): 한 대의 굴착기와 한 대의 트럭이 있는 제한 작업장에서 장애물·트럭 위치·지형을 중간에 변경하고, 고정 작업계획 대비 온라인 통합 재계획을 비교한다. 작업시간, 베이스 이동거리, 계획 실패, 최소 이격거리, 비상정지와 복구시간을 측정한다.
- 차별점: 개별 인지·주행·굴착 성능이 아니라 전체 작업의 안전한 완료 비용을 최적화하며, 후속 단계에서 다장비 협업으로 자연스럽게 확장된다.
논문별 상세 분석
[!summary] A. 통합 시스템·작업계획 인지-계획-제어 통합, 작업 분해, 학습 기반 task planning을 다룬다.
2020 · AES: 위험 환경용 자율굴착기 시스템
- 원문: 논문 PDF
1) 대표그림
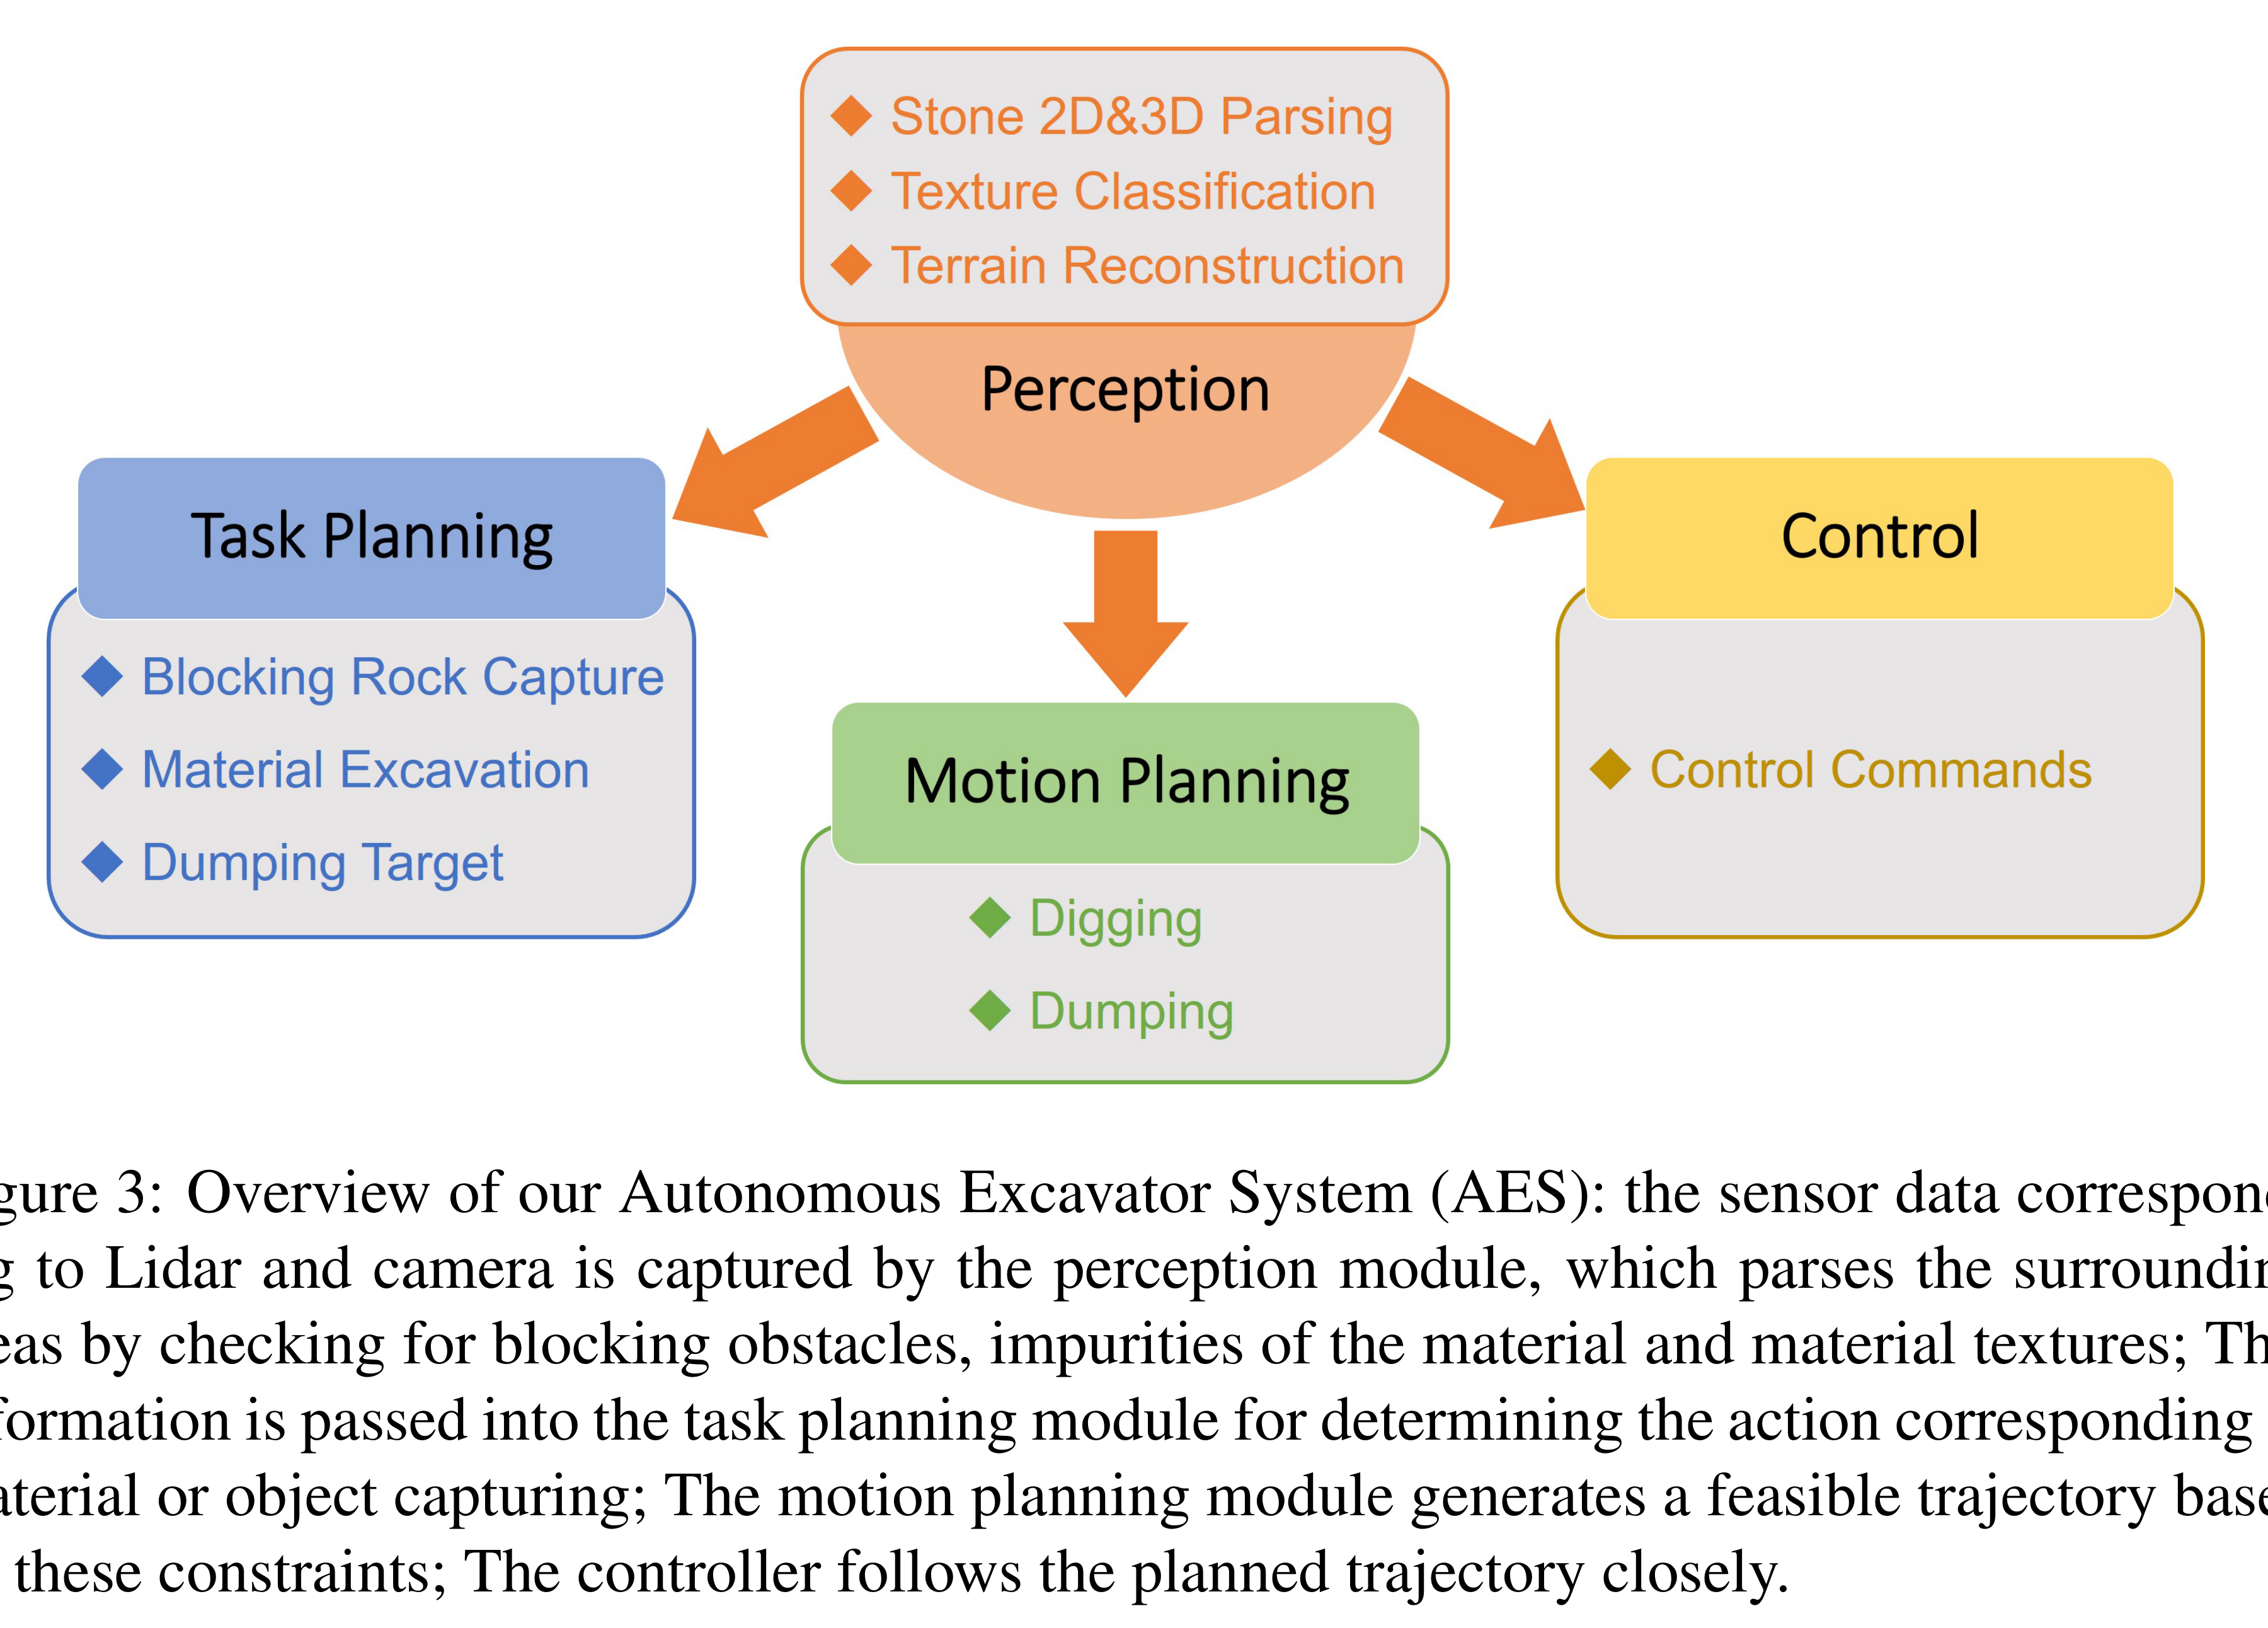
그림 설명: LiDAR·카메라 기반 인지가 장애물·재질·지형 정보를 만들고, 작업계획·동작계획·제어로 전달되는 perception-centered AES 구조. 원문 Figure 3, PDF p.9.
2) 요약
- 비정형·위험 환경의 적재·굴착을 사람 개입 없이 수행하기 위해 인지, 계층형 계획, 제어를 하나의 ROS 기반 시스템으로 통합했다.
- 핵심 새로움은 3D LiDAR와 RGB-D 카메라로 지형·암석·불순물·재질·덤프트럭을 인지하고, 사람 시연에서 학습한 굴착 목표·동작 패턴을 최적화 기반 궤적계획과 결합한 데 있다.
- 8개 실제 시험 시나리오에서 지형 조작, 장애물 회피, 물 영역 회피와 이들의 조합을 검증했다.
- 6.5톤 장비의 폐기물 처리 현장에서 24시간 무개입 운전, 시간당 145회 굴착-덤핑, 시간당 36.25 m³ 처리를 보고했다.
- 기본 적재 시험에서 AES는 사이클당 25.0초·버킷 충전율 105%, 숙련자는 23.6초·86%였고, 저자는 시간당 처리량이 유사하다고 평가했다.
3) 방법
- 장비·센서 구성: drive-by-wire 유압 굴착기에 RTK, 관절 경사계, Livox Mid-100 LiDAR, ZED RGB-D 카메라를 장착하고 CAN 버스로 제어한다. Linux/ROS에서 인지·계획·제어·응용 노드를 동시에 실행하며, 논문 장비는 Intel i7 8 CPU·NVIDIA GPU 2개를 사용했다.
- 환경 인지: RGB 영상은 Mask R-CNN으로 암석·장애물을 분할하고 카메라·LiDAR 깊이를 결합해 3D 경계상자를 구한다. 재질은 Deep Encoding Pooling Network로 분류하고, 덤프트럭은 오프라인 3D 템플릿과 온라인 LiDAR 점군을 ICP로 정합한다.
- 굴착 목표 선택: 작업영역을 2.5D 높이 격자로 변환하고, 데이터 기반 네트워크가 사람 운전 패턴을 모사해 버킷 최초 접촉점(POA)과 인입 이동거리를 출력하게 학습한다. 목표 선택 시연 수와 네트워크 세부 하이퍼파라미터는 원문 구현 세부 확인 필요.
- 동작 패턴 학습: 사람 굴착 궤적에서 IRL로 관절별 종단 자세 오차와 변화율에 대한 비용 가중치를 오프라인 학습하고, POA와 이동거리로 시작·종단 관절자세를 역기구학으로 계산한다.
- 온라인 계획·제어: 학습된 비용을 STOMP에 넣고 불순물·트럭·건물 등 인지된 장애물 비용을 추가해 충돌 없는 굴착·덤핑 관절궤적을 만든 뒤, 저수준 제어기가 이를 추종한다. 비정상 사람·동물 감지와 수동 비상제어를 안전장치로 둔다.
- 검증: 단순 적재부터 암석 제거·장애물·물 영역이 결합된 8개 시나리오와 실제 폐기물 처리·광산 현장에서 사이클 시간, 버킷 충전율, 시간당 처리량, 무개입 운전시간을 측정한다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 전체 성능이 인지 알고리즘 정확도와 센서 신뢰성에 크게 좌우되며, 눈·얼음 환경은 다루지 않았다. 더 어려운 날씨와 조명에서 인지·계획·제어를 추가 평가하는 것이 후속 목표다.
- 분석상 한계: 해석: 재질 분류와 장애물 인지는 제한된 폐쇄형 클래스·현장 데이터로 학습됐고, 미지 재질이나 센서 열화에 대한 불확실도 추정·안전 보장은 제시되지 않았다.
- 연구주제 제안: 눈·폭우·분진 조건에서 LiDAR-카메라 신뢰도를 온라인 추정해 계획 비용과 정지 정책을 조절하는 불확실도 인지형 AES를 개발하고, 객체 미검출률·불필요 정지율·작업 성공률·HPI로 검증한다.
- 연구주제 제안: 미지 재질을 탐지하면 안전 동작으로 전환하고 소량 현장 데이터로 재질·장애물 모델을 갱신하는 개방집합 적응 인지를 개발해 OOD 탐지 AUROC, 적응 후 mIoU, 충돌·개입 횟수로 평가한다.
2021 · AES: 실제 적재 작업용 통합 자율굴착기
- 원문: 논문 PDF
1) 대표그림
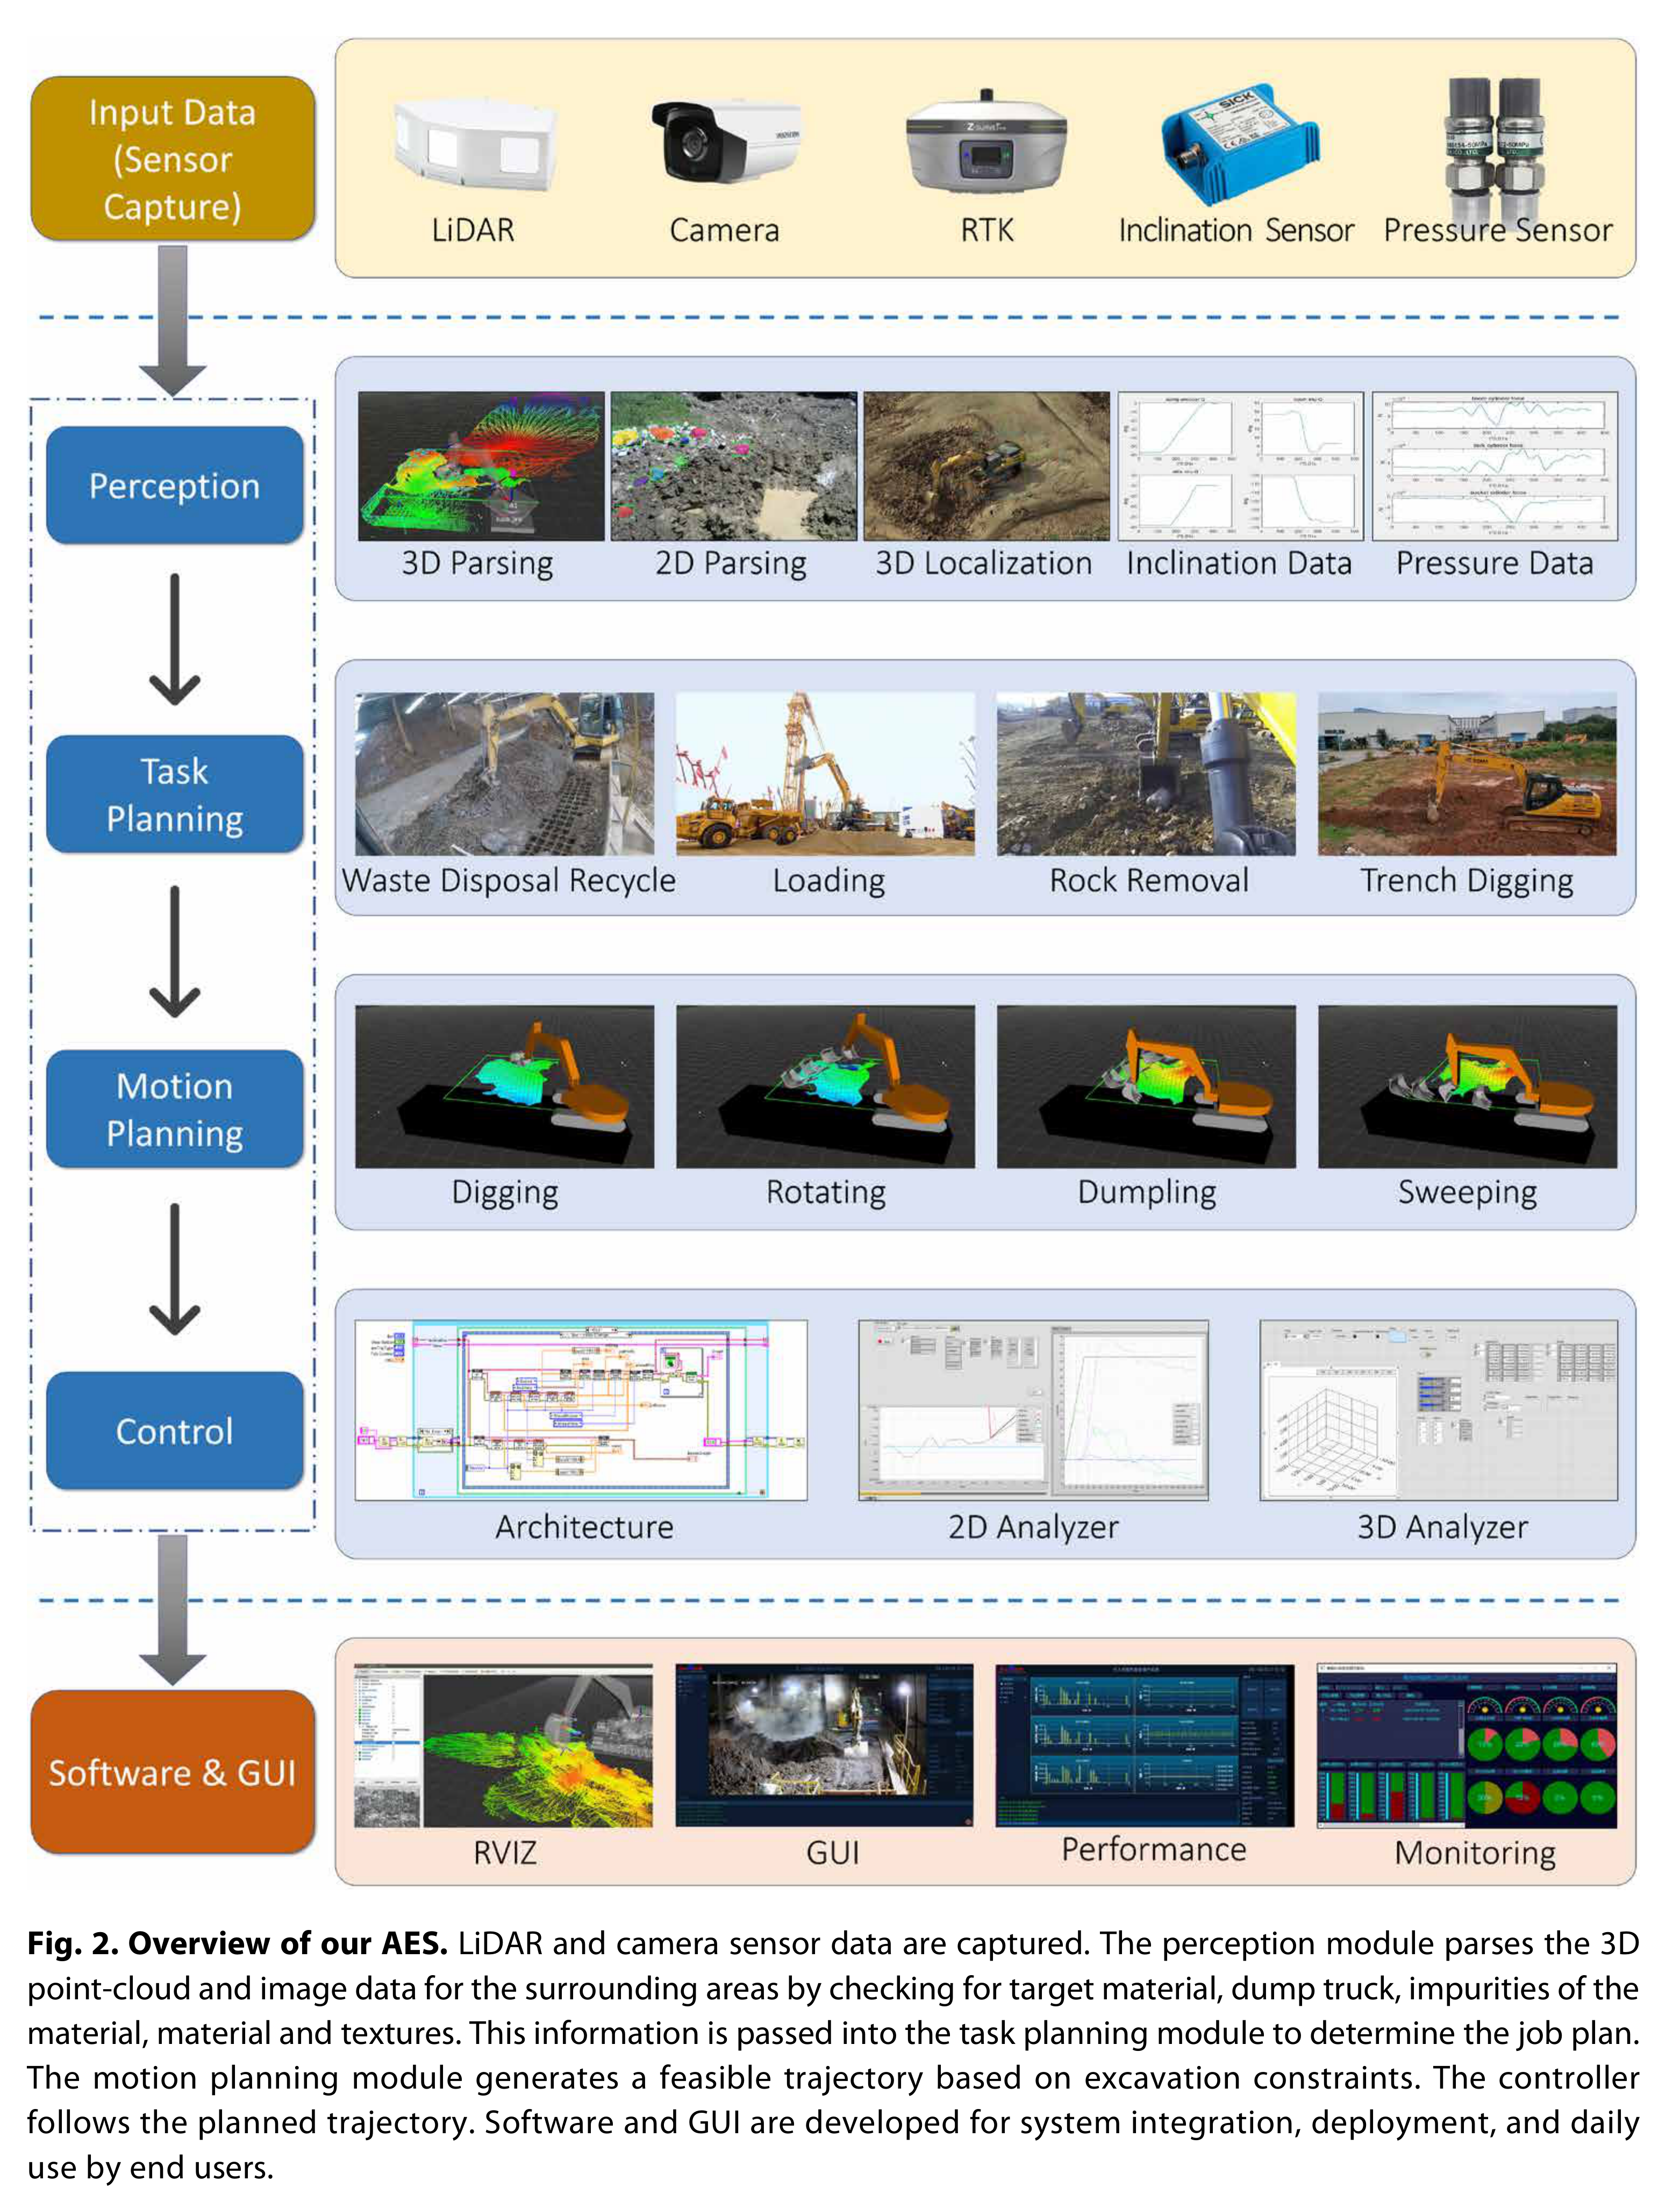
그림 설명: 센서 입력에서 정밀 2D/3D 인지, 작업계획, 동작계획, 제어, 운용 GUI까지 이어지는 AES 전체 소프트웨어·하드웨어 파이프라인. 원문 Figure 2, PDF p.3.
2) 요약
- 위험한 자재 적재를 장시간 무인화하기 위해 멀티모달 인지, 계층형 작업·동작계획, 계층형 제어, 안전 기능을 실제 굴착기용 통합 시스템으로 구현했다.
- 인지는 제진(dedusting) → 재질 분류 → 의미·인스턴스 분할 → 3D 형상·자세 추정의 coarse-to-fine 구조이고, 계획은 학습 기반 목표 선택과 IRL 비용을 활용한 궤적 최적화를 결합한다.
- 6.5·7.5톤급 소형, 33.5톤급 표준, 49톤급 대형 굴착기에 같은 모듈 구조를 크기 파라미터만 바꾸어 적용했다.
- 폐기물 처리 현장에서 24시간 무개입 운전과 7.5톤 굴착기 기준 시간당 67.1 m³ 처리를 보고했다.
- 실내외의 적재, 암석 제거, 장애물·물 회피, 기초 제거, 도랑 굴착 등 실제 시나리오를 통해 단일 굴착 동작이 아니라 장시간 시스템 수준의 강건성을 검증했다.
3) 방법
- 장비·센서 구성: CAN 제어가 가능한 drive-by-wire 유압 굴착기에 RTK, SICK/Honeywell 경사계, Livox Mid-100 LiDAR, RGB 카메라를 장착하고 Intel i7+NVIDIA GPU Linux 컴퓨터에서 ROS 노드로 인지·계획·제어·응용 계층을 실행한다. STM32F407 보드가 저수준 CAN 통신을 담당한다.
- 영상·재질 전처리: 256×256 실제 분진 영상 1,000쌍과 시험 200장을 사용해 멀티스케일 인코더-디코더 제진망을 학습하고, 8종 재질 영상 7,563장(학습 6,720·시험 843)으로 attention이 포함된 Deep Encoding Pooling Network를 학습한다. 논문은 각각 P40 GPU 1개에서 5시간·1시간 학습을 보고했다.
- 객체·3D 자세 인지: Mask R-CNN을 암석/장애물 인스턴스 4,000개로 학습한 뒤 2D 분할과 LiDAR·카메라 깊이를 결합해 3D 경계상자를 맞춘다. 덤프트럭은 다중 시점 점군 템플릿을 만들고 ICP 정합으로 6-DoF 자세와 투하 위치를 구한다.
- 팔 작업계획: LiDAR 지형을 2.5D 높이맵으로 만들고 학습 모델이 POA와 버킷 이동거리를 예측한다. 사람 시연 궤적에서 IRL로 종단오차·속도·가속도·버킷-지면 거리 비용의 가중치를 학습하고, 온라인 궤적 최적화에 정·동적 장애물 비용을 더한다.
- 차체 작업·경로계획: 작업영역을 한 위치에서 팔로 처리 가능한 task zone으로 분할해 방문 순서를 만든다. LiDAR 3D 점군, RTK 위치, 높이·점유 정보를 이용해 주행가능 영역을 만들고 탐색 기반 경로계획과 MPC로 각 차체 목표점에 이동한다.
- 제어·안전: 상위 관절/말단 추종 결과를 저수준 유압밸브 명령으로 변환한다. 지도에 사전 금지구역을 두고, RTK·관절센서로 링크 진입을 막으며, 카메라가 사람·동물을 검출하면 정지시킨다.
- 평가: 시뮬레이션·기록 데이터·HIL·실차를 단계적으로 검증하고, 다양한 장비·시나리오에서 작업 성공, 사이클/처리량, HPI와 센서·통합 실패를 기록한다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 현재 인지는 형상·외관 중심이라 밀도·감쇠·강성·점성·유동성, 매몰·가림 물체와 객체 간 의미관계를 충분히 다루지 못한다. 학습 데이터와 기지 클래스에 의존하고 극심한 분진·비·바람·눈에서 추가 검증이 필요하다.
- 논문이 직접 밝힌 한계/향후 연구: 계획·제어는 토사와 고립 암석, 제한된 사전 재질 지식에 집중하며 힘 피드백을 충분히 쓰지 못한다. 차체 경로와 팔 동작을 분리해 계산해 상호영향을 동시에 최적화하지 못했고, 센서 이상·하드웨어 통합 검증도 큰 비용을 요구한다.
- 분석상 한계: 해석: 인지 중심 직렬 구조에서는 한 모듈의 오차가 다음 계획·제어 단계에 누적되지만, 논문 평가는 모듈별 불확실도에서 최종 안전·처리량으로 이어지는 민감도를 정량화하지 않았다.
- 연구주제 제안: 버킷 압력·관절 토크와 시각/지형을 결합해 토질 물성을 온라인 추정하고 동작 비용을 적응시키는 force-aware 굴착을 개발해 재질별 충전율·최대 접촉력·에너지/m³·작업 성공률로 검증한다.
- 연구주제 제안: 지반 안정도와 굴착 후 지형변형을 예측하면서 차체 위치와 팔 궤적을 공동 최적화하는 base-arm 통합계획을 개발해 총 이동거리·작업시간·안정도 여유·충돌/재계획 횟수로 평가한다.
2021 · 계층형 작업·차체·팔 계획 구조
- 원문: 논문 PDF
1) 대표그림
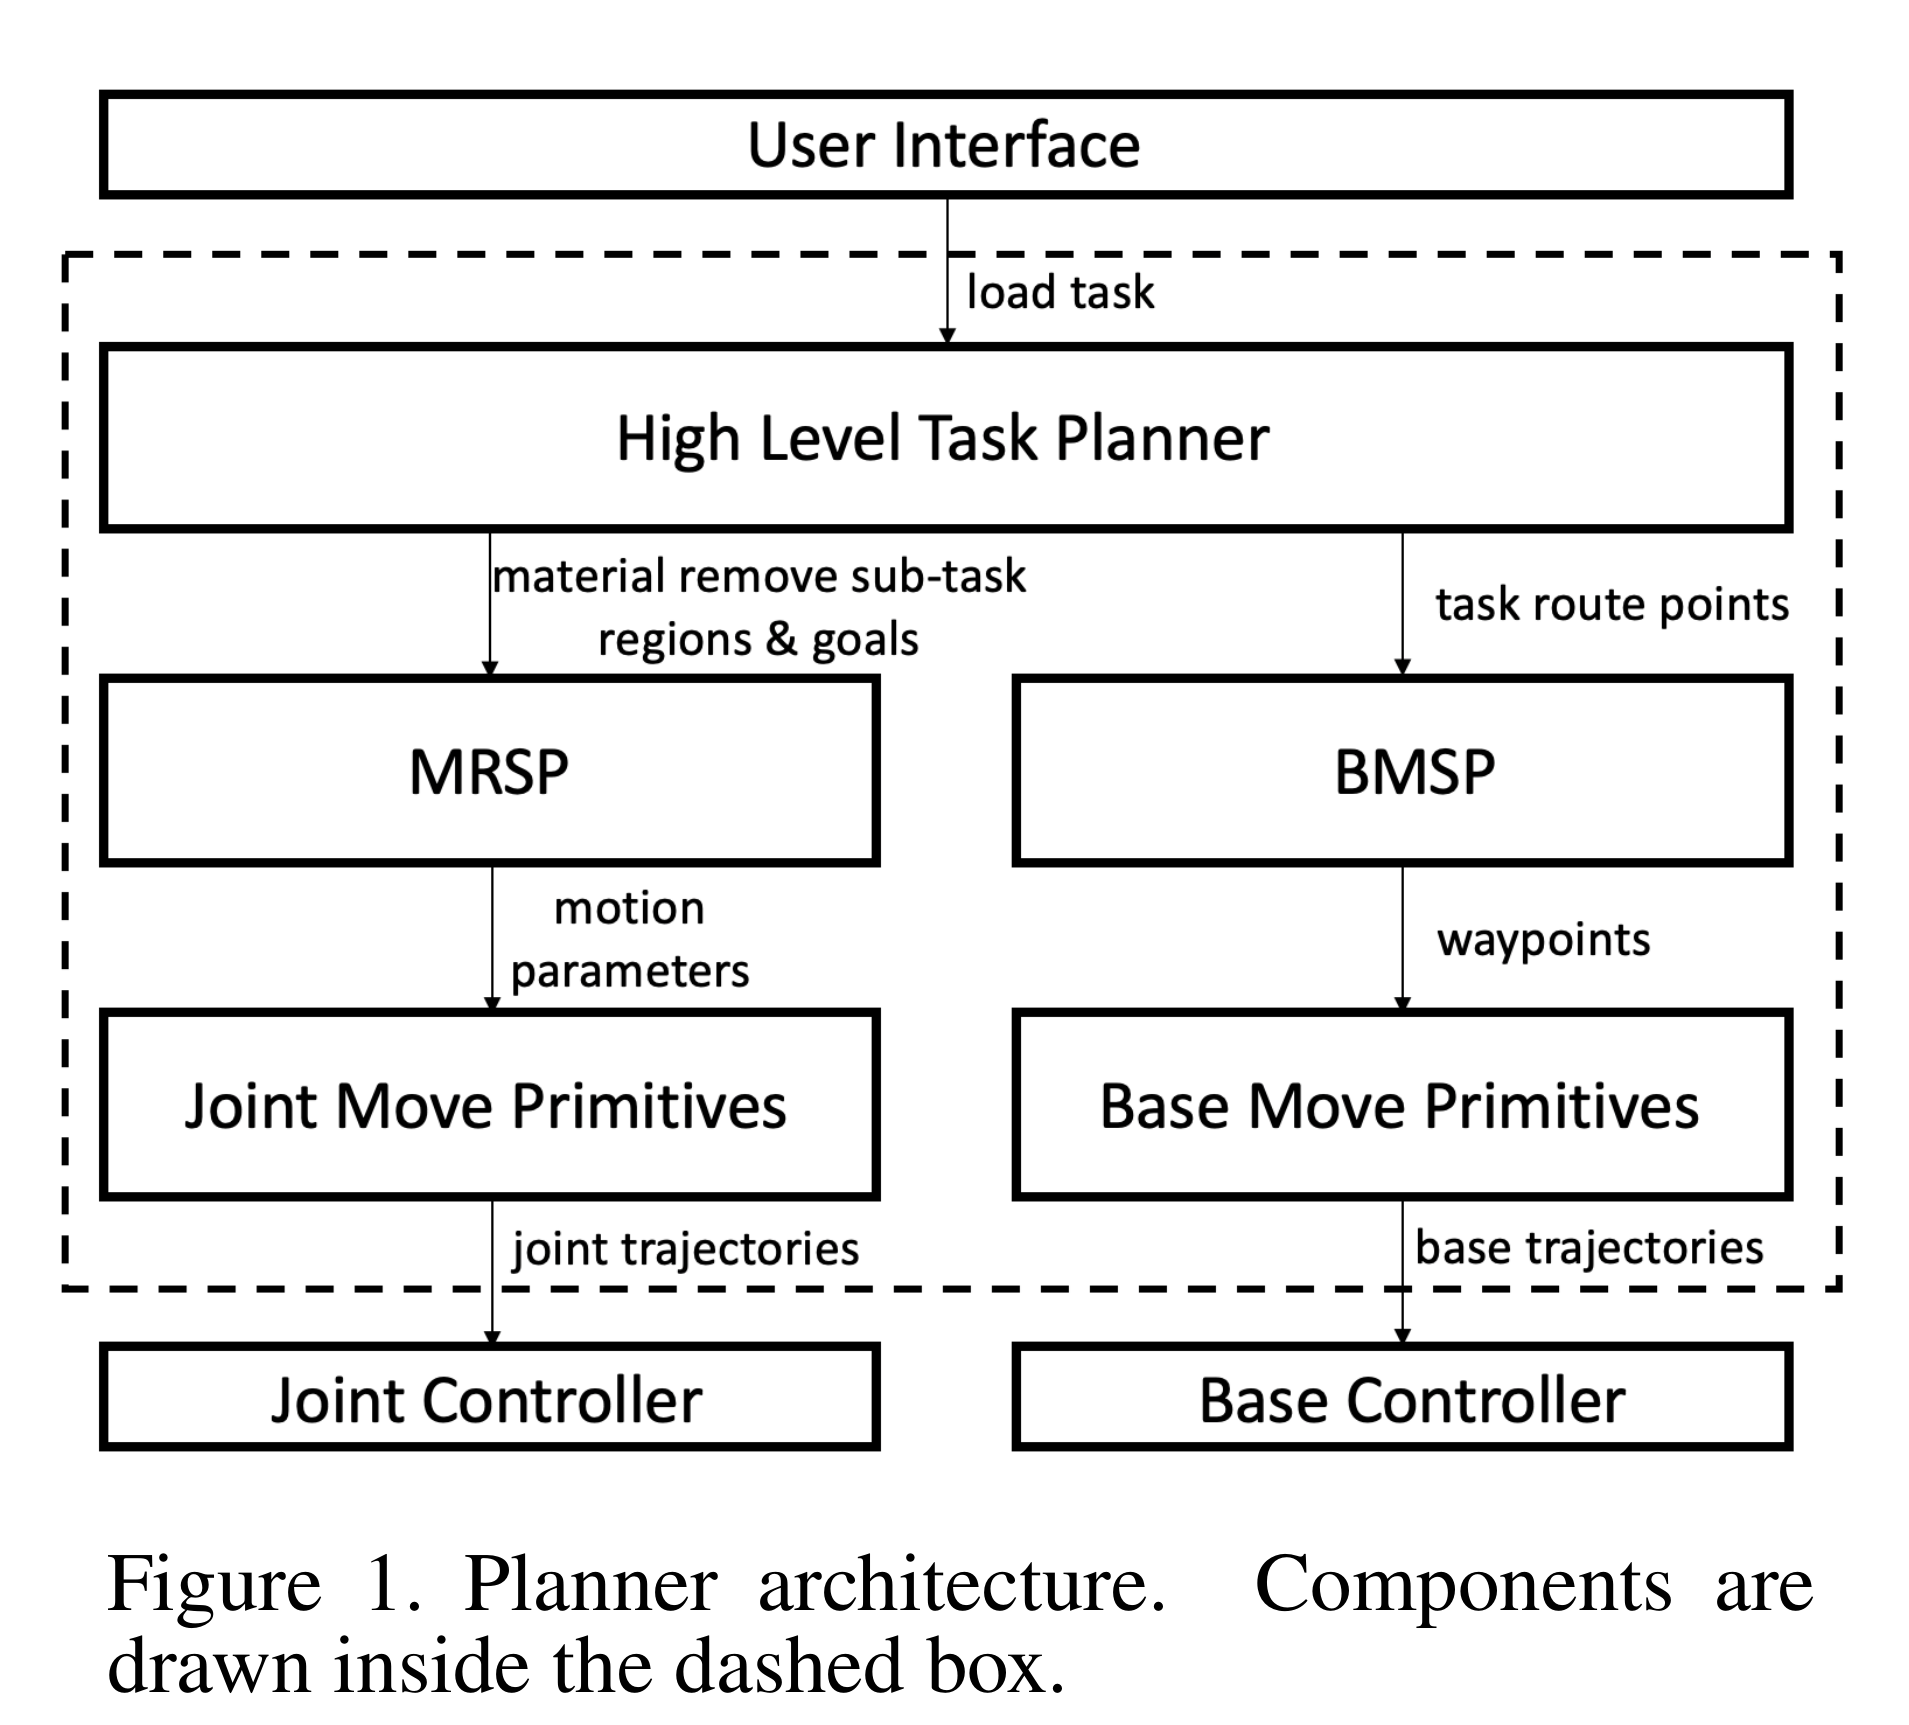
그림 설명: 사용자 작업을 고수준 계획기가 재료 제거(MRSP)와 차체 이동(BMSP) 하위작업으로 나누고, 각 motion primitive와 제어기로 연결하는 3계층 계획 구조. 원문 Figure 1, PDF p.3.
2) 요약
- 서로 다른 굴착 작업마다 전체 플래너를 다시 만드는 문제를 줄이기 위해 고수준 작업분할 → 범용 하위작업 플래너 → 동작 primitive·제어기로 이어지는 계층형 구조를 제안했다.
- 고수준 계획기는 도랑 굴착, 파일 제거, 대규모 파일 제거를 차체 route point와 각 위치의 local task region으로 분할하고, MRSP와 BMSP가 각각 팔 굴착과 차체 이동을 수행한다.
- MRSP는 LiDAR 지형의 최고점과 평균높이로 POA·굴착 파라미터·덤프 위치·종료조건을 정하고, BMSP는 2D 점유지도에서 Hybrid A*와 MPC로 차체 경로를 만든다.
- 36.6톤 실차에서 10.0×1.5×2.0 m 도랑을 5개 route point/하위작업으로 나누어 20분에 완료했고, 8.0×5.6×0.5 m 파일 제거는 4개 route point/하위작업으로 16분 이내 완료했다.
- 67.0톤 모델의 AGX Dynamics 시뮬레이션에서도 대규모 작업영역을 열·층별로 분할하고 U턴 경로로 연결하는 전체 계획을 검증했다.
3) 방법
- 작업 입력·도달영역 설정: 사용자가 목표 작업영역과 목표 높이를 지정하면 장비의 최소·최대 도달거리와 중첩폭으로 부채꼴 또는 직사각형 local task region을 정의한다. 도랑은 후진형, 파일 제거는 전진형 작업으로 구분한다.
- 고수준 분할: 작업 길이·폭과 도달범위로 필요한 정차 지점과 재료 제거 하위영역 수를 계산한다. 대규모 파일은 열, 부채꼴 조각, 필요 시 여러 높이층으로 분할하고 열 사이를 큰 반경의 반원 U턴으로 연결한다.
- 상태 취득: RTK로 차체 위치, 관절센서로 자세, Livox Mid-100 LiDAR로 지형 점군을 갱신한다. 실험의 RTK·LiDAR 갱신률은 10 Hz, 관절각은 100 Hz·0.1° 정확도로 보고됐다.
- MRSP 굴착 루프: local task region·목표높이·덤프모드와 현재 점군을 입력받아 목표높이에 이를 때까지
POA 선택 → dig primitive → dump primitive를 반복한다. POA는 최고점을 향한 선에 오프셋을 주고 높이는 영역 평균으로 정한다. - 굴착·덤프 파라미터화: POA 3축, 관입 깊이·길이, 끌기 길이, 굴착 기울기의 7개 값으로 dig primitive를 만들고, 고정·가변·트럭의 3개 덤프모드와 rigid·regular·loose 종료조건을 선택한다. 토량-버킷 용량 최적화의 구체 목적함수와 파라미터 튜닝값은 원문 구현 세부 확인 필요.
- BMSP·저수준 제어: LiDAR 점유지도, 현재/목표 2D 차체 자세로 Hybrid A* waypoint를 생성하고 unicycle 모델의 MPC로 추종한다. 팔 primitive는 관절궤적을 PID로, 차체 primitive는 MPC로 제어하며 최종 명령은 lookup table로 유압 입력에 대응시킨다.
- 검증: 실차 도랑·파일 제거와 물리 시뮬레이션 대규모 파일 제거에서 자동 분할된 route point 수, 작업 완료시간, 목표형상 달성을 확인한다. 형상 오차의 정량 지표는 원문 구현 세부 확인 필요.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 현재 구조를 평탄화 등 새로운 작업 유형으로 확장할 수 있으나, 차체 이동계획은 2D에 제한된다. 거친 지형을 위한 3D 차체계획과 굴착기 균형 고려를 향후 과제로 제시했다.
- 분석상 한계: 해석: 고수준 분할과 POA 선택이 주로 기하 규칙에 의존하고 토질·힘·인지 불확실도를 반영하지 않으며, 실험도 완료시간 중심이라 잔여 토량·형상오차·안전 여유의 비교 기준이 부족하다.
- 연구주제 제안: 3D 높이맵의 경사·지지면과 굴착기 질량중심을 포함한 안정도 제약 Hybrid A*/MPC를 개발해 전복 안정도 여유, roll/pitch 최대값, 경로길이, 주행 성공률로 검증한다.
- 연구주제 제안: 점군·버킷 힘의 불확실도에 따라 local task region과 route point를 온라인 재분할하는 적응형 계층계획을 개발해 잔여체적 RMSE·재계획 횟수·총 작업시간·개입률로 평가한다.
2021 · TaskNet: 신경망 기반 계층형 작업계획
- 원문: 논문 PDF
1) 대표그림
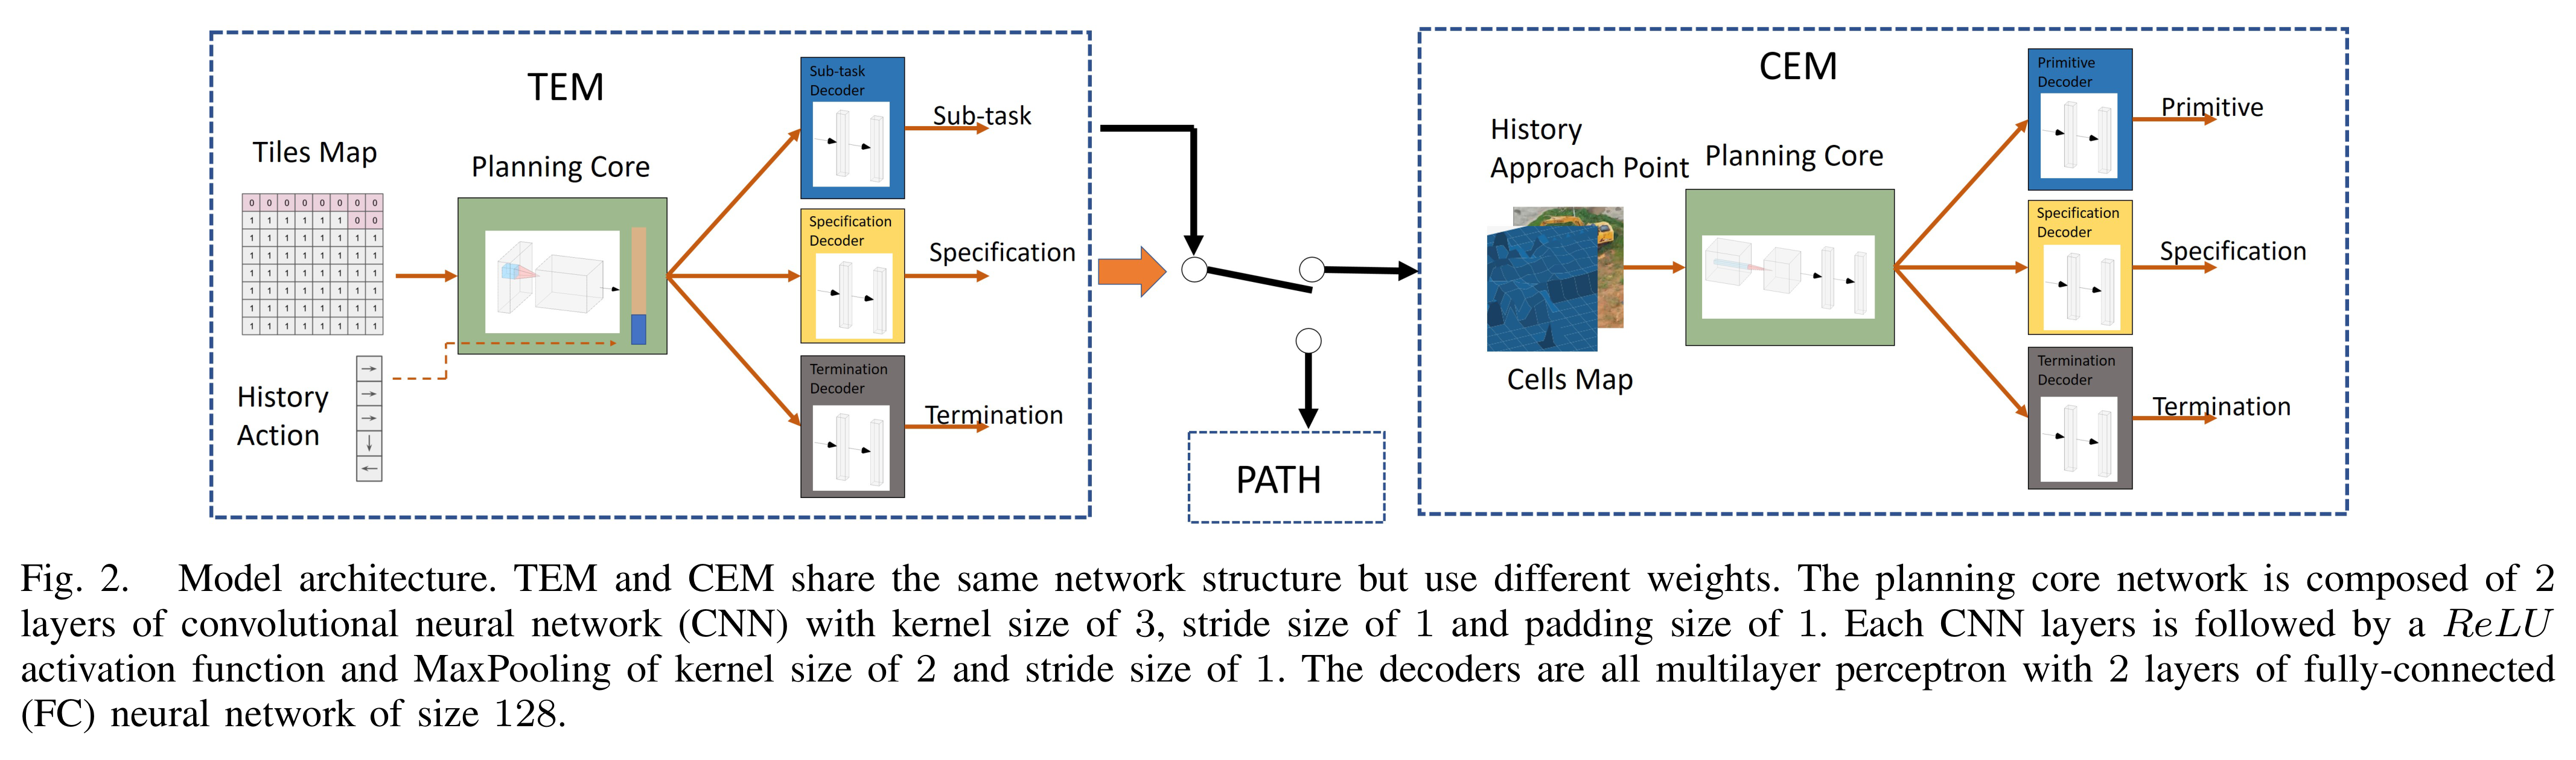
그림 설명: 전역 tile 단위의 차체/굴착 하위작업을 정하는 TEM과 지역 cell 단위의 접근·굴착 primitive를 정하는 CEM, 그리고 차체 PATH 모듈의 연결 구조. 원문 Figure 2, PDF p.4.
2) 요약
- 규칙 기반 FSM 대신 시연 데이터에서 작업분해 전략을 학습해, 목표 지형을 하위작업 → 사양이 붙은 동작 primitive로 재귀 분해하는 신경망 작업계획기 TaskNet을 제안했다.
- LiDAR 높이차 지도를 장비 도달범위 크기의 tile map과 버킷 폭 크기의 cell map으로 나누고, TEM은
move_to_tile/excavate_tile, CEM은approach/dig와 각 사양·종료 여부를 예측한다. - TEM과 CEM은 같은 CNN-다중 decoder 구조를 쓰되 서로 다른 가중치를 사용한다. 비교 모델 중 순수 imitation learning은 cell 종료판단에 실패했고, 공유-core 모델은 tile 하위작업 선택에 실패한 반면 TaskNet은 두 시험을 모두 완료했다.
- TEM은 최대 32×32의 서로 다른 tile map 3,000개에서 총 1,126,900개 샘플, CEM은 최대 6×6의 10,000개 시퀀스로 학습하고 실차 전 사람 운전 데이터로 미세조정했다.
- 49톤 실차에서 54회 적재를 수행해 시간당 356.8 m³로, 사람 운전의 396.5 m³/h에 근접했다고 보고했다.
3) 방법
- 목표·관측 표현: LiDAR 점군을 현재-목표 높이차 격자 $G$로 만들고 허용오차 $\epsilon$ 이내이면 완료로 정의한다. 전역 격자는 장비 도달영역 크기의 tile, 지역 격자는 버킷 폭 크기의 cell로 축소·절단한다.
- 시연 데이터 생성: 규칙 기반 시뮬레이터로 사람의 전체 순회·비작업 tile 건너뛰기와 지역 최고 cell 우선 굴착 시퀀스를 합성하고, 실제 운전자 시퀀스로 미세조정한다. 합성-실데이터 비율과 미세조정 epoch는 원문 구현 세부 확인 필요.
- TEM 전역계획: 현재 tile map과 최근 이동 이력을 입력해
move_to_tile또는excavate_tile, 이동방향/지역 높이맵 사양, 종료 여부를 각각 decoder로 예측한다. 이동 하위작업이면 PATH 모듈이 차체 primitive와 경로를 만든다. - CEM 지역계획: 선택된 지역 cell map과 이전 approach 지점을 입력해 다음
approach/digprimitive, 국소 좌표/깊이 사양, 하위작업 종료 여부를 예측하며 관측을 갱신해 반복한다. - 모델·학습: 각 planning core는 kernel 3·stride 1·padding 1의 CNN 2층과 ReLU, kernel 2·stride 1 max-pooling으로 구성하고, sub-task/primitive·사양·종료 decoder는 128-unit 완전연결층 2개를 쓴다. 세 출력의 cross-entropy를 가중합해 지도학습하며 TEM/CEM core 가중치는 공유하지 않는다.
- 동작 실행: TaskNet 출력 primitive를 팔 궤적 최적화와 차체 grid-search 경로계획에 넘기고, 관절·차체 제어기가 실행한다. 전체 시퀀스를 일괄 생성하거나 매 primitive마다 새 관측으로 온라인 실행할 수 있다.
- 평가: 3.5톤 모델의 입자 기반 3D 물리 시뮬레이터에서 파일·도랑·복수 블록 작업을 폐루프로 평가한 뒤, LiDAR·IMU를 단 49톤 drive-by-wire 굴착기에서 실제 적재를 수행한다. 실차에서 TaskNet 추론은 1초 미만, approach는 약 2초, dig·swing·dump는 합계 약 22초로 보고됐다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 현재 높이 기반 기하 표현에 토질 texture·hardness 같은 물성을 추가하려 하며, 대량 학습 데이터를 시뮬레이션에 의존하고 실제 데이터의 수집·라벨링이 어려워 few-shot learning을 후속 방향으로 제시했다.
- 분석상 한계: 해석: 합성 trace 규칙이 학습 전략을 사실상 선결정할 수 있고, Table II는 완료/실패만 제시해 미지 지형·센서오차에서의 일반화율과 안전 실패 확률을 판단하기 어렵다.
- 연구주제 제안: 소량 실차 시연과 대량 합성 trace를 불확실도 기반 sim-to-real few-shot 학습으로 결합해 새로운 지형에서 sequence 완료율·종료판단 F1·필요 실데이터 수·안전개입률을 비교한다.
- 연구주제 제안: 높이맵에 재질 texture, 추정 hardness, 버킷 힘 이력을 채널로 추가한 물성 조건부 TaskNet을 개발해 재질별 버킷 충전율·에너지/m³·primitive 실패율·작업시간으로 검증한다.
[!summary] B. 환경인지·자율주행 먼지 제거, 의미·기하 주행성 지도, 영상-관성 지형 분류를 다룬다.
2021 · 폐루프 심층망 기반 영상 제진
- 원문: 논문 PDF
1) 대표그림
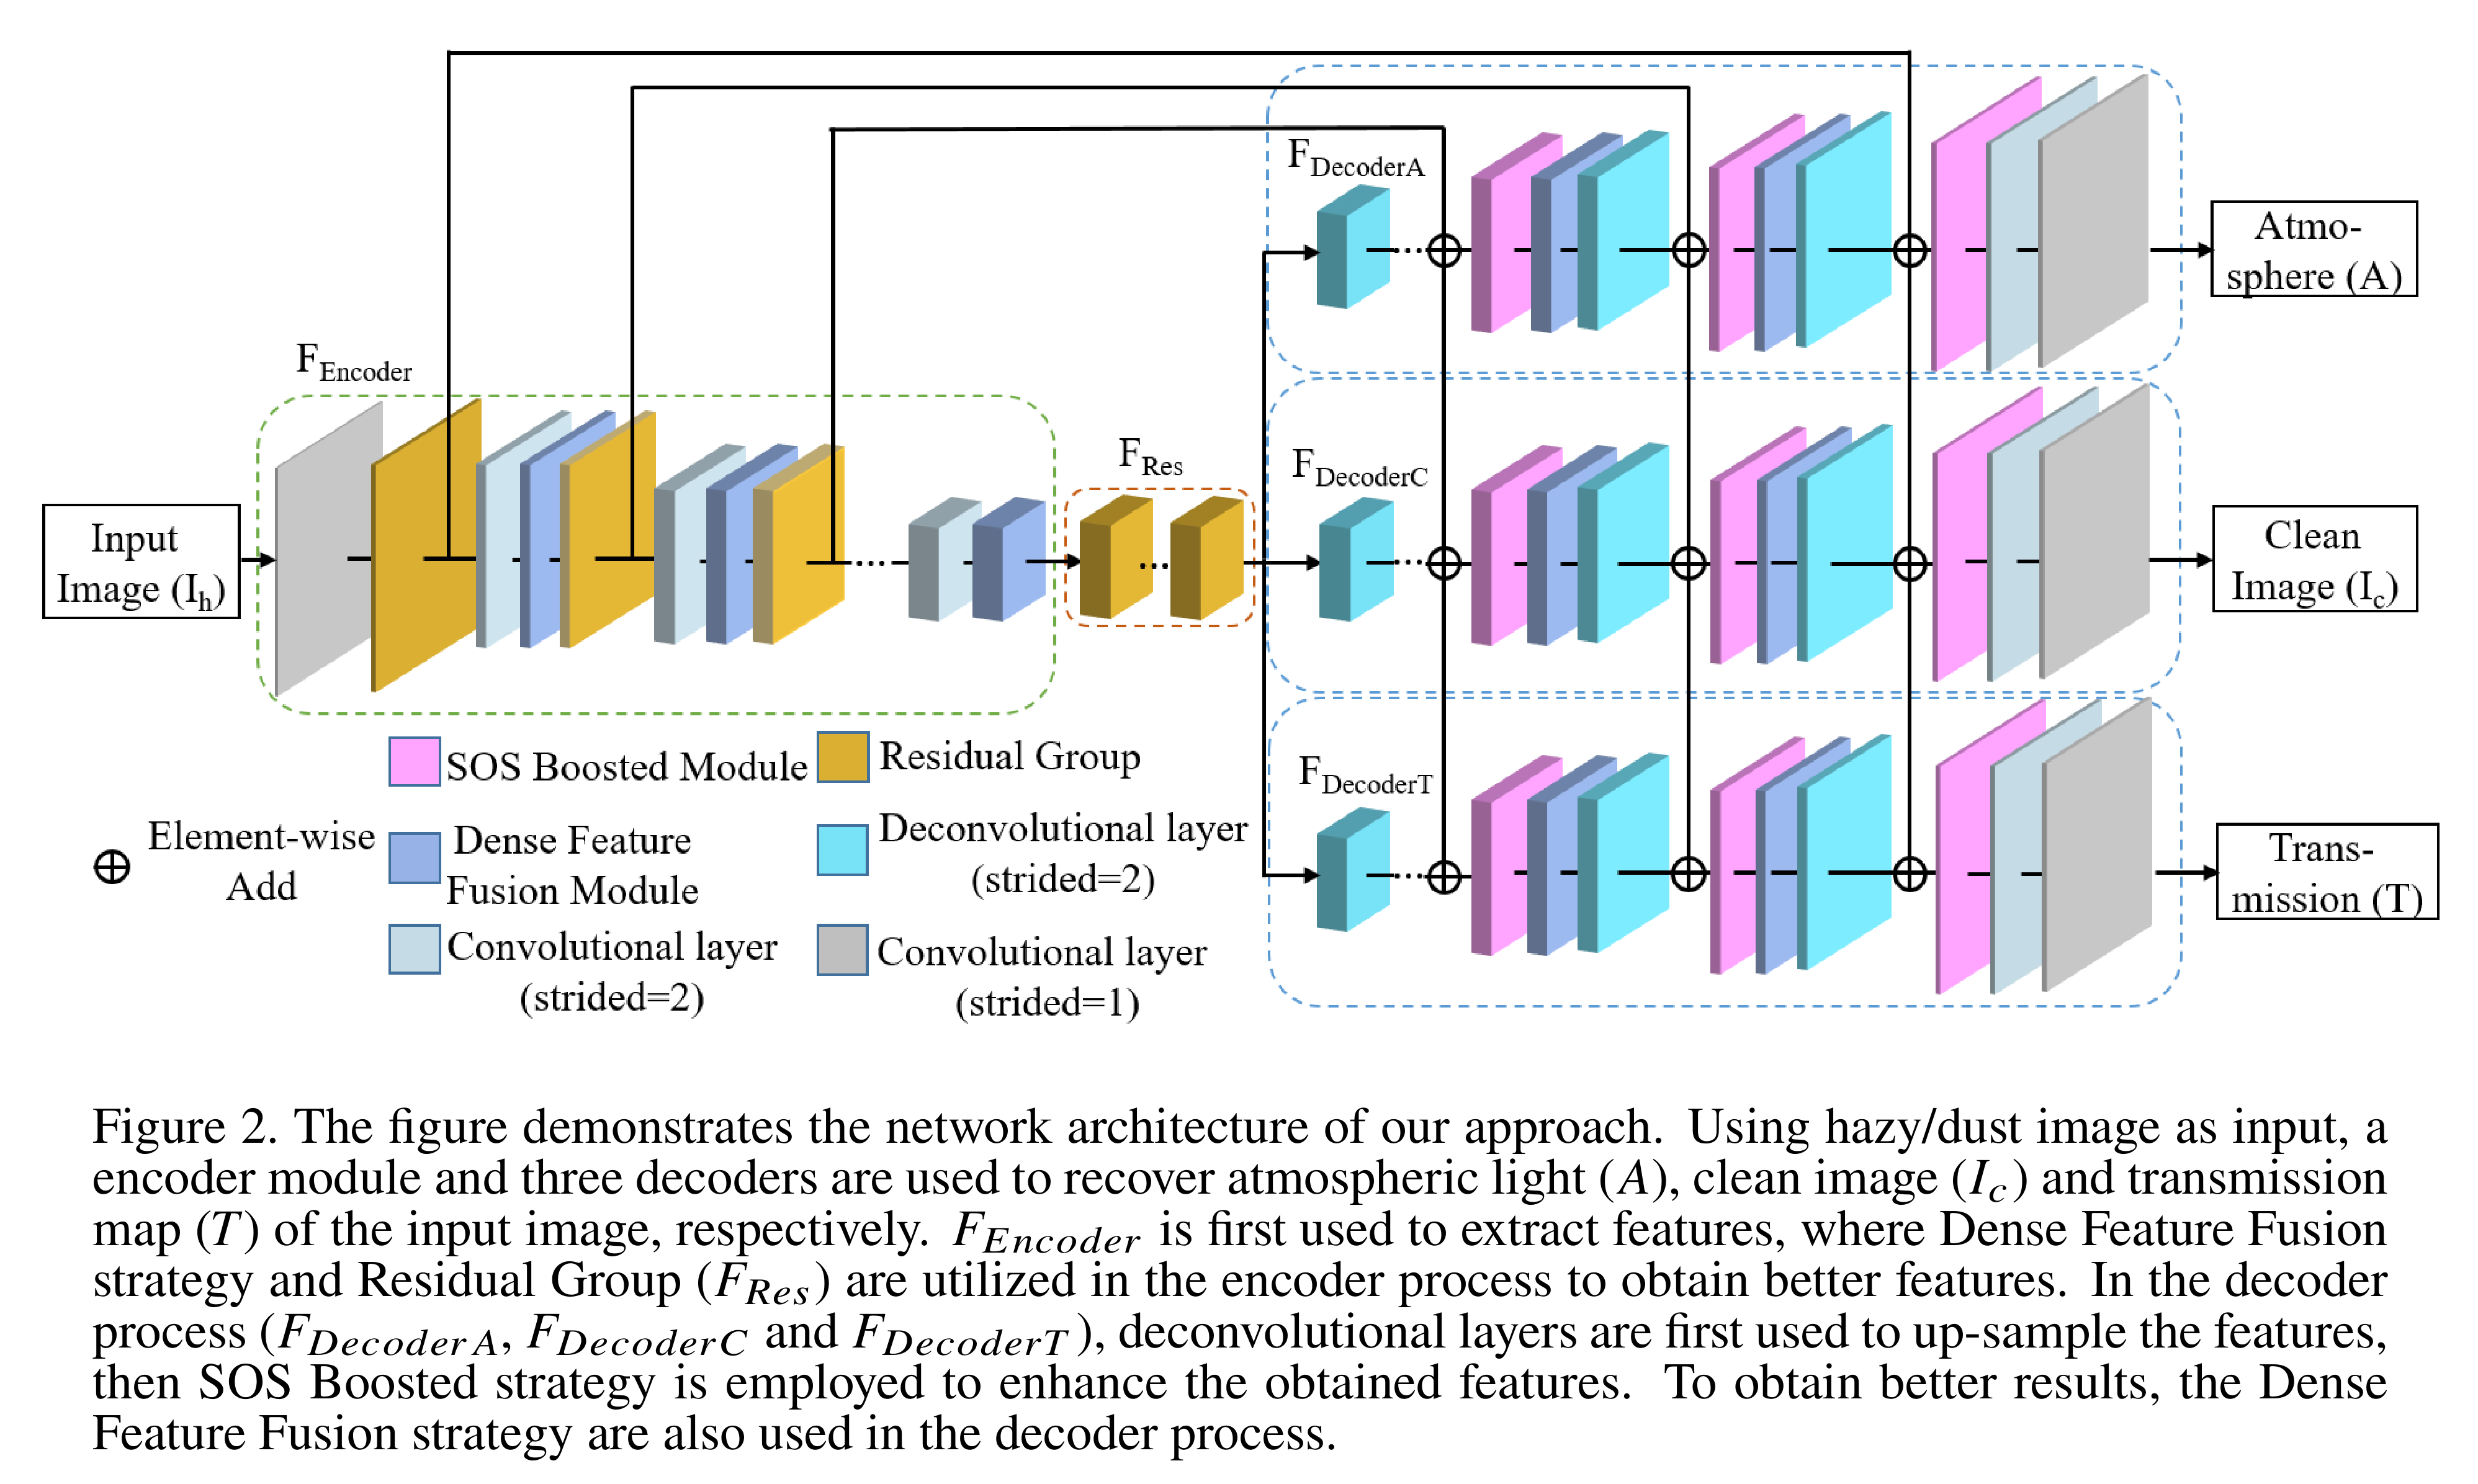 그림 설명: 먼지·안개 영상을 하나의 인코더로 압축한 뒤 세 디코더가 대기광 $A$, 깨끗한 영상 $I_c$, 투과도 $T$를 동시에 복원하고, Dense Feature Fusion·Residual Group·SOS boosting을 거치는 전체 네트워크 구조다. 원문 Figure 2, PDF p.3.
2) 요약
- 건설 현장의 먼지·안개 때문에 저하되는 검출·분할 성능을 회복하기 위해, 단일 RGB 영상에서 깨끗한 영상·대기광·투과도를 함께 추정하는 U-Net 계열 제진 네트워크를 제안한다.
- 핵심 새로움은 세 성분을 분리하는 것에 그치지 않고, 추정한 $A,I_c,T$로 입력 $I_h=T I_c+(1-T)A$를 다시 구성하여 출력이 물리적 산란 모델과 맞도록 폐루프 감독을 거는 점이다.
- 안개 제거에는 RESIDE의 실외 영상쌍 9,000개, 먼지 제거에는 실제 산업 현장의 먼지/무먼지 영상쌍 1,000개를 사용했다.
- 네 개의 안개 영상 예에서 3-디코더 모델은 1-디코더 기준선보다 PSNR과 SSIM이 모두 높았고, 실제 굴착·상차 영상에서는 먼지 제거 효과를 정성적으로 제시했다.
3) 방법
- 데이터 준비: 안개 제거는 RESIDE 실외 hazy/clean 쌍 9,000개를 사용하고, 먼지 제거는 동일 장면의 실제 dust/dust-free 쌍 1,000개를 별도로 수집한다.
- 증강: 각 영상쌍을 0.5-1.0 범위의 임의 스케일 세 가지로 리사이즈하고, 256×256 패치를 무작위 crop한 뒤 수평·수직 flip을 적용한다.
- 인코더: 첫 합성곱은 11×11, 나머지 합성곱·역합성곱은 3×3 커널을 사용한다. 인코더 안에 Dense Feature Fusion과 Conv-ReLU-Conv 구조의 residual block 3개를 배치해 다중 해상도 특징을 보존한다.
- 세 갈래 복원: 공유 특징을 대기광·깨끗한 영상·투과도용 디코더로 분기하고, 역합성곱 업샘플링, LReLU(negative slope 0.2), SOS boosting, decoder-side Dense Feature Fusion으로 각 성분을 출력한다.
- 폐루프 학습: 깨끗한 영상 정답과 $I_c$ 사이의 손실, 그리고 $A,I_c,T$로 재구성한 입력과 원 입력 사이의 손실을 각각 가중치 0.5로 결합한다. 다만 수식은 L1을, 구현 절은 MSE를 적어 손실의 정확한 구현은 원문 구현 세부 확인이 필요하다.
- 최적화·평가: Adam으로 100 epoch, batch 16, β₁=0.9, β₂=0.999, 10 epoch마다 학습률 감쇠 0.75를 사용하고 PSNR·SSIM으로 평가한다. 초기 학습률은 PDF에
104로 인쇄되어 있어 원문 구현 세부 확인이 필요하다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 결론에서 별도의 한계나 향후 연구를 제시하지 않는다.
- 분석상 한계: 해석: 먼지 모델은 실제 영상쌍 1,000개로 학습했지만 먼지 제거 성능은 정성 사례만 제시했고, 복원 영상이 검출·분할 성능을 실제로 높이는지는 평가하지 않았다. 또한 손실 종류와 초기 학습률 표기가 재현을 방해한다.
- 연구주제 제안: 먼지 농도별 합성·실제 데이터를 혼합하고 제진망과 객체검출/의미분할망을 task-aware loss로 공동학습하여, PSNR·SSIM뿐 아니라 mAP·mIoU와 추론 지연으로 효과를 검증한다.
- 연구주제 제안: 단일 영상 대신 연속 프레임의 광류와 산란 일관성을 이용하는 실시간 비디오 제진 모델을 개발하고, 깜빡임 지표·복원 품질·현장 검출률·FPS를 함께 평가한다.
2022 · TNS: 굴착기 지형 주행성 지도화·내비게이션
- 원문: 논문 PDF
1) 대표그림
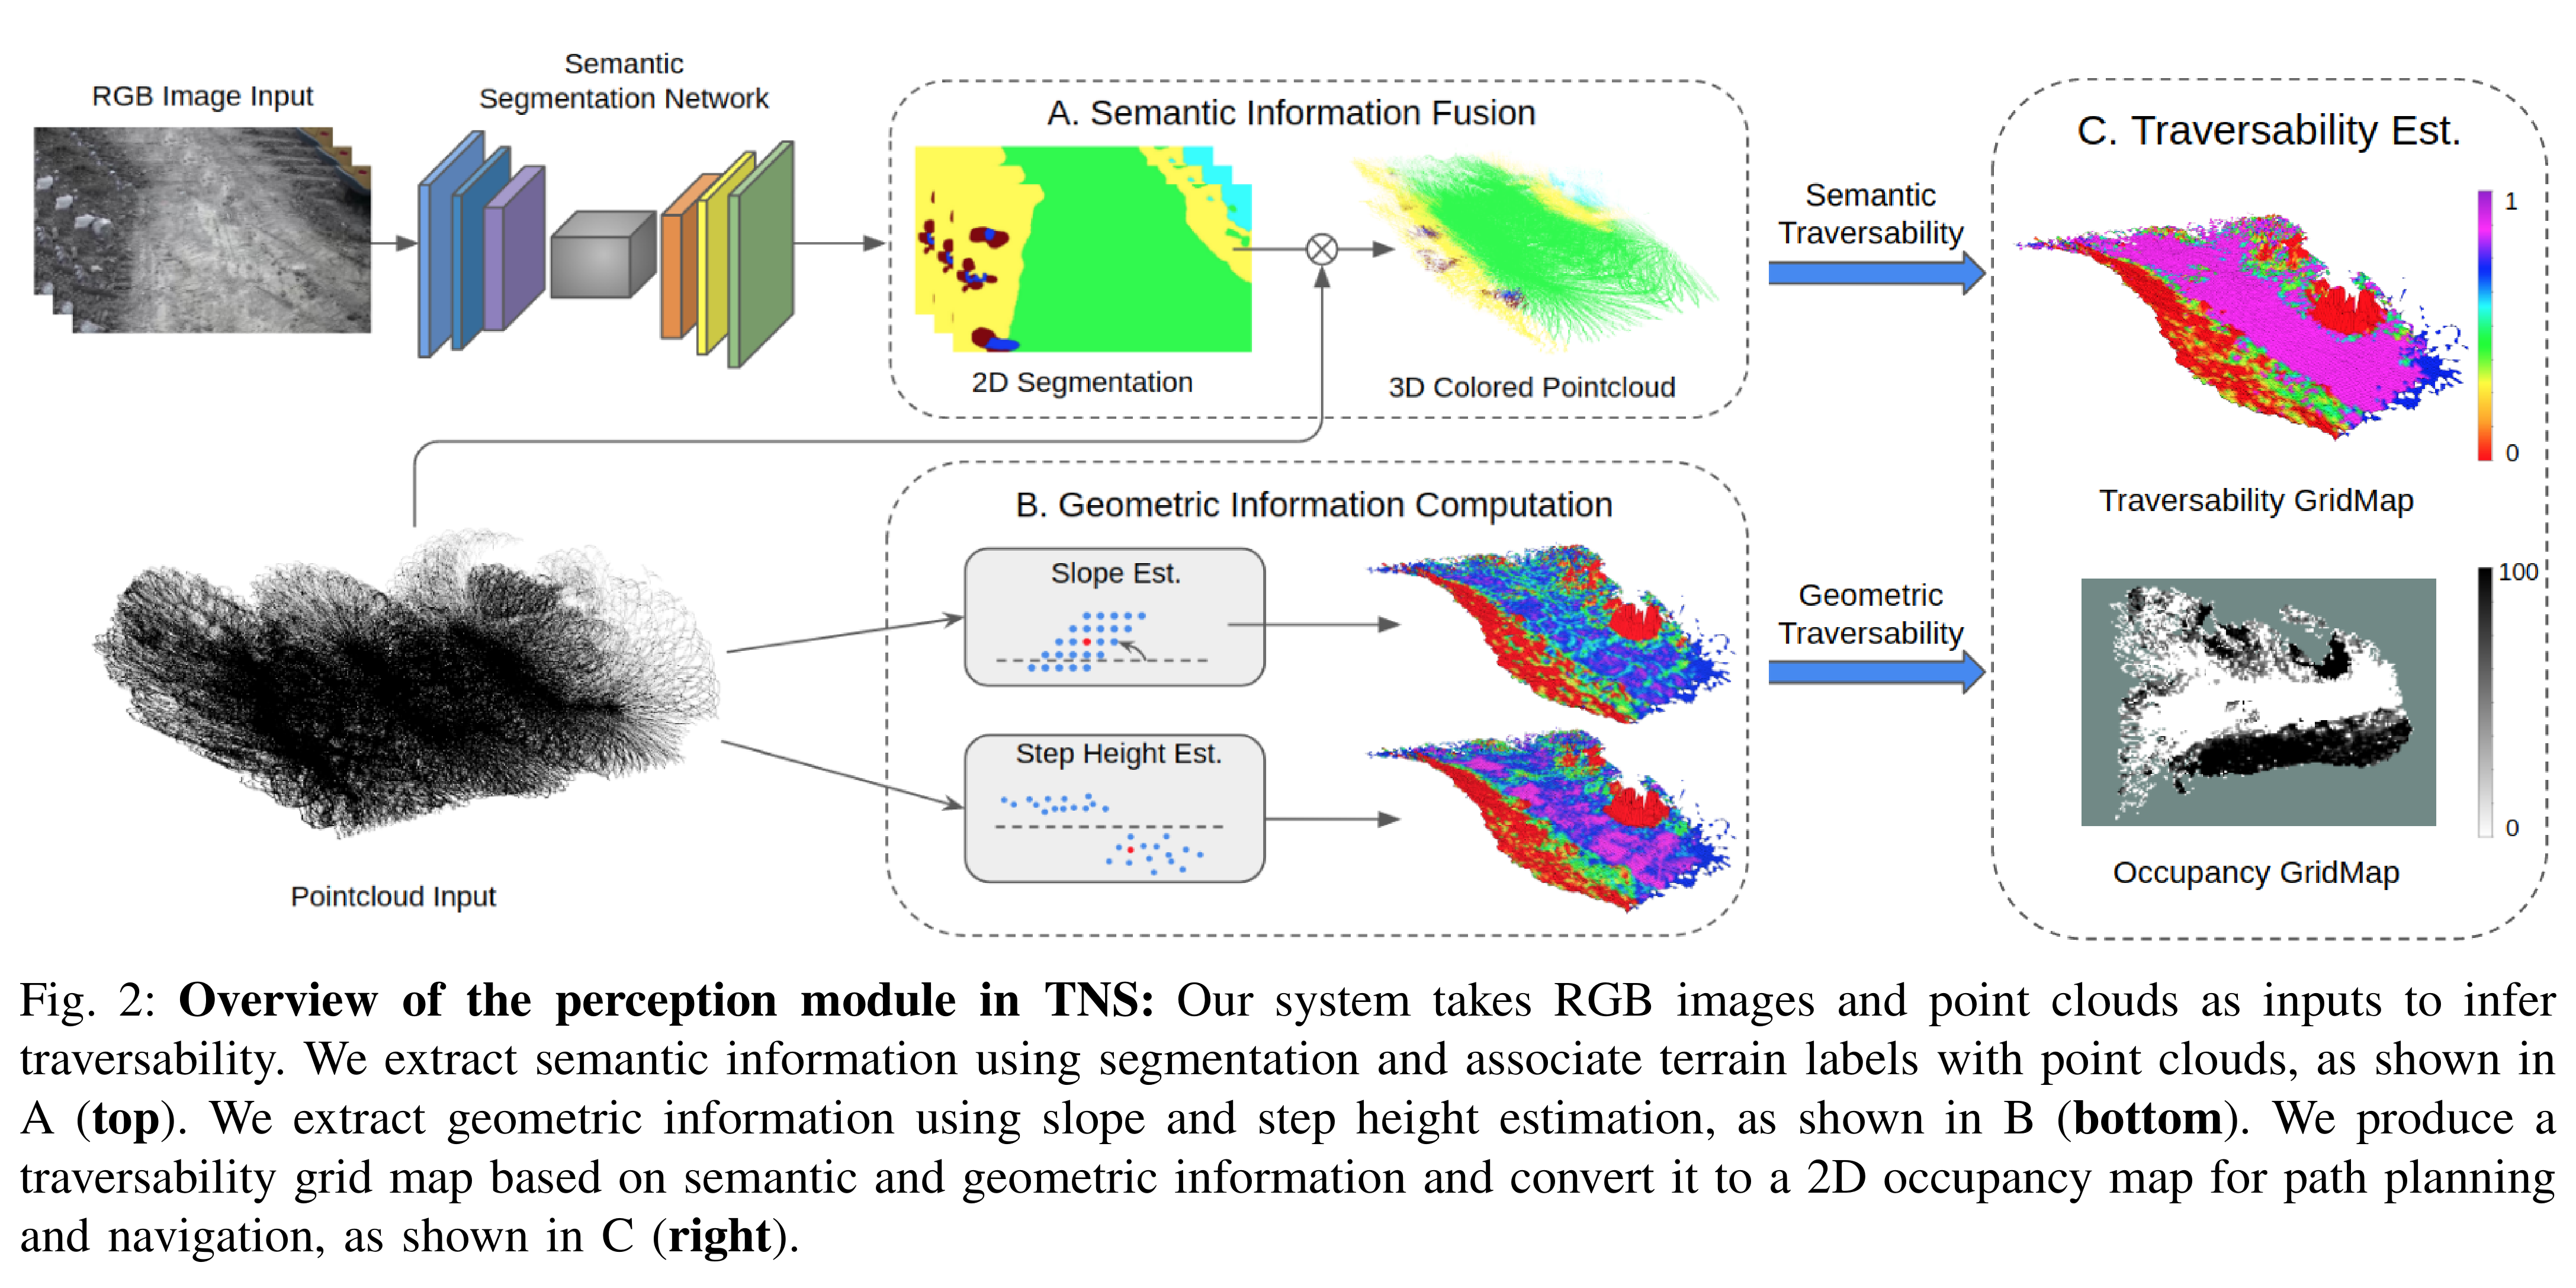 그림 설명: RGB 의미분할을 3D 점군에 투영하는 상단 경로와 LiDAR 점군에서 경사·단차를 계산하는 하단 경로를 융합하여 주행성 grid map과 planning용 occupancy grid map을 만드는 TNS 인지 모듈이다. 원문 Figure 2, PDF p.3.
2) 요약
- TNS는 RGB 카메라·3D LiDAR·GPS-RTK를 이용해 변화하는 비정형 건설 현장의 주행성 지도를 실시간 갱신하고, 수정 Hybrid A*와 추종 제어까지 연결한 49톤 굴착기용 통합 시스템이다.
- Fast-SCNN의 지형 의미와 점군 기반 경사·단차를 기계의 등판각·트랙 폭 제약에 따라 융합해, 위험물의 시각적 구분과 지형 형상의 기하학적 판단을 상호 보완한다.
- RELLIS-3D 평가에서 기존 방법보다 mAcc가 4.17-30.48% 높고 map MSE가 13.8-71.4% 낮았으며, 실제 시스템은 주행성 지도를 10 Hz로 갱신했다.
- 오프라인 경로계획 성공률은 TNS 82.6%, 기하 단독법 33.3%였고, 실제 세 종류 궤적에서는 평균 추종오차가 모두 10 cm 이내였다.
3) 방법
- 플랫폼·보정: XCMG XE490D에 Livox-Mid100 LiDAR, FOV 56.8°·pitch 30.3° RGB 카메라, GPS-RTK를 장착하고 카메라-라이다 외부·내부 보정과 시간 동기화를 수행한다. 계산은 i7-10875H, RAM 16 GB, RTX 2060 6 GB 노트북에서 수행했다.
- 의미분할 학습: 건설 현장 영상 669장을 7개 주행 관련 클래스로 픽셀 단위 주석한 CWT를 만들고, MMSeg 기반 Fast-SCNN을 240K iteration 학습한다. 세부 optimizer·batch·증강은 원문 구현 세부 확인이 필요하다.
- 시맨틱 지도화: 타임스탬프로 RGB와 점군을 대응시키고 보정행렬로 각 LiDAR 점을 분할 mask에 투영한다. 0.2 m elevation-grid 각 셀에는 최근 점들의 평균 높이, 갱신 시각, 경사, 단차, 의미 레이블을 저장한다.
- 기하 주행성: 8-neighborhood PCA로 표면 법선과 경사를 구하고, 7×7 이웃(약 1.4 m)의 최대 높이차로 단차를 구한다. XE490D 기준 $s_{cri}=35°$, $s_{safe}=10°$, $h_{cri}=0.35\,m$, $h_{safe}=0.10\,m$를 적용하되, 중간 구간 가중치 α₁·α₂의 실제 값은 원문 구현 세부 확인이 필요하다.
- 의미-기하 융합: rock·excavator·obstacle·water는 금지, flat은 안전으로 우선 지정하고, 나머지는 경사·단차 기반 연속 점수를 쓴다. 그 결과를 2D occupancy map으로 변환한다.
- 계획·제어: Hybrid A*의 노드 확장 비용에 두 트랙이 밟는 영역과 트랙 사이 영역의 평균 주행성 비용을 추가한다. 경로는 heading/cross-track error 기반 좌우 트랙 PI 추종 제어기와 종방향 PI 속도 제어기로 실행한다.
- 검증: CWT 분할 성능, RELLIS-3D map mAcc·AUC·MSE, 90회 이상 무작위 start-goal의 계획 성공률, 실제 직선·일반 회전·급회전 추종오차, 모듈별 runtime을 순서대로 측정한다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 작업자·다른 장비가 많은 위험 상황을 충분히 시험하지 못했고 49톤 굴착기 한 대만 평가했다. 향후 굴착기 형상, 특히 두 트랙 사이 공간을 활용하는 planner, 다양한 야외 지형 평가, 기계-기계·인간-기계 협업으로 확장한다.
- 분석상 한계: 해석: RTK 고도 오차가 약 20 cm이고 반복적인 흙더미 환경에서 SLAM이 불안정했으며, 임의 지형에서 Hybrid A*의 경로 평활성을 보장하지 못한다. 또한 문제정의는 큰 점수를 비주행으로 설명하지만 융합식과 그림은 0=금지, 1=안전으로 사용해 score convention 확인이 필요하다.
- 연구주제 제안: RTK·LiDAR·카메라를 factor graph로 결합하고 셀별 고도·의미 불확실성을 전파하는 주행성 지도를 개발하여, 고도 RMSE·map AUC/MSE·계획 성공률·재계획 횟수로 검증한다.
- 연구주제 제안: 트랙 접지면과 차체 roll/pitch 안정성을 직접 비용화한 형상 인지 planner를 만들고, 여러 중량급 굴착기에서 성공률·최소 여유거리·자세 안정성·주행 에너지로 비교한다.
2022 · TTM: 비정형 환경 굴착기 주행성 지도화
- 원문: 논문 PDF
1) 대표그림
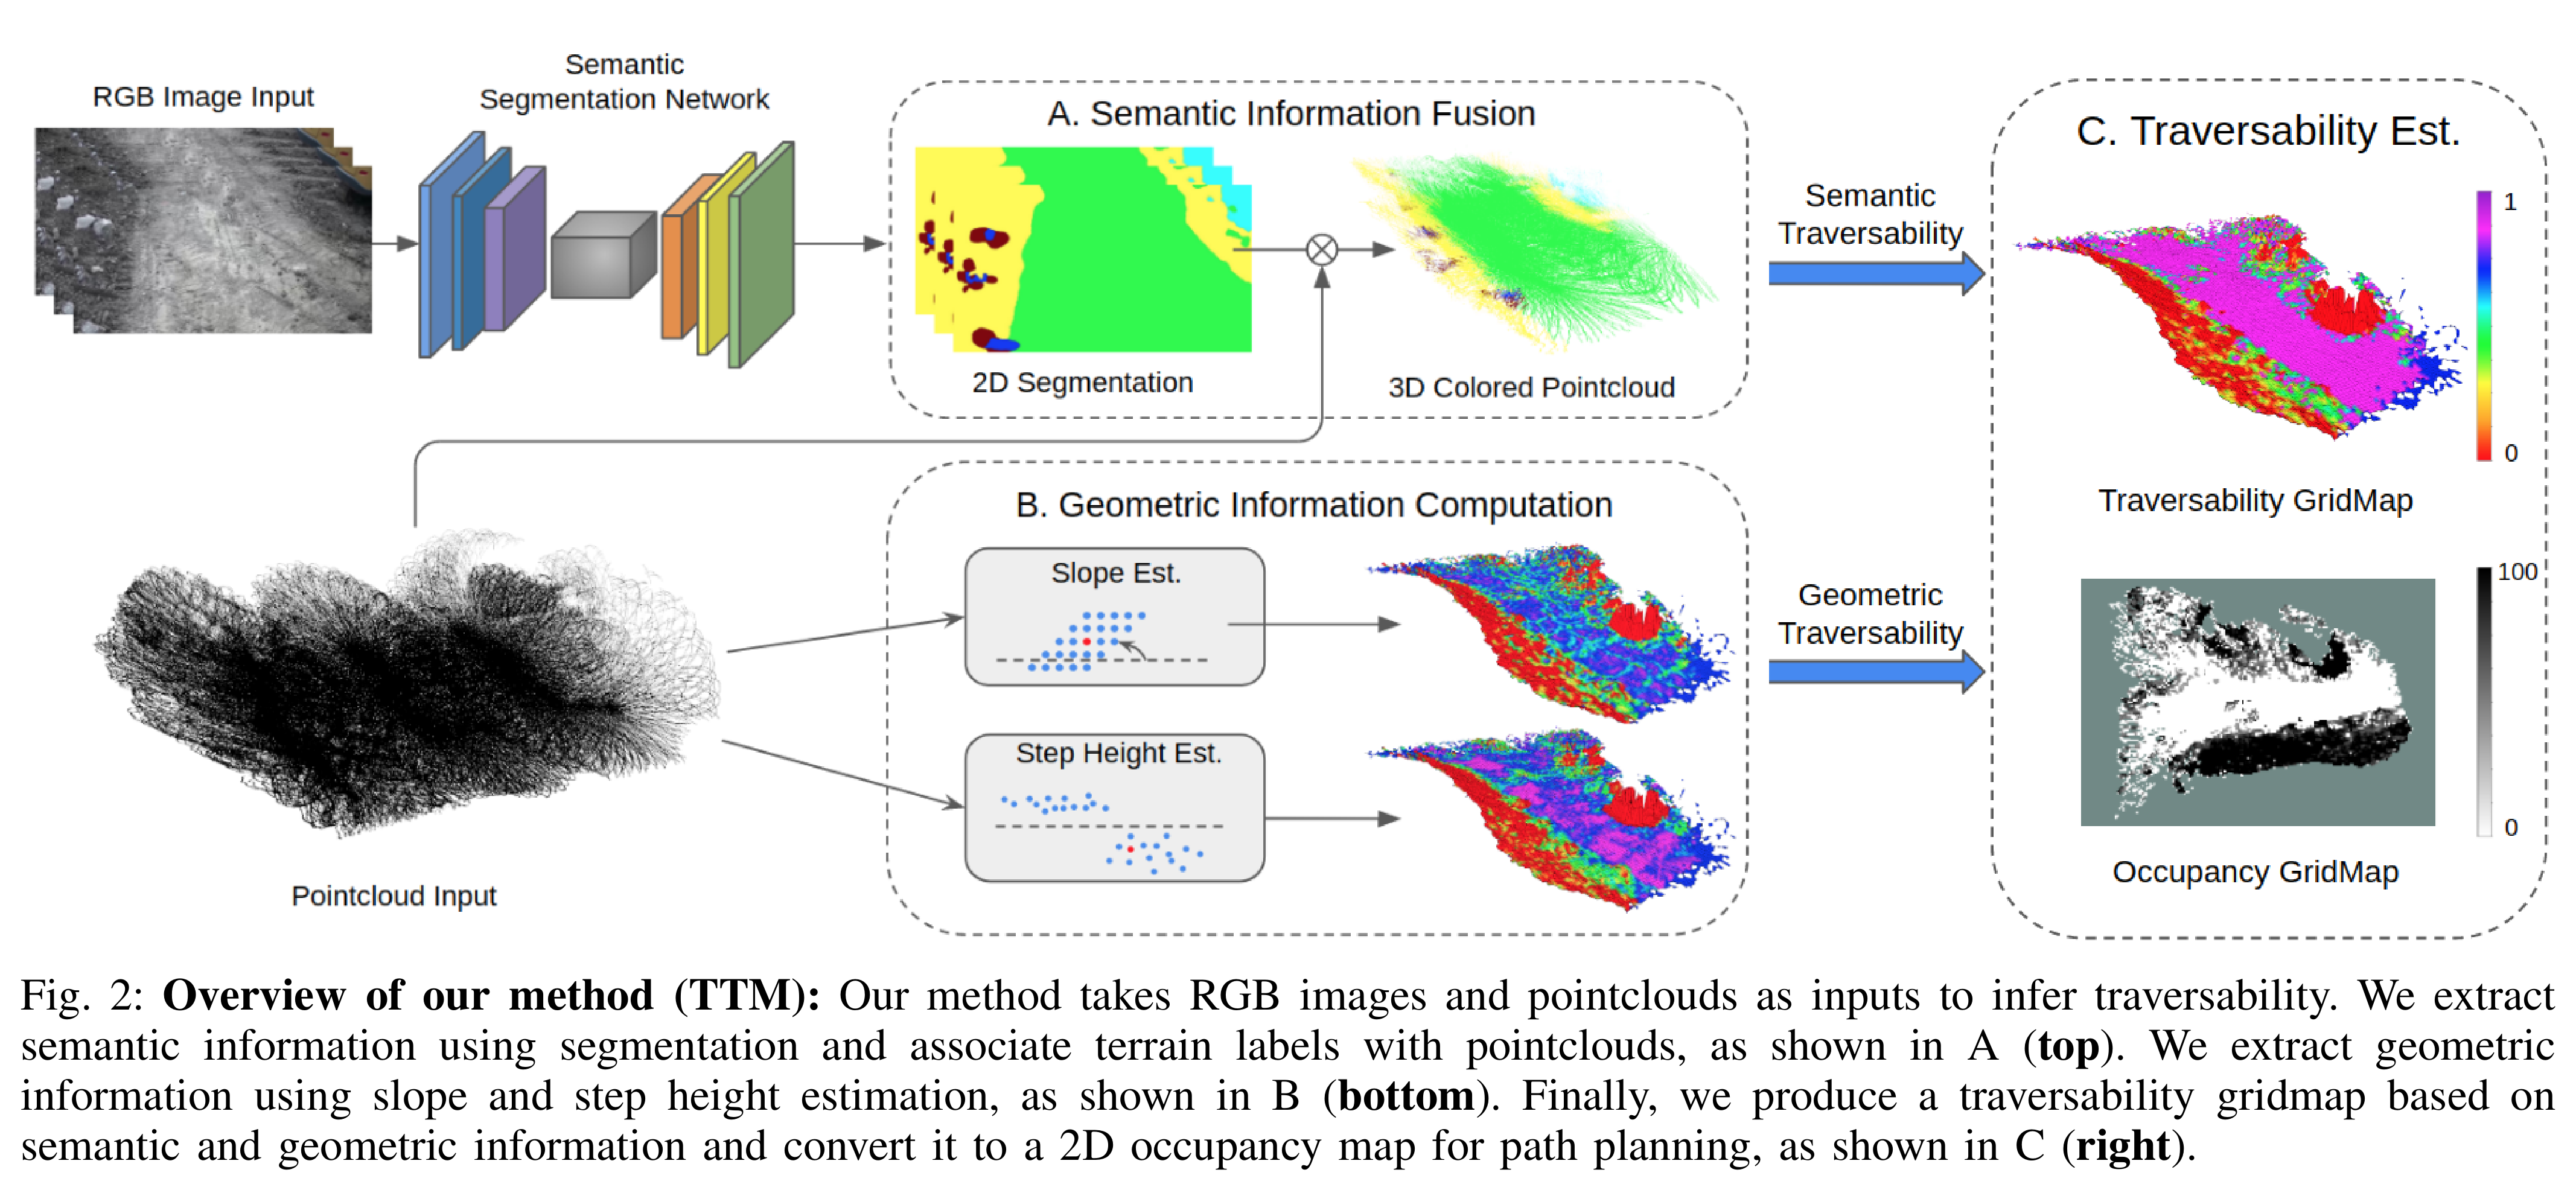 그림 설명: RGB-Fast-SCNN 의미 경로와 LiDAR 경사·단차 경로가 3D 셀 단위에서 결합되어 연속 주행성 지도와 Hybrid A*용 점유 지도를 만드는 TTM 전체 처리 흐름이다. 원문 Figure 2, PDF p.4.
2) 요약
- TTM은 굴착기 주변의 RGB·LiDAR·GPS-RTK를 결합해 비정형 건설 현장의 지형 의미와 기하학적 위험도를 하나의 전역 elevation grid에 누적하는 실시간 주행성 지도화 방법이다.
- 시각만으로 어려운 pit·hill은 점군 형상으로, 기하만으로 구별하기 힘든 물·돌·장애물은 의미분할로 판별하고, 등판각·트랙 폭 같은 기계 사양을 안전 임계값에 반영한다.
- AET로 학습한 Fast-SCNN은 mIoU 68.75%, overall accuracy 84.49%를 보였고, 전체 지도는 10 Hz로 갱신됐다.
- 90회 이상의 planning 시험에서 TTM 기반 Hybrid A* 성공률은 82.6%, 기하 단독 지도는 33.3%로 49.3%p 차이를 보였다.
3) 방법
- 수집·라벨링: 건설 현장 약 30분 영상에서 1920×1080 RGB 669장을 뽑아 flat, bumpy, mixed water/dirt, water, rock pile, obstacle, excavator의 7개 클래스로 주석하고 9:1로 분할한다.
- 분할망 학습: Fast-SCNN을 GTX 1080 두 장에서 240K iteration, SGD(lr 0.12, momentum 0.9), polynomial decay(power 0.9)로 약 이틀 학습한다. batch·crop·weight decay는 원문 구현 세부 확인이 필요하다.
- 센서 융합 전처리: XCMG XE490D의 Livox-Mid100, HIK RGB 카메라, RTK를 시간 동기화하고, 보정행렬로 2D 분할 레이블을 각 3D 점에 투영한 뒤 셀 내 다수결 의미 레이블을 구한다.
- 기하 특징 계산: 0.2 m grid에서 8-neighborhood PCA로 경사를, 7×7 이웃의 최대 높이차로 단차를 구한다. $s_{cri}=30°$, $s_{safe}=10°$, $h_{cri}=0.35\,m$, $h_{safe}=0.10\,m$, α₁=α₂=0.5로 연속 $T_{geo}$를 계산한다.
- 주행성 융합·후처리: rock·excavator·obstacle·water는 0, flat은 1, 나머지는 $T_{geo}$를 사용한다. 작은 금지영역은 평균 점수, 높이, x/y span이 트랙 간격 절반보다 작은지를 함께 검사해 제거한다.
- 계획·출력: occupied threshold 0.6, 최대 단차 0.35 m, 트랙 간격 2.75 m로 occupancy grid를 만들고 Hybrid A* 경로를 생성해 motion controller에 보낸다.
- 평가: 분할 mIoU/accuracy, 모듈 runtime, 기하 단독법 대비 map 연결성·장애물 검출, 무작위 start-goal planning 성공률을 측정한다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 전복 위험 때문에 매우 울퉁불퉁하거나 급경사인 실제 지형을 충분히 시험하지 못했고, 기존 planner가 트랙 사이로 작은 장애물을 넘는 굴착기 고유 능력을 활용하지 못했다. 향후 기계 사양을 적극 이용하는 planner로 극한·위험 환경의 완전 자율주행을 목표로 한다.
- 분석상 한계: 해석: 669장·단일 현장 중심 학습은 날씨·토질·카메라 변화에 취약할 수 있고, 의미 클래스를 규칙으로 0/1에 매핑해 불확실성과 미지 지형을 표현하지 못한다. 또한 임계값은 특정 XE490D에 강하게 결합되어 있다.
- 연구주제 제안: 여러 현장·계절의 미라벨 데이터를 self-training과 domain adaptation으로 흡수하고 셀별 uncertainty를 출력하는 TTM을 개발하여, 현장 간 mIoU·ECE·map AUC/MSE·주행 성공률로 검증한다.
- 연구주제 제안: 의미·경사·단차와 차체 자세의 시계열을 입력으로 전복확률을 직접 예측하는 risk map을 학습하고, 규칙 기반 TTM 대비 위험 recall·false-safe rate·roll/pitch peak로 비교한다.
2022 · VINet: 시각·관성 기반 미지 지형 분류와 적응 주행
- 원문: 논문 PDF
1) 대표그림
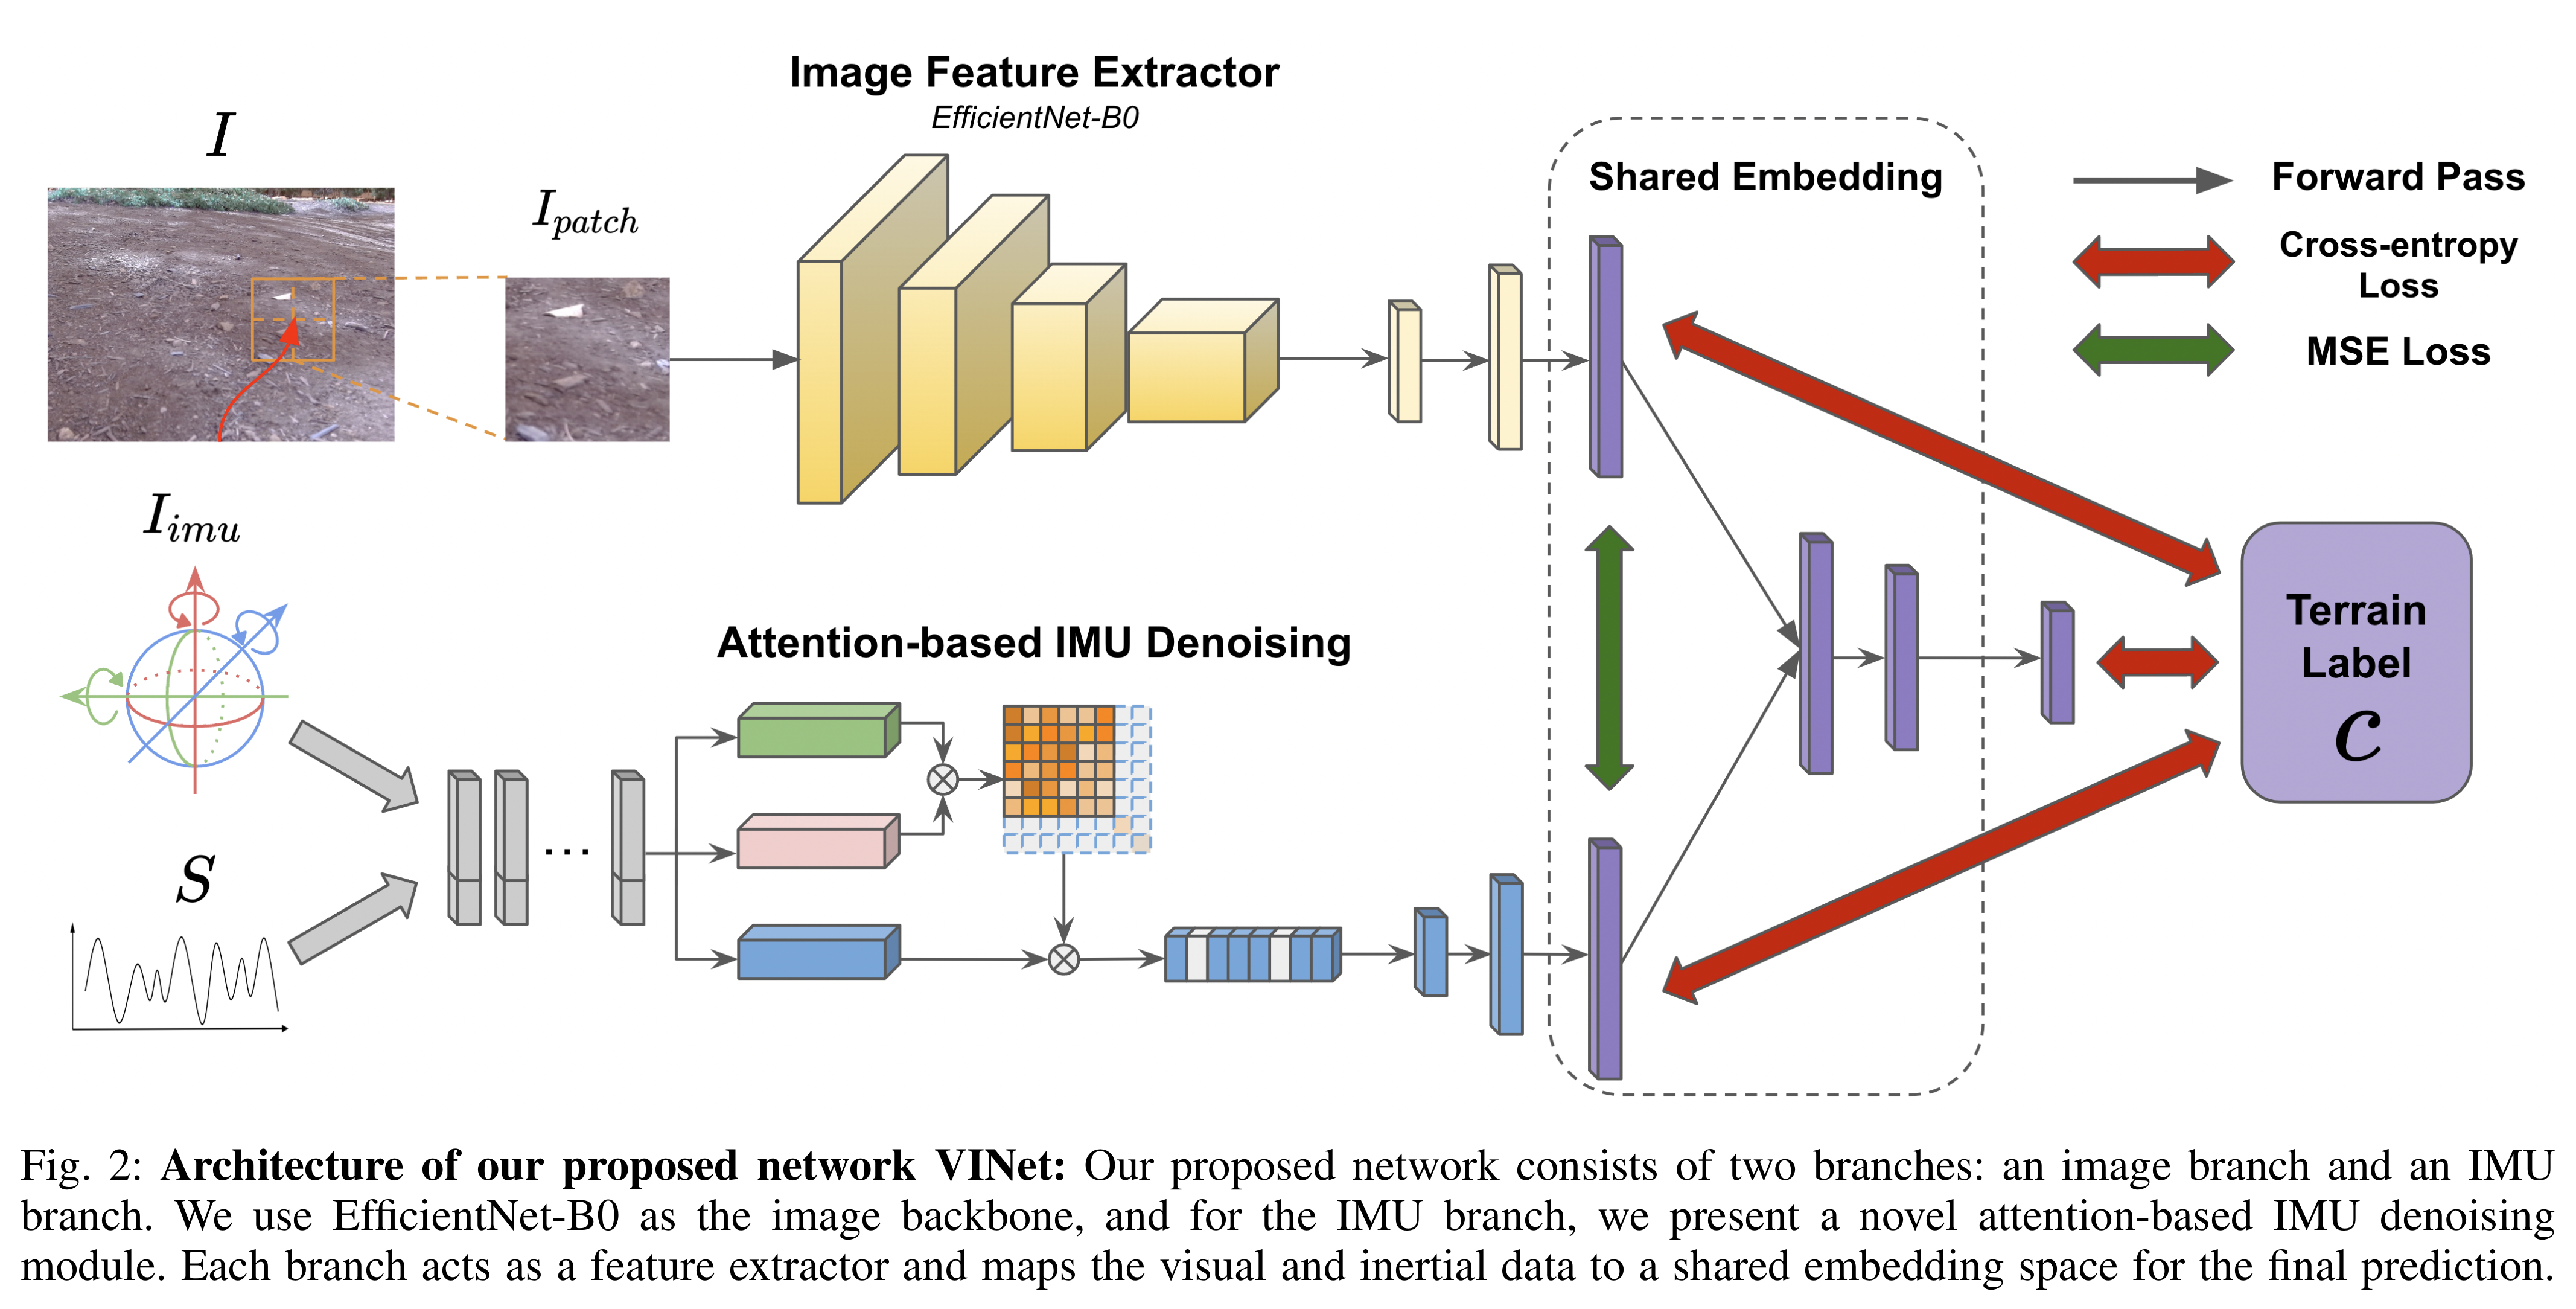 그림 설명: 예상 경로의 영상 patch는 EfficientNet-B0로, IMU와 PWM 시퀀스는 attention 기반 denoising으로 처리한 뒤 두 특징을 shared embedding에서 정렬·융합하여 지형-제어기 레이블을 출력하는 VINet 구조다. 원문 Figure 2, PDF p.3.
2) 요약
- VINet은 지형의 이름이 아니라 “어떤 기학습된 제어기가 이 지형에서 추종오차가 가장 작은가”로 레이블을 정의하여, 처음 보는 표면도 알려진 제어기 중 가장 적합한 하나에 연결한다.
- 영상 branch와 IMU+PWM branch를 shared embedding에 정렬하고, attention이 낮은 IMU 시점을 버리는 denoising과 채널별 learnable fusion을 사용해 시각적 유사성만으로는 구별하기 힘든 주행 특성을 반영한다.
- 11개 알려진 지형의 supervised 분류 정확도는 98.37%였고, 5개 알려진 지형으로 학습해 6개 미지 지형을 분류한 최상 설정은 76.48%였다.
- 적응 제어의 lateral RMSE는 0.026 m로 carpet 고정 제어기 0.050 m, mulch 고정 제어기 0.029 m보다 낮았다.
3) 방법
- 데이터·레이블: 11개 표면에서 1280×720 영상 4,923장과 30 Hz 관성 시퀀스를 수집한다. 알려진 지형마다 약 1,500개의 {PWM $S$, 선·각속도 $u$} 쌍으로 GP를 맞추고 NMPC를 수동 tuning한 뒤, 미지 지형은 추종 MSE가 가장 낮은 알려진 제어기의 레이블로 지정한다.
- 입력 정렬: 현재 속도·heading으로 예상 경로의 128×128 RGB patch를 뽑고, 그 영역을 주행할 때의 6축 IMU와 모터 PWM을 길이 $D=60$으로 정렬한다. attention 상위 $f_s=5/6$ 시점만 유지한다.
- 영상 branch: ImageNet-pretrained EfficientNet-B0로 patch를 1,280-channel 7×7 특징까지 추출한 뒤 flatten, 두 개의 linear layer, batch normalization, dropout으로 256 또는 512차원 $F_{img}$를 만든다.
- 관성 branch: $H=[I_{imu};S]$에 self-attention을 적용하고 attention map 대각값이 낮은 시점을 제거한 뒤 linear layer·batch normalization·flatten으로 동일 차원의 $F_{imu}$를 만든다.
- 융합·손실: 채널별 learnable weight로 두 특징을 융합한다. 각 branch와 최종 head에 cross-entropy를 걸고 $F_{img}$와 $F_{imu}$ 사이 MSE로 shared embedding을 정렬한다. 각 손실의 상대 가중치와 FC/dropout 세부는 원문 구현 세부 확인이 필요하다.
- 학습: Adam(lr 0.0003, exponential decay 0.95), batch 128, 200 epoch, RTX 2080 Ti 한 장을 사용한다. 미지 지형 실험의 최고 설정은 ImageNet pretraining, 8차원 IMU+PWM 입력, shared dimension 256이다.
- 적응 제어: Jetson AGX Orin에서 VINet이 지형 레이블을 출력하면 그 레이블의 NMPC와 RBF-kernel GP(PWM-속도 변환)를 즉시 선택한다. RPLiDAR-A3는 경로추종 위치 정보, C920은 영상, 3DM-GX5-25는 IMU를 제공한다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 한 장소에서 여러 미지 지형을 동시에 찾기 어려워 단일 주행에서 다양한 미지 지형 전환을 충분히 시험하지 못했다. 향후 navigation-based label을 더 잘 활용하는 제어기 설계와 traversability analysis·obstacle avoidance 통합을 제안한다.
- 분석상 한계: 해석: IMU 기반 판별은 로봇이 이미 표면에 진입한 뒤에야 강한 정보를 얻고, 모든 미지 지형을 기존 제어기 중 하나로 강제 매핑하므로 적합한 제어기가 없는 open-set 상황에서 안전한 거부가 없다. 평가도 소형 tracked robot과 제한된 표면에 국한된다.
- 연구주제 제안: embedding distance와 controller-performance model로 open-set uncertainty를 추정하고 임계값 이상이면 저속 안전 제어기로 전환하는 VINet을 개발하여, unknown AUROC·controller-selection regret·추종 RMSE·안전개입 횟수로 검증한다.
- 연구주제 제안: 전방 RGB/LiDAR의 예견 정보와 과거 IMU를 결합해 지형 경계 전에 제어기를 선제 전환하는 모델을 만들고, 전환 지연·경계구간 RMSE·slip ratio·충돌/불안정 사건 수로 평가한다.
[!summary] C. 동작·궤적 계획 기구학적 도달성, 토양 상호작용 제약, 연속 궤적 최적화와 모방학습 결합을 다룬다.
2019 · 굴착기 동작계획을 위한 Compact Reachability Map
- 원문: 논문 PDF
1) 대표그림
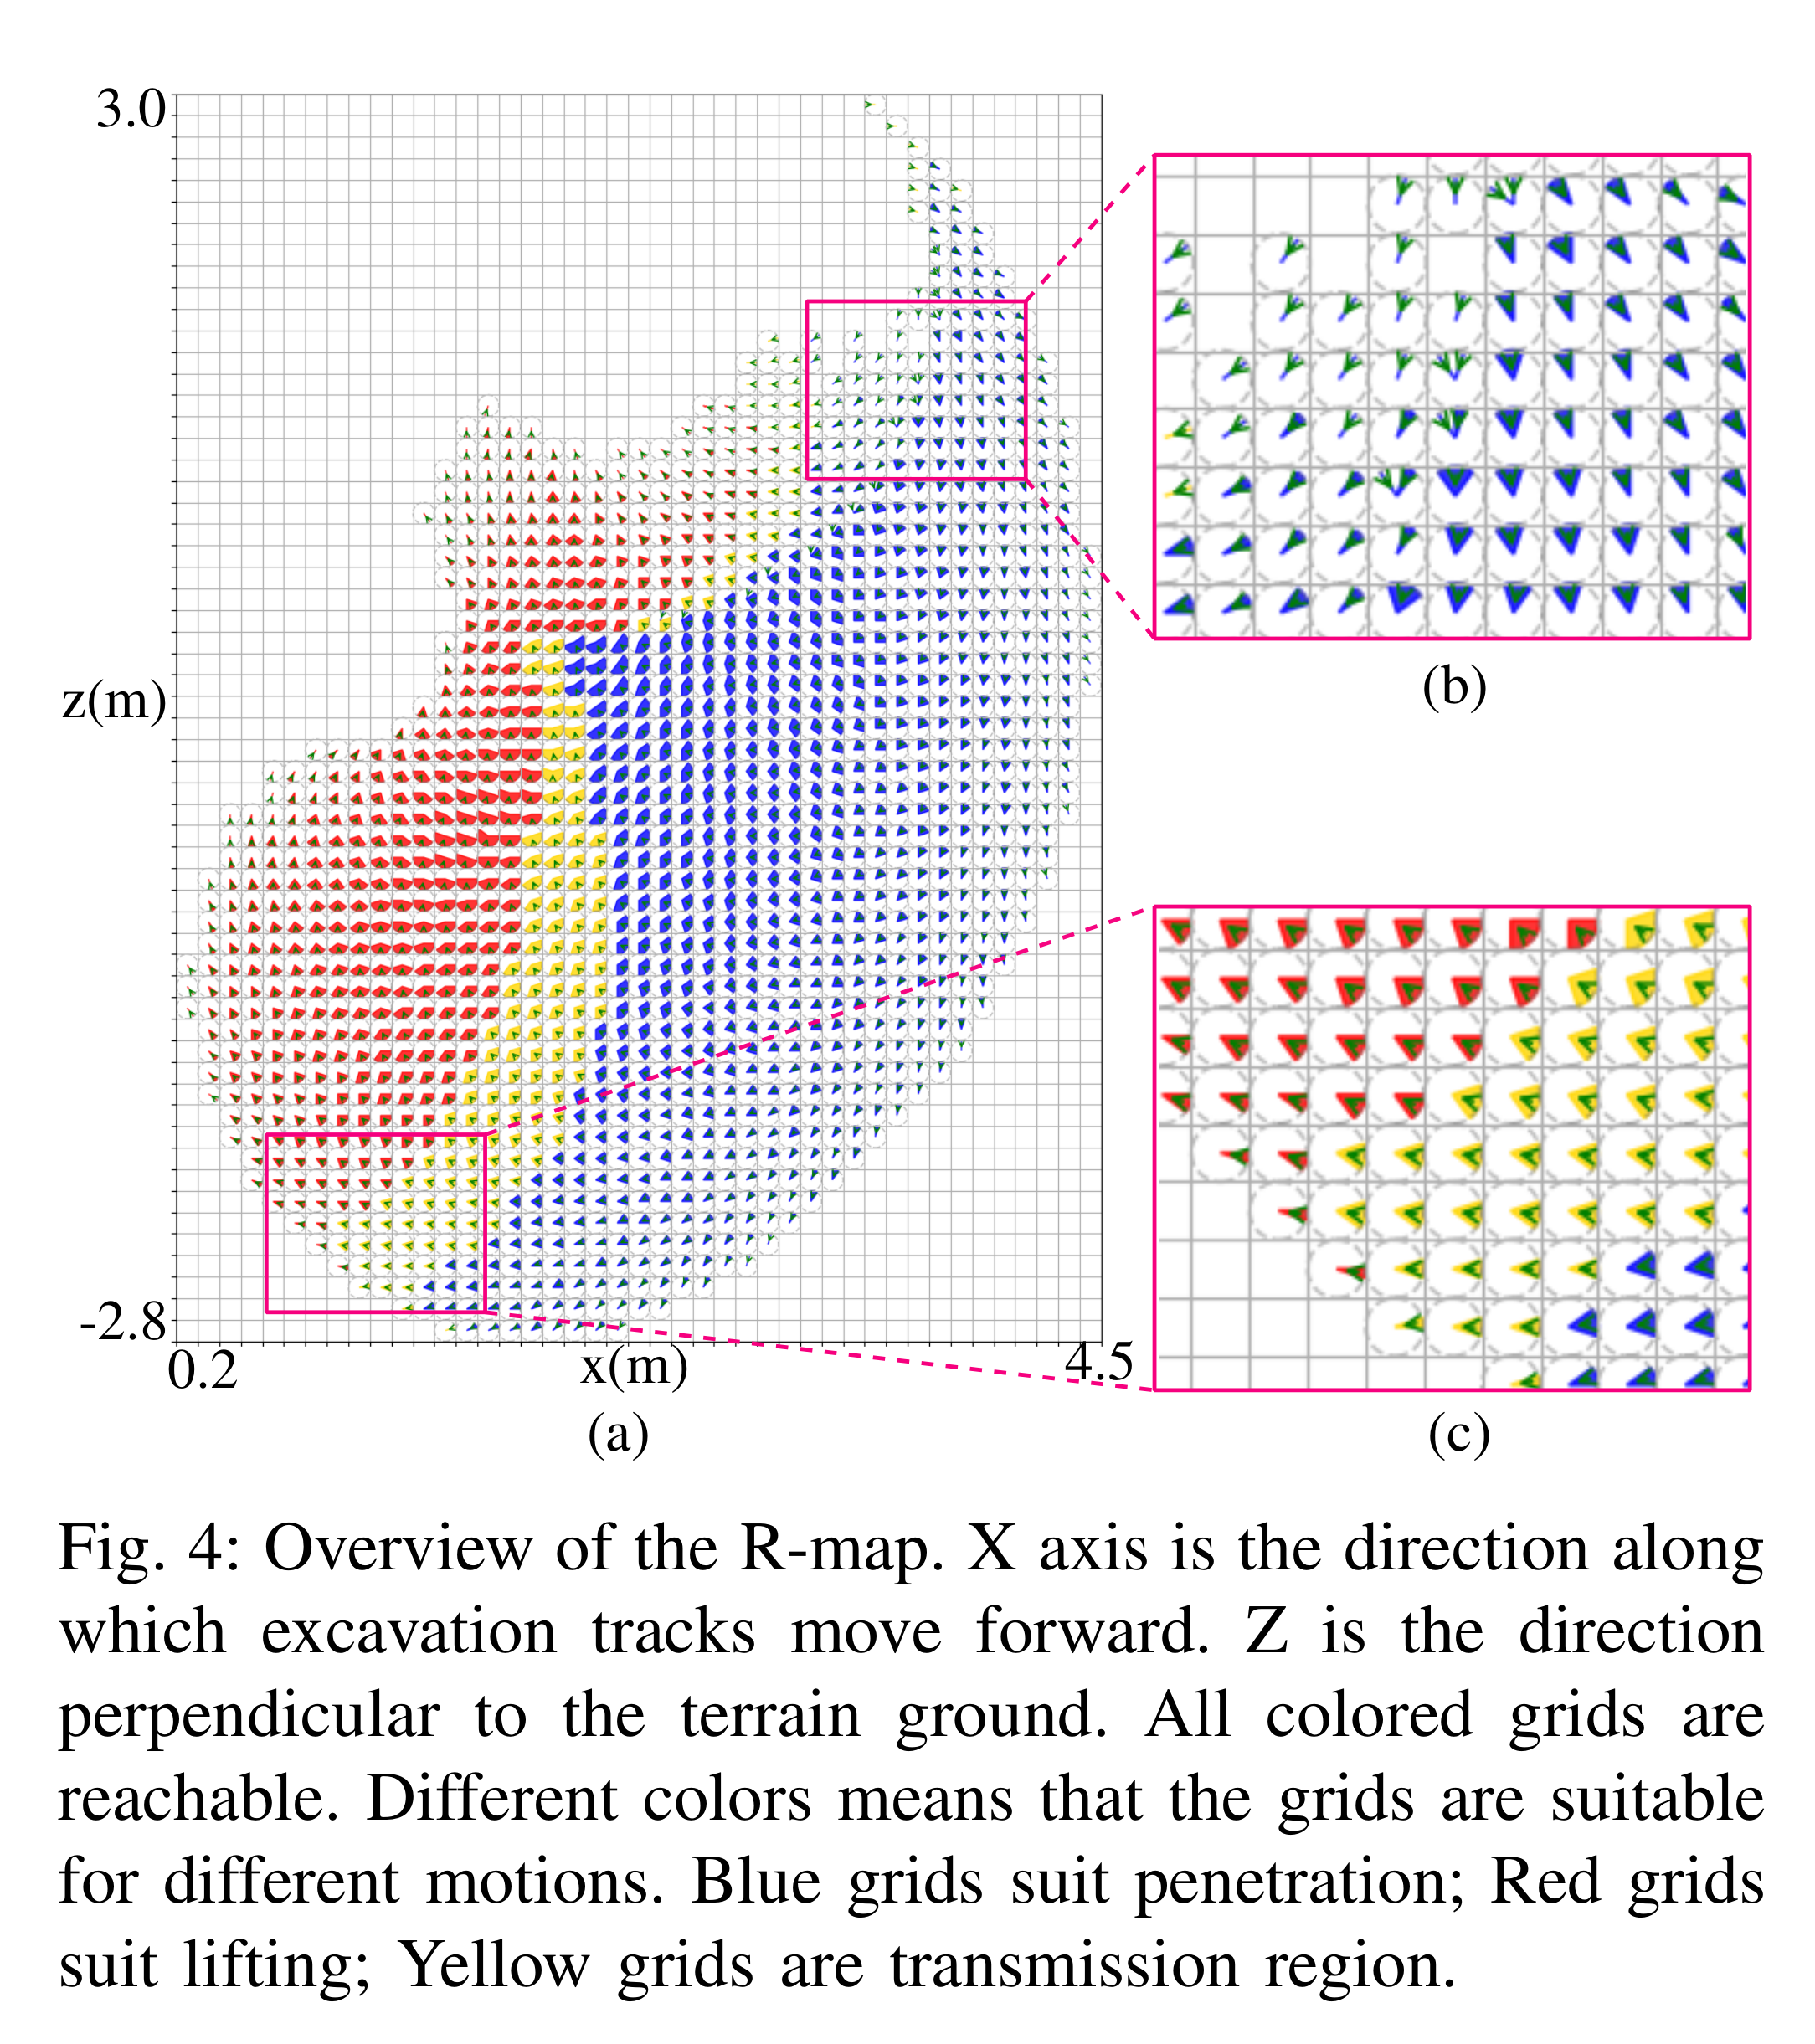
그림 설명: 굴착 평면의 각 격자에 버킷의 도달 가능한 자세 방향을 저장하고, 침투·인양·전이 동작에 적합한 작업영역을 색으로 구분한 2차원 R-map이다. 원문 Fig. 4, PDF p.3.
2) 요약
- 굴착기의 기구학 때문에 가능한 버킷 자세와 직선 이동 능력을 미리 계산해 두는 2차원 Compact Reachability Map(R-map)을 제안한다. 붐·암·버킷이 만드는 굴착 평면에 문제를 한정하고, 차체 회전·경사는 강체변환으로 처리해 3차원 맵보다 작게 만든 것이 핵심이다.
- 각 격자에는 도달 가능한 버킷 헤딩 구간과 방향별 최대 직선 이동 길이를 저장한다. 온라인 계획기는 이 정보를 조회해 침투-드래그-회전-인양으로 이어지는 full-bucket 후보를 빠르게 구성한다.
- AGX Dynamics의 2.5D height map 지형에서 연속 굴착을 검증했으며, 실험 모델의 R-map은 0.1 m × 0.1 m 격자·0.1π 각도 해상도로 약 7분에 한 번 생성되고, 단일 굴착 계획은 평균 50 ms가 걸렸다.
3) 방법
- 입력 준비: 굴착기 CAD/링크 치수와 관절 한계, 버킷 형상, 현재 지형 height map, 목표 지형, 접근점 $P_a$를 준비한다. 실제 센서로 height map을 만드는 절차는 논문에 없으므로 원문 구현 세부 확인 필요.
- R-map 생성: 굴착 평면을 격자로 나누고, 각 격자의 내접원에 균일하게 배치한 버킷 자세에 역기구학을 적용한다. 해가 있는 헤딩을 하나 이상의 도달 가능 구간 $[\theta]$로 저장한다.
- 직선 이동 능력 계산: 각 격자와 샘플 이동방향 $\alpha$에서 다음 격자로 진행하며 $[\theta]$의 교집합이 빌 때까지 추적한다. 구간 차집합으로 헤딩별 최대 이동거리 $L$을 구해 $CT_i={(\alpha_j,L_j)}$로 등록한다.
- 침투·드래그 계획: 지표면 법선과 정렬되고 버킷 면이 토양을 누르지 않는 침투 방향/헤딩을 R-map에서 고른다. 버킷 경로 위 토량으로 굴착량을 근사해 침투·드래그 길이를 정하고, 도달 구간 안에서 헤딩 변화가 작고 단조롭게 회전하도록 보간 최적화를 푼다.
- 회전·인양 계획: 토사 유실을 줄이도록 인양 방향과 버킷 헤딩을 수직 부근으로 제한한다. 버킷을 감싸는 삼각형과 지면 사이 최소 간격 제약으로 회전 시작점 높이를 정한 뒤 드래그 종료점에서 인양 경로를 탐색한다.
- 출력·평가: 각 버킷 자세를 관절 구성으로 변환해 궤적을 실행하고, 매 굴착 뒤 갱신된 height map을 다음 계획에 넣는다. 계획시간, 버킷 적재, 목표 height map 오차와 기구학적 도달성을 평가한다.
4) 토의
- 논문이 밝힌 한계/향후 연구: 현재는 주로 기구학 제약만 다루므로, 과제 수준의 최적 베이스 배치, 액추에이터 토크 한계 등 동역학 제약과 미지 지형 적응 제어의 결합, 실제 굴착기 검증이 후속 과제다.
- 해석: 굴착을 2차원 평면과 정적 height map으로 단순화하고 토양-버킷 힘을 계획 변수에 넣지 않았기 때문에, 비균질 토양·측방 운동·침하가 큰 현장에서는 R-map상 가능 경로가 실제로는 과부하나 미끄러짐을 일으킬 수 있다.
- 연구주제 제안: 지각-동역학 결합 적응형 R-map - 온라인 토크·유압압력·지형 갱신으로 격자별 실행 가능도를 보정하고, 기존 R-map 대비 굴착 성공률·토크 한계 위반률·계획지연·버킷 충전율을 비교한다.
- 연구주제 제안: R-map 기반 굴착기 베이스 재배치와 굴착 순서 공동 최적화 - 목표 토공 형상 전체를 대상으로 베이스 위치와 굴착 시퀀스를 함께 선택하고, 베이스 이동 횟수·총 사이클 시간·미굴착 체적을 검증한다.
2020 · 시간 가변 최소 토크 궤적 최적화
- 원문: 논문 PDF
1) 대표그림
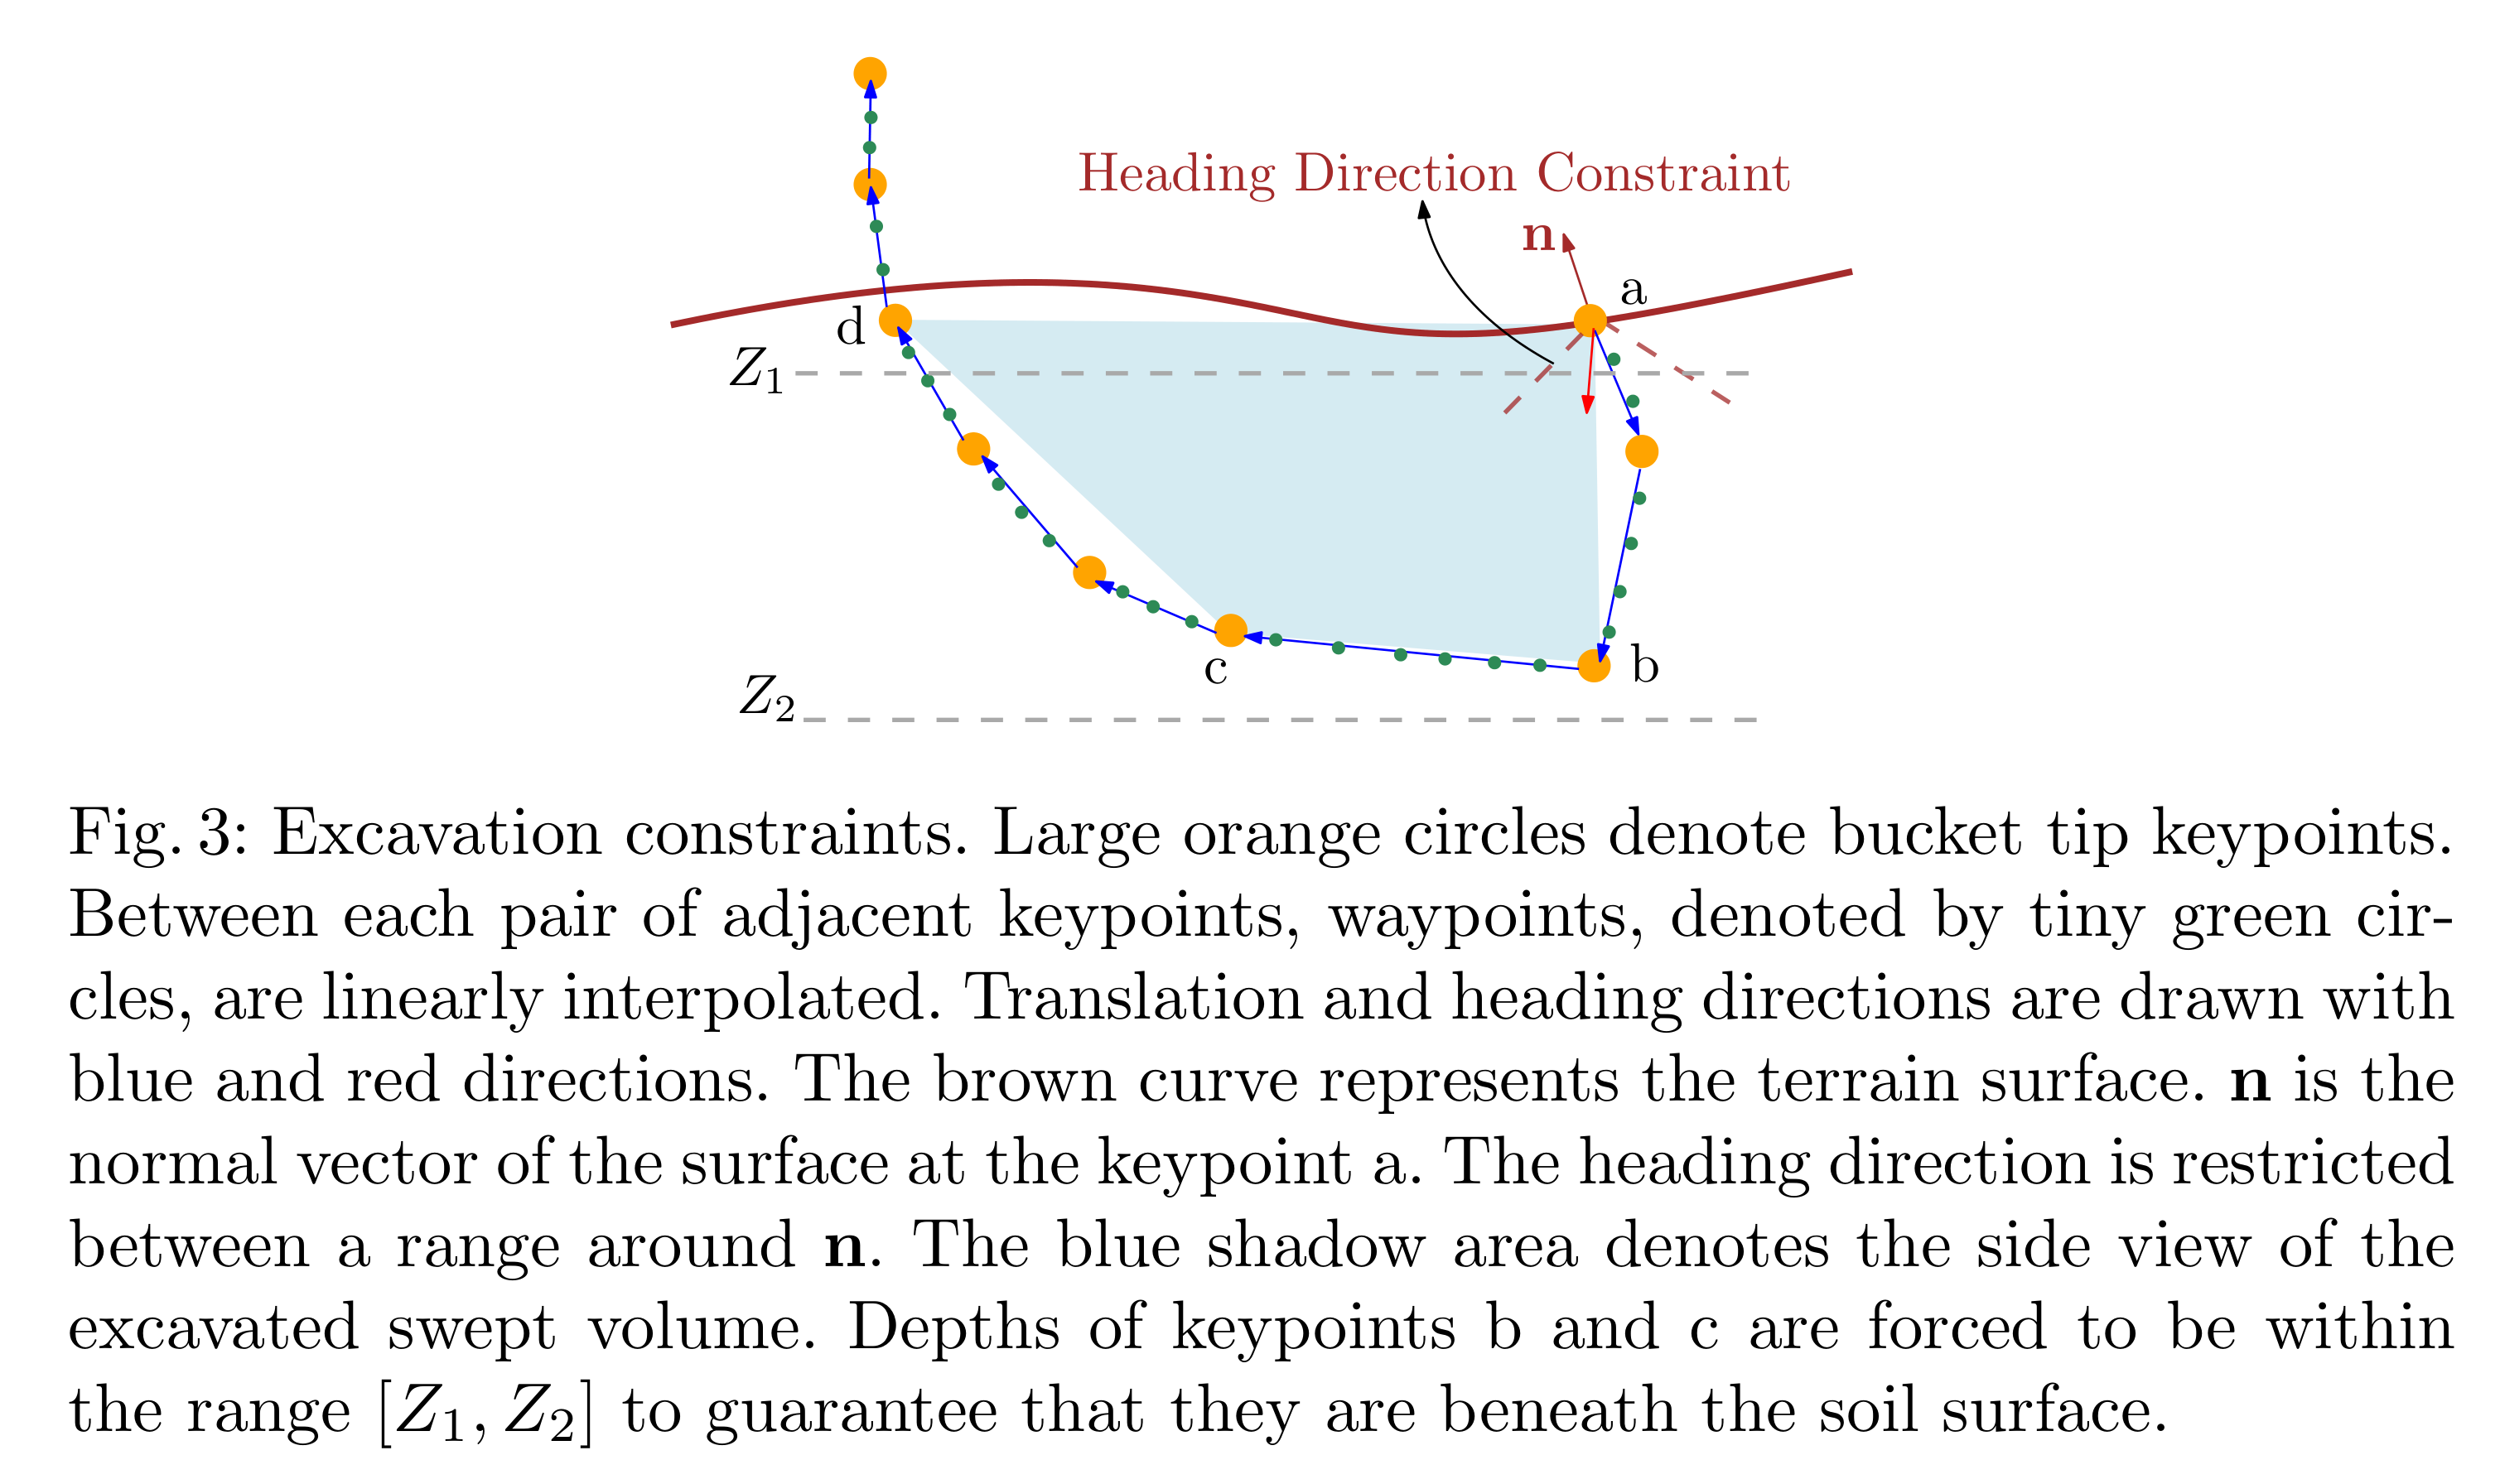
그림 설명: 소수의 최적화 keypoint와 그 사이의 보간 waypoint, swept volume, 지중 깊이, 버킷 헤딩 제약을 한 그림에 나타낸 궤적 최적화 구성이다. 원문 Fig. 3, PDF p.7.
2) 요약
- 단일 굴착을 최소 토크 궤적 최적화로 만들되, keypoint 사이 시간 간격까지 변수로 두어 동역학적 실행 가능성과 작업시간을 함께 조정한다.
- 최적화 변수는 소수의 관절 keypoint와 시간 간격으로 제한하고, 토크 계산은 고정된 작은 $\Delta t$로 선형 보간한 waypoint에서 수행한다. swept volume, 버킷 헤딩·이동방향, 관절 속도·토크 한계를 동시에 제약한다.
- 버킷을 back plane과 separation plane으로 단순화하고 정수압·속도·마찰 항을 적분한 토양 저항을 역동역학에 넣어, 토양 조건에 따라 궤적이 달라지게 했다.
- AGX 검증에서 가변시간 해는 고정시간 해의 6.4 s보다 짧은 5.5 s였고, 논문은 동역학적으로 가능한 궤적을 평균 150 s 이내에 계산했다고 보고한다.
3) 방법
- 입력 준비: 굴착기 질량·관성·기구 치수, 관절/액추에이터 토크·속도 한계, 버킷 형상, 지표면, 목표 swept volume, 토양 계수 $\rho,K_p,K_v,K_s$, R-map으로 얻은 초기 궤적을 준비한다.
- 시간 가변 궤적 표현: 관절 keypoint $k={k_i}$와 구간시간 $T={T_i}$를 최적화 변수로 둔다. 각 구간을 $\Delta t$ 간격으로 선형 보간해 속도·가속도와 waypoint 수 $Q_i=T_i/\Delta t$를 계산한다.
- 굴착 제약 구성: 진입-침투-드래그-회전-이탈 keypoint로 만든 사각형 면적에 버킷 폭을 곱해 swept volume 범위를 설정한다. 버킷 헤딩과 끝단 이동방향의 허용 반평면·단조 회전, 지중 깊이, 관절 속도와 토크 한계를 부과한다.
- 토양력 계산: 지중 버킷 면을 작은 요소로 나누고, 요소 깊이의 정수압 $\rho gh$, 법선 속도 저항, 접선 마찰을 계산한다. 모든 요소의 힘·모멘트를 버킷 끝단 좌표계에 합산한다.
- 역동역학·최적화: 합산 외력을 포함한 Lie-group 재귀 역동역학으로 각 waypoint의 관절 토크를 구한다. TrajOpt의 SQP로 $\sum|\tau|^2$를 최소화하며 keypoint와 구간시간을 함께 갱신한다. 세부 수렴 기준과 하이퍼파라미터는 원문 구현 세부 확인 필요.
- 출력·평가: 최적 관절궤적과 시간 프로파일을 단순 궤적 제어기로 AGX에 입력하고, 제약 만족, swept volume, 토크 곡선 일치, 총 시간·수렴비용, 토양별 궤적 변화를 비교한다.
4) 토의
- 논문이 밝힌 한계/향후 연구: 궤적 계획기를 상위 task planner와 통합하고, 서로 다른 실제 토양 데이터로 system identification을 수행해 토양력 모델을 보정하며, 실제 굴착기에서 검증하는 것이 향후 과제다.
- 해석: 토양력은 균질 재료와 단순화한 버킷 면의 경험계수에 의존하고 AGX와도 모델 차이가 있다. 또한 평균 약 150 s의 최적화 시간은 지형이 빠르게 바뀌는 온라인 재계획에는 길며, 토크 제곱합이 실제 연료소비를 직접 나타내지는 않는다.
- 연구주제 제안: 실시간 토양 파라미터 식별을 결합한 receding-horizon 굴착 최적화 - 관절/유압 센서의 토크·속도·자세로 $K_p,K_v,K_s$를 갱신하고, 토크예측 RMSE·제약 위반률·계획시간·에너지/굴착량을 평가한다.
- 연구주제 제안: 상위 작업계획과 최소토크 궤적의 계층형 warm-start - 다음 굴착 위치·목표 체적을 task planner가 정하고 이전 해를 초기화에 재사용해, 전체 작업시간·연료 대용지표·수렴 성공률을 비교한다.
2021 · 굴착 궤적 생성을 위한 최적화 프레임워크
- 원문: 논문 PDF
1) 대표그림
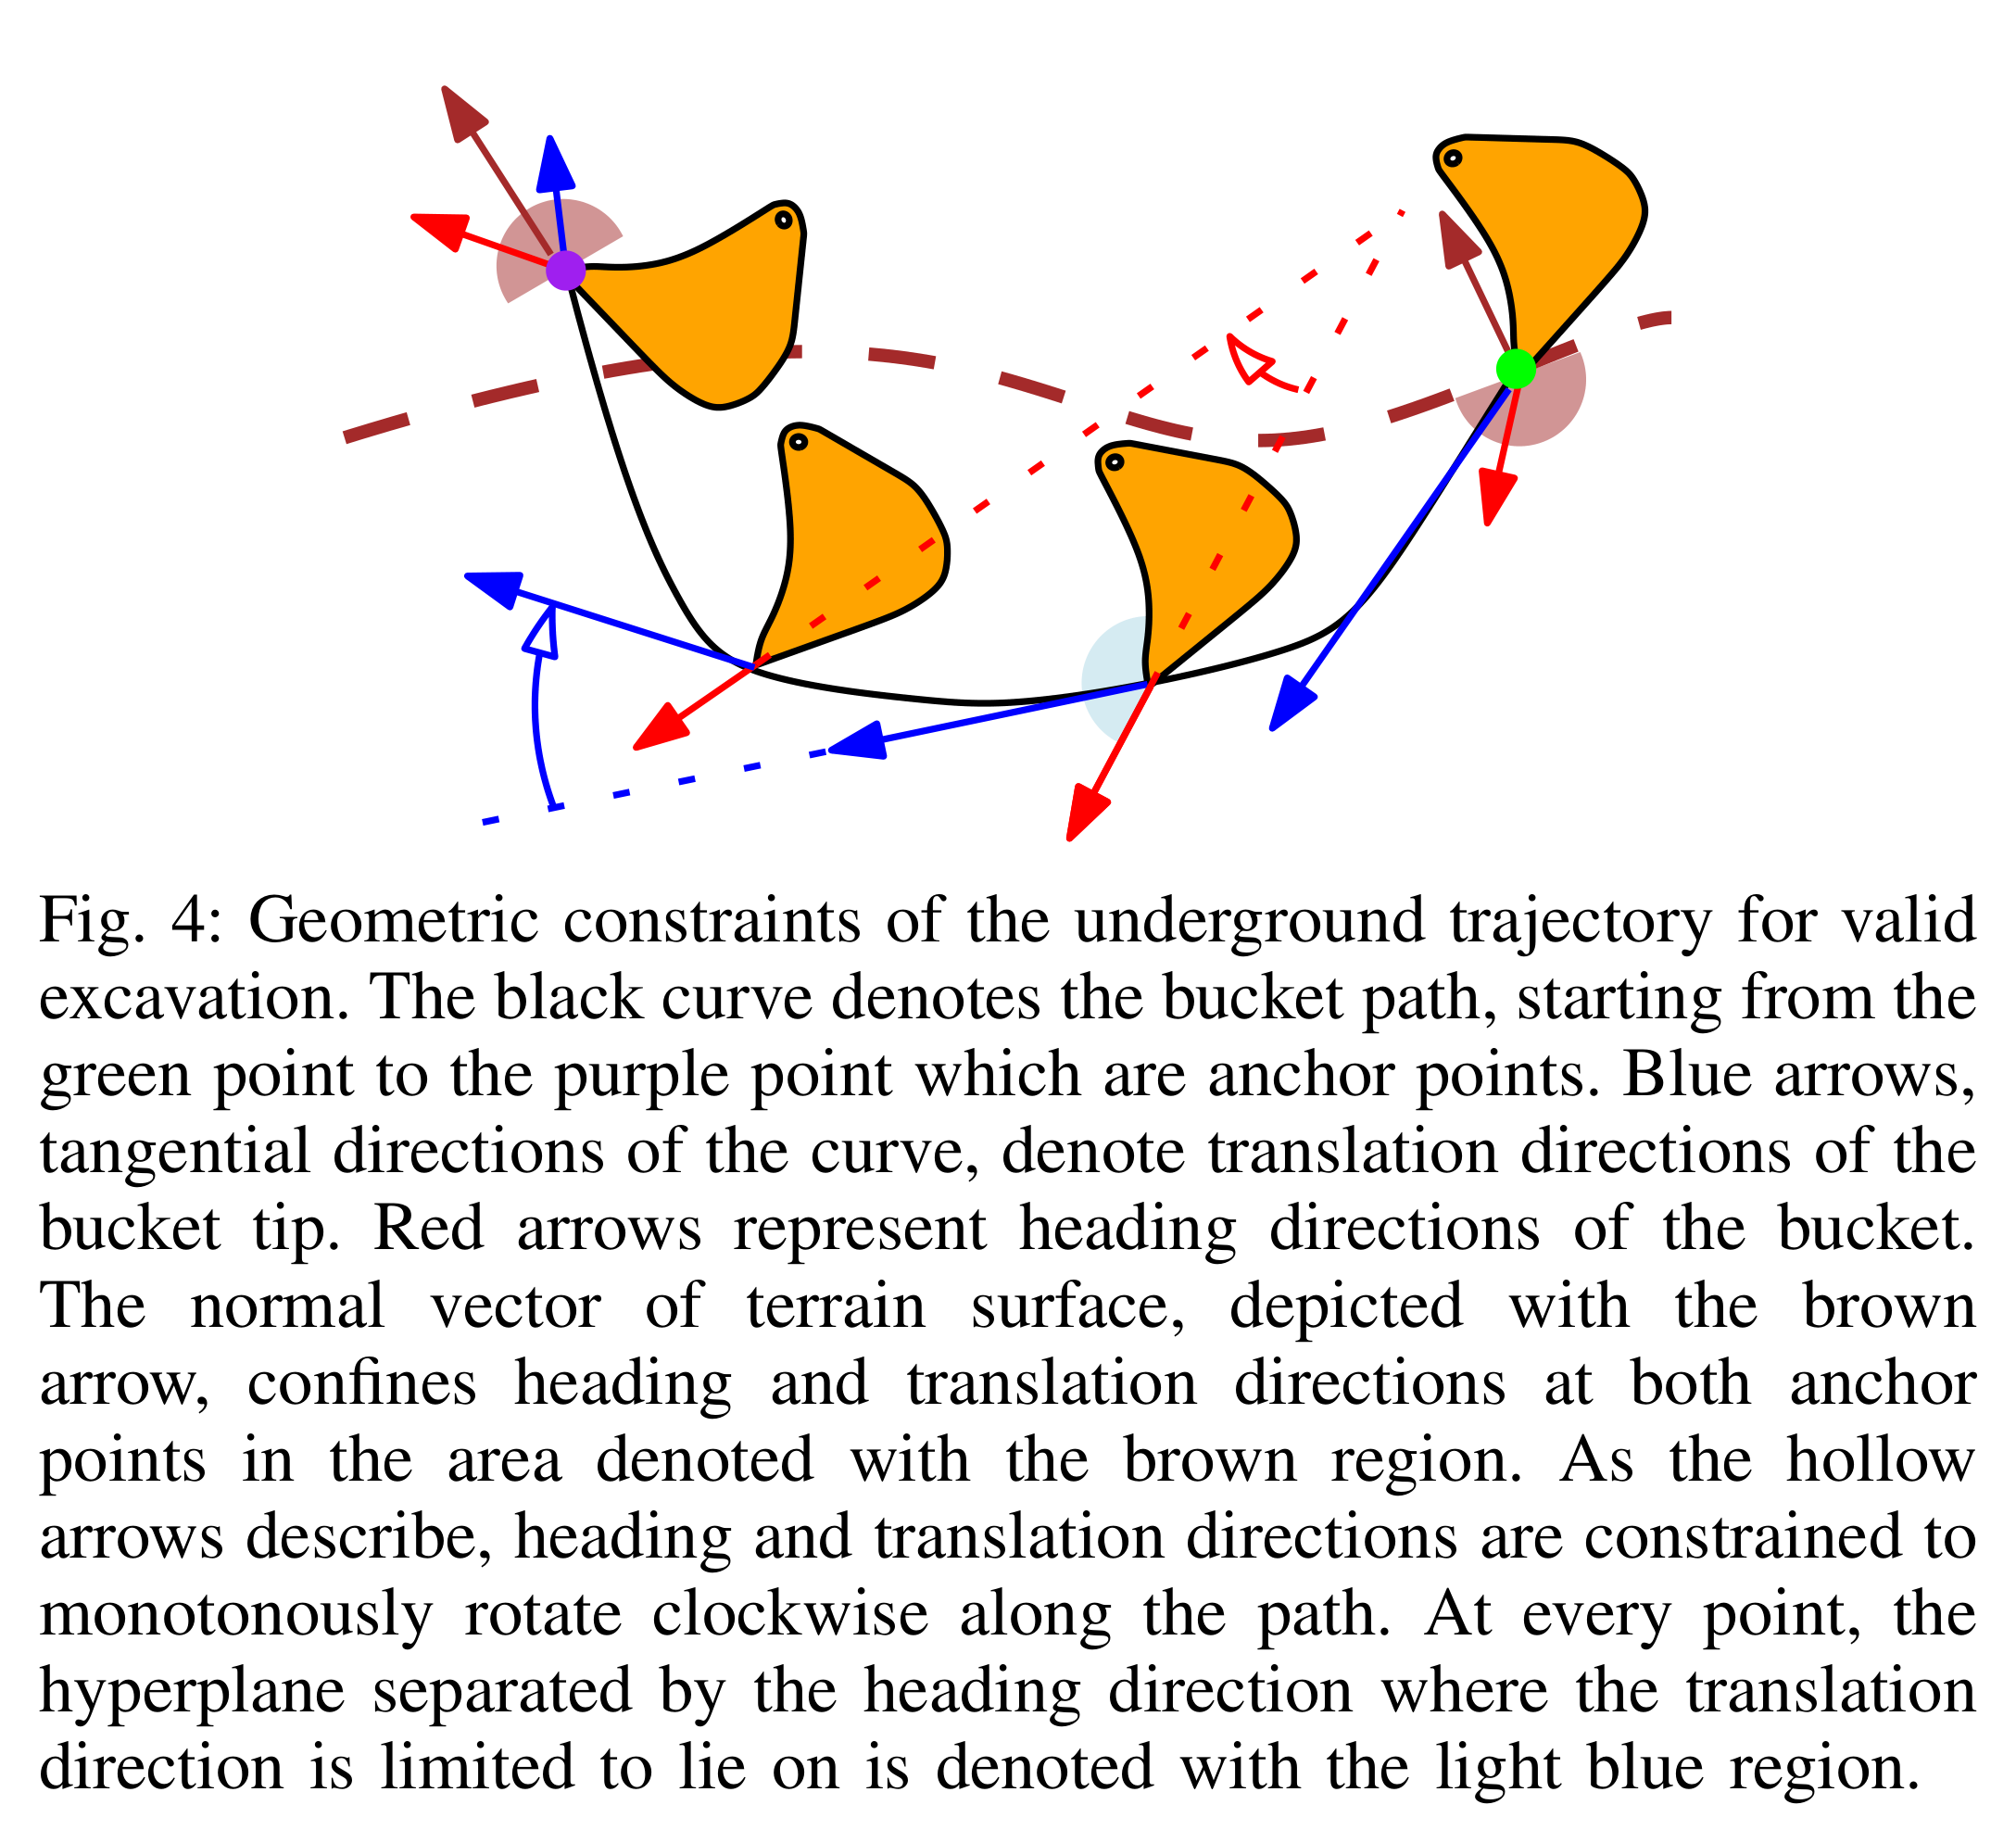
그림 설명: 고정된 침투-드래그-스쿠핑 단계 대신, 연속 경로에서 버킷의 이동방향(파랑)과 헤딩(빨강)을 단조롭게 회전시키고 서로의 반평면 관계로 유효 굴착을 규정하는 핵심 기하 제약이다. 원문 Fig. 4, PDF p.4.
2) 요약
- 굴착을 미리 정한 3단계 동작으로 제한하지 않고, 버킷의 순간 이동·헤딩 관계와 swept volume만 제약해 더 넓은 궤적 공간에서 최소 관절변위·최소시간 등 다양한 목적을 최적화한다.
- 연속 관절궤적은 양 끝의 quintic과 내부 exact cubic을 결합한 spline으로 표현하고, waypoint와 구간시간을 함께 최적화한다. waypoint뿐 아니라 spline 중간 샘플에도 경로 제약을 적용한다.
- UR5 실험에서 전통적 3단계 방식보다 최소 관절궤적 길이가 60% 짧았고, 경로와 시간을 동시에 푸는 one-stage 방식은 two-stage 방식보다 평균 실행시간이 18% 짧았다.
- D435 depth camera의 지형 height map과 6축 힘-토크 센서의 적재중량을 이용해 평지·경사지 및 서로 다른 시간 조건에서 실제 굴착량과 반복 생산성을 검증했다.
3) 방법
- 입력 준비: depth point cloud로 만든 terrain height map, 로봇 순기구학과 관절 속도·가속도 한계, 버킷 체적, 시작/종료점, 목표 bucket filling factor $K_{bf}$, 목적함수(시간·관절변위·토크 중 선택)를 준비한다.
- 궤적 변수화: 관절 waypoint $Q={q_i}$와 시간간격 $T={\Delta t_i}$를 변수로 두고, 양 끝 구간은 quintic, 내부는 cubic spline으로 보간해 2차 미분 가능한 $s(t)$를 만든다.
- 순간운동 제약: 시작·끝 버킷 끝점을 지표면에 고정하고 진입/이탈 방향을 지표면 법선으로 제한한다. 전체 경로에서 이동방향과 헤딩이 단조 회전하고, 이동방향이 헤딩의 허용 반평면 안에 있으며, 마지막 헤딩이 위쪽을 향하게 한다.
- 굴착량 제약: 경로와 지표면 사이의 x-z swept area를 사다리꼴 적분하고 이를 y축의 여러 단면에 대해 적분한다. $K_{bf}=V_{swept}/V_{bucket}$가 지정 범위에 들도록 제약한다.
- 최적화 실행: spline 중간점을 균일 샘플링해 모든 경로 제약을 변수 $Q,T$의 제약으로 바꾸고 선택한 비용을 최소화한다. 실제 사용한 솔버·초기화·정지조건은 원문 구현 세부 확인 필요.
- 출력·평가: 최적 관절·시간 궤적을 UR5에서 실행한다. 매 굴착 전 height map을 갱신하고, 힘-토크 센서로 적재중량을 재며, $K_{bf}$-실제 중량 관계, 최적 궤적 길이/시간, 수렴 성공률과 반복 작업의 잔여 지형을 평가한다.
4) 토의
- 논문이 밝힌 한계/향후 연구: 시간변수 도입은 변수 수와 비선형성을 높여 one-stage 최적화 성공률을 two-stage보다 낮춘다. 정적 swept volume은 실제 굴착량을 과대평가하므로 더 정확한 토양-버킷 상호작용 모델 또는 지형·토양 특성에 따라 목표 $K_{bf}$를 조정하는 적응 전략이 필요하다.
- 해석: 소형 UR5와 저밀도·저응집성 토양에서 검증했으므로 유압 굴착기의 동역학, 고응집/암석 혼합재, 토양 이탈·유실에 그대로 일반화하기 어렵다. 또한 $K_{bf}$ 보정은 조건별 관찰에 의존한다.
- 연구주제 제안: 지형·토질·속도 조건부 bucket filling factor 학습 - height map, 토질 특징, spline 속도로 실제 적재량을 예측해 $K_{bf}$를 자동 보정하고, 적재량 MAE·full-bucket 성공률·유실률을 검증한다.
- 연구주제 제안: 성공률 보장형 one-stage 시간 최적화 - continuation/multi-start와 two-stage fallback을 결합해 비선형성을 완화하고, 수렴 성공률·계획시간·최종 실행시간·제약 위반률을 비교한다.
2022 · 모방학습과 모델 최적화를 결합한 궤적 계획
- 원문: 논문 PDF
1) 대표그림
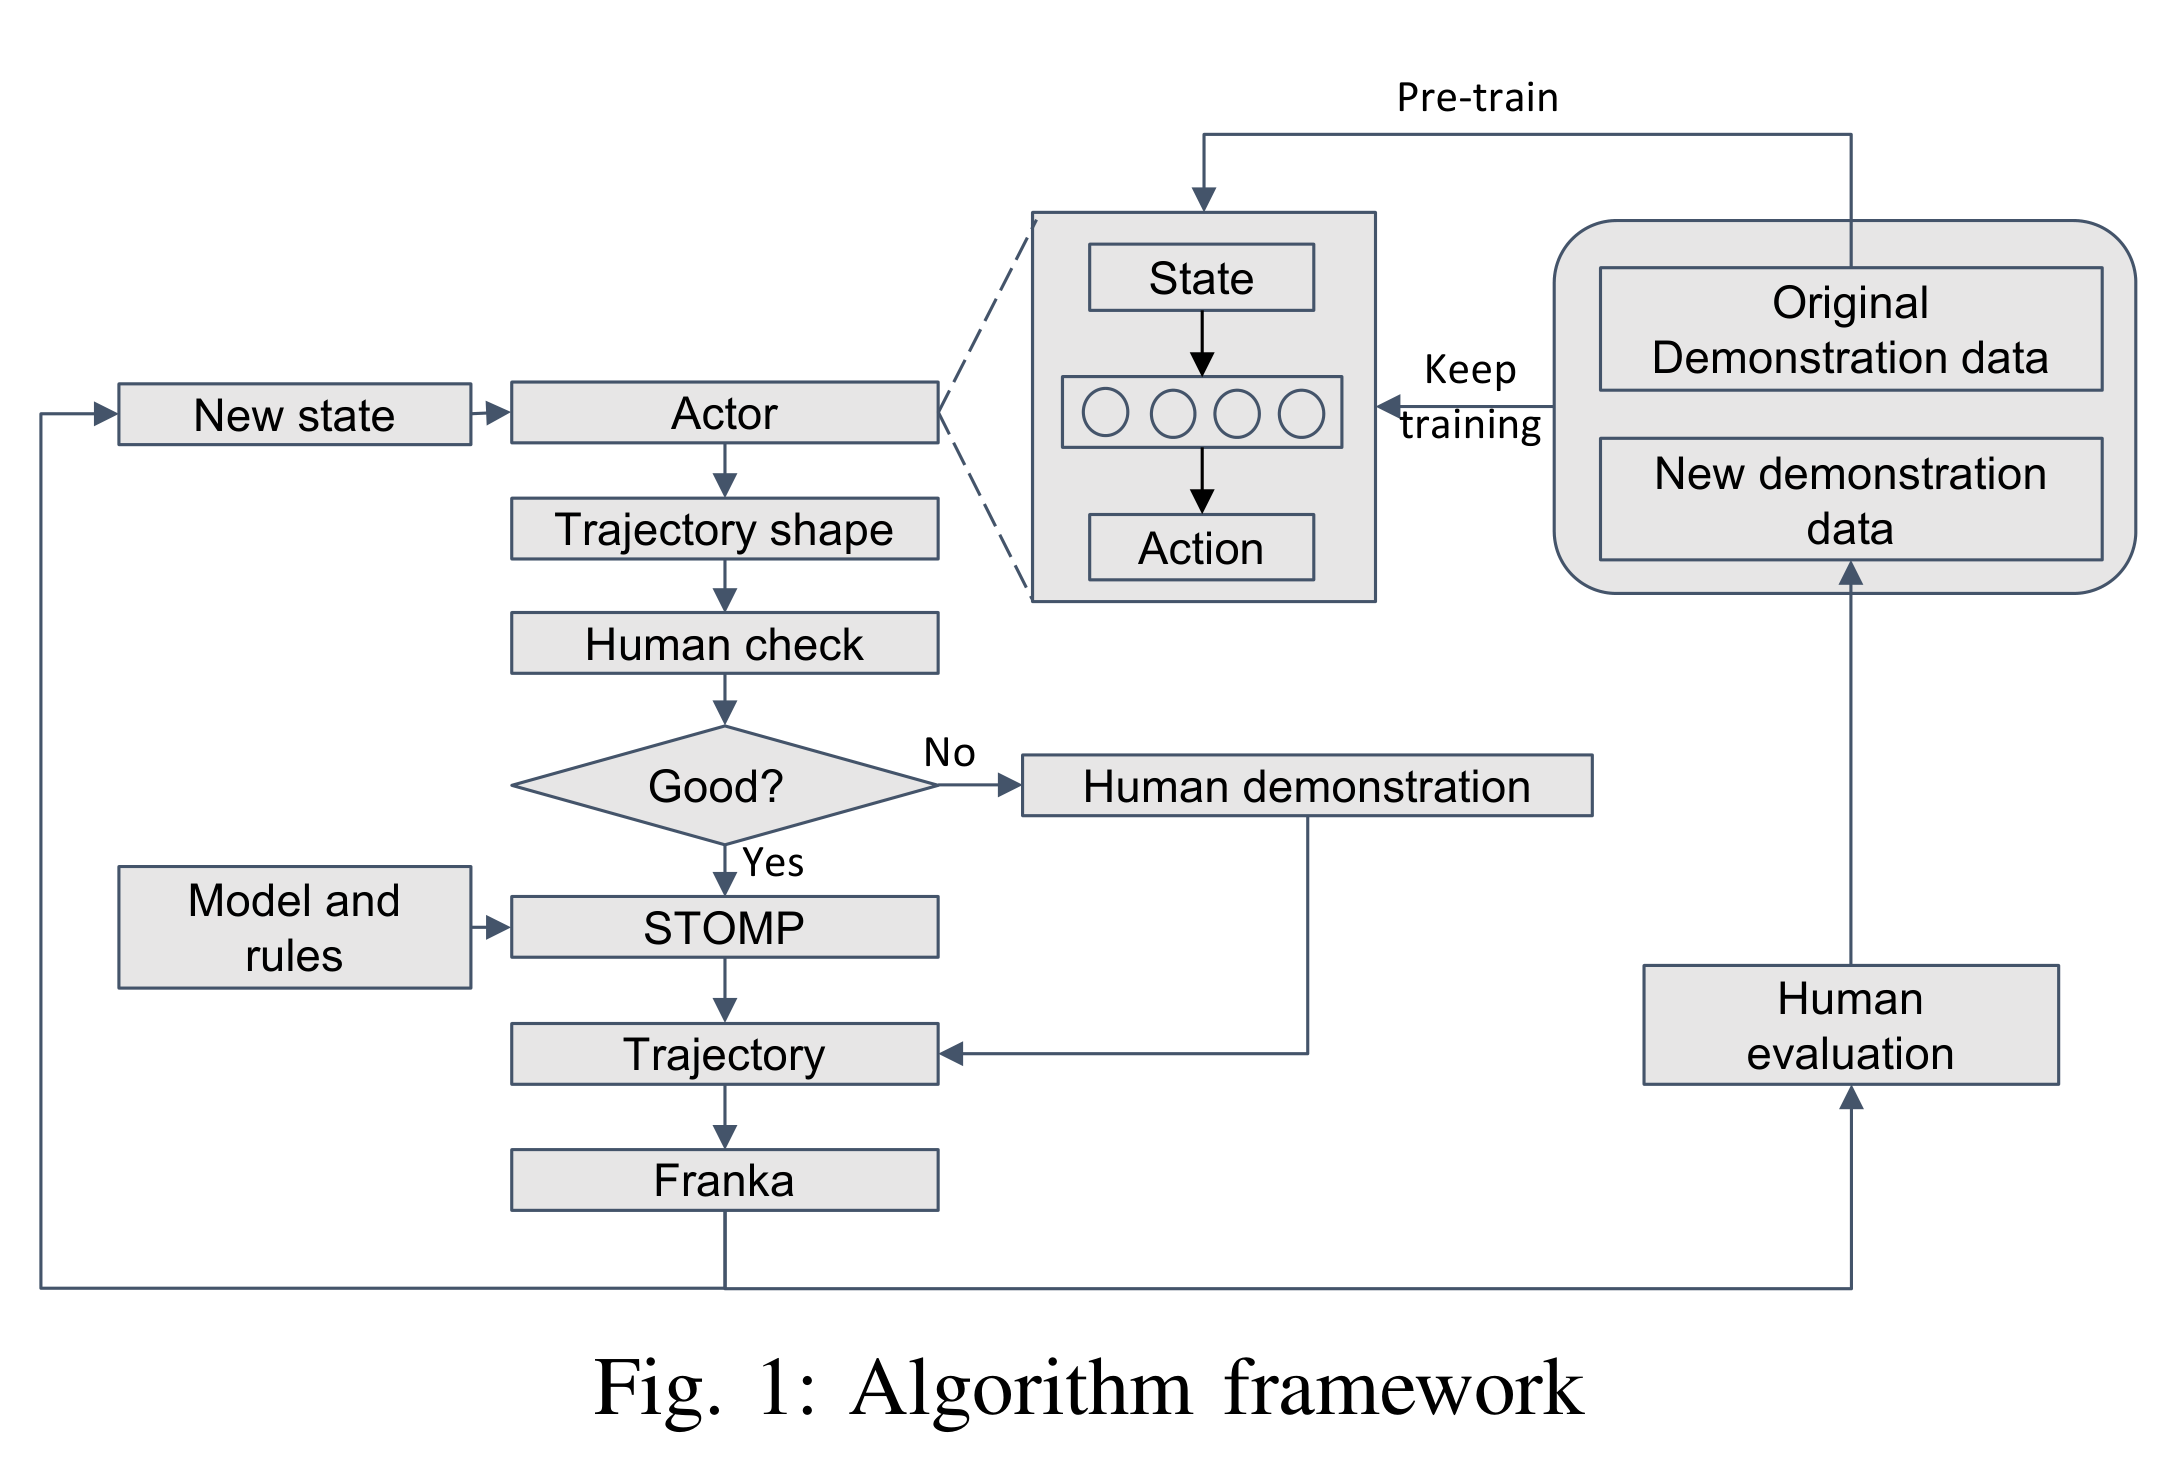
그림 설명: 지형 상태에서 IL actor가 만든 궤적 형상을 사람이 선별하고, STOMP가 모델·규칙으로 실행 가능하게 보정한 뒤 실행·평가 데이터를 다시 학습셋에 넣는 전체 폐루프이다. 원문 Fig. 1, PDF p.2.
2) 요약
- 지형 형상·재료 종류로부터 인간 전문가와 유사한 초기 궤적을 생성하는 모방학습 actor와, 그 궤적의 기구학·안전·부드러움·목표 체적을 보정하는 STOMP를 직렬 결합한다.
- 지형 전체 grid map 대신 굴착기-POA 선상의 영역을 여러 단면으로 나누고 상대 높이 합을 특징으로 사용하며, 지형 이미지 분류기의 재료 특징을 연결해 작은 데이터에서도 actor를 학습한다.
- 사람의 적합성 판정과 실행 후 0-10 평가를 통해 새 시연을 모으고, 높은 평가 궤적을 더 자주 샘플링해 actor를 계속 갱신하는 DAgger형 루프를 사용한다.
- Franka Panda의 모래 실험에서 결합법은 세 에피소드 합산 평균 굴착중량을 pure-STOMP보다 24.77% 높였고, pure-IL보다 중량 표준편차를 35.52% 낮췄다. 목재 블록에서도 baseline보다 평균중량과 성공률이 높았다.
3) 방법
- 데이터·입력 수집: Azure Kinect point cloud를 grid map으로 바꾸고 같은 시점의 지형 이미지에서 재료 라벨/특징을 얻는다. POA와 전문가 궤적을 수집하되 카메라 보정, 분류기 구조·학습조건은 원문 구현 세부 확인 필요.
- 상태 특징 생성: POA에서 굴착기 베이스로 이어지는 굴착 관련 영역을 $n$개 단면으로 나누고, 각 단면에서 POA 대비 grid 높이 차를 합산해 형상 특징 $s_g\in\mathbb{R}^n$을 만든다. 재료 특징 $s_m$과 연결해 상태 $s={s_g,s_m}$를 구성한다.
- IL actor 학습: 전문가 궤적에서 시간축으로 균등한 $m$개 버킷 자세(베이스까지 평면거리, z, 버킷 각도)를 선택해 행동 $a\in\mathbb{R}^{3m}$으로 만들고, 시연과 예측 사이 MSE를 최소화한다. 네트워크 층수와 $n,m$ 값은 원문 구현 세부 확인 필요.
- 초기 궤적 판정: 새 상태의 actor 궤적을 사람이 확인한다. 부적합하면 사람이 직접 시연하고, 적합하면 STOMP의 초기·참조 궤적으로 사용한다.
- STOMP 보정: 관절공간에서 잡음 궤적을 샘플링하고 순기구학으로 버킷 자세를 계산한다. smoothness, 목표 raw volume, 굴착영역 밖 거리의 지수 penalty, IL 초기궤적 이탈비용을 합쳐 반복 갱신한다.
- 실행·재학습·평가: 최적 궤적을 Franka에서 실행하고 인간 평가 $r\in[0,10]$와 $(s,a,r)$를 시연셋에 추가한다. 평가가 높은 궤적을 importance sampling해 actor를 재학습하며, 굴착중량 평균·표준편차·계획 성공률을 pure IL/pure STOMP와 비교한다.
4) 토의
- 논문이 밝힌 한계/향후 연구: actor 학습에 128개 궤적만 사용했고 DAgger 데이터 추가 효과가 일정 시점 이후 정체됐다. 더 크고 다양한 데이터, few-shot 등 고급 IL/RL, 실제 굴착기 적용을 위한 시연 수집·정제·STOMP 목적함수·실행 절차가 필요하다.
- 해석: 사람의 궤적 적합성 판정과 실행 후 평가가 필수라 완전 자율 데이터 수집은 아니다. Franka와 모래/목재 블록에서의 검증, 단순 raw-volume 대용모델, 세부가 공개되지 않은 재료 분류기가 현장 일반화의 주요 불확실성이다.
- 연구주제 제안: 불확실성 기반 능동 DAgger와 few-shot 토질 적응 - ensemble actor가 OOD/궤적 불확실성이 높을 때만 전문가를 요청하고, 실제 굴착기에서 개입률·OOD 성공률·적재중량 분산·적응 샘플 수를 검증한다.
- 연구주제 제안: 학습 잔차 토양모델을 결합한 안전 STOMP - height map·재료·실행 토크로 raw-volume 오차를 학습하되 기구학/영역 제약은 모델 기반으로 유지하고, 적재량 예측 MAE·충돌/IK 위반률·계획시간을 비교한다.
[!summary] D. 학습·제어·계측 강체 굴착 학습, 버킷 체적 추정, 차량 추종제어, 장기 굴착 RL을 다룬다.
2021 · 군집 강체의 학습 기반 굴착 계획
- 원문: 논문 PDF
1) 대표그림
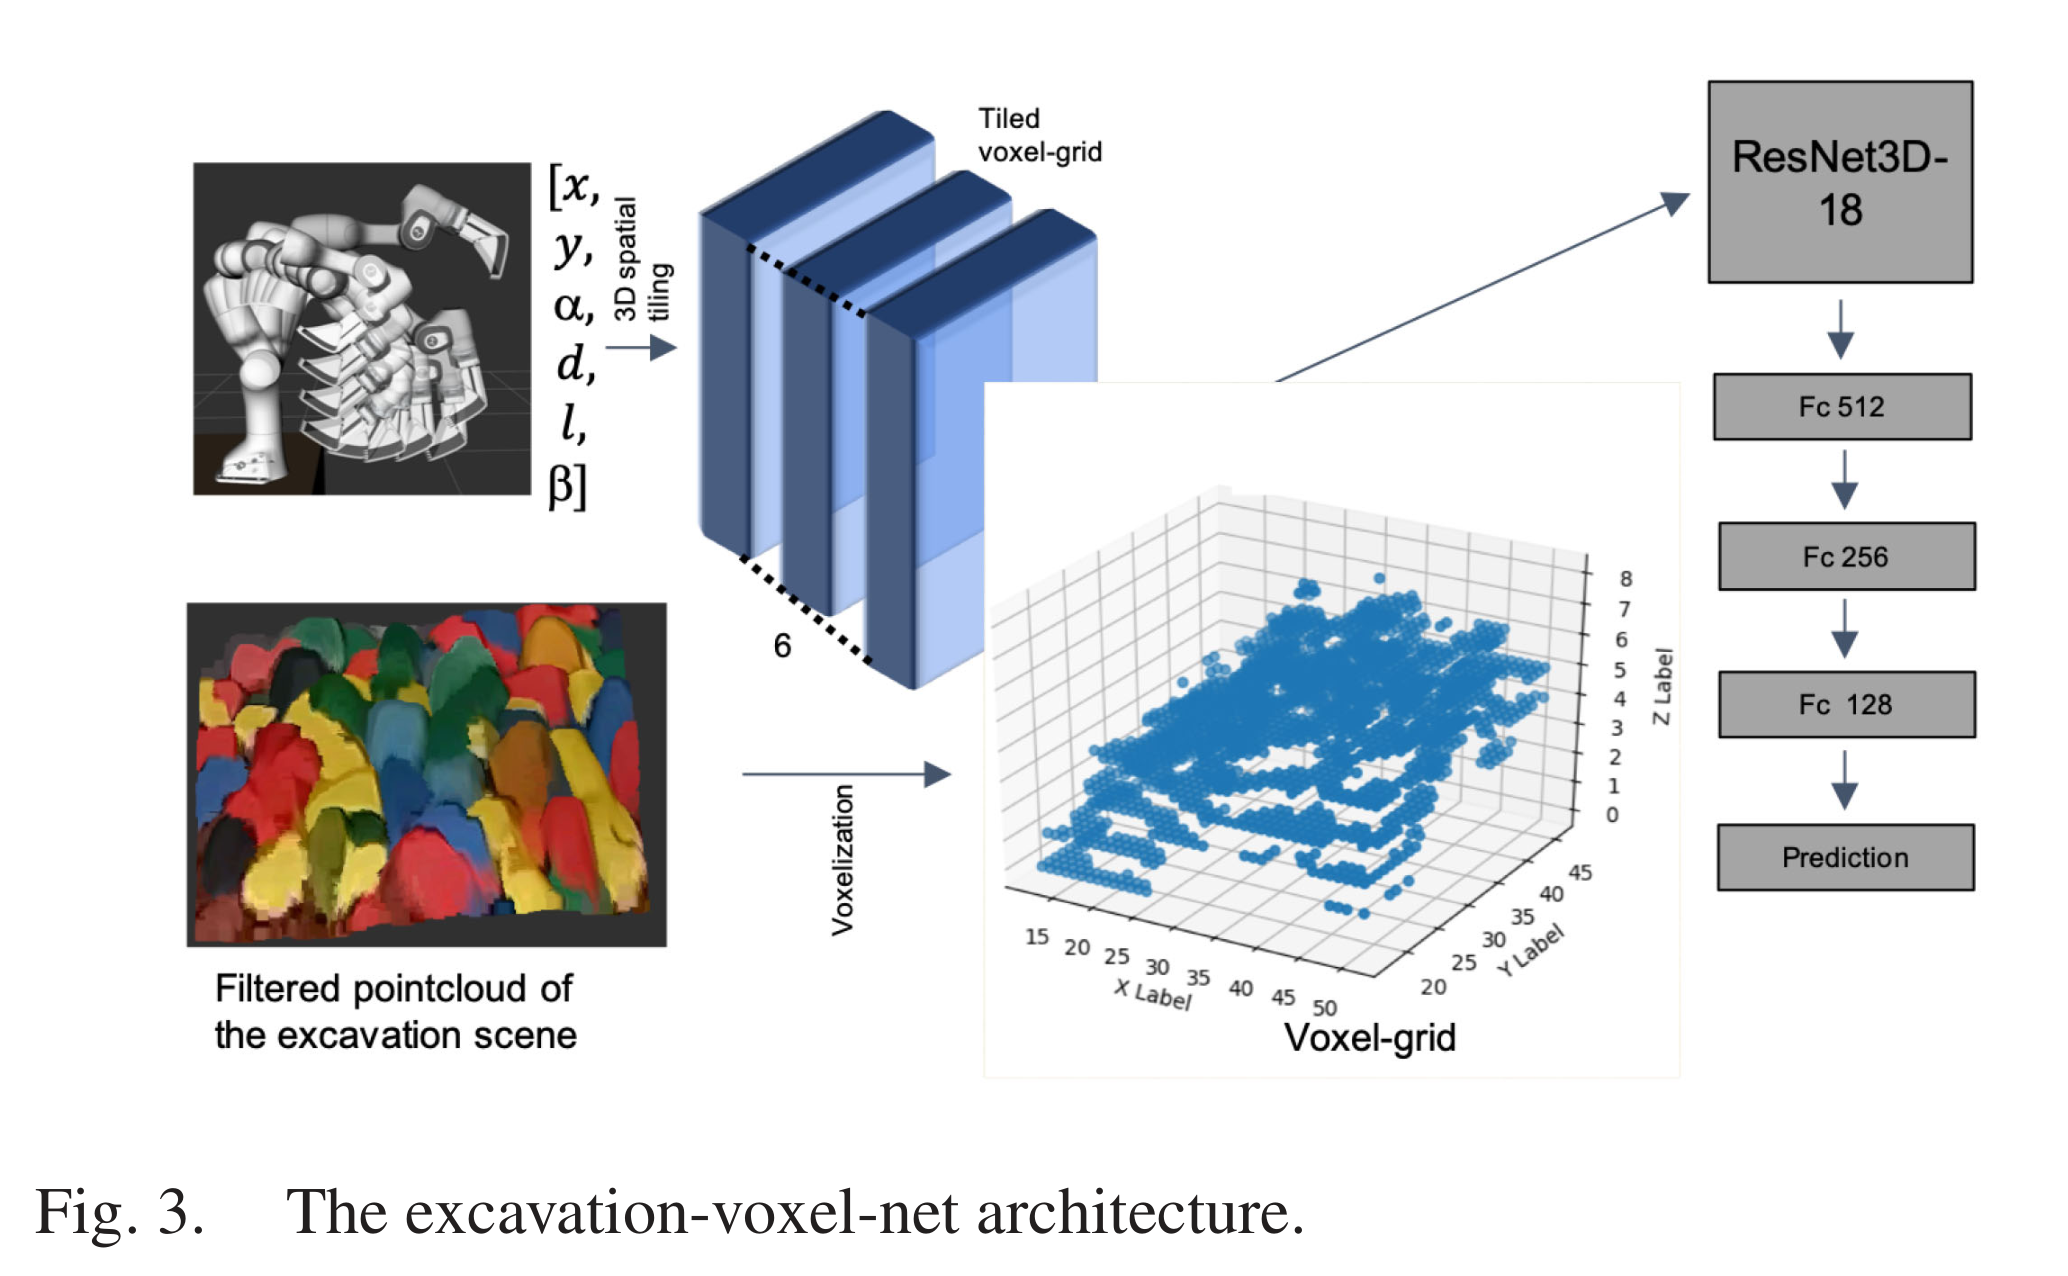
그림 설명: 장면 점군과 6차원 굴착 궤적을 7채널 voxel-grid로 결합하고 ResNet3D-18로 굴착 성공확률을 예측하는 excavation-voxel-net 구조. 원문 Fig. 3, PDF p.4.
2) 요약
- 불규칙 강체가 뒤엉킨 장면에서 현재 장면을 보고 한 번의 굴착으로 충분한 체적을 담을 궤적을 고르는 문제를, 성공확률 예측 CNN + Cross-Entropy Method(CEM) 궤적 최적화로 풀었다.
- 카메라·배경 차이에 민감한 RGB-D 영상 대신, tray 좌표계의 3D 점군을 1 cm voxel로 표현해 시뮬레이션과 실제 환경의 외관 차이를 줄인 것이 핵심이다.
- 시뮬레이션에서 CEM-voxel은 평균 136 cm³(버킷의 30.2%)를 굴착했고, 실제 Franka 실험에서도 평균 110 cm³(24.4%)로 비교 대상보다 가장 좋은 성능을 보였다.
- 작업공간 궤적을 사용해 PyBullet의 UR5에서 학습한 예측 모델을 실제 Franka Panda로 옮겼으며, voxel 표현이 RGB-D 표현보다 sim-to-real 전이에 유리함을 보였다.
3) 방법
- 장면·궤적 정의: RGB-D 카메라 점군을 tray 좌표계로 변환·범위 필터링하고, 굴착 궤적을 공격점 $(x,y)$, 공격각 $\alpha$, 관입깊이 $d$, 끌기길이 $l$, 닫힘각 $\beta$의 6개 변수로 둔다. $z$는 높이맵 표면에서 얻고, 궤적은 공격-관입-끌기-닫기-들기의 5단계로 보간한다.
- voxel 입력 생성: 굴착 공간을 $64\times64\times32$, 해상도 0.01 m의 occupancy voxel-grid로 만든다. 각 궤적 변수는 동일 크기의 grid로 타일링해 장면 1채널과 결합한 7채널 입력을 구성한다.
- 성공 예측기 학습: 3D로 확장한 ResNet-18이 1,000차원 특징을 만들고, FC 512-256-128 및 sigmoid가 성공확률을 출력한다. PyBullet·UR5·450 cm³ 버킷으로 휴리스틱 궤적 데이터를 모아 cross-entropy로 학습한다. 이 로컬 PDF에 포함되지 않은 보충 Appendix의 데이터 수·세부 학습 설정은 원문 구현 세부 확인 필요다.
- CEM 계획: 휴리스틱 궤적 256개로 6차원 Gaussian을 초기화하고, 5회 반복마다 256개를 샘플링해 예측확률 상위 64개로 분포를 갱신한다. 마지막 분포에서 64개를 뽑아 성공확률이 가장 높으면서 IK와 공격점 범위를 만족하는 궤적을 선택한다.
- 실행: 선택한 작업공간 궤적을 IK로 관절 waypoint로 바꾸어 위치제어기로 실행한다. 실제 검증은 Azure Kinect와 3D 프린트 버킷을 장착한 Franka Panda에서 수행하며, 관입 중에는 걸림을 줄이기 위해 waypoint마다 버킷을 수평으로 2 cm씩 번갈아 움직인다.
- 평가: 시뮬레이션은 방법별 1,000회, 실제는 방법별 25회 굴착을 수행하고 굴착 체적·성공률·유효 궤적률·계획시간을 비교한다. 성공 기준은 134 cm³, 즉 버킷 체적의 30%다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 현재 계획은 이번 굴착 체적만 탐욕적으로 최대화한다. 저자들은 연속 굴착의 장기 보상을 고려하는 심층강화학습, 큰 저항력을 견디는 힘제어, 실제 굴착기로의 이전을 후속 연구로 제시했다.
- 해석: 로봇팔 위치제어와 작은 실험 tray에서 검증해, 실제 유압 굴착기의 동역학·토양/암석 저항·작업공간 제약을 충분히 반영하지 못한다. 또한 본 PDF에는 본문이 참조하는 보충 Appendix가 없어 데이터 생성·학습 재현에 필요한 일부 세부가 빠져 있다.
- 연구주제 제안: 강체 군집의 연속 굴착을 위한 위험민감 계층형 RL - voxel/point-cloud 기반 상위 정책이 장기 누적 체적을 최적화하고 힘·토크 기반 하위 제어기가 걸림을 회피하도록 학습한 뒤, episode 누적 체적·버킷 걸림률·힘/토크 제한 초과율·sim-to-real 성능저하로 검증한다.
2021 · LiDAR 기반 버킷 적재 체적 실시간 추정
- 원문: 논문 PDF
1) 대표그림
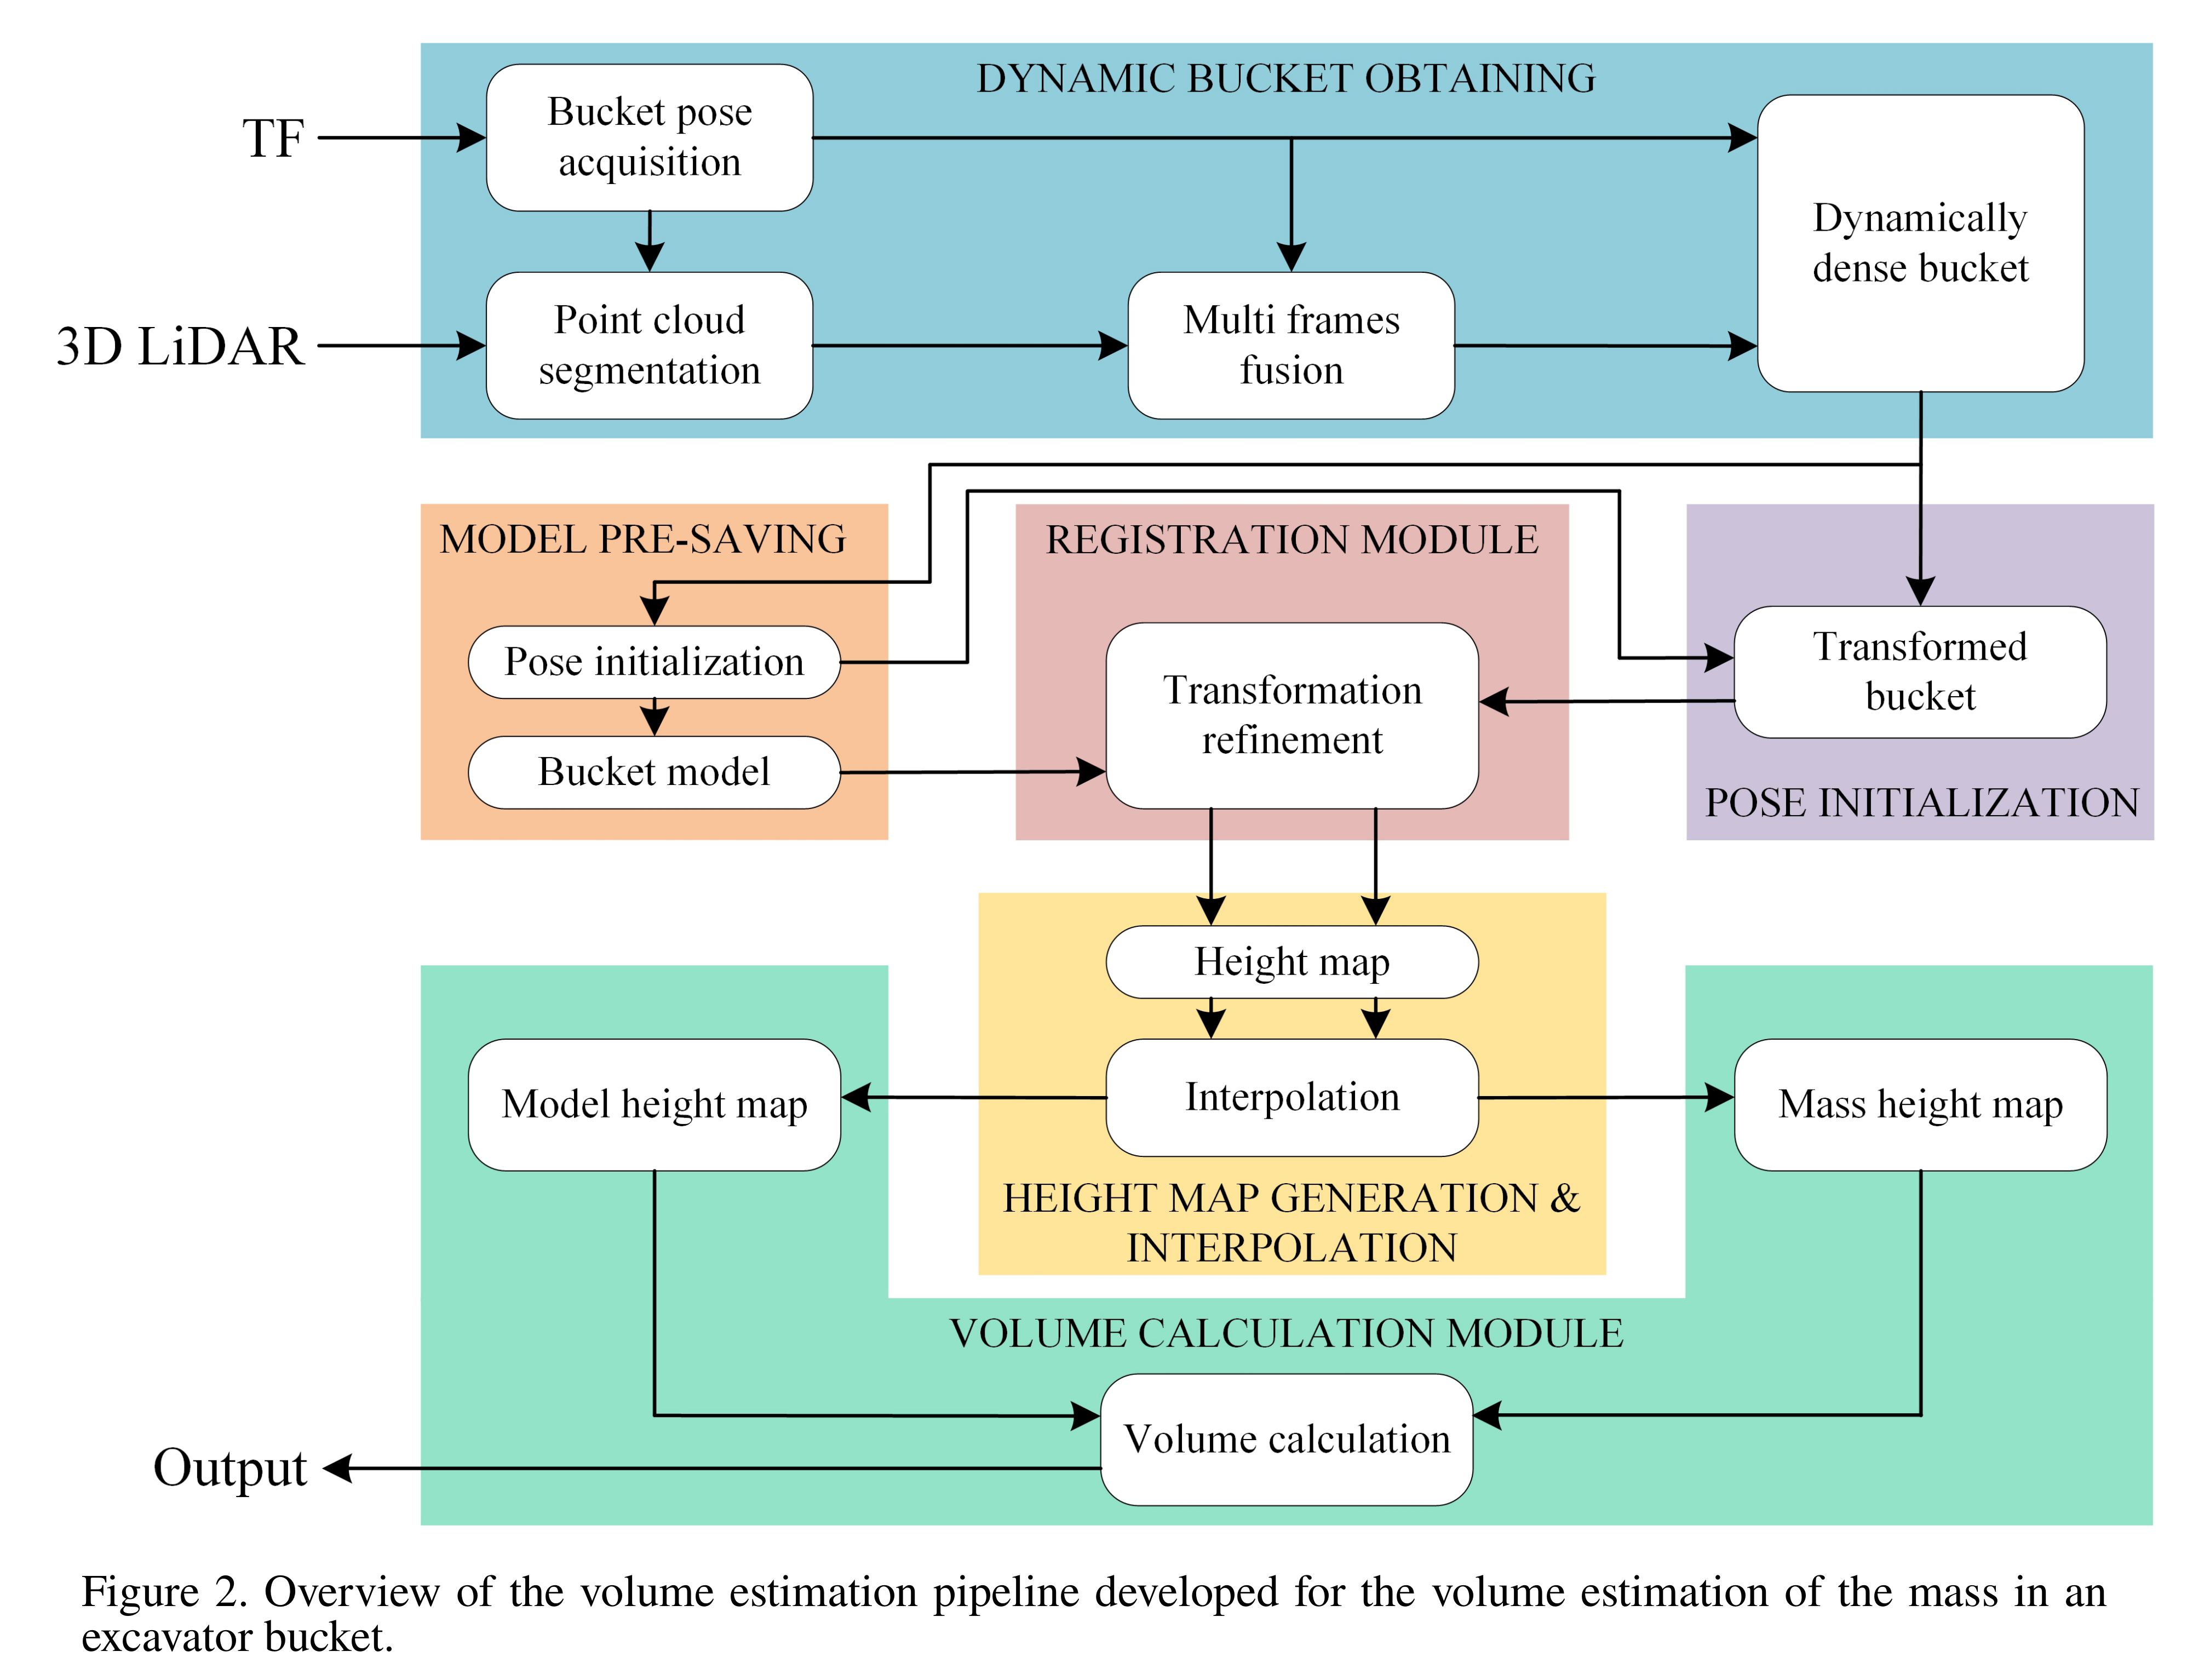
그림 설명: LiDAR·버킷 자세 입력에서 다중 프레임 융합, 빈 버킷 모델 정합, 높이맵 보간, 체적 계산으로 이어지는 전체 온라인 파이프라인. 원문 Figure 2, PDF p.3.
2) 요약
- 굴착기 캐빈의 3D LiDAR와 관절 경사센서만으로 움직이는 버킷 속 재료의 체적과 충전율을 약 0.5초 주기로 계산한다.
- 성긴 비균일 LiDAR 점군을 약 10프레임 누적하고, 센서 자세로 초기 정렬한 뒤 ICP로 빈 버킷 모델에 재정합해 자세 오차를 줄인다.
- 빈 버킷과 적재물의 2.5D 높이맵을 각각 생성·보간한 뒤 셀별 높이차를 적분하는 단순한 계산으로 온라인 체적을 얻는다.
- 전체 파이프라인은 단일 스레드 i7-10875H에서 평균 539 ms가 걸렸고, 관찰 충전율 50%, 70%, 105%에 대해 각각 47.51%, 72.16%, 107.35%를 추정했다.
3) 방법
- 센서·기준 모델 준비: Livox Mid100의 3D 점군과 ROS TF의 버킷 자세를 입력으로 사용한다. 작업 전 빈 버킷을 스캔하고 PCA로 축 정렬한 뒤 수동 미세조정하여 기준 모델과 초기변환을 저장한다.
- 동적 버킷 점군 구성: 매 프레임에서 현재 자세 주변 반경 1.5 m로 버킷 점군을 분할하고, 약 10프레임을 각 자세의 역변환으로 같은 좌표계에 누적한다.
- 노이즈 제거·정합: 0.01 m voxel downsampling과 통계적 이상치 제거(이웃 100개, 표준편차 배수 0.8)를 정합용 점군에 적용한다. normal 반경 0.025 m, 최대 대응거리 0.03 m, RMSE 임계값 0.01 m로 ICP를 수행해 경사센서 기반 초기변환을 보정한다.
- 높이맵 생성: passthrough filter로 실제 점군에서 버킷 부분을 대부분 제거하고 적재물 점군을 남긴다. 빈 버킷 모델과 적재물 점군을 각각 0.01 m 격자의 $z$ 높이맵으로 변환한다.
- 성긴 영역 보간: 행·열 경계점과 주변 유효점 존재 여부로 보간영역을 고른다(탐색영역 $8\times8$ pixel). 각 결측 셀은 $5\times5$ 이웃의 유효 높이 평균으로 채운다.
- 체적 계산·출력: 두 높이맵에서 동시에 유효한 셀의 높이차 $d=h_s-h_m$를 구해 $V=\sum l_{grid}^2d$로 적분하고, 사전 산정한 만재 체적 1.71 m³ 대비 충전율로 변환한다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 높이맵 기준 모델 바깥으로 튀어나온 돌의 체적은 계산하지 못한다. 버킷이 빠르게, 특히 LiDAR에서 멀어지는 방향으로 움직일 때 날림점 노이즈가 늘어 ICP와 체적 정확도를 낮추므로 후속 연구로 노이즈 억제를 제시했다.
- 해석: 정확도 비교 기준이 정밀 3D ground truth가 아니라 육안 충전율이어서 절대오차를 엄밀히 검증하기 어렵다. 단일 높이값을 쓰는 2.5D 표현은 overhang·큰 돌·가림이 있는 적재 형상을 본질적으로 표현하지 못한다.
- 연구주제 제안: 운동 보상 3D 버킷 체적추정 - IMU/관절속도 조건부 이상치 제거와 TSDF 또는 occupancy fusion으로 버킷 밖 돌과 가림면까지 복원하고, 정밀 스캔/질량-밀도 기준 체적 대비 MAE·95백분위 오차·지연시간·고속동작 시 실패율로 검증한다.
2022 · 휠로더 궤적 추종을 위한 LPV-MPC
- 원문: 논문 PDF
1) 대표그림
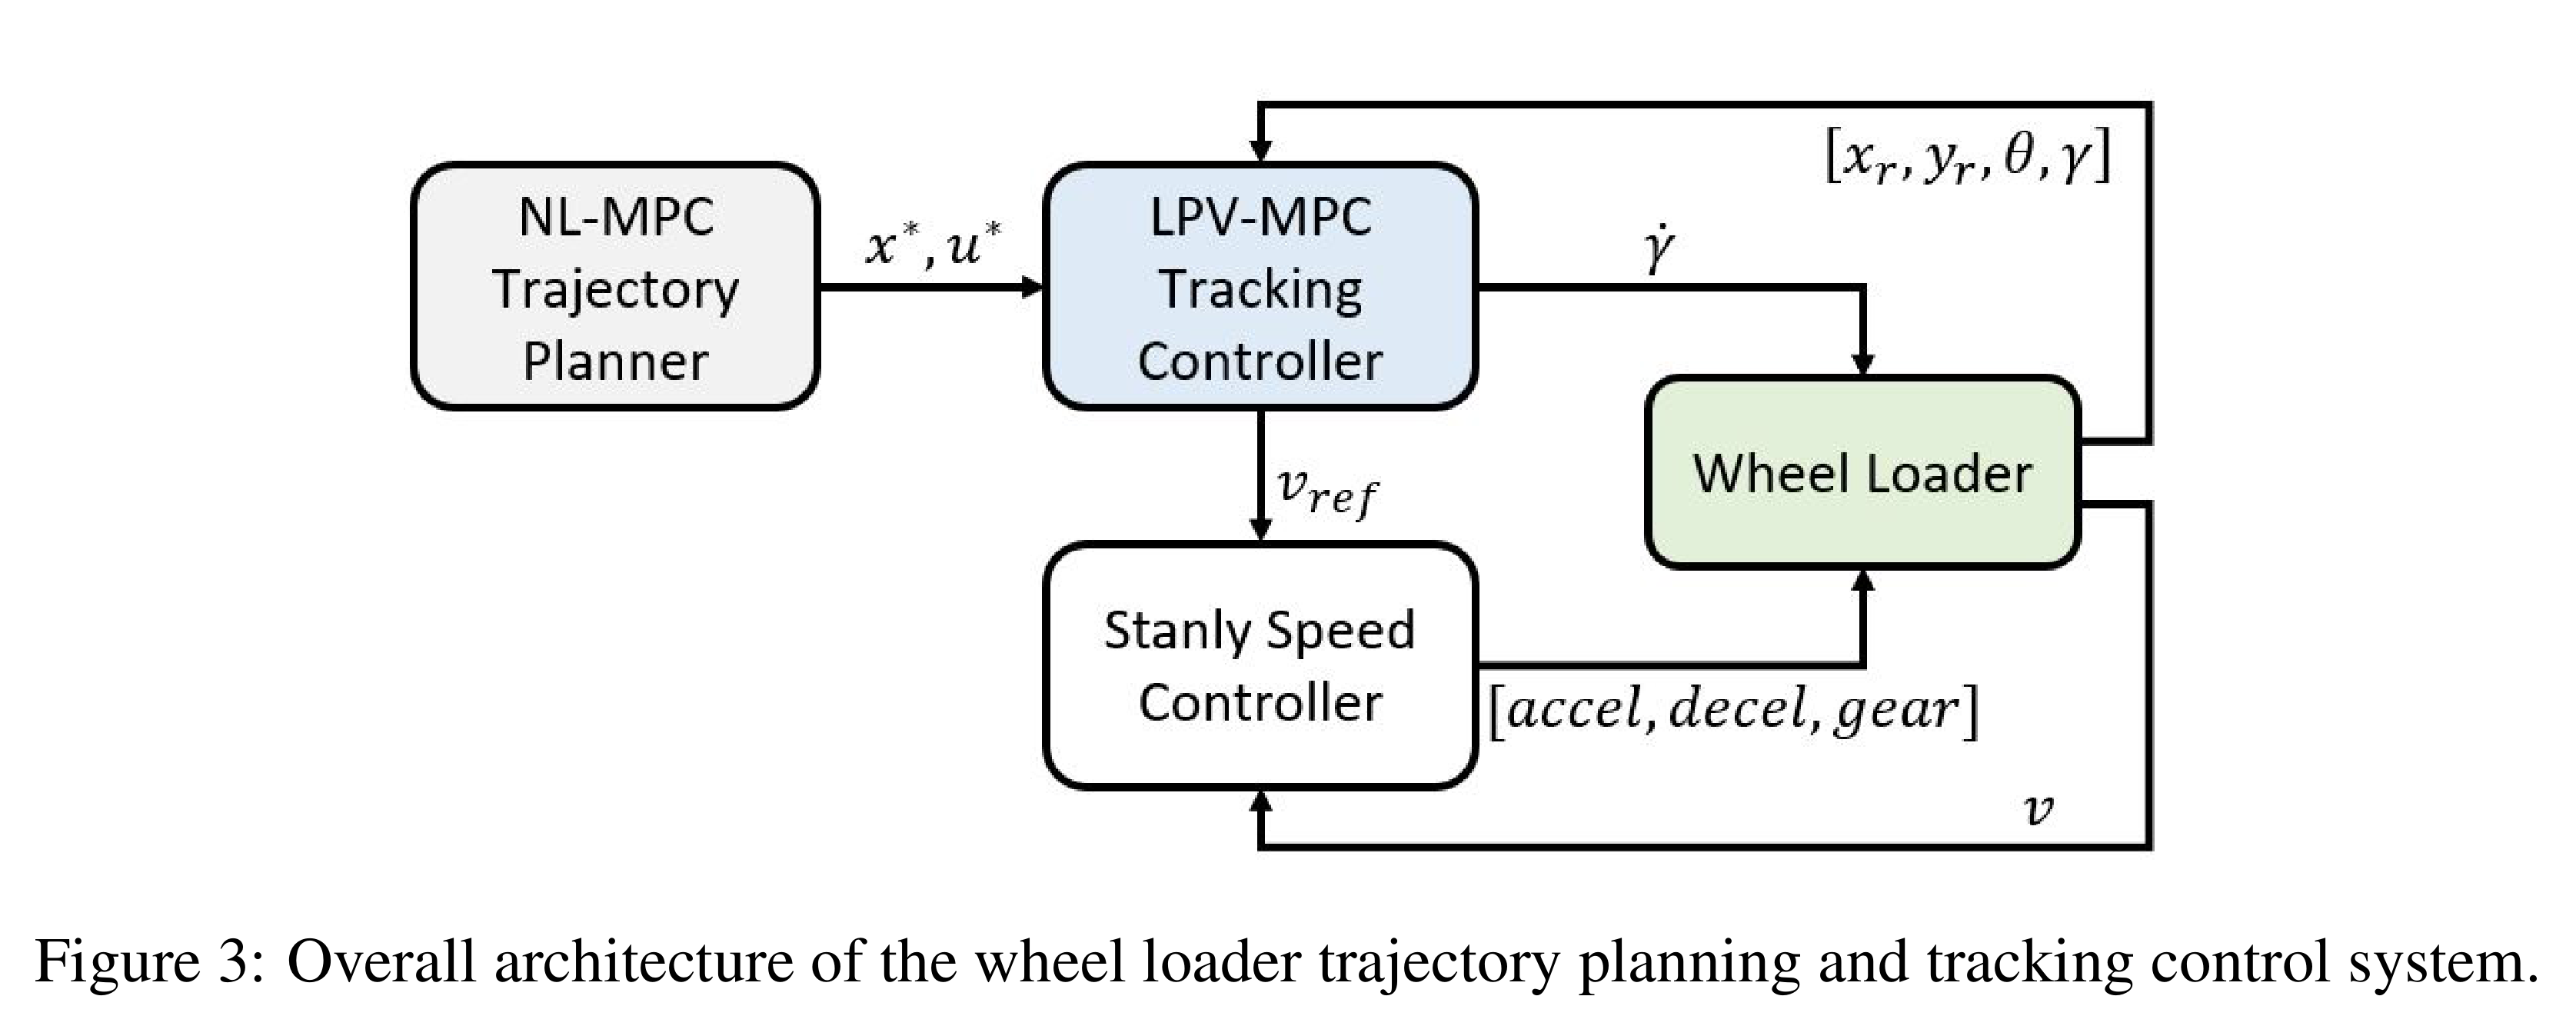
그림 설명: 비선형 MPC의 오프라인 궤적, LPV-MPC의 조향률 명령, 속도제어기의 구동 명령, 차량 상태 피드백 관계를 한눈에 보여주는 계획·제어 구조. 원문 Figure 3, PDF p.6.
2) 요약
- 굴절조향 휠로더의 강한 비선형성을 모두 온라인에서 풀지 않고, 오프라인 NL-MPC 계획 + 온라인 LPV-MPC 추종으로 분리해 성능과 계산량을 절충했다.
- NL-MPC는 적재점-덤프트럭 사이 Y자 loading cycle을 차량 상태·입력·굴절각·장애물 안전거리 제약 아래 계획하고, LPV-MPC는 이 nominal state-control 궤적을 scheduling parameter로 이용한다.
- 고충실도 AGX Dynamics 실험에서 평균 절대 위치추종오차는 NL-MPC 0.103 m, LPV-MPC 0.120 m, adaptive LTI-MPC 0.246 m였다. LPV-MPC는 NL-MPC에 근접한 정확도를 유지하면서 LTI-MPC와 유사한 QP 계산복잡도를 보였다.
- 전진 때는 전차체 좌표, 후진 때는 후차체 좌표를 상태로 선택해 조향 힌지 때문에 반대 차체의 오차가 증폭되는 것을 줄인 점도 실용적인 설계 요소다.
3) 방법
- 상태·센서 정의: 저속에서 tire slip과 횡력을 무시한 bicycle kinematic model을 사용한다. 상태는 $[x_r,y_r,\theta,\gamma]$ 또는 $[x_f,y_f,\theta,\gamma]$, 입력은 속도 $v$와 굴절각속도 $\dot\gamma$다. 실제 적용 시 위치는 GPS, heading은 IMU, 굴절각은 encoder로 측정한다.
- 오프라인 NL-MPC 계획: 적재점·하역점의 시작/종료 pose와 pile·truck 사각 장애물을 넣고, 입력 크기와 변화율을 최소화하면서 상태·입력·안전거리·최대 굴절각을 만족하는 Y자 궤적을 계산한다. 논문 설정은 $T_s=0.2$ s, horizon $N=100$, $\gamma_{max}=0.40$ rad다.
- LPV 모델 생성: nominal 궤적의 각 $(x^,u^)$에서 비선형 모델을 1차 Taylor 전개하고, Jacobian의 비선형항을 scheduling parameter $\rho$로 묶어 예측구간의 $A(\rho),B(\rho)$ 행렬열을 만든다.
- 온라인 LPV-MPC: 상태·입력 편차 $x_e=x-x^$, $u_e=u-u^$에 대해 추종오차·제어노력의 이차비용과 제약을 갖는 receding-horizon QP를 푼다. 전진 구간은 전차체, 후진 구간은 후차체 좌표를 쓰고 적재·하역·turning point에서 전환한다.
- 명령 실행: LPV-MPC의 $\dot\gamma$는 조향에, $v_{ref}$는 Stanley 계열 속도제어기에 보내 acceleration/deceleration/gear 명령으로 바꾼다. 속도제어기 상세는 논문 범위 밖이므로 원문 구현 세부 확인 필요다.
- 재현 평가: Matlab/Simulink에서 YALMIP을 통해 LPV/LTI QP는 SeDuMi, NL-MPC는
fmincon으로 풀고 AGX Dynamics 휠로더 모델과 연동한다. 모든 추종 MPC는 $T_s=0.2$ s, $N=10$, 5 Hz이며 시작점에 0.5 m 횡오차를 넣어 추종오차와 계산시간을 비교한다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 마찰·불균일 지면의 외란과 모델 불확실성에 대한 LPV-MPC 강건성을 분석하지 않았고, 적재량 변화까지 포함한 full vehicle dynamics도 고려하지 않았다. 저자들은 강건성 분석 도구와 robust LPV-MPC, 하중에 따라 변하는 전체 동역학 모델을 후속 연구로 제시했다.
- 해석: 검증이 시뮬레이션에 한정되고 저속·무슬립 기구학 가정에 의존한다. 실제 현장의 지반 침하·타이어 slip·유압 및 구동계 지연, 속도 하위루프 오차가 커지면 nominal scheduling sequence가 빠르게 부정확해질 수 있다.
- 연구주제 제안: 적재량·지반 slip 적응형 tube LPV-MPC - 온라인 추정한 payload와 slip을 scheduling parameter 및 불확실성 집합에 포함하고, 실차 loading cycle에서 위치/heading/굴절각 RMSE·최대 제약위반·평균/최악 solve time·작업주기 시간을 비교한다.
2022 · 기하 표현을 이용한 연속 굴착 강화학습
- 원문: 논문 PDF
1) 대표그림
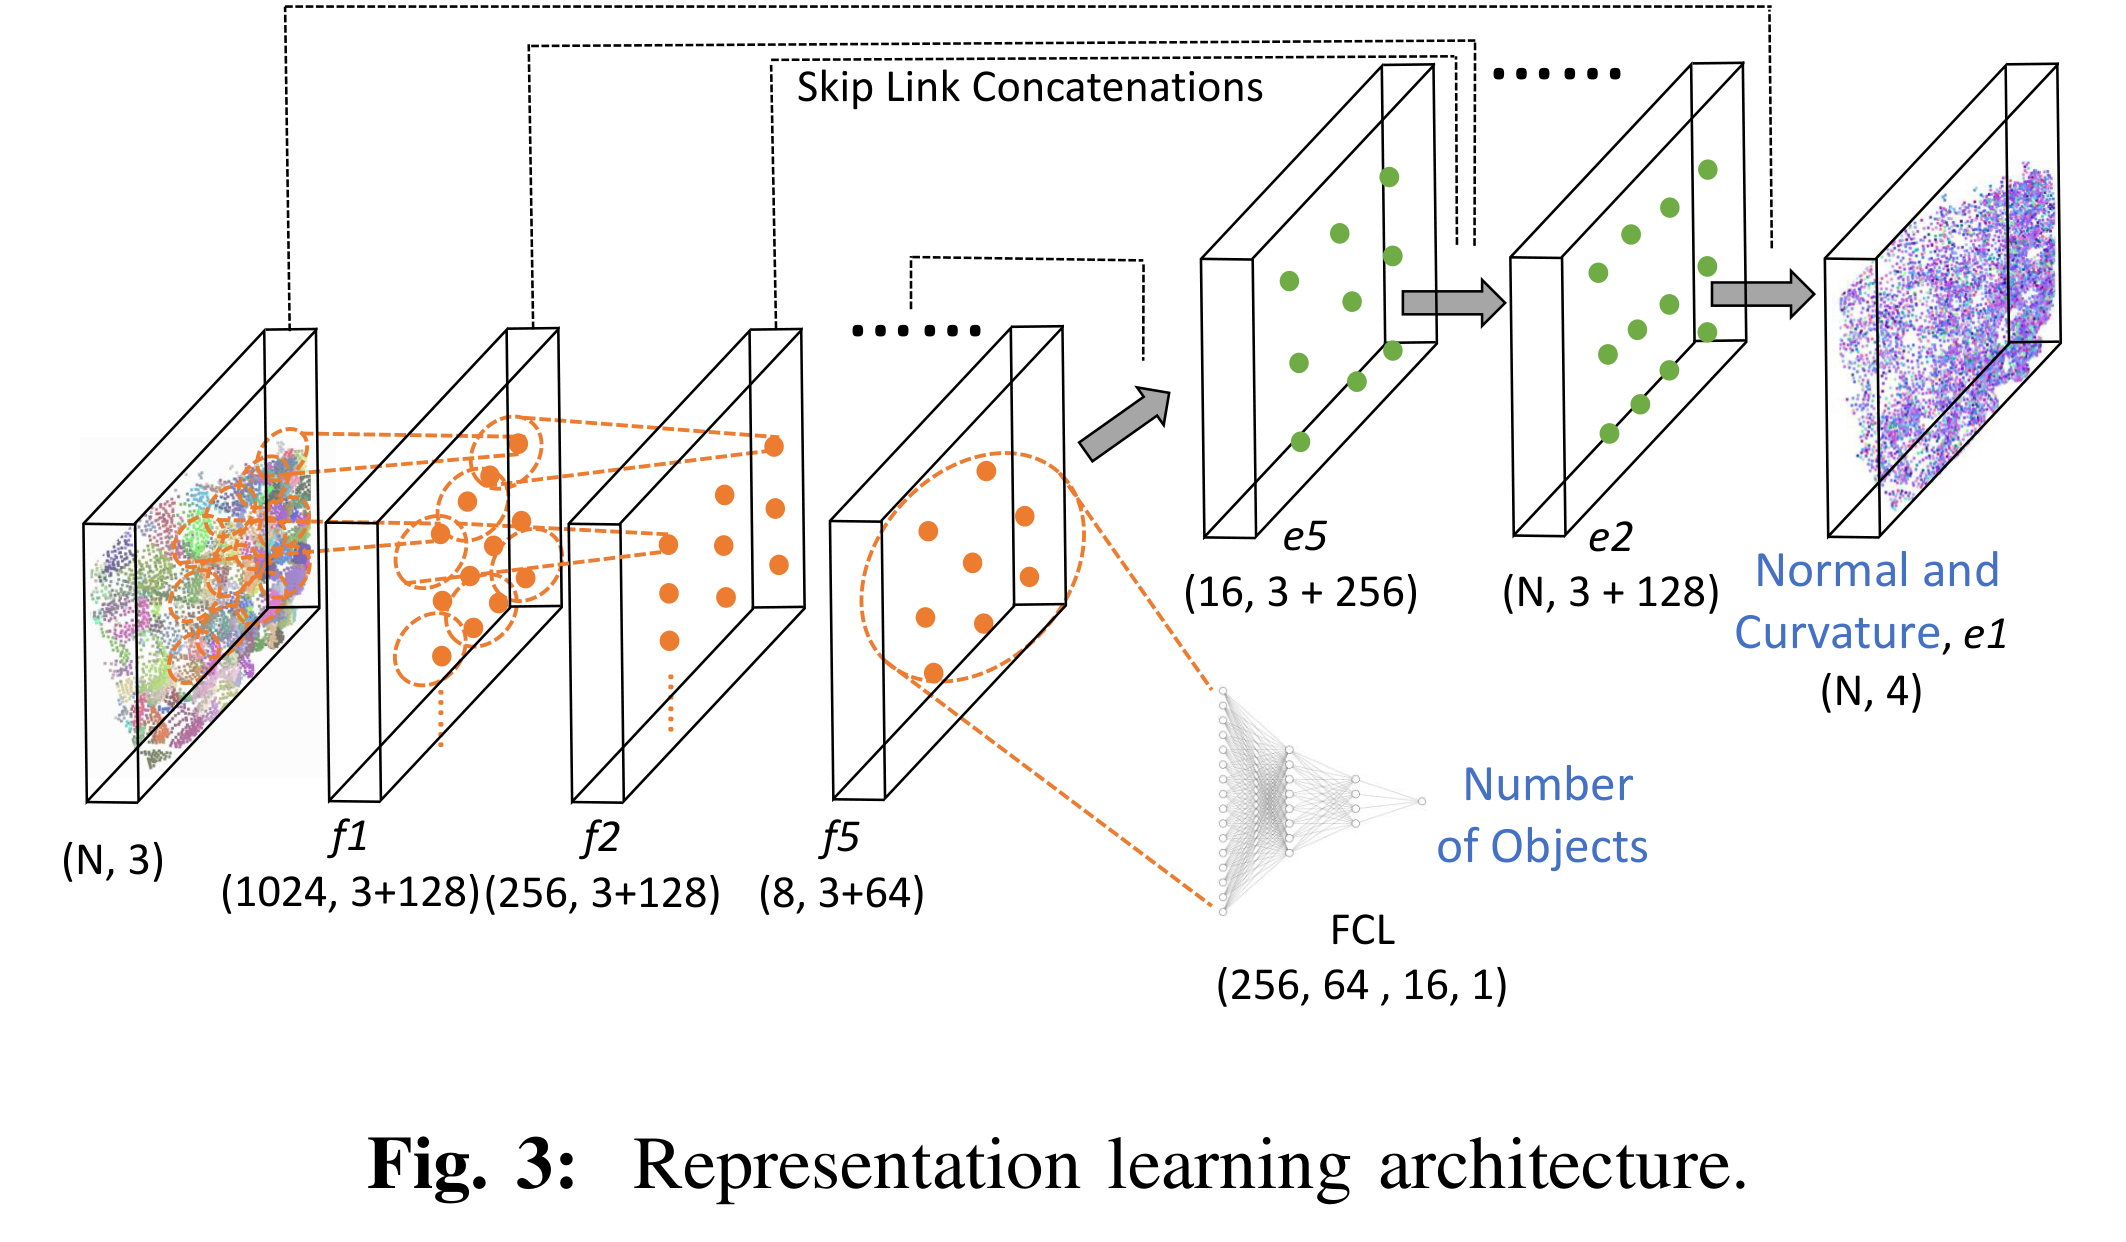
그림 설명: PointNet++ encoder가 장면 점군의 지역 normal·curvature와 전역 object count를 함께 학습해 280차원 굴착 표현을 만드는 구조. 원문 Fig. 3, PDF p.4.
2) 요약
- 한 번의 굴착이 다음 장면을 바꾸는 문제를 MDP로 만들고, 점군 상태에서 공격 pose $(x,y,\alpha)$의 연속열을 PPO로 학습해 장기 누적 굴착체적을 최대화했다.
- 사람 라벨 없이 normal·주곡률·물체 수를 예측하도록 PointNet++를 사전학습한 뒤 encoder를 고정해, 원시 점군 end-to-end 정책보다 작은 280차원 기하 표현으로 RL을 수행한다.
- 기하 표현 정책은 16k parameter와 126시간 39분 학습으로, 205k parameter·163시간 28분의 end-to-end 정책보다 빨랐다. 시뮬레이션 평균 체적/계획성공률도 194.1 cm³(43.1%)/93.1%로 176.6 cm³(39.2%)/87.4%를 상회했다.
- 실제 환경에 tuning 없이 옮겼을 때 기하 표현 정책은 평균 191.0 cm³(42.4%), 계획 25/25 성공을 기록했으나 실행은 14/25만 성공해, 시각적 전이는 개선했지만 접촉·힘 문제는 남았다.
3) 방법
- 표현학습 데이터: PyBullet에서 1-7 cm 크기의 무작위 convex object 100k개를 만들고 장면별 점군을 수집한다. 약 35,000개 장면의 점군을 FPS로 7,000점에 맞춘 뒤 PCL로 normal·주곡률을 계산하고 simulator object count를 사용한다.
- 기하 encoder 학습: PointNet++ feature extraction을 1,024-256-64-16-8점으로 줄이며 특징차원을 128-128-128-64-32로 만든다. 마지막 8개의 $(3D 위치+32D 특징)$을 이어 280차원 표현을 얻고, decoder는 normal·curvature, 별도 FCL은 object count를 예측한다. 총손실은 $10L_{normal}+L_{curv}+L_{obj}$이며 batch 16, Adam, 초기 학습률 0.01, decay $10^{-4}$, 10 epoch로 학습한다.
- PPO 정책 학습: encoder 가중치는 고정하고 256-64 ReLU 정책망만 업데이트한다. 6개 simulator를 병렬 실행해 768 sample마다 갱신하고, planning failure에는 -1 reward, discount 0.99를 사용한다. 200-300개 물체로 만든 장면에서 episode당 10회 굴착하며 총 30,000 sample을 학습한다.
- 행동을 궤적으로 변환: 정책은 tray 좌표계의 $(x,y,\alpha)$만 출력한다. 공격점 $z$는 height map에서 얻고 최대 끌기길이·닫힘각·들기높이는 고정한다. 시뮬레이션은 $d=0.1$ m, 최대 끌기 0.3 m, $\beta=135^\circ$, 들기 0.4 m를 사용한다.
- 계획·실행: 5단계 작업공간 궤적을 100 Hz 관절 waypoint로 이산화하고 IK·self-collision·tray collision을 검사한다. 유효하면 Franka의 joint impedance controller(강성 100 Nm/rad)에 open-loop로 보낸다.
- 실제 검증: Azure RGB-D와 학습에 없던 목재 블록 282개를 사용하며, episode당 5회씩 5 episode를 수행한다. 실제 로봇의 힘 한계 때문에 관입깊이는 0.07 m, 최대 끌기는 0.1 m로 줄이고, 덤핑한 물체의 질량과 추정 밀도로 체적을 계산한다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: simulation-real 표현분포를 비교해 지각 sim-to-real gap을 더 줄이고, 유효 계획에서 실제 굴착체적을 높이며, 불확실한 광산 작업을 위한 replanning·reactive control과 실제 굴착기 전이를 연구하겠다고 밝혔다.
- 해석: RL이 정하는 것은 공격 pose뿐이고 나머지 궤적은 고정값이며 실행도 open-loop다. 실제 기하 표현 정책에서 25회 중 11회가 큰 저항력으로 멈춘 결과는, 지각·계획 성공과 접촉 강건성이 분리되어 있음을 보여준다.
- 연구주제 제안: 기하-접촉 계층형 연속 굴착 정책 - 상위 정책은 point-cloud 기하로 공격 pose와 장기 순서를 고르고, 하위 정책은 힘/토크·버킷속도 피드백으로 관입·끌기를 residual 제어하며, 누적 체적·계획/실행 성공률·걸림률·최대 접촉력·sim-to-real gap으로 검증한다.
[!summary] E. 안전·실환경·종단간 시스템 안전 모니터링, 장시간 실환경 배치, 다중 작업 통합, action chunking 기반 종단간 제어를 다룬다.
2021 · 영상 기반 굴착기 작업·안전 모니터링
- 원문: 논문 PDF
1) 대표그림
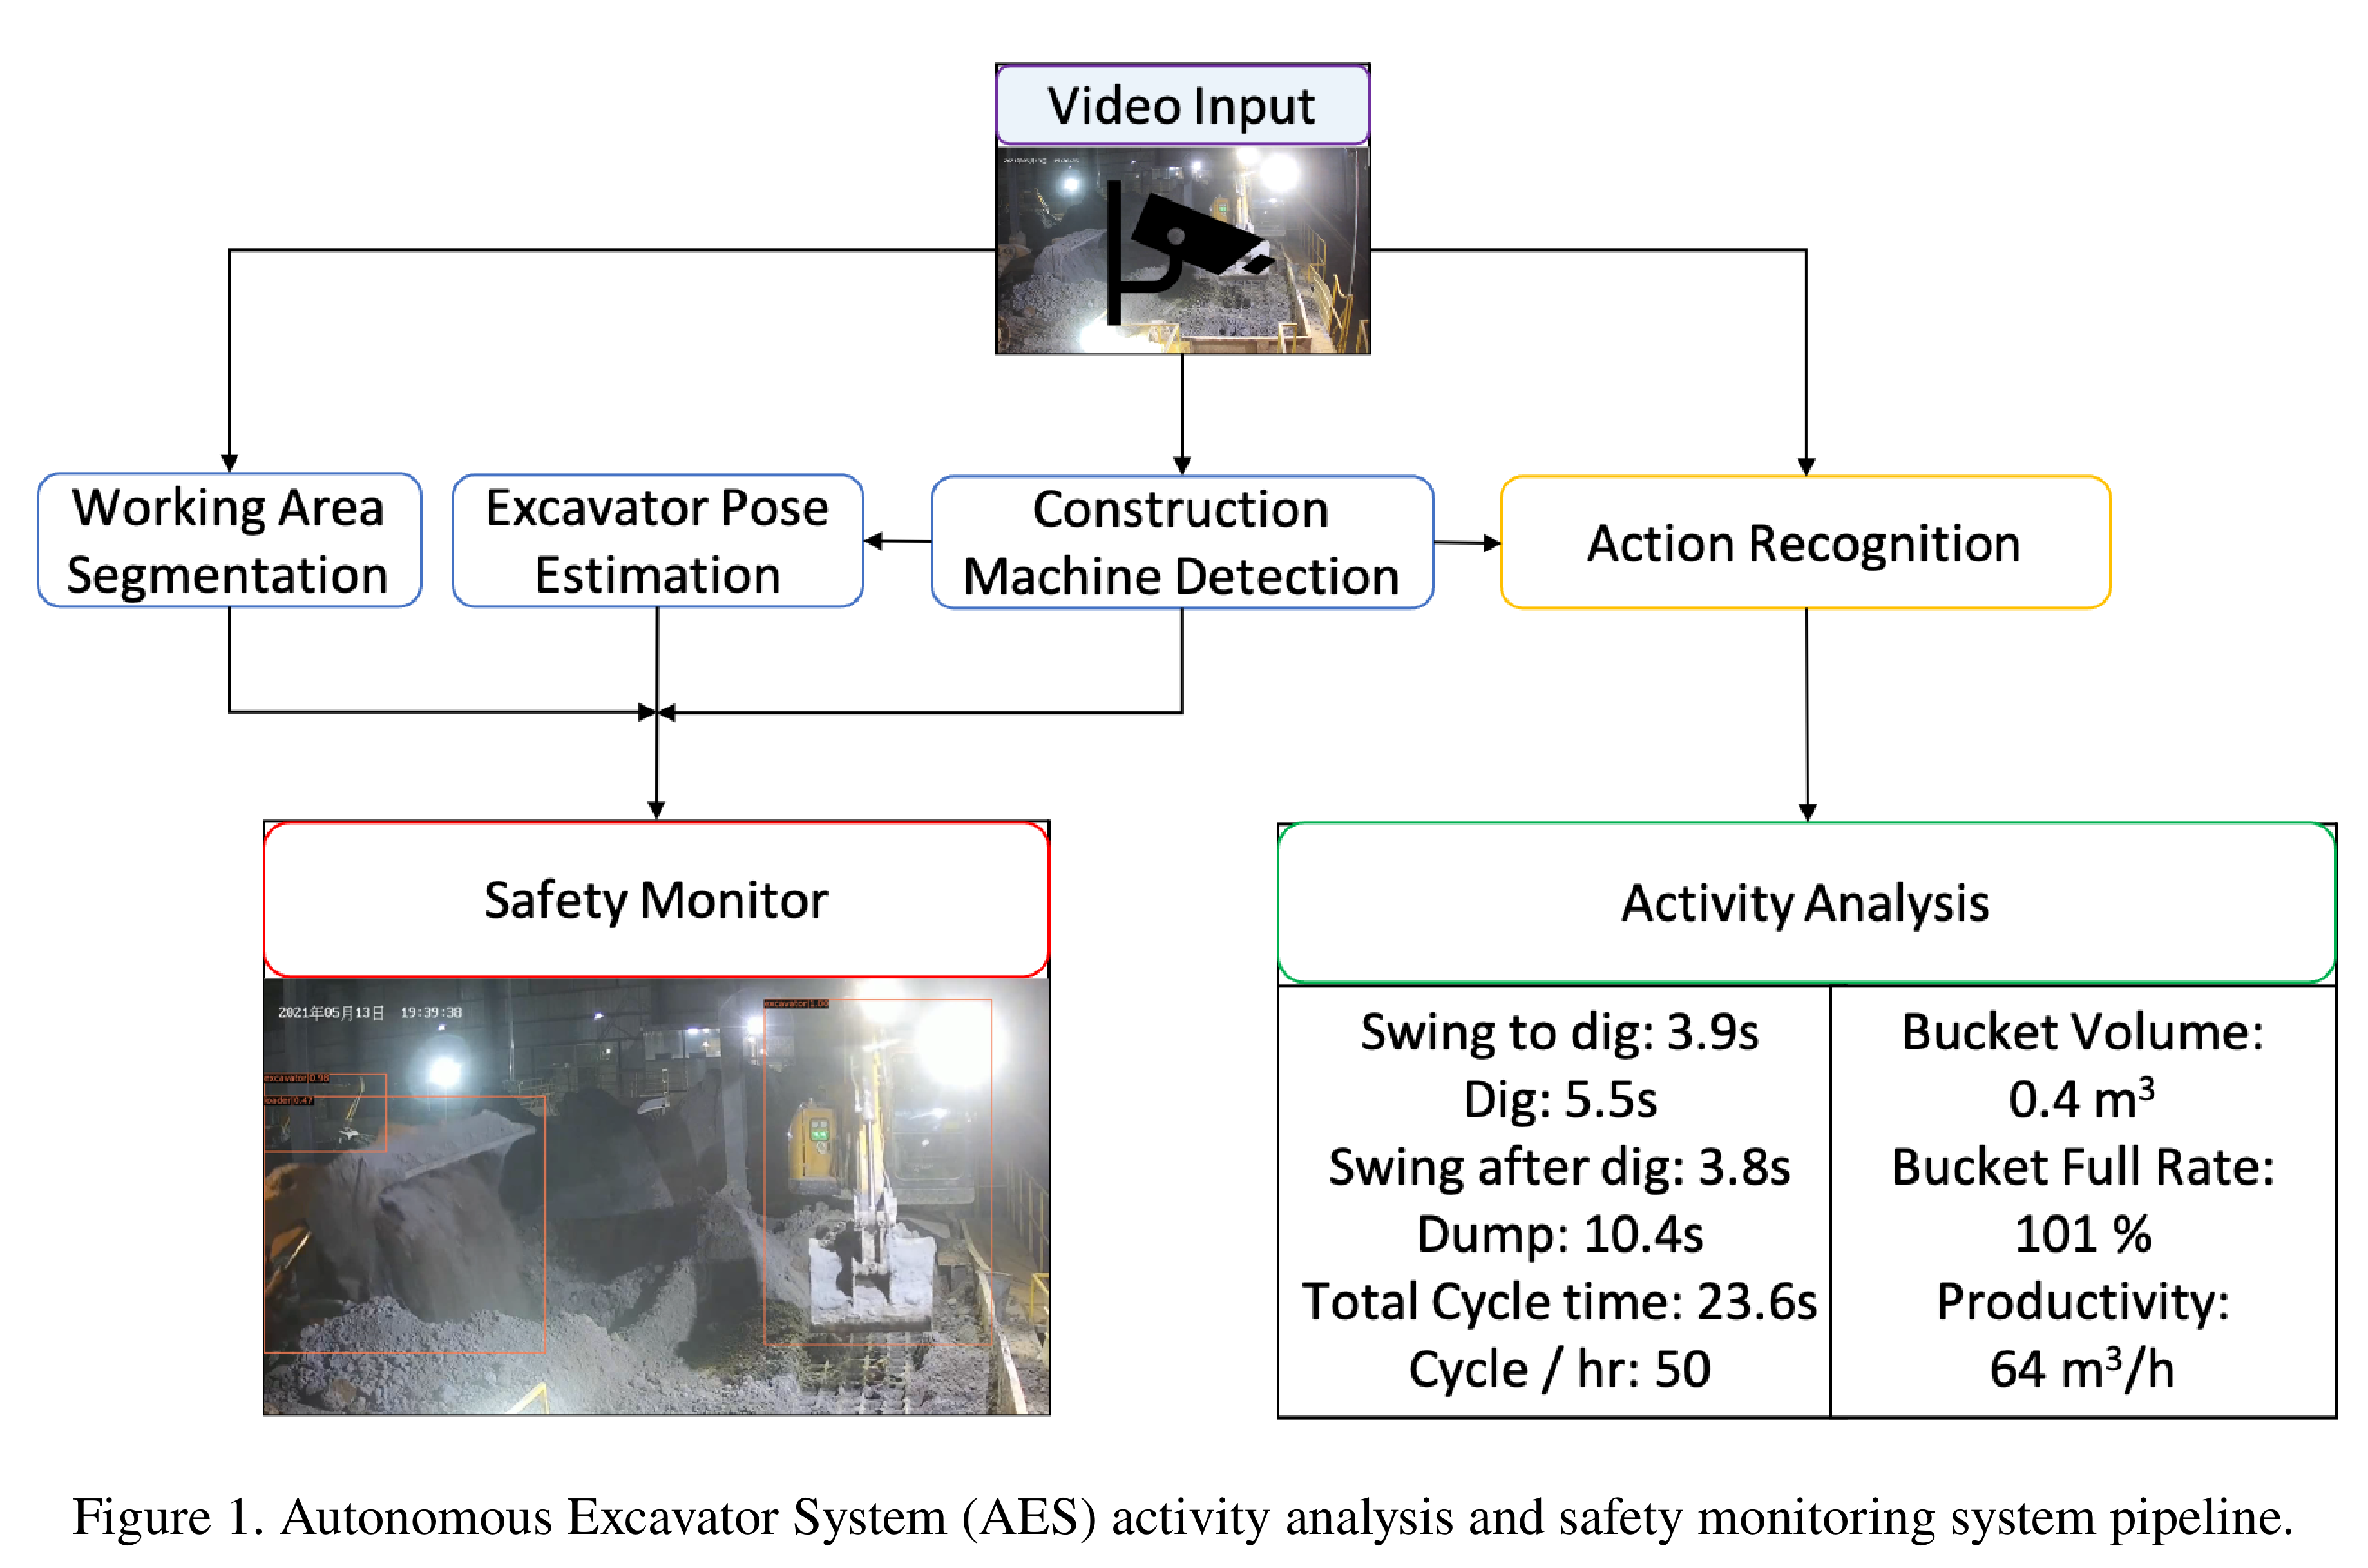
그림 설명: 현장 감시 영상에서 작업영역 분할·건설장비 검출·굴착기 자세 추정·행동 인식을 거쳐 안전 경보와 생산성 분석으로 연결되는 전체 파이프라인. 원문 Figure 1, PDF p.2.
2) 요약
- 현장에 별도 마커나 IMU를 설치하지 않고 감시 카메라 영상만으로 굴착기와 주변 장비를 검출하고, 굴착기 자세·작업 상태·잠재 충돌·생산성을 한 시스템에서 분석한다.
- 핵심은 작업영역 분할, Faster R-CNN 기반 장비 검출, 10개 핵심점 자세 추정, 규칙 기반/SlowFast 기반 행동 인식을 결합한 점이다. 기존 연구가 개별 기능에 머문 데 비해 안전 모니터와 생산성 산정까지 연결했다.
- AES 폐기물 재활용 현장에서 1시간의 영상을 수집해 601개 이미지와 102개 행동 클립을 주석화했으며, 외부 UIUC 건설장비 데이터셋에서도 행동 인식 성능을 평가했다.
- UIUC 데이터셋에서 제안한 행동 인식은 비교 기준보다 top-1 정확도가 약 5.18% 높았고, 15분 작업 영상에서는 실제 40회 중 39회를 검출해 생산성 계산 정확도 97.5%를 보였다.
3) 방법
- 고정 감시 카메라에서 굴착기·로더가 포함된 영상을 수집한다. 논문 데이터는 1920×1080, 25 fps의 1시간 영상이며, 검출·자세·영역 분할용 이미지 601장과 digging/dumping/swinging 행동 클립 102개를 구축했다.
- MMDetection의 Faster R-CNN(ResNet-50/152-FPN)을 학습해 장비 종류와 바운딩 박스를 얻고, Soft-NMS로 중복 박스를 제거한다. 학습률·배치 크기·증강 설정은 원문 구현 세부 확인 필요.
- 검출된 굴착기 박스를 MMPose의 SimpleBaseline(ResNet)에 입력해 bucket end 2점, bucket joint, arm joint, boom cylinder, boom base, body 4점의 총 10개 핵심점을 추정한다. 부품 중심보다 모서리를 주석해 정확도를 높였다.
- MMSegmentation의 ResNet 기반 분할망으로 digging area와 dumping area를 구분하고, 핵심점이 어느 영역에 있는지 결합한다. 분할 클래스 정의와 네트워크 세부 구성은 원문 구현 세부 확인 필요.
- 안전 모니터에는 연속 프레임의 body 1-4 핵심점 평균 이동량과 bucket/arm 위치를 이용한 상태 규칙을 적용한다. 몸체 이동 임계값과 이전 상태로 digging, swing-to-dump, dumping, swing-to-dig, idle을 판정하며, 임계값 수치는 원문 구현 세부 확인 필요하다. 생산성 분석에는 SlowFast를 별도로 학습해 영상 행동 라벨을 생성한다.
- 굴착기와 다른 장비가 동일한 digging/working 영역에 검출되면 경보를 내고 자율장비를 일시 정지한다. 생산성은 연속 프레임 행동 라벨의 지속시간과 이웃한 digging 시작점 사이의 주기, 제조사 버킷 용량, 버킷 충만율을 결합해 계산한다.
- 이미지는 80% 학습·20% 검증/시험으로 나누고 COCO AP/OKS와 행동 top-1 정확도로 평가한다. 논문은 NVIDIA M40 24 GB에서 각 모듈 학습에 약 6시간이 걸렸고 검출·자세·행동 인식 속도가 각각 5·2·1 fps였다고 보고한다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: AES의 비교적 단순한 폐기물 재활용 장면에서 수집해 데이터셋이 작다는 점을 직접 한계로 든다. 구체적인 후속 연구 항목은 별도로 제시하지 않았다.
- 분석상 한계: 해석: 충돌 판단이 동일 영역 내 복수 장비 검출이라는 공간 규칙에 의존해 상대 속도·예측 궤적·time-to-collision을 반영하지 못한다. 또한 핵심 모듈이 1-5 fps로 동작하므로 빠르게 접근하는 장비에 대한 경보 지연을 별도로 검증할 필요가 있다.
- 연구주제 제안: 다중 카메라 추적과 궤적 예측으로 굴착기-작업자/장비의 time-to-collision을 산출하는 동적 안전 모니터를 개발하고, 미관측 현장에서 위험사건 재현율·시간당 오경보·경보 지연으로 검증한다.
- 연구주제 제안: 소규모 단일 현장 데이터의 한계를 줄이기 위해 합성 영상과 자기지도 도메인 적응을 결합한 굴착기 행동 인식기를 개발하고, 조명·분진·카메라 시점이 다른 현장 간 top-1 정확도와 검출 mAP 하락폭으로 일반화 성능을 평가한다.
2022 · 실환경 배치형 자율 굴착기 시스템
- 원문: 논문 PDF
1) 대표그림
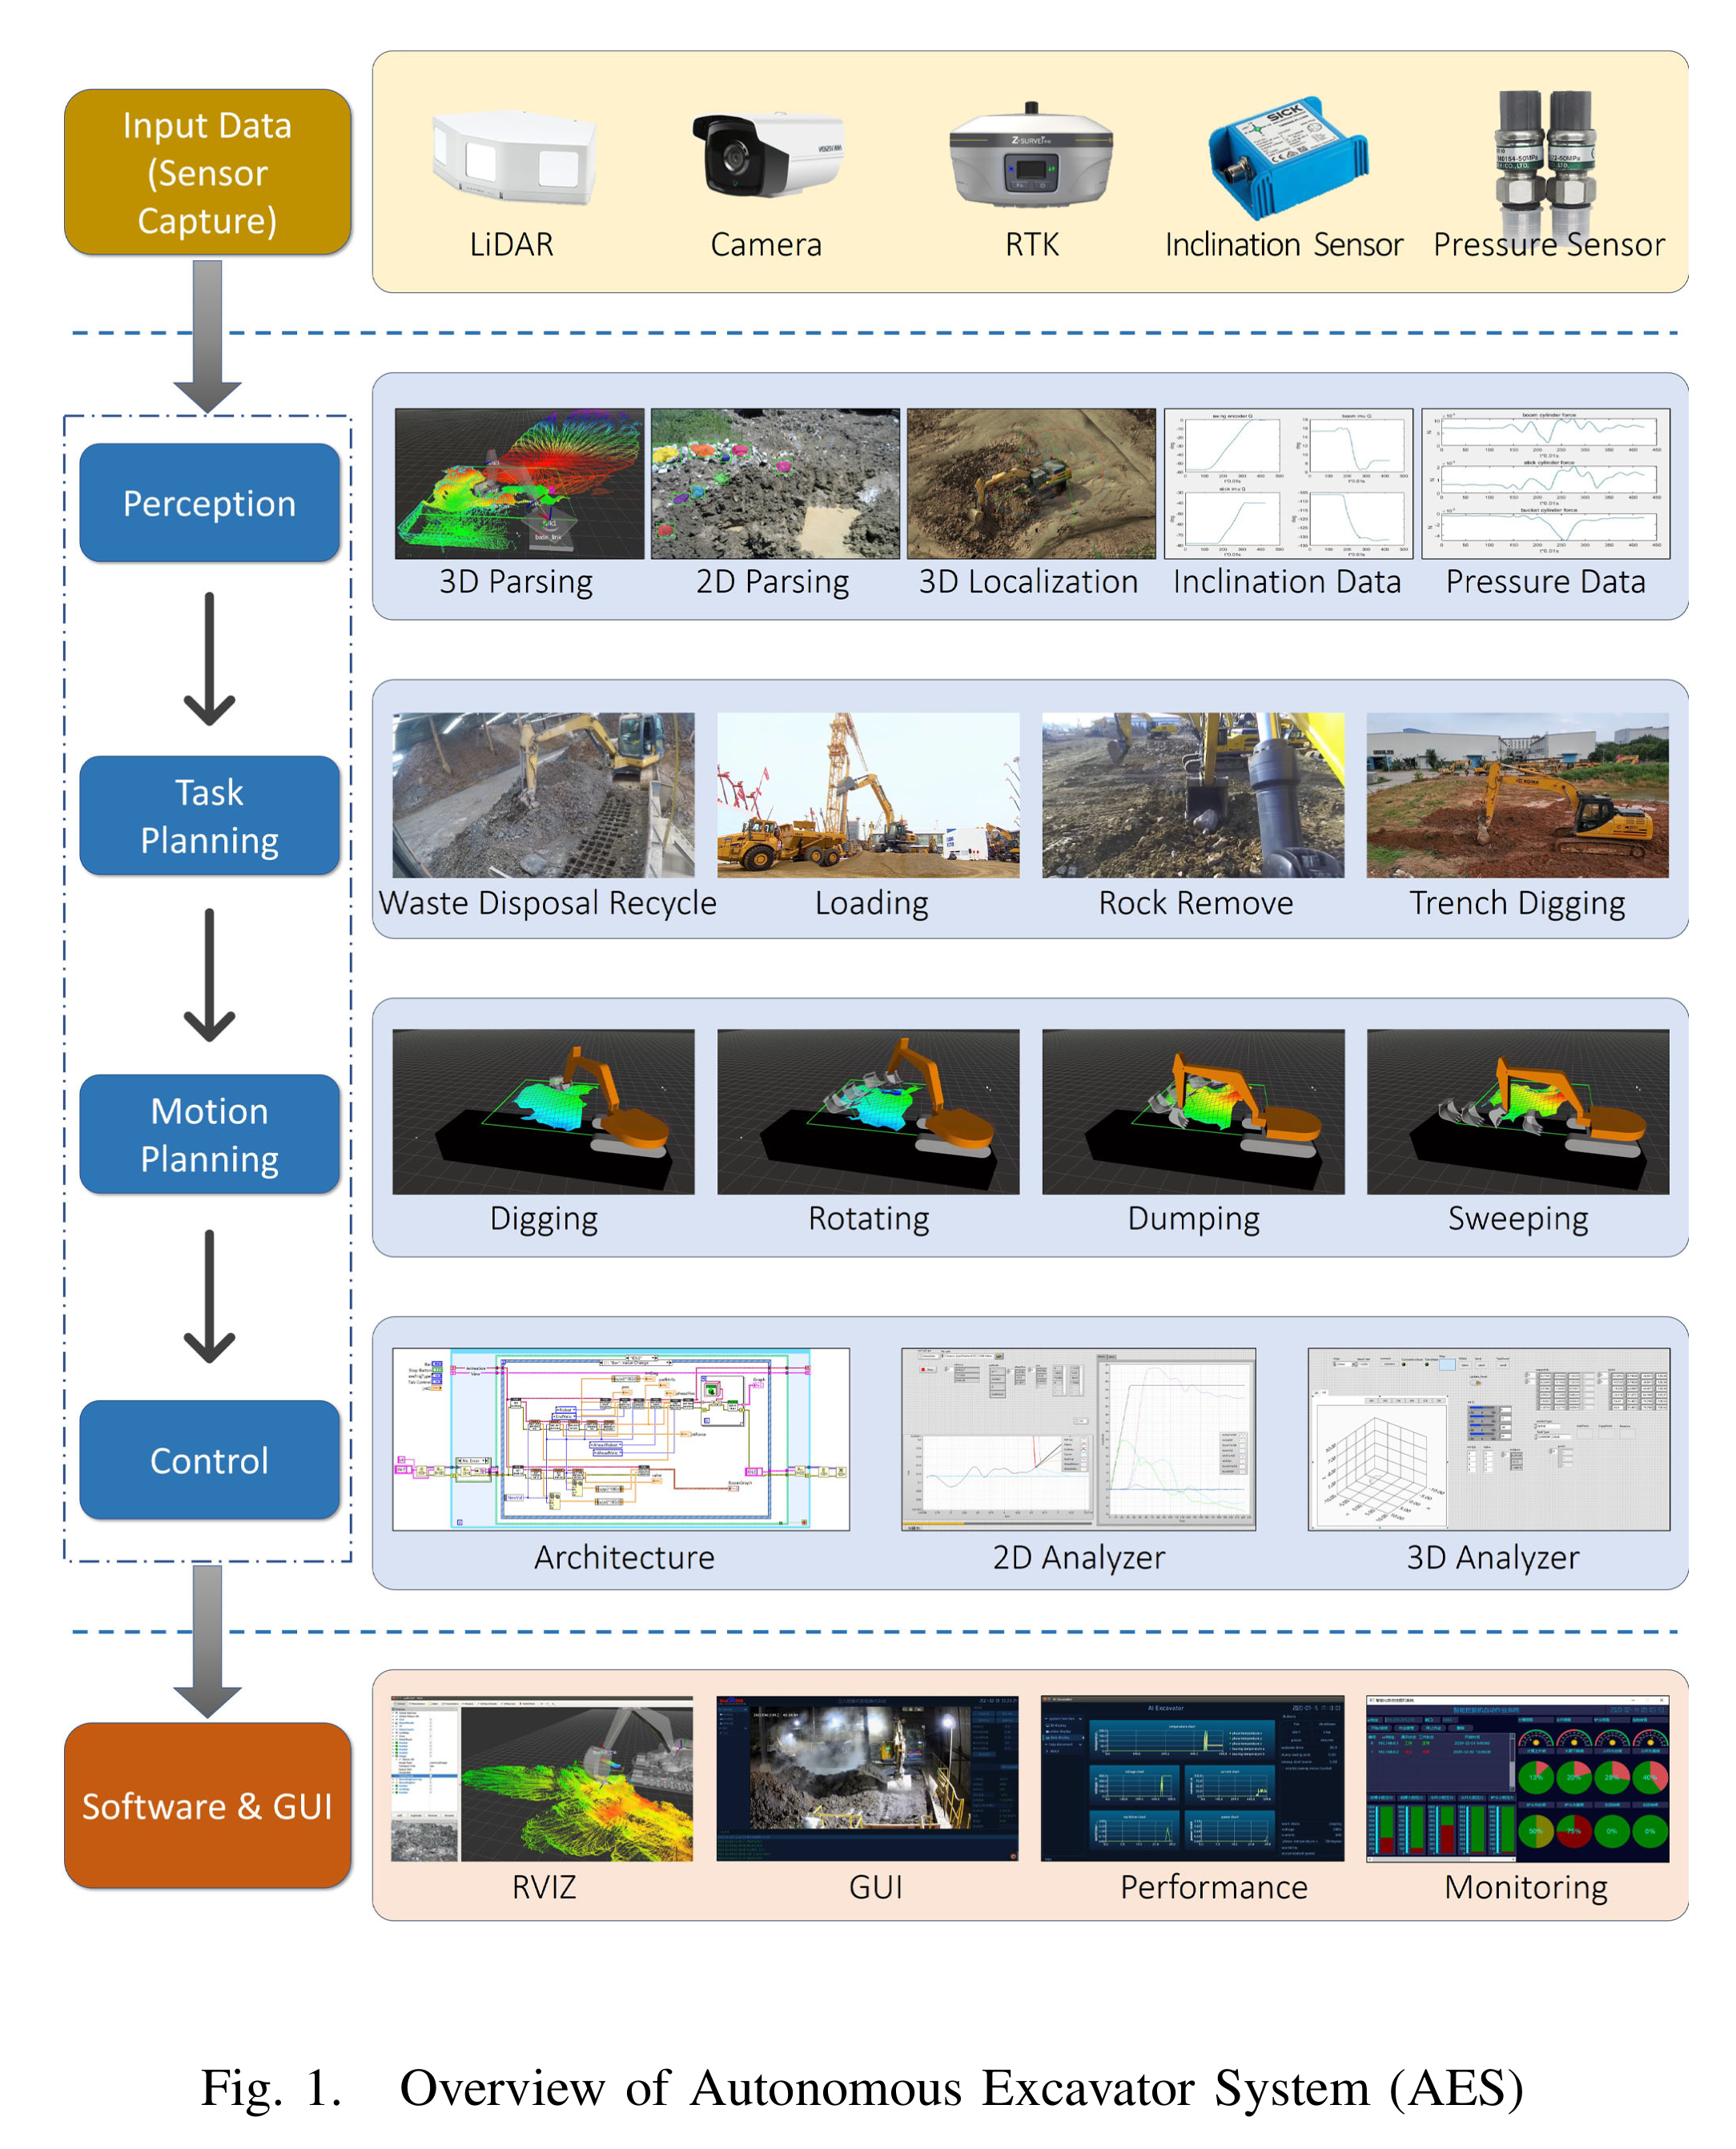
그림 설명: LiDAR·카메라·RTK·경사·압력 센서 입력부터 perception-task planning-motion planning-control 및 운영 GUI까지 이어지는 AES의 하드웨어·소프트웨어 계층. 원문 Figure 1, PDF p.1.
2) 요약
- 비정형 광산·건설 현장의 자재 상차를 위해 멀티모달 인지, 계층형 작업/동작 계획, 유압 제어를 ROS 기반으로 통합한 자율 굴착기 시스템(AES)을 제시한다.
- 인지는 분진 제거→재질/물체의 거친 후보 추출→정밀 2D 분할→LiDAR 깊이 융합의 coarse-to-fine 구조이며, 계획은 굴착기 팔과 주행 베이스를 분리한 계층 구조다.
- 실제 폐기물 처리 현장의 7.5톤 굴착기에서 24시간 연속 무인 운전을 달성했고 고객 사용 시간이 8,500시간을 넘었으며, 시간당 최대 67.1 m³의 자재를 처리했다고 보고한다.
- 200 m²보다 큰 실제 작업장에서 모든 주행 시험의 목표 도달에 성공하고 평균 위치 오차를 9 cm 미만으로 유지했다.
3) 방법
- CAN 버스 drive-by-wire가 가능한 유압 굴착기에 RTK, 관절 경사계, LiDAR, RGB 카메라를 장착하고 비상시 인간이 제어권을 회수하는 fallback을 둔다. 압력 센서까지 포함한 전체 입력 계층은 Figure 1에 제시되지만 센서 모델·장착 좌표·보정법은 원문 구현 세부 확인이 필요하다.
- 모든 기능을 ROS 노드로 병렬 실행한다. 인지 노드는 장애물·지형·재질·덤프트럭을 추정하고, 계획 노드는 팔/베이스 궤적을 만들며, 제어 노드는 이를 CAN 하드웨어 명령으로 변환한다.
- coarse-to-fine 인지는 먼저 분진 제거 영상과 재질 인식으로 stone/puddle/pipe 후보 영역을 좁힌 뒤 2D 검출·분할을 수행하고, 해당 마스크와 LiDAR 깊이를 융합해 3D 장애물 박스를 맞춘다. 분진 제거망은 공유 encoder와 대기광·clean image·transmission map의 3개 decoder 및 clean/reconstruction loss를 사용하지만 정확한 학습 설정은 원문 구현 세부 확인이 필요하다.
- LiDAR-카메라 의미·기하 정보를 융합해 고도/장애물/재질 기반 traversability map을 만든다. 최대 등판각, 차체 폭, 계산 예산을 반영해 통과 불가능 영역을 먼저 배제하고 나머지 영역의 기하·의미 가중치를 조정해 주행 궤적을 계획한다.
- high-level task planner가 이동 목표와 굴착 구역을 선택하고, MRSP(material removal sub-task planner)와 BMSP(base move sub-task planner)가 세부 굴착 및 waypoint를 생성한 뒤 motion primitive가 실행 가능한 팔·베이스 동작을 만든다. 개별 비용함수와 탐색 파라미터는 원문 구현 세부 확인이 필요하다.
- 계층형 제어기는 bucket end-effector 추종기, 베이스 제어기, 명령 속도를 유압 밸브 명령으로 바꾸는 장비별 lookup table로 구성한다. 실제 현장에서는 컨베이어 처리율에 맞춰 상차 속도를 조절하고 건식·습식 자재 및 야간 운전을 반복 시험한다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 파쇄암 굴착과 악천후 등 더 다양한 환경으로 확장하고, 자재의 물성 및 굴착 저항력을 감지·모델링하는 방법을 개발하겠다고 밝혔다.
- 분석상 한계: 해석: 8,500시간 배치는 강한 실증 근거지만 고정된 폐기물 상차 공정 중심이며, 여러 작업·토질·기상 조건에서의 실패율이나 안전 개입률은 보고되지 않았다. 각 인지·계획·제어 모듈의 세부 파라미터도 대부분 선행 논문으로 분산돼 이 논문만으로 완전 재현하기 어렵다.
- 연구주제 제안: 카메라·LiDAR의 자재 형상과 유압 압력으로 토질 물성·굴착 저항을 온라인 추정하고 digging primitive를 적응시키는 제어기를 개발해 사이클 시간·버킷 충만율·단위 체적 에너지·stall 비율로 검증한다.
- 연구주제 제안: 파쇄암·분진·강우를 포함한 조건별 시뮬레이션-실차 벤치마크를 만들고 불확실성 추정 기반 인지-계획 fallback을 적용해 무개입 운전시간, 작업 성공률, 위험정지율로 강건성을 평가한다.
2024 · 건설 자동화용 다중작업 자율 굴착기
- 원문: 논문 PDF
1) 대표그림
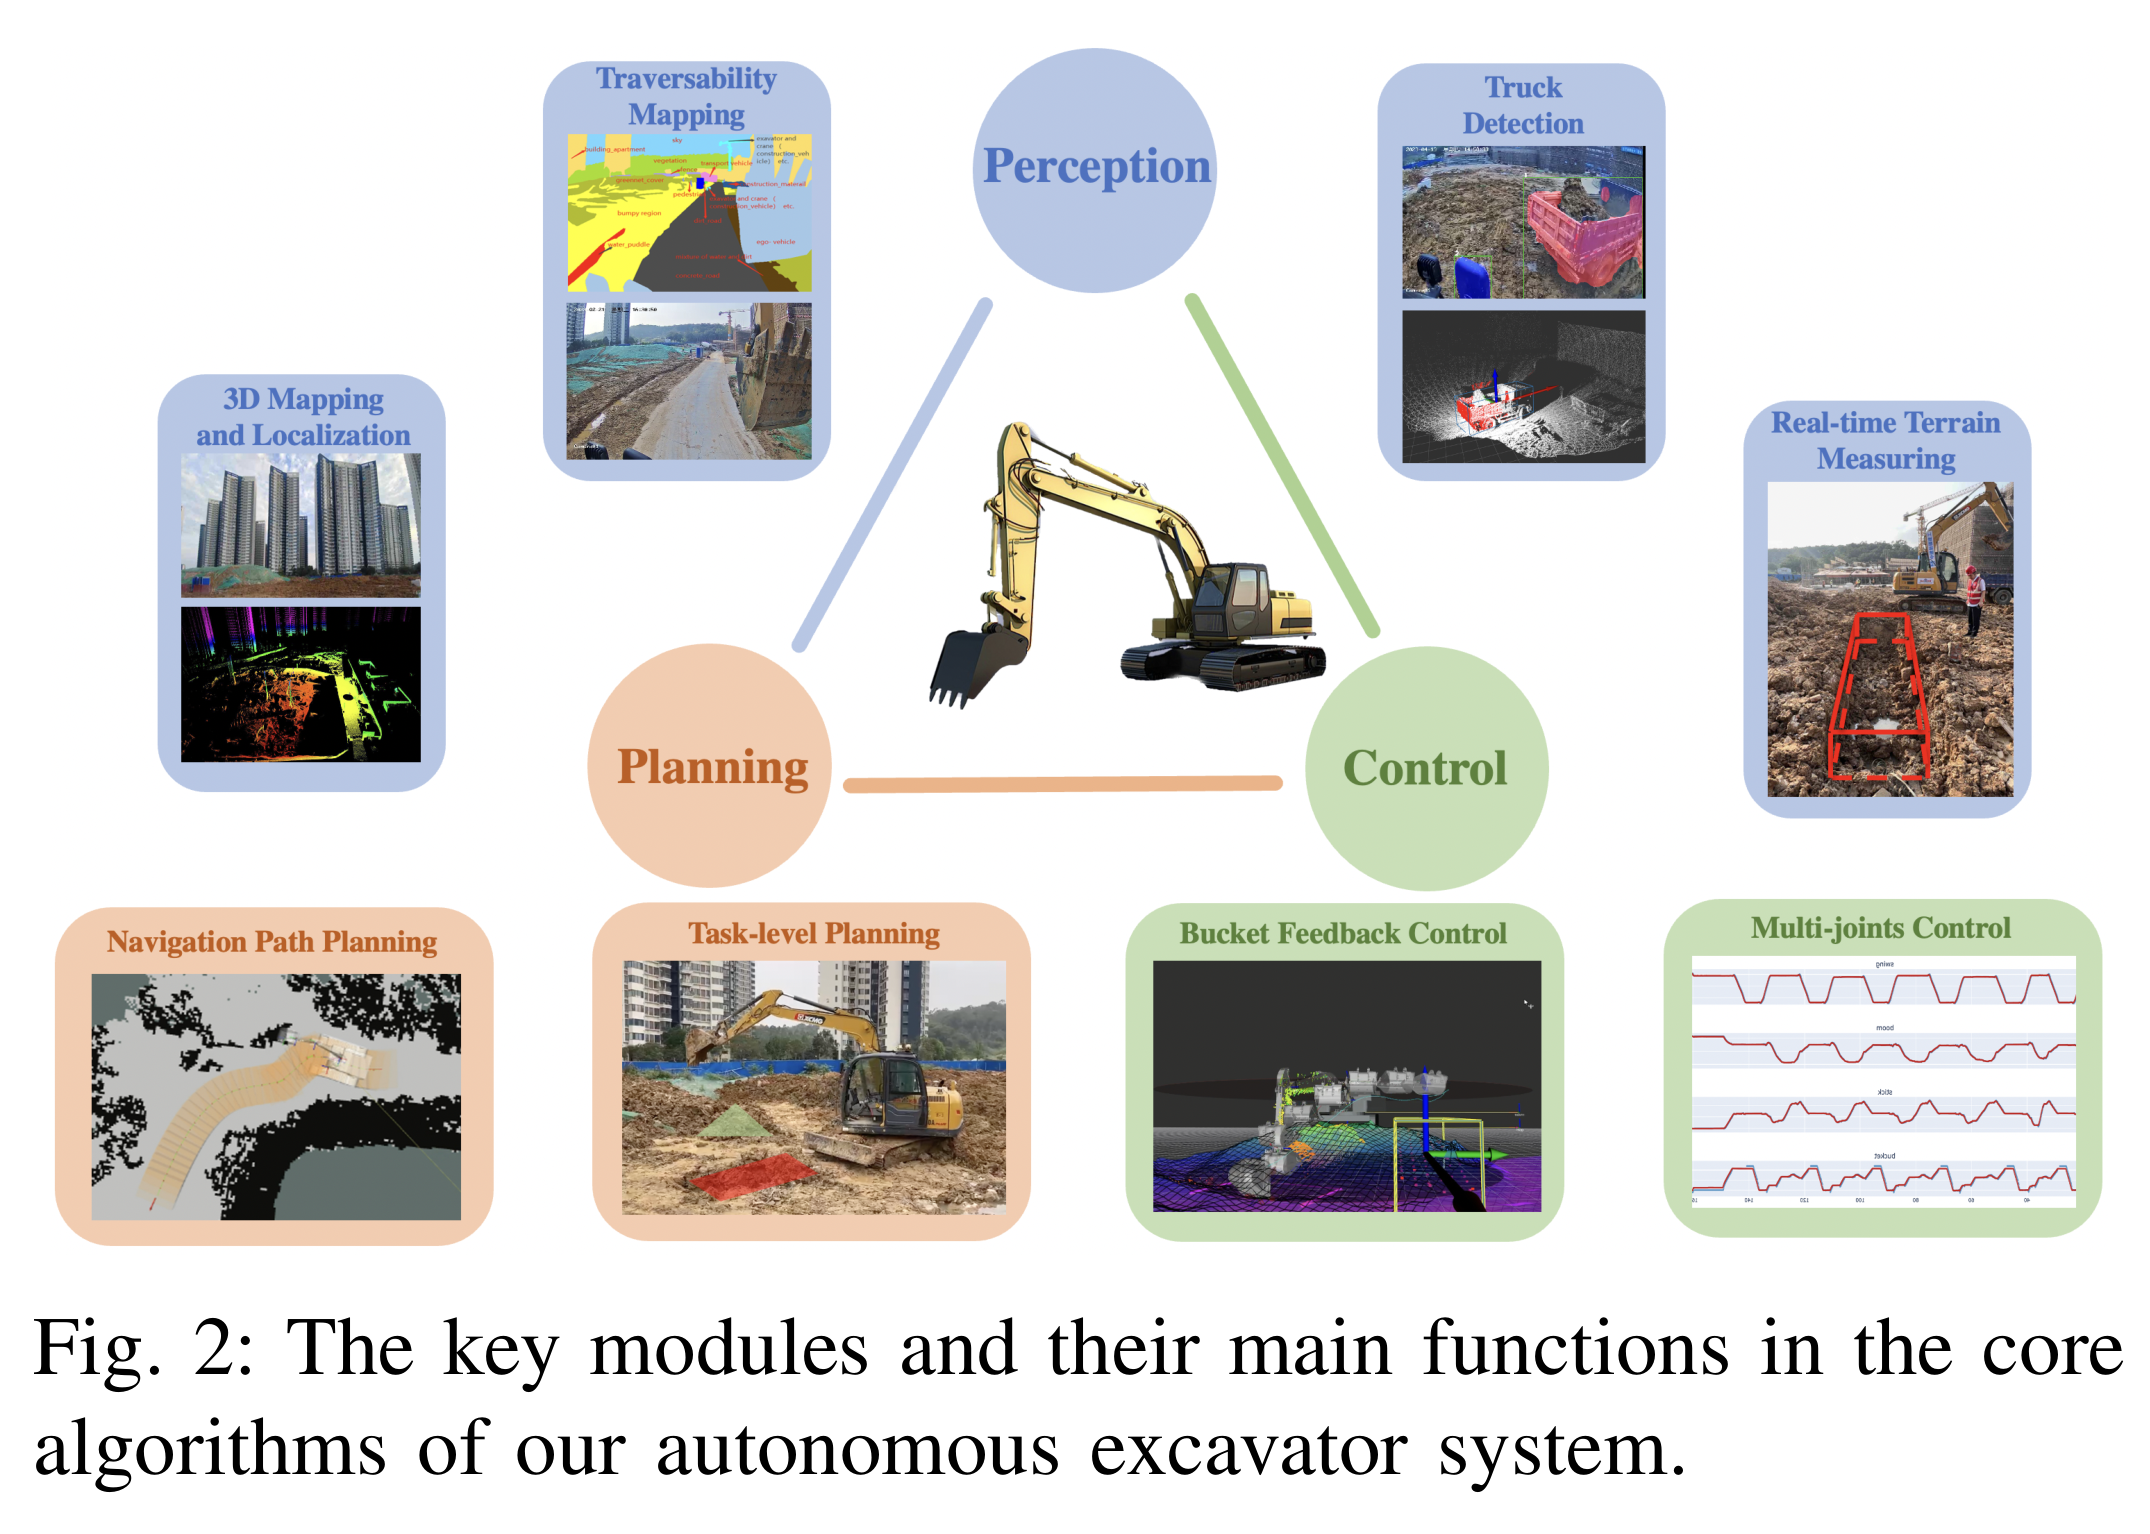
그림 설명: perception-planning-control의 세 축과 3D 위치추정, traversability map, 트럭 검출, 실시간 지형 측정, 작업/경로 계획, 버킷·다관절 제어를 한눈에 정리한 핵심 모듈 구성. 원문 Figure 2, PDF p.2.
2) 요약
- 기존 AES를 건설 토공으로 확장해 트럭 상차, 비정형 지형 자율주행, 트렌칭을 한 번의 시연에서 사람 개입 없이 연속 수행한 다중작업 시스템을 제시한다. 저자 주장 기준 세 작업을 연속 수행한 최초의 자율 굴착기 시스템이다.
- 저장된 전역 점군과 실시간 LiDAR 스캔의 정합, RGB 기반 트럭 검출+LiDAR 기반 3D 자세 추정, 실시간 elevation/traversability map, 계층형 작업 계획과 Hybrid A* 주행을 통합한다.
- 트럭 상차의 버킷 RMS 추종 오차는 x/y/z축에서 각각 0.167/0.135/0.282 m였고, 1×1×6 m 트렌치를 11.78분에 굴착해 평균 깊이 오차 0.020±0.101 m를 기록했다.
- 주행 오차는 시간의 약 90%에서 0.3 m 미만이었고, 별도 emergency-stop 시험에서는 전방 6×4 m 안전영역에 장애물이 진입하면 정지해 약 2 m 거리를 남겼다.
3) 방법
- 7.5톤 CAN drive-by-wire 굴착기에 RTK-GPS, 관절 경사계, 3D LiDAR, RGB 카메라를 장착한다. traversability와 비상정지는 같은 센서 구성을 갖춘 20톤 굴착기에서도 시험했다. 센서 모델·외부/시간 보정은 원문 구현 세부 확인이 필요하다.
- 작업 시작 시 360° LiDAR 스캔을 저장된 전역 점군 지도에 정합해 굴착기 위치를 초기화한다. RGB에서 트럭을 검출한 뒤 해당 LiDAR 점군으로 3D 트럭 자세를 추정하고, LiDAR elevation map과 작업자가 지정한 굴착 구역을 작업 계획 입력으로 사용한다.
- 점군·RGB로 실시간 elevation grid를 갱신하며 각 cell에 최신 평균 높이, 갱신 시각, 경사, step height, semantic 정보를 저장한다. 장비의 등판 능력을 벗어난 cell은 비통과로 두고 나머지는 의미·기하 점수를 융합해 traversability map을 만든다.
- high-level planner가 이동 위치와 굴착 영역을 정하고, material-removal/base-move sub-task planner가 세부 작업을 분해하며, motion primitive가 팔과 베이스의 실행 궤적을 생성한다. 주행은 Hybrid A*로 곡률을 제한해 연약지반에서 걸리지 않도록 한다. 계획 비용·높이 종료 임계값은 원문 구현 세부 확인이 필요하다.
- 트럭 상차에서는 굴착기 기준 45° 방향의 2×3×1 m 굴착 박스와 추정 트럭 자세를 사용한다. 트렌칭에서는 1×1×6 m 영역을 1×1×2 m sub-task로 나누고 인접 구간을 1 m 겹치며, elevation map에서 dig point를 선택해 목표 높이까지 dig-and-dump를 반복한다.
- 주행 중 별도 비상정지 노드는 LiDAR scan을 sector로 나눠 지면을 추정하고 높이 임계값으로 양/음 장애물을 분리한 뒤 OctoMap 기반 2D occupancy map을 만든다. 계획 경로와 충분히 큰 장애물이 겹치면 planner와 controller를 즉시 종료한다. 지면·크기 임계값은 원문 구현 세부 확인이 필요하다.
- 작업 성공 여부와 함께 버킷 RMS 오차, 트렌치 깊이 오차·완료시간, 주행 횡오차, 정지 거리 및 검출 가능한 장애물 크기로 평가한다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: 시연은 다른 차량·작업자가 없는 통제 구역에서 수행됐고 당시 주행 중 장애물을 능동 감시하지 않았다. 현재도 주행 planner는 장애물을 회피하도록 재계획하지 않고 별도 모듈이 정지만 수행하며, 유압 관절 결합으로 버킷 추종 오차가 발생해 제어 정밀도 개선 여지가 있다. 향후 파쇄암·악천후로 범위를 넓히고 강건성과 신뢰성을 높여 실제 건설 프로젝트에 배치할 계획이다.
- 분석상 한계: 해석: 정적 장애물에 대한 hard stop은 검증됐지만 작업자·차량이 움직이는 현장의 예측 회피, 안전 정지 후의 복구 계획, 센서 가림·분진 상황의 안전 성능은 아직 검증 범위 밖이다.
- 연구주제 제안: 이동 작업자·차량의 궤적 불확실성을 semantic occupancy forecast로 예측해 Hybrid A*를 실시간 재계획하는 굴착기 주행기를 개발하고 충돌률·최소 이격거리·재계획 지연·작업 완료율로 검증한다.
- 연구주제 제안: 유압 관절 결합과 토질 부하를 온라인 식별하는 residual model을 기존 버킷 추종 제어기에 결합하고, 다양한 적재량에서 3축 RMS 오차·overshoot·사이클 시간으로 효과를 평가한다.
2024 · ExACT: 행동 청킹 Transformer 기반 종단간 제어
- 원문: 논문 PDF
1) 대표그림
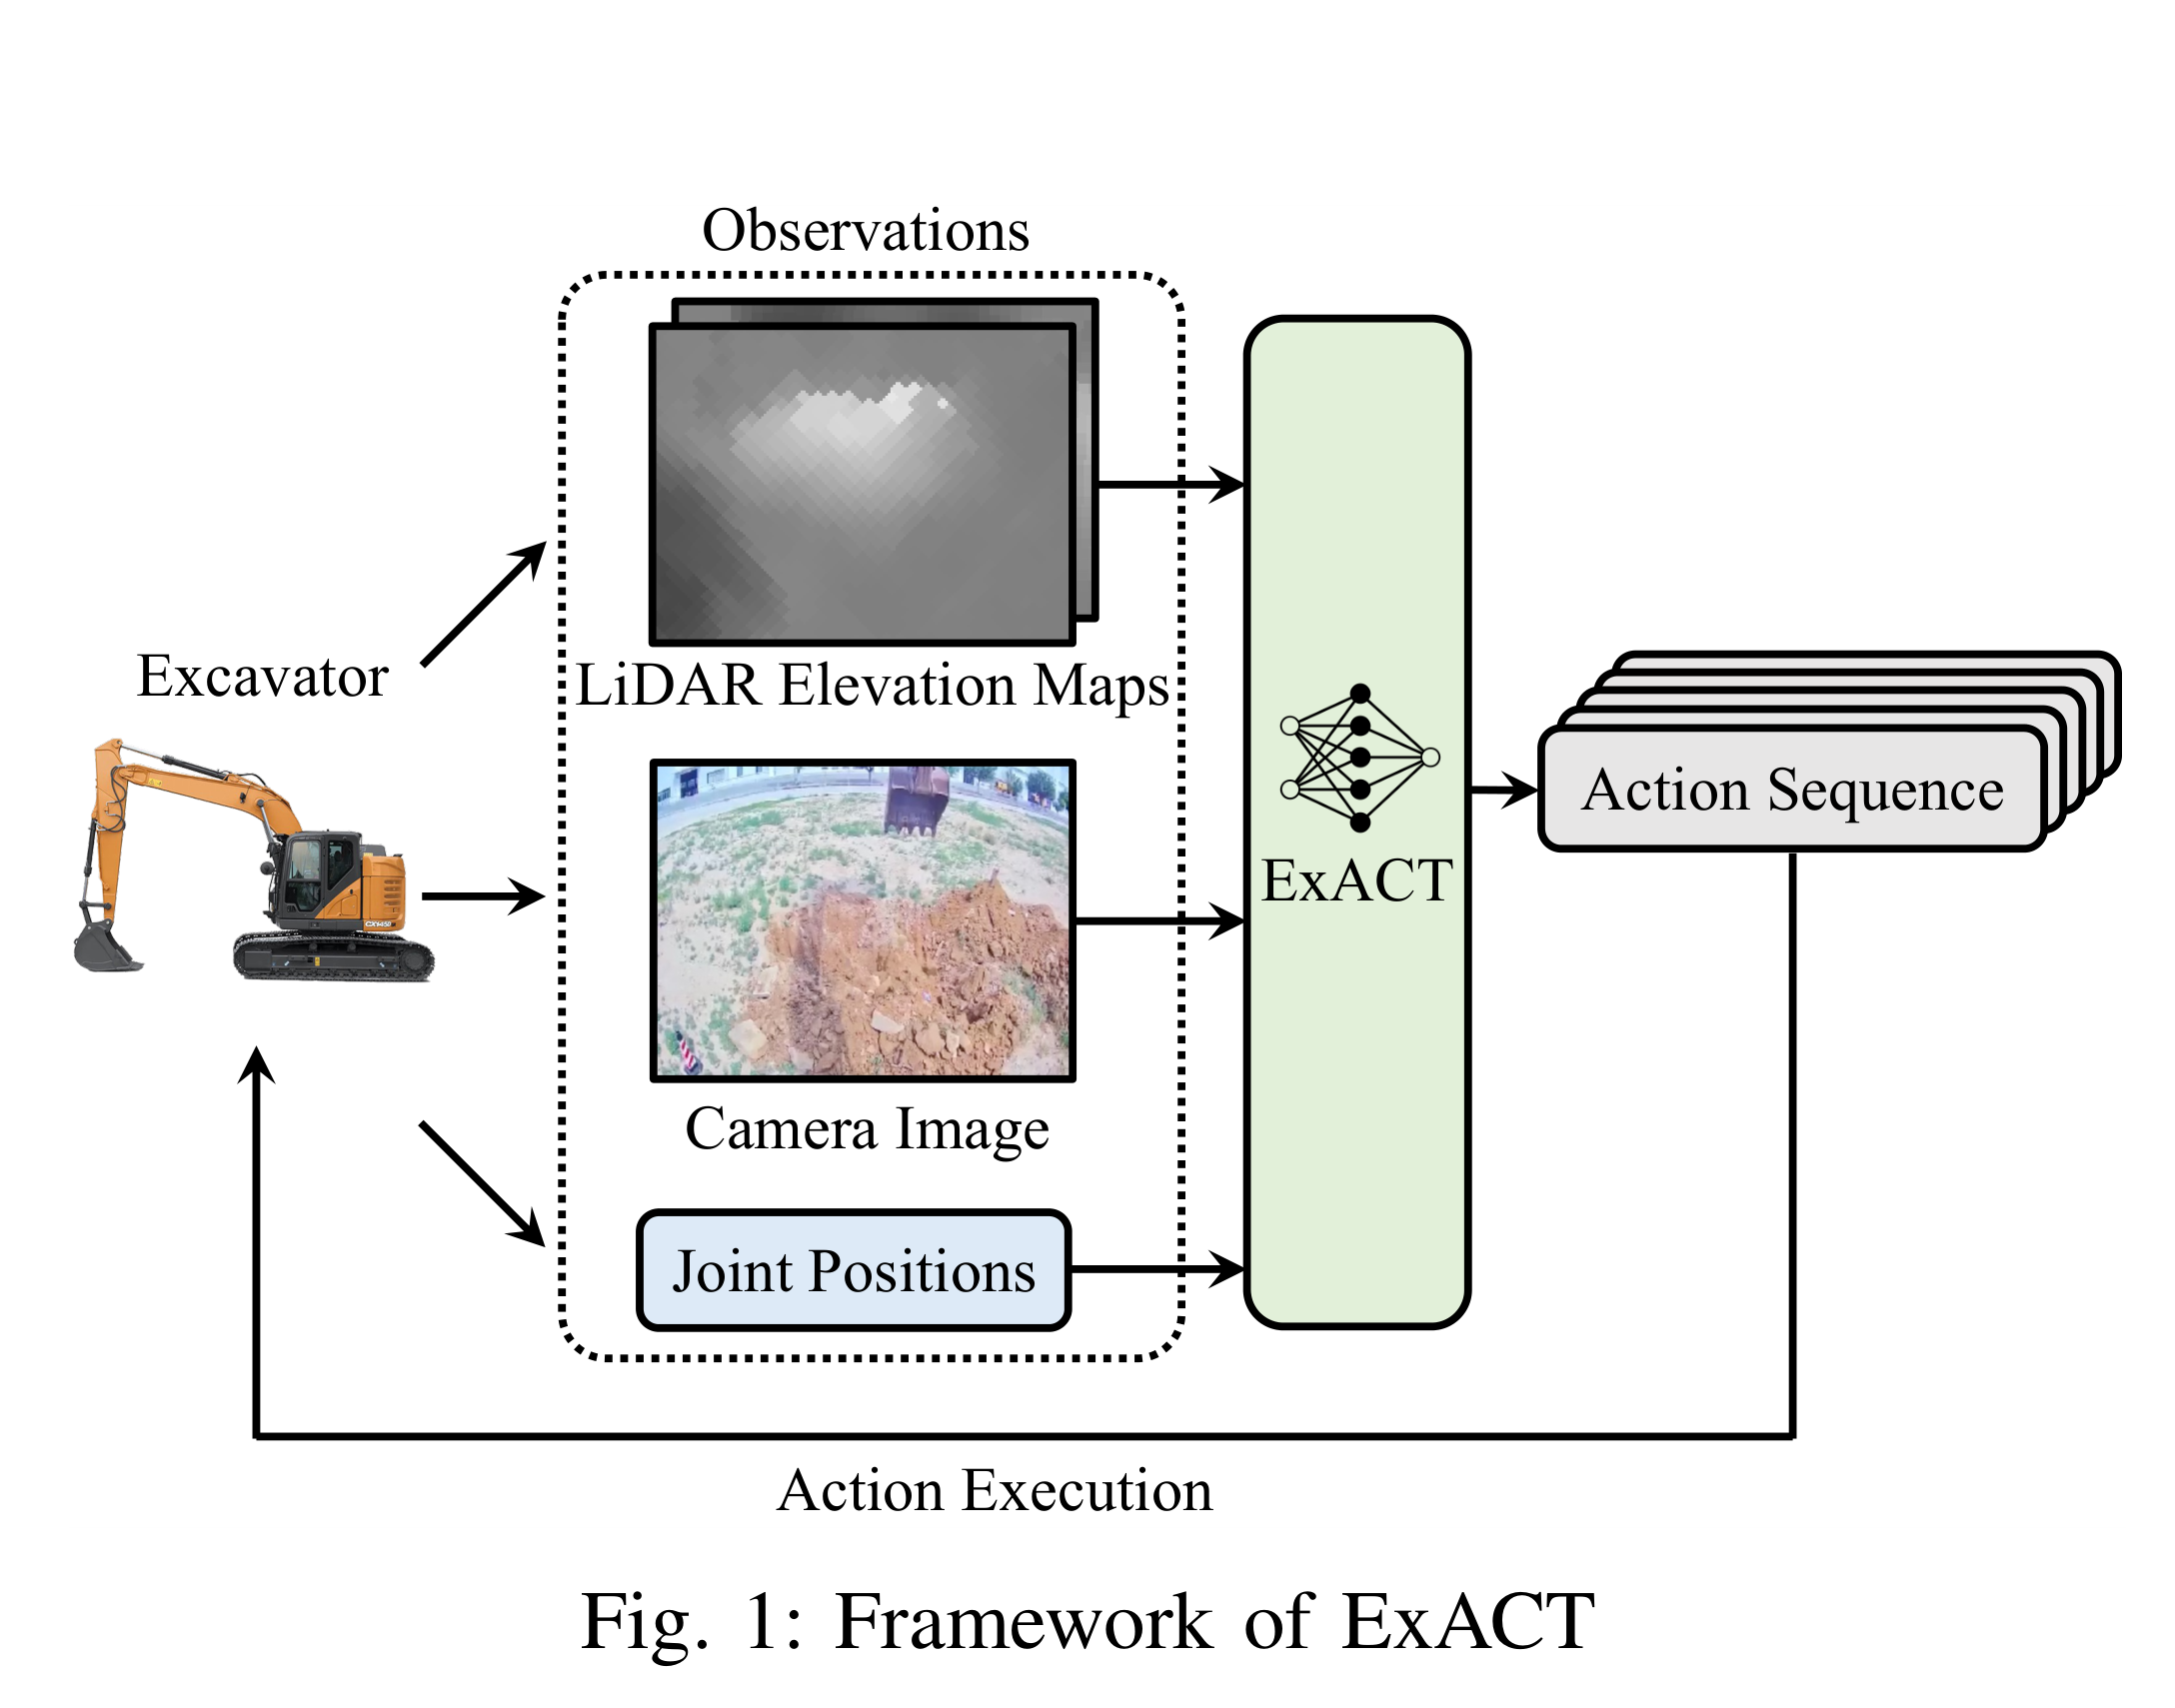
그림 설명: LiDAR 굴착/덤핑 elevation map, 전방 카메라, 4축 관절 위치를 ExACT에 입력해 미래 action chunk를 생성하고 굴착기에 실행하는 종단간 폐루프 구조. 원문 Figure 1, PDF p.1.
2) 요약
- 기존 perception-planning-control 모듈 체인 대신 LiDAR elevation map·카메라 영상·관절 위치에서 밸브/관절 명령 시퀀스를 직접 생성하는 종단간 자율 굴착기 정책을 제안한다.
- ACT의 conditional VAE와 Transformer, action chunking, temporal ensembling을 이용해 적은 수의 인간 원격조작 궤적으로 reach, dig-dump, dig-dump-return을 모방학습한다. 저자 주장 기준 최소 시연으로 만든 최초의 종단간 굴착기 모방학습 사례다.
- 실험 검증은 실차 실행이 아니라 실측 밸브-관절 속도 관계로 만든 선형 simulator와 기록된 센서 시퀀스에서 수행했다. reach와 joint-position 방식의 dig-dump-return은 학습했지만 valve 방식 dig-dump는 고주파 명령 성분을 충분히 학습하지 못했다.
- 논문은 21.5톤 실차에서 작업별 8-12개 episode를 수집해도 동작을 학습할 가능성을 보였으나, 실제 굴착기 폐루프 성능 시험은 향후 과제로 남겼다.
3) 방법
- CAN drive-by-wire 21.5톤 굴착기에 boom/stick/bucket 경사계, cabin swing encoder, 3D LiDAR, RGB 카메라, IMU, RTK-GPS와 GPU 컴퓨터를 장착한다. 원격조작기로 인간 시연을 기록한다.
- 관측은 swing/boom/stick/bucket의 4차원 관절 위치, 480×640×3 전방 카메라 영상, 굴착 작업일 때 각각 480×640×3인 digging/dumping zone elevation map 두 장으로 구성한다. 두 elevation map은 전체 LiDAR 고도 지도에서 작업 구역을 crop해 만든다.
- 10 Hz로 시연을 수집한다. 데이터는 reach 8 episode, dig-dump 12 episode, dig-dump-return 12 episode이며 각 작업에서 한 episode를 시험용으로 임의 선택하고 나머지를 학습에 사용한다. 논문 결과 절의 reach 학습 episode 표기는 분할 설명과 다소 불일치하므로 재현 시 split 목록을 별도 확인해야 한다.
- reach와 dig-dump는 4개 유압 valve state를 action으로, return 동작까지 포함한 dig-dump-return은 관절 위치를 action으로 정의한다. ACT의 conditional VAE·Transformer가 매 시점 action chunk를 예측하고, 겹치는 예측을 지수 가중 temporal ensemble로 합쳐 부드러운 실행 명령을 만든다.
- 보고된 학습값은 KL divergence weight 10, chunk size 30, learning rate 1×10⁻⁵, 30,000 step이다. encoder 세부·Transformer 층 수·영상 정규화와 augmentation은 원문 구현 세부 확인이 필요하다.
- 실차 투입 전 2,661개의 valve-state/joint-velocity 쌍으로 4축 선형식을 적합해 offline simulator를 만든다. 시험 episode의 첫 관절 상태만 실측값으로 두고 이후 관절은 이전 상태와 예측 action으로 전개하며, 카메라·LiDAR 입력은 기록된 시험 episode 데이터를 사용한다.
- reach는 valve 명령과 버킷 궤적, dig-dump는 고주파 valve 추종, dig-dump-return은 관절 위치 예측과 전체 작업 완료 여부로 평가한다. 실제 장비 투입 전에는 선형 모델 밖의 지연·dead zone·부하 변화에 대한 안전 검증이 추가로 필요하다.
4) 토의
- 논문이 직접 밝힌 한계/향후 연구: valve 기반 dig-dump에서 고주파 성분을 학습하지 못해 관절 움직임이 둔해지고 bucket edge가 필요 이상으로 이동할 수 있다. 이를 학습하는 controller와 더 많은 시연 데이터가 필요하며, 논문은 향후 ExACT를 실제 굴착기에서 시험하겠다고 밝혔다.
- 분석상 한계: 해석: simulator가 밸브-관절 속도의 축별 선형식이고 카메라·LiDAR도 기록 재생이므로 정책 행동이 토질 형상이나 작업 부하를 바꾸고 그 변화가 다음 관측으로 돌아오는 실제 상호작용을 재현하지 못한다. 따라서 시뮬레이터의 task completion은 실차 폐루프 성공률로 해석할 수 없다.
- 연구주제 제안: 지연·dead zone·부하 의존성을 포함한 불확실성 동역학 모델과 제어 장벽 기반 safety shield를 ExACT에 결합해 실차로 단계적 전이하고, 작업 성공률·버킷 궤적 오차·사람 개입률·안전제약 위반 횟수로 검증한다.
- 연구주제 제안: wavelet/주파수 가중 손실과 다중 시간해상도 action decoder로 고주파 valve 성분을 보존하는 frequency-aware action chunking을 개발하고, valve 스펙트럼 오차·관절 응답 지연·dig-dump 성공률로 기존 ACT와 비교한다.
[!note] 문서 범위 폴더의 기존 요약 자료인
2022-10-12 Baidu.pdf는 형식 참고용으로만 사용했으며, 논문 수 20편에는 포함하지 않았다.