Abstract
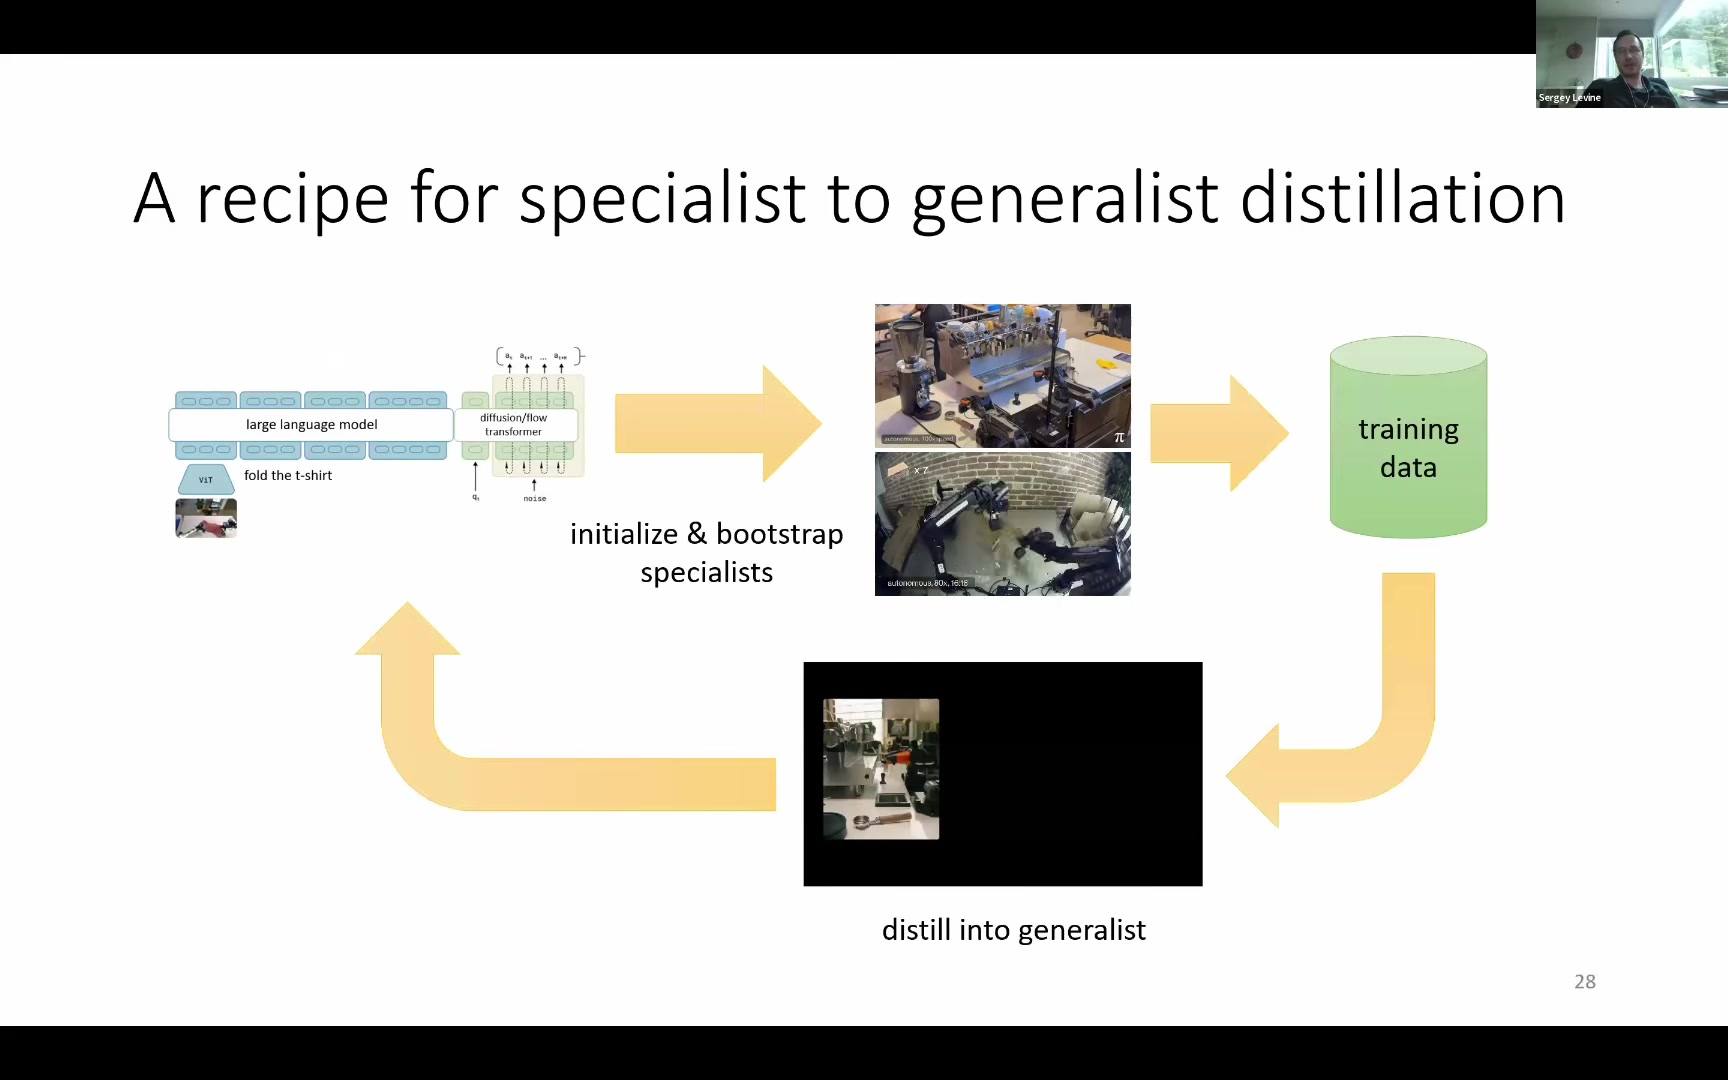
로봇 파운데이션 모델을 대규모 강화학습으로 처음부터 끝까지 개선하는 일은 아직 계산량·샘플 효율·실세계 안전성의 벽에 부딪힌다. Levine이 제안하는 현실적 대안은 역할 분담이다. 작은 스페셜리스트 정책은 특정 병목 과제를 실세계 RL로 빠르게 숙달하고, 거대한 제너럴리스트 VLA는 사전학습된 표현과 행동 사전확률로 그 탐색을 돕는다. 이후 스페셜리스트가 수집한 성공·실패·복구 경험을 다시 제너럴리스트에 증류한다. 핵심은 어느 한 모델의 승리가 아니라 제너럴리스트와 스페셜리스트 사이에 데이터가 계속 순환하는 학습 시스템이다.
Executive Summary
먼저 읽어야 할 다섯 가지 발견
지도학습과 RL은 대체재가 아니다. 전자는 일반화와 언어 이해를, 후자는 성공률·속도·복구 능력을 담당한다.
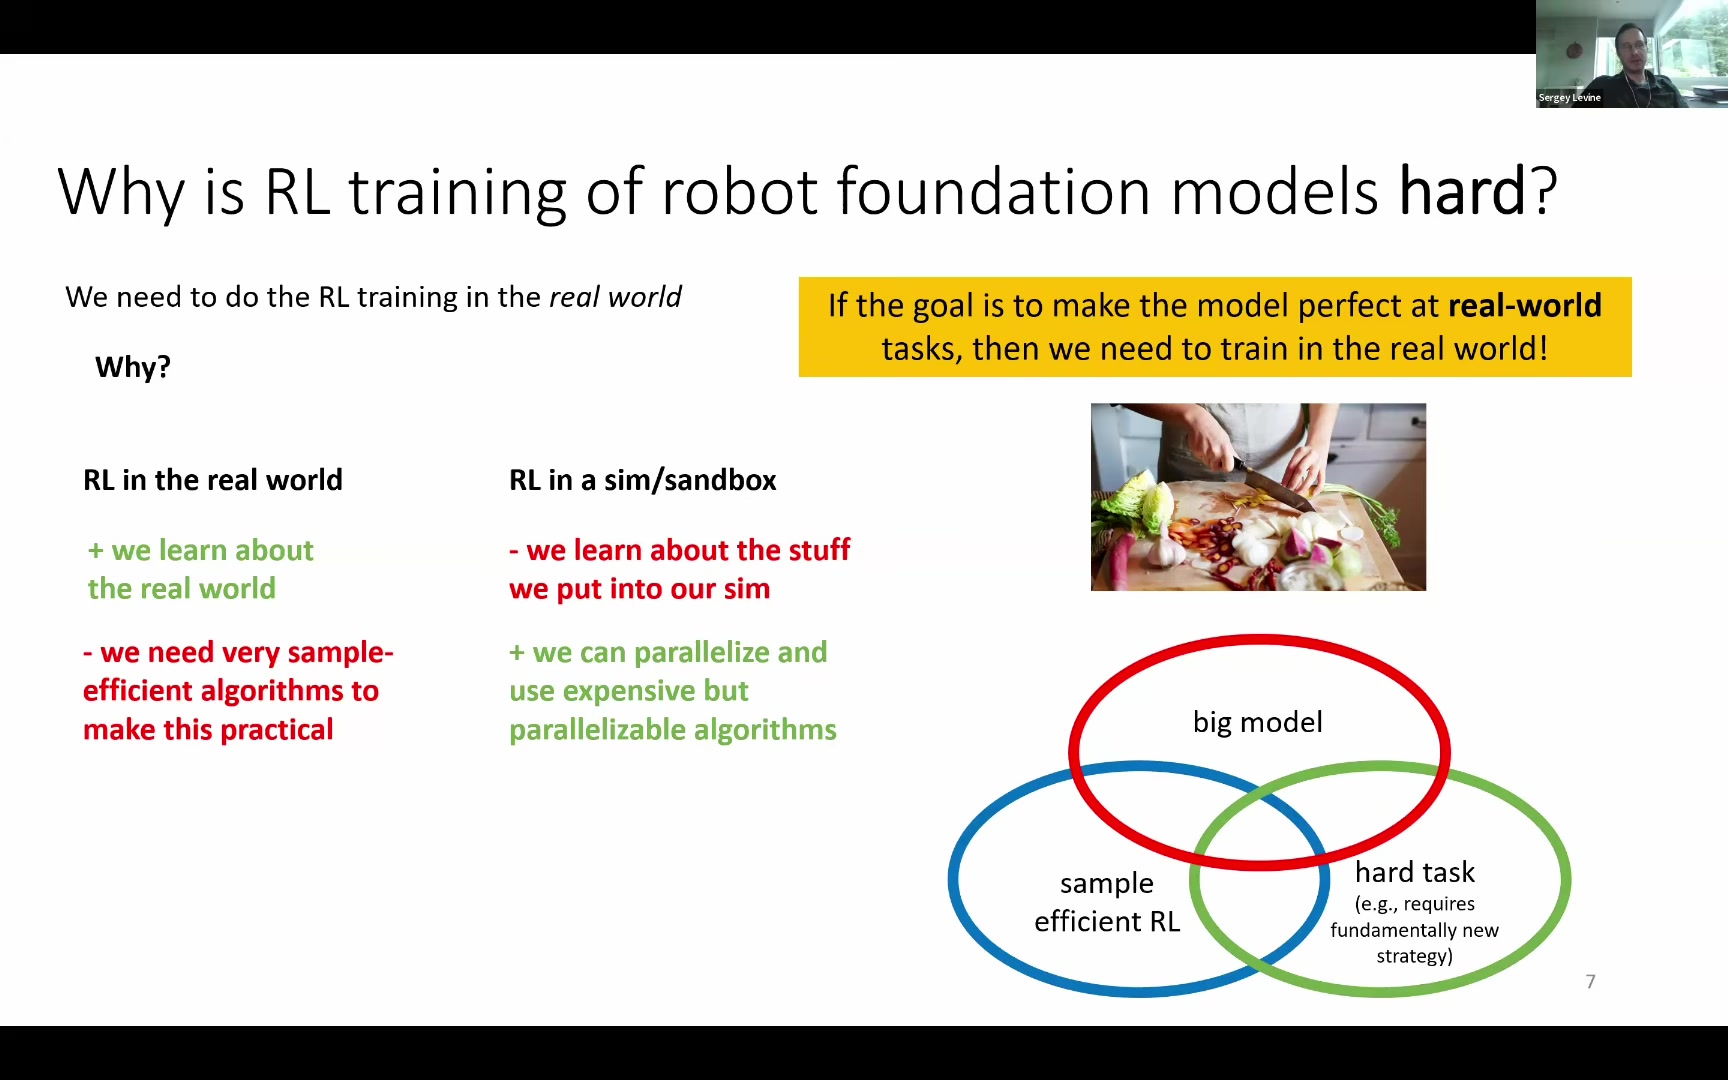
큰 모델, 샘플 효율적 RL, 근본적으로 새로운 전략이 필요한 어려운 과제. 셋 중 둘은 가능하지만 셋의 결합은 여전히 어렵다.
RLPD·SERL 계열은 특정 환경에서 과제당 1~2시간의 실세계 데이터로 100% 성공률과 절반 이하의 사이클 타임을 보였다.
RL 토큰과 기본 정책의 액션 청크를 작은 actor·critic에 전달하면 무작위 흔들기보다 훨씬 의미 있는 탐색이 가능하다.
CFGRL은 좋은 데이터와 나쁜 데이터를 모두 학습한 뒤, 추론 시 guidance로 좋은 행동의 모드를 증폭한다.
제너럴리스트 → 스페셜리스트 RL → 자율 데이터 → 증류 → 더 나은 제너럴리스트라는 플라이휠이 핵심 자산이 된다.
Part I · The Gap
“알고 있다”와 “해낼 수 있다” 사이
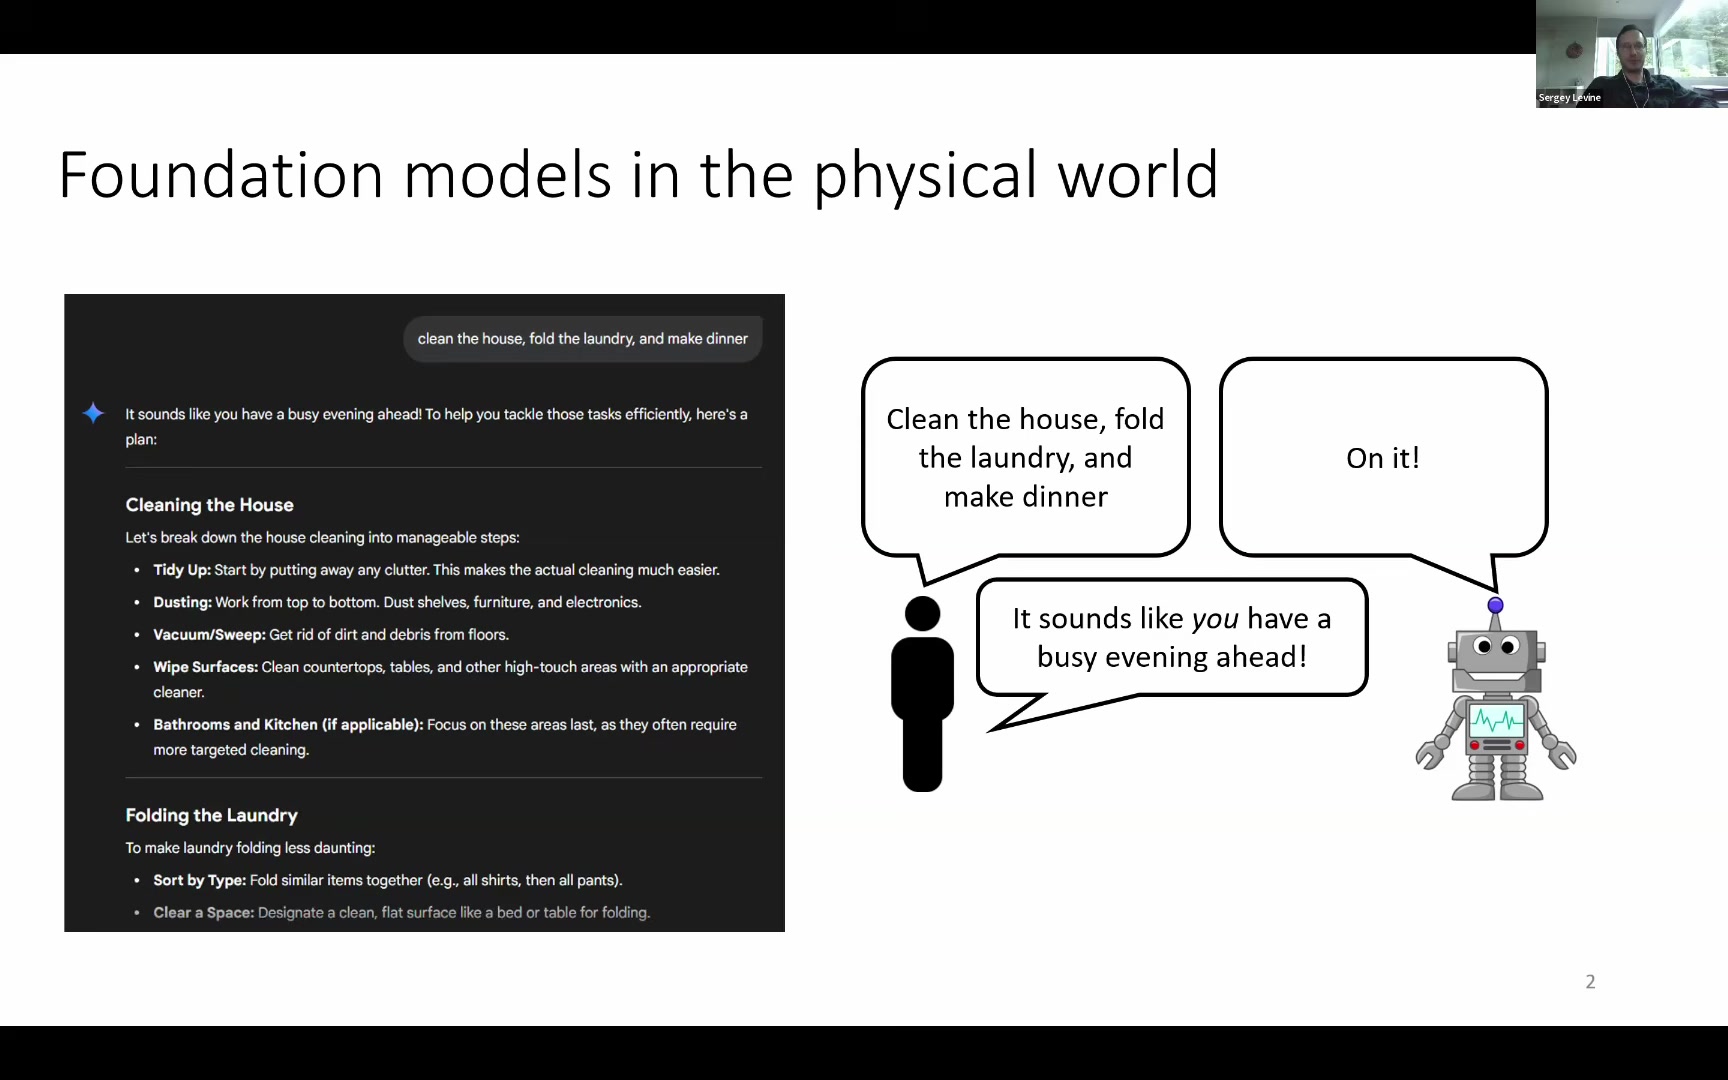
대규모 언어 모델에게 “집을 청소하고, 빨래를 개고, 저녁을 차려 달라”고 부탁하면 훌륭한 실행 계획을 받을 수 있다. 그러나 계획이 물리 세계에서 행동으로 이어지지는 않는다. 로봇 파운데이션 모델이 해결해야 하는 문제는 단순한 pick-and-place가 아니다. 처음 보는 물체와 환경에서도 긴 지시를 단계적으로 해석하고, 실수에서 복구하며, 인간이 납득할 속도로 끝내야 한다.
LLM의 학습 레시피를 로봇으로 옮기기
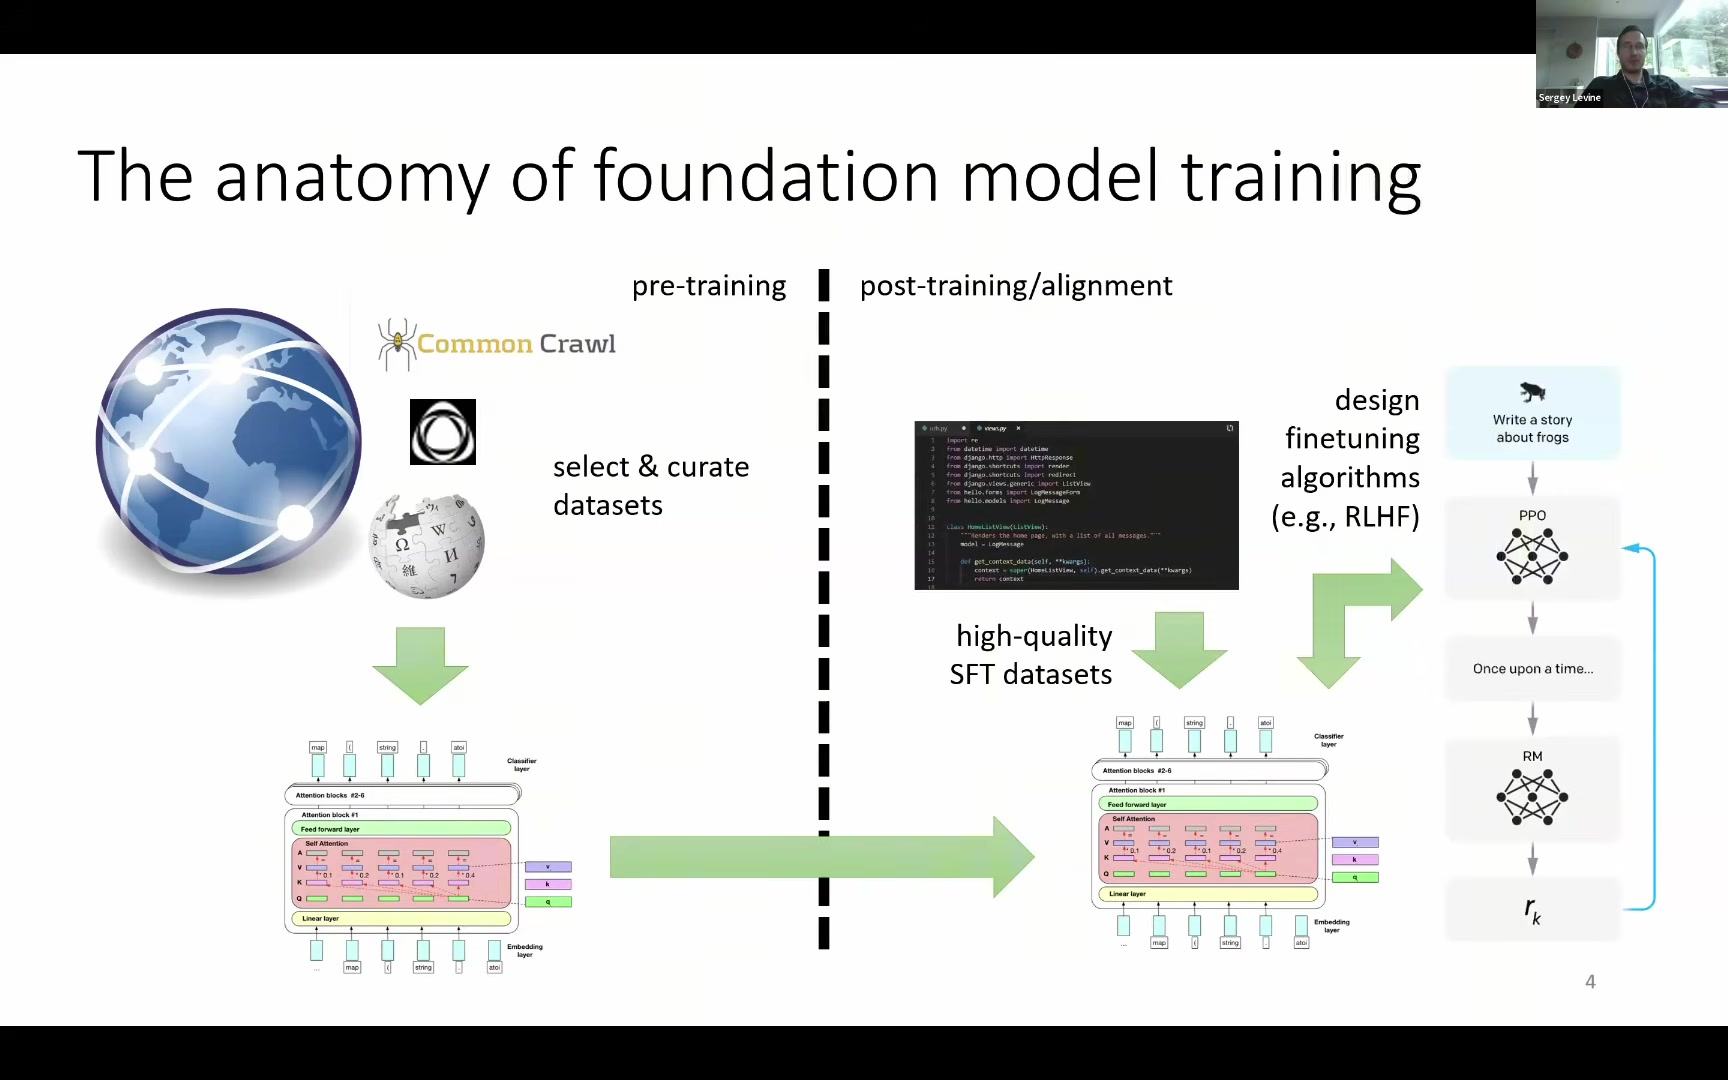
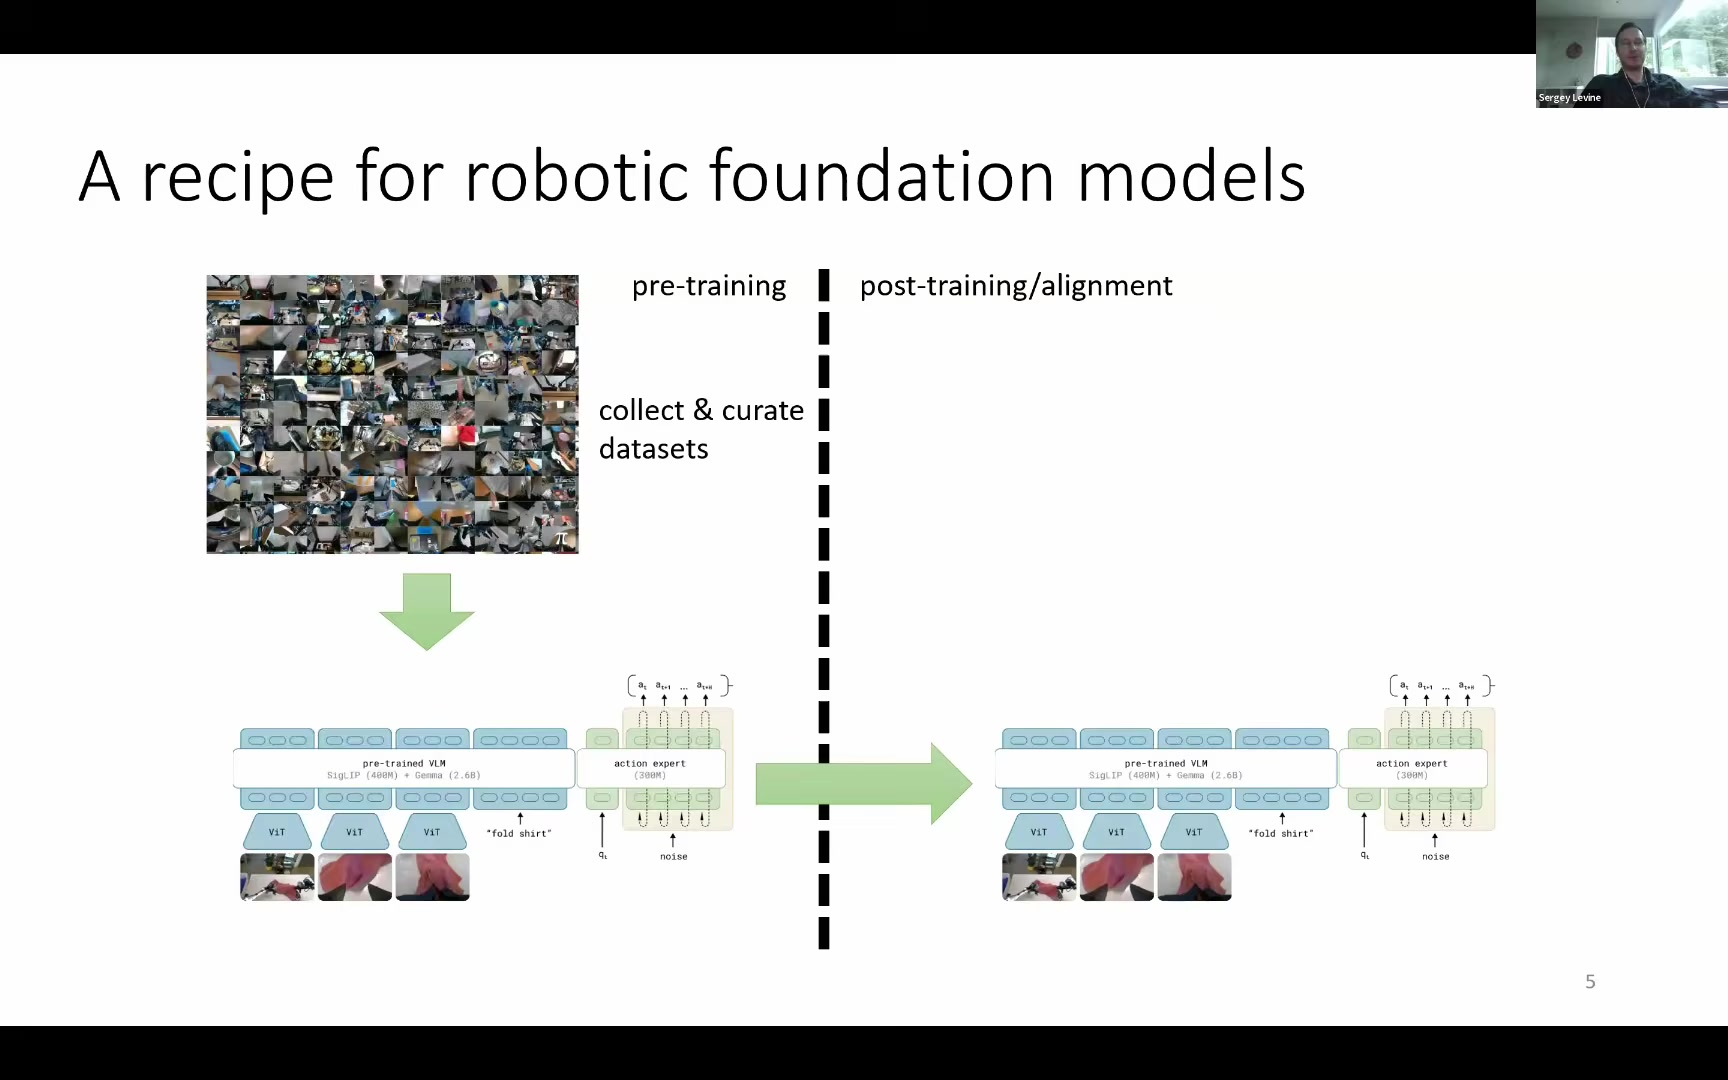
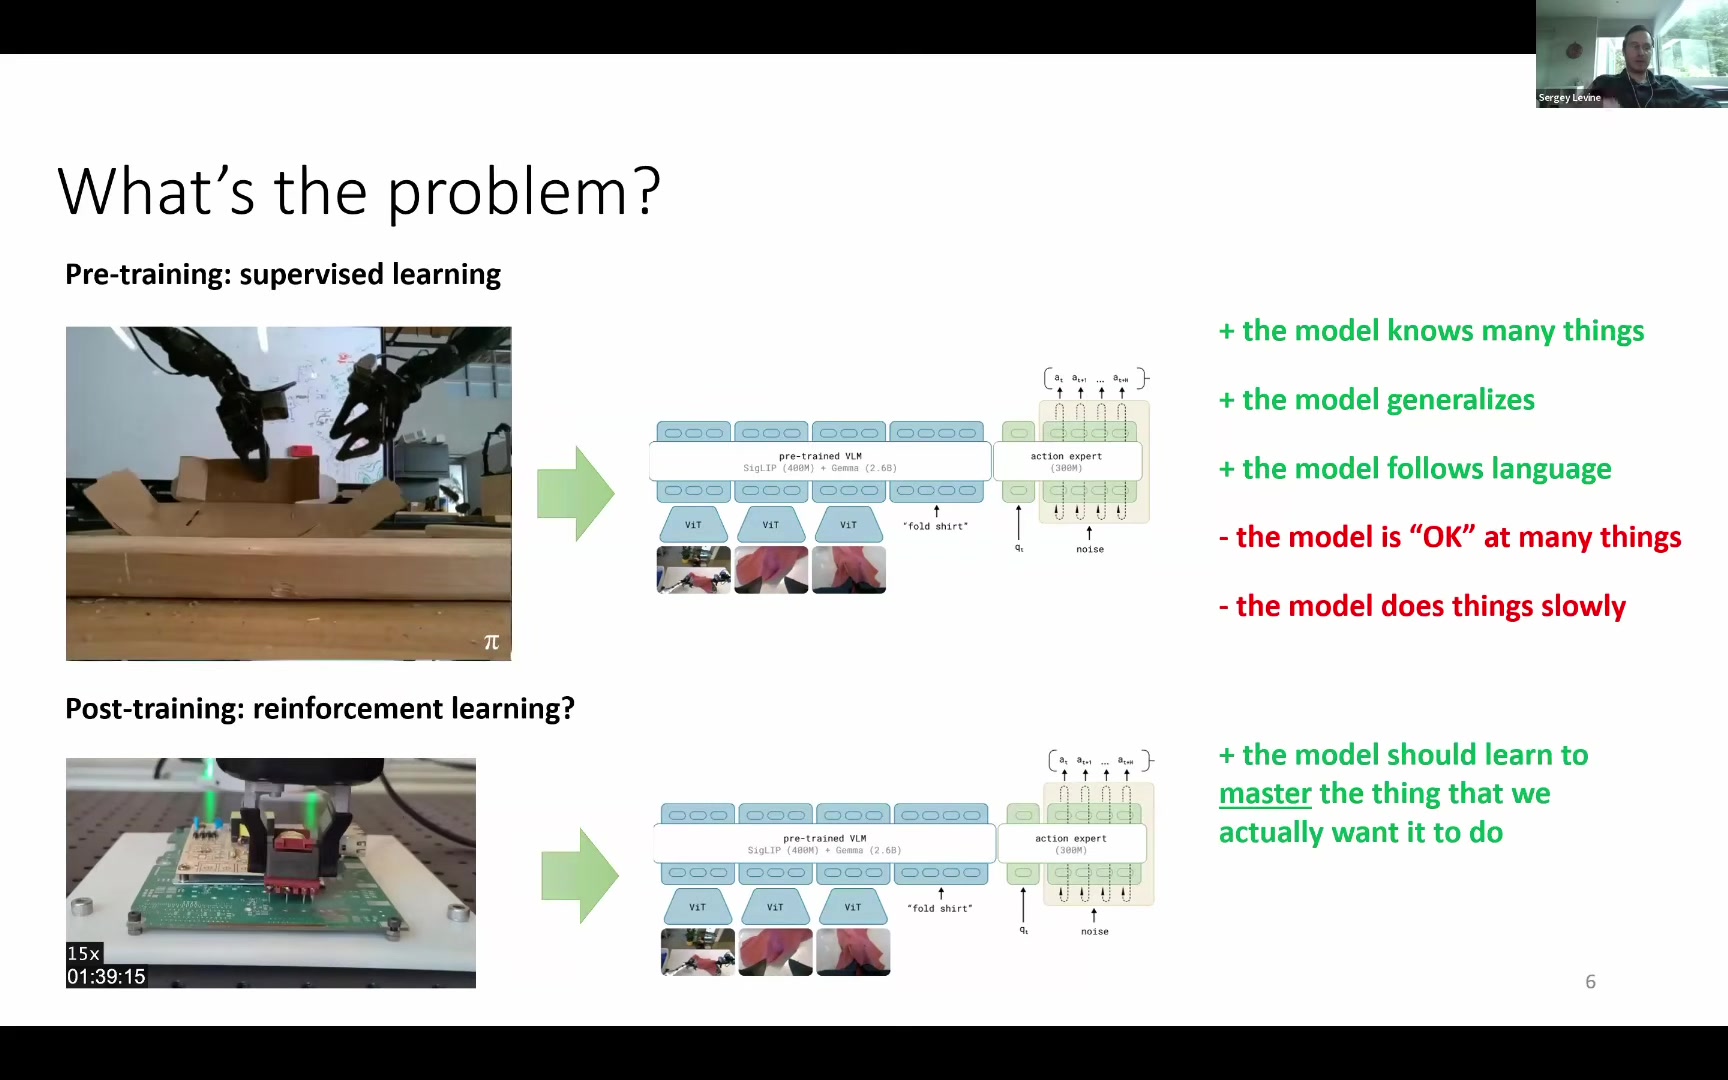
일반 파운데이션 모델의 학습은 크게 두 단계다. 대규모 데이터로 사실과 패턴을 흡수하는 pre-training, 그리고 그 지식을 실제 과제 해결에 배치하는 post-training이다. 로봇에서도 구조는 비슷하다. 다양한 로봇 데모로 VLA를 사전학습한 뒤, SFT와 자동화된 RL로 특정 과제의 성공률과 속도를 끌어올린다. 다만 구현 조건은 LLM과 현저히 다르다. 로봇의 한 번의 토큰 생성은 실제 모터 움직임이고, 실패는 시간과 장비 비용을 만든다.
RL post-training은 하나의 일을 완전히 익히게 한다.” 발표의 논지를 요약한 편집 문장
지도학습의 천장: 그럭저럭 잘하지만 느리다
사전학습 정책은 많은 과제에 “OK” 수준으로 대응하지만, 한 과제를 안정적으로 마스터하지는 못한다. 속도가 느린 이유도 단순한 관절 속도 제한이 아니다. 작은 실수와 재시도, 복구 행동이 누적돼 전체 사이클 타임이 길어진다. 따라서 RL의 목표는 더 과격하게 움직이는 것이 아니라 불필요한 실수 없이 과제를 끝내는 정책을 찾는 데 있다.
왜 시뮬레이션만으로는 충분하지 않은가
Levine의 주장은 단호하다. 목표가 실세계 과제를 완벽히 수행하는 것이라면, 최종 학습도 실세계에서 이루어져야 한다. 시뮬레이터는 대규모 병렬화와 복잡한 알고리즘을 허용하지만, 모델은 결국 시뮬레이터에 표현된 물리만 배운다. 접촉, 마찰, 휘어지는 재료, 카메라 노이즈처럼 마지막 몇 퍼센트의 성공률을 결정하는 요소는 실제 환경에서 드러난다.
| 학습 환경 | 강점 | 구조적 한계 |
|---|---|---|
| 실세계 RL | 배포 환경의 물리와 오차를 직접 학습 | 샘플 비용이 높아 극도로 효율적인 알고리즘이 필요 |
| 시뮬레이션·샌드박스 | 병렬화와 안전한 대규모 탐색 가능 | 시뮬레이터에 포함된 현상 밖으로 일반화하기 어려움 |
Part II · Specialist First
작은 정책으로 어려운 한 가지를 끝까지 익힌다
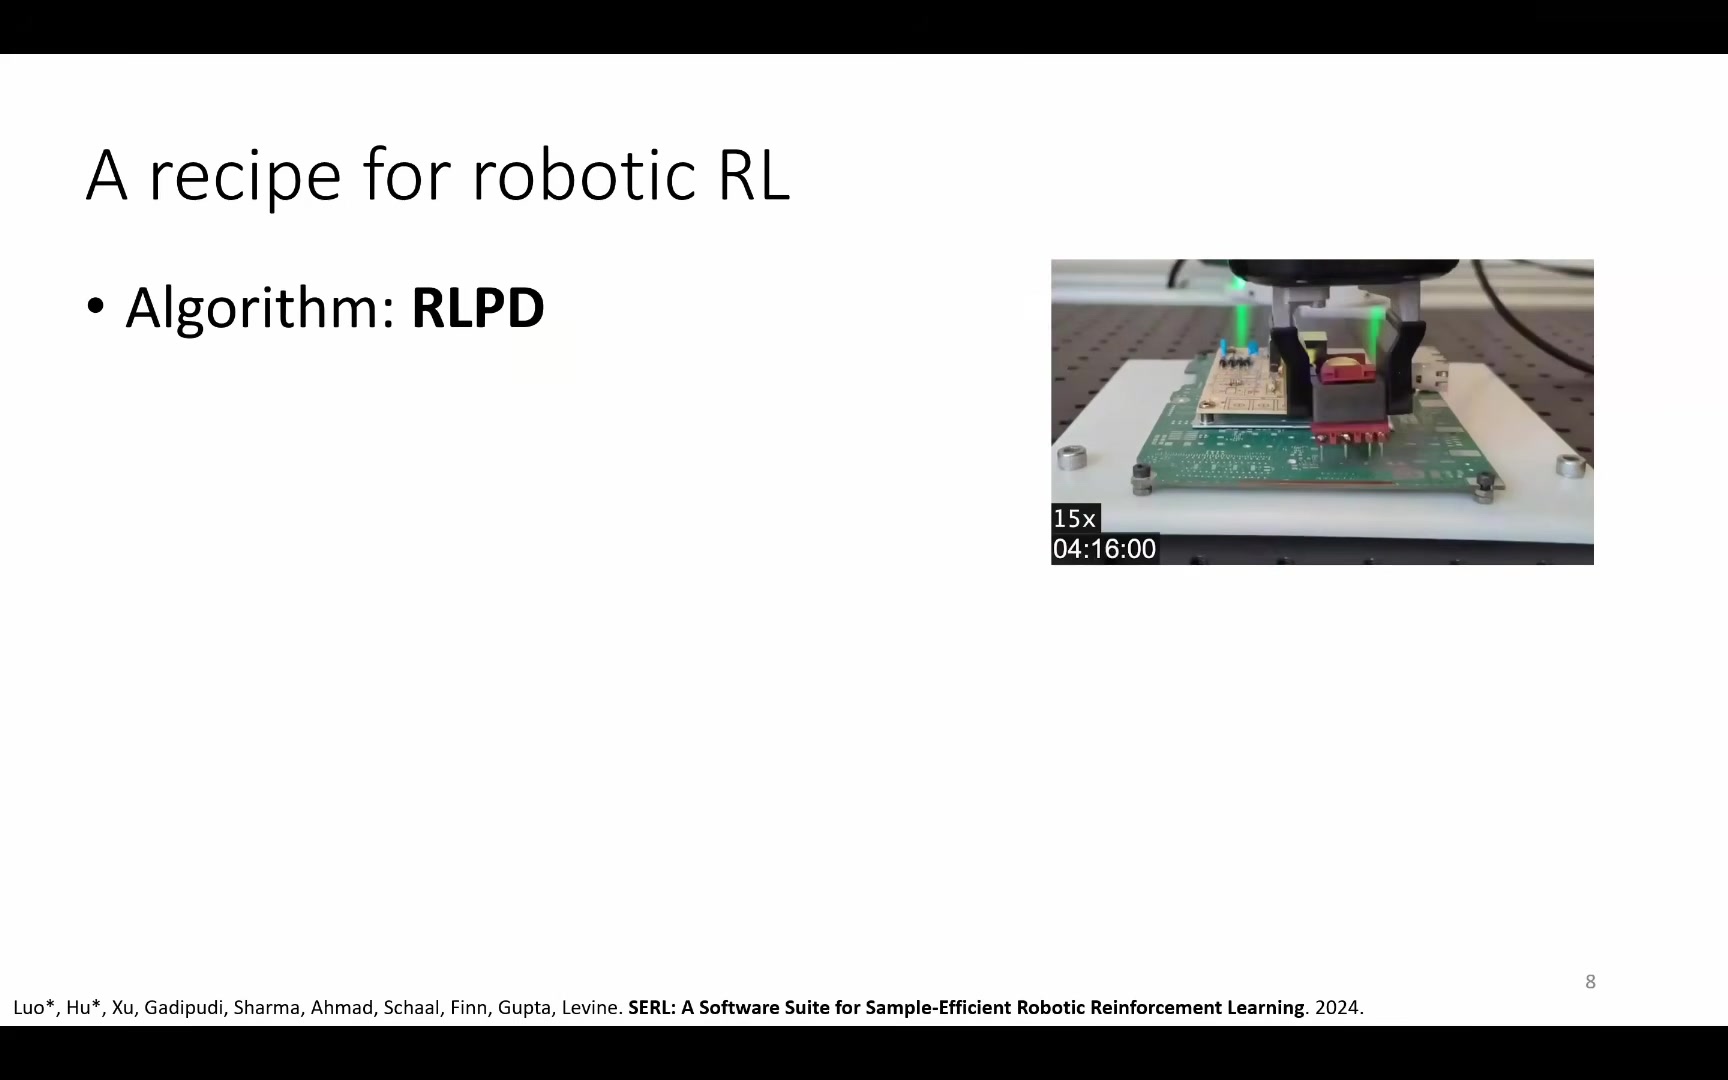
엔드투엔드 RL이 어렵다고 해서 RL 자체가 작동하지 않는 것은 아니다. 파운데이션 모델을 사용하지 않는 스페셜리스트 정책은 이미 상당히 높은 수준의 실세계 성능을 낸다. 대표적인 기준선은 soft actor-critic 계열의 RLPD다. 사람 데모를 리플레이 버퍼에 섞고, wrist 카메라와 사전학습 비전 인코더를 사용하며, 과제 완료 여부는 이진 이미지 분류기로 판정한다.
스페셜리스트 학습 구성
- 관측: wrist 카메라 이미지와 사전학습 비전 표현
- 보상: 과제 완료 이미지를 판별하는 이진 분류기
- 데이터: 초기 데모와 자율 롤아웃을 동일한 리플레이 버퍼에서 재사용
- 개입: 사람이 교정한 행동도 off-policy 데이터로 즉시 편입
SERL이 보여준 것: 몇 시간 안에 산업 작업을 숙달한다
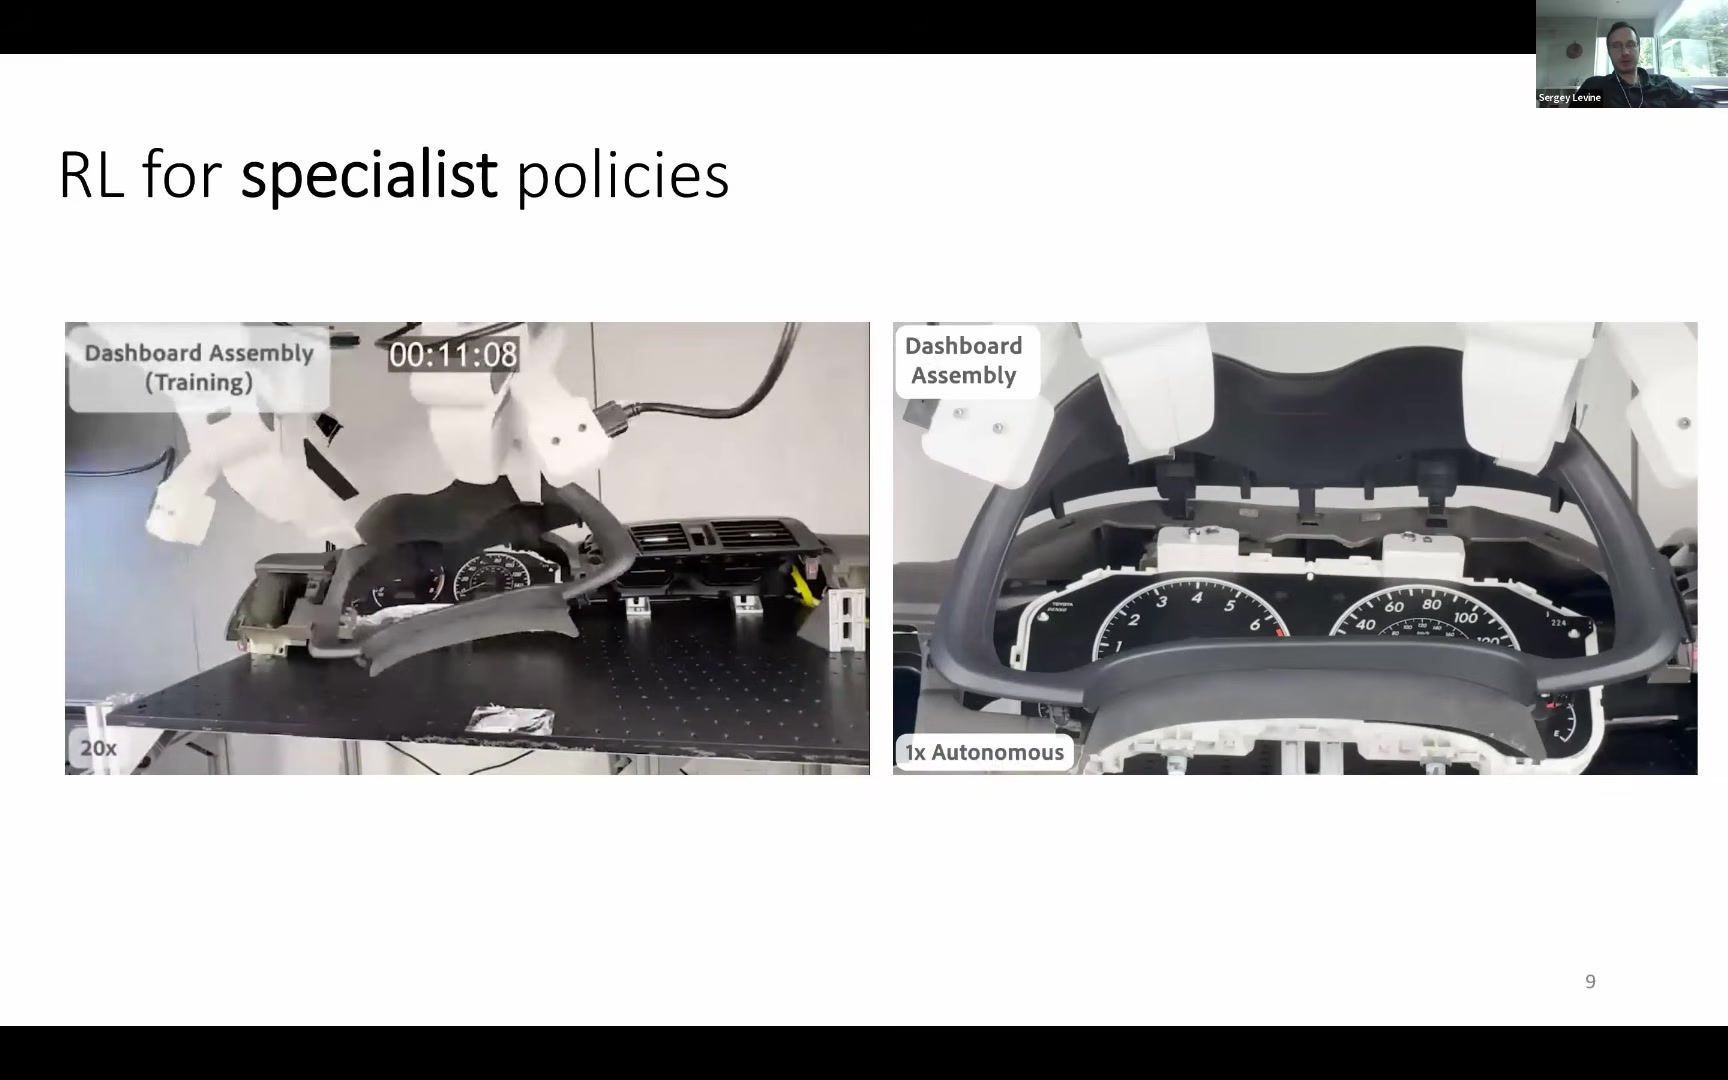
오픈소스 프레임워크 SERL은 자동차 대시보드 커넥터 조립처럼 접촉 정밀도가 높은 작업을 반복 학습한다. 초기에는 정렬과 삽입에 실패하지만, 몇 시간의 실세계 상호작용 뒤에는 일관된 자율 실행이 가능해진다.
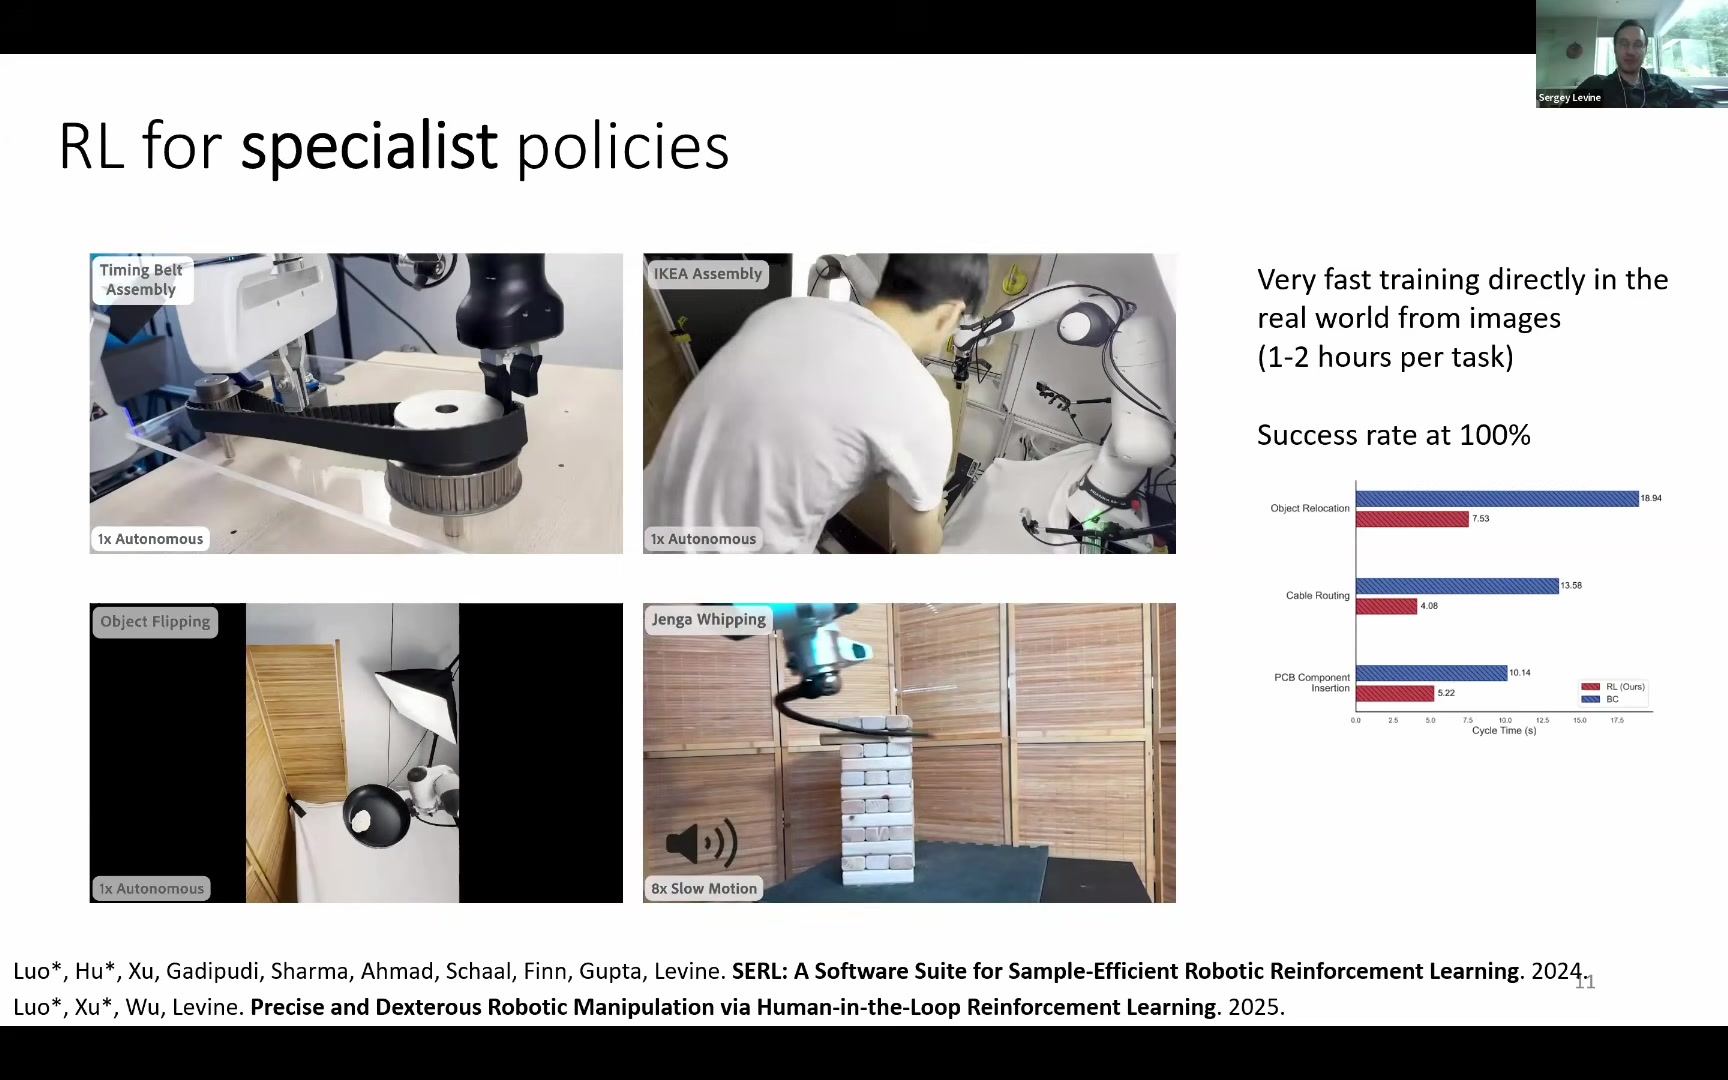
| 과제 | RL 정책 | BC 기준선 | 해석 |
|---|---|---|---|
| 물체 재배치 | 7.53초 | 18.94초 | 재시도와 불필요한 이동 감소 |
| 케이블 라우팅 | 4.08초 | 13.58초 | 접촉 구간에서 더 직접적인 궤적 |
| PCB 부품 삽입 | 5.22초 | 10.14초 | 삽입 정렬과 복구 행동 개선 |
한계를 뒤집는 방법: 스페셜리스트의 경험을 증류한다
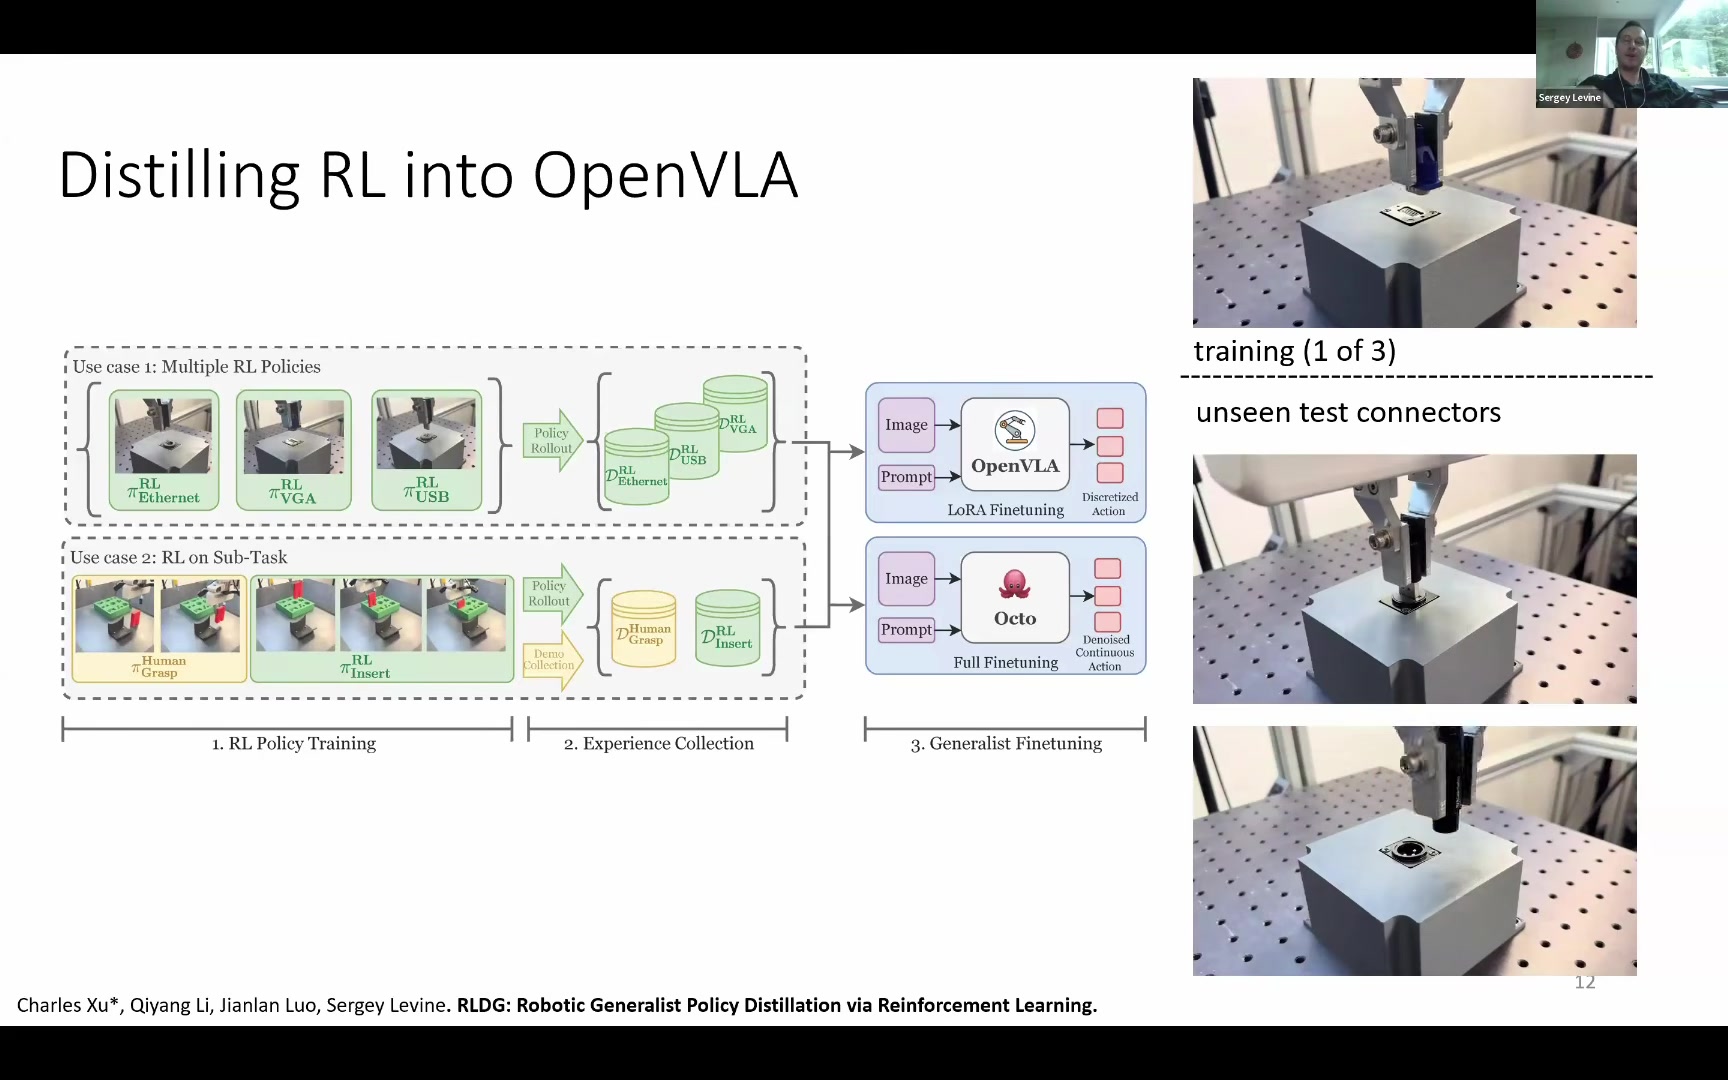
스페셜리스트 정책은 높은 성공률을 얻지만 학습 환경 밖으로 나가지 못한다. RLDG는 이 한계를 데이터 문제로 바꾼다. Ethernet·VGA·USB 커넥터마다 RL 스페셜리스트를 학습하고, 이들의 롤아웃을 OpenVLA와 Octo에 증류한다. 개별 정책은 한 커넥터만 알지만, 통합 모델은 처음 보는 커넥터에도 일반화한다.
중요한 데이터 발견
같은 수의 성공 사례를 비교했을 때, RL 정책이 생성한 데이터가 사람의 성공 데모보다 파운데이션 모델 학습에 더 효과적이었다. RL 롤아웃은 단순히 정답 궤적을 모방하지 않고, 여러 상태에서 일관된 행동을 선택하는 마르코프 정책의 분포를 더 충실히 반영하기 때문이다.
Part III · Reverse the Arrow
이번에는 제너럴리스트가 스페셜리스트를 돕는다
증류만으로는 화살표가 한 방향이다. 새로운 과제를 만날 때마다 스페셜리스트 RL은 다시 무지한 상태에서 탐색을 시작해야 한다. RLT는 이 화살표를 되돌린다. 거대한 VLA의 내부 표현과 제안 행동을 작은 RL 모델에 전달해, 파운데이션 모델이 이미 아는 것을 탐색의 출발점으로 삼는다.
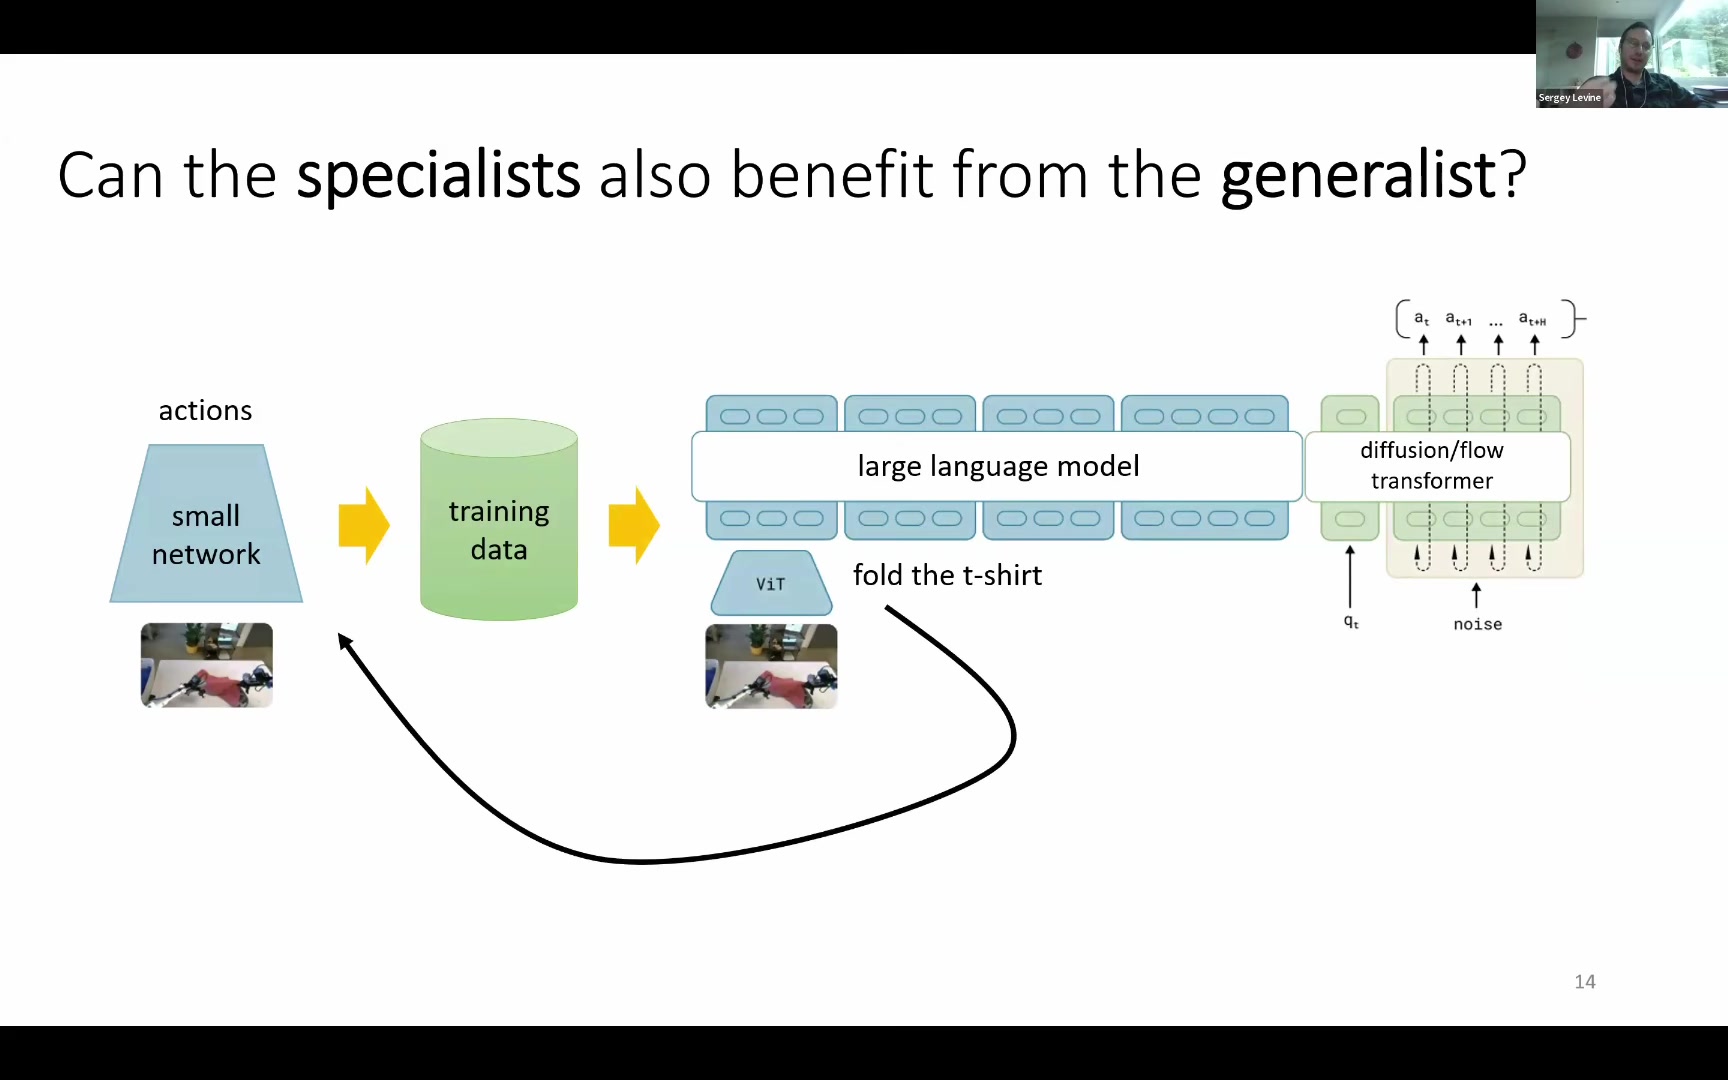
RL 토큰: 거대한 모델의 판단을 작은 정책에 압축하기
Physical Intelligence의 RLT는 π*0.6 VLA의 이미지 표현을 cross-attention 인코더·디코더로 압축해 1×2048 크기의 RL 토큰을 만든다. 작은 actor와 critic은 이 토큰뿐 아니라 VLA가 제안한 액션 청크도 함께 입력받는다. 즉 RL은 “기본 모델이 현재 상황을 어떻게 보고, 무엇을 하려 하는지”를 알고 시작한다.
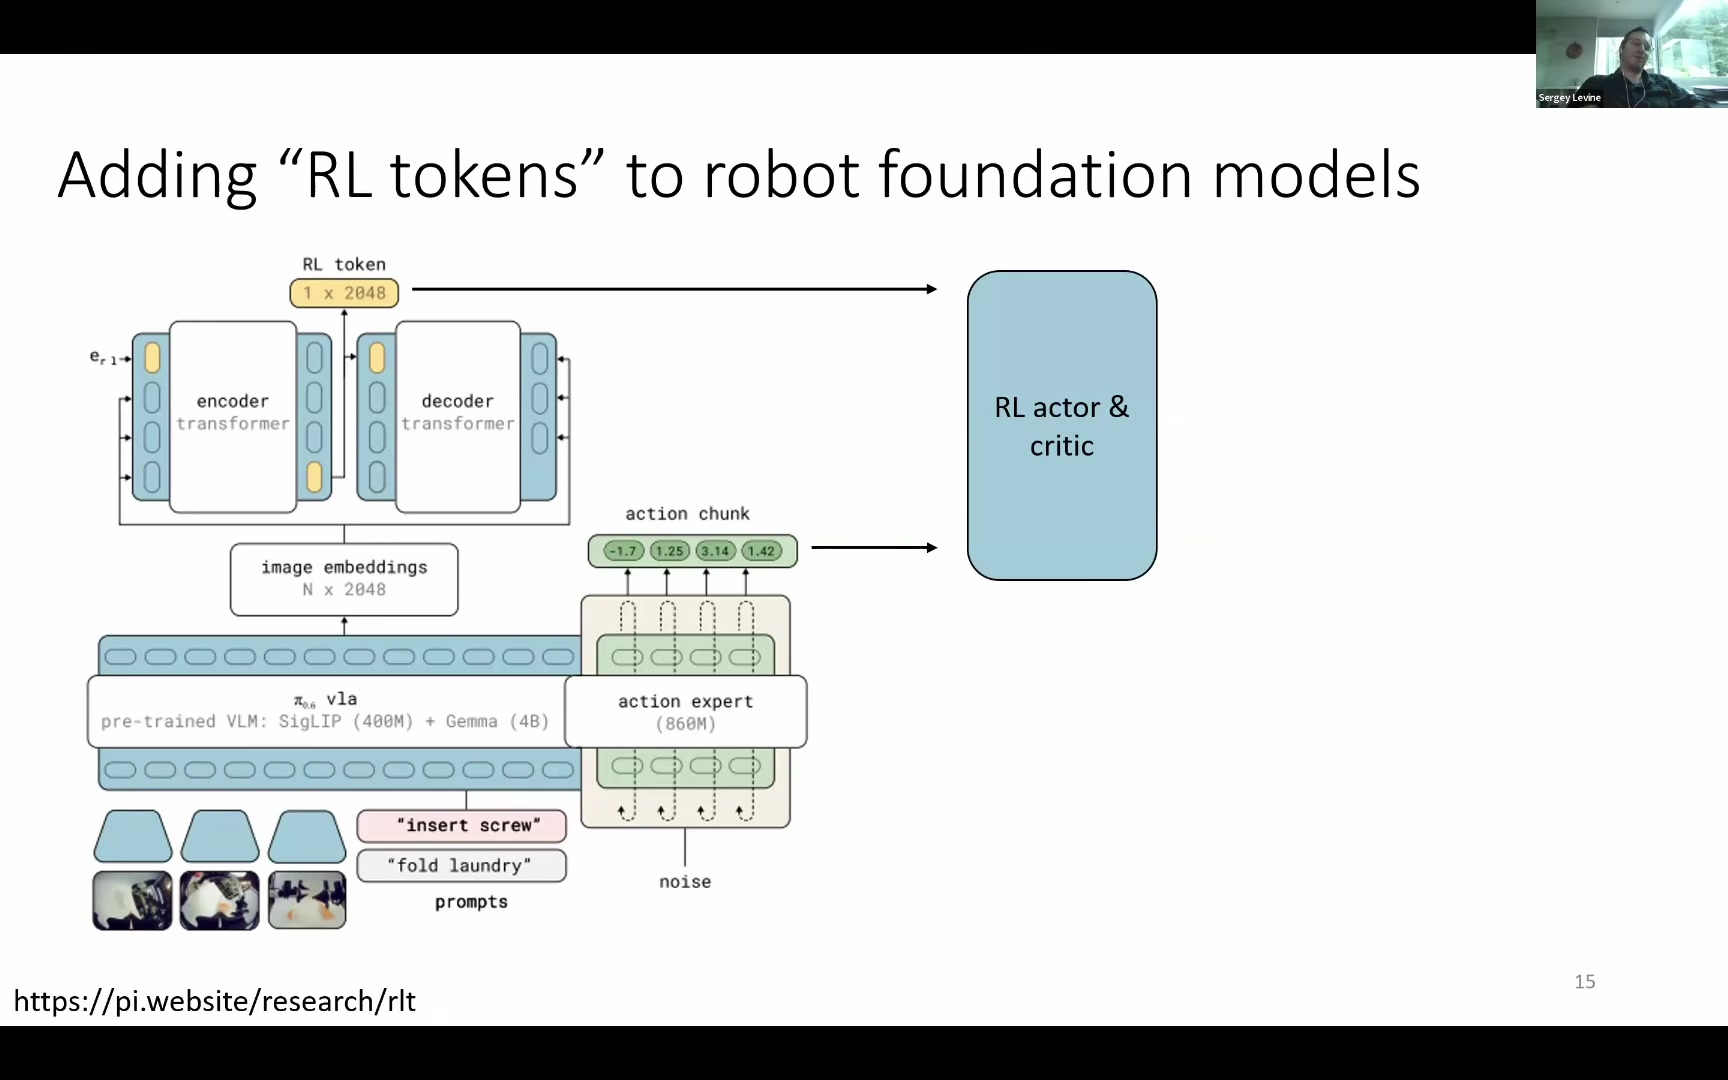
신입에게 무작정 시도하라고 하는 대신, 베테랑이 “지금 상황은 이렇고, 나라면 이렇게 하겠다”고 계속 알려준다. 신입은 모를 때 베테랑을 따르고, 더 좋은 방법을 실제로 발견했을 때만 그 행동에서 벗어난다.
긴 과제를 모두 학습하지 말고, 가장 어려운 한 단계만
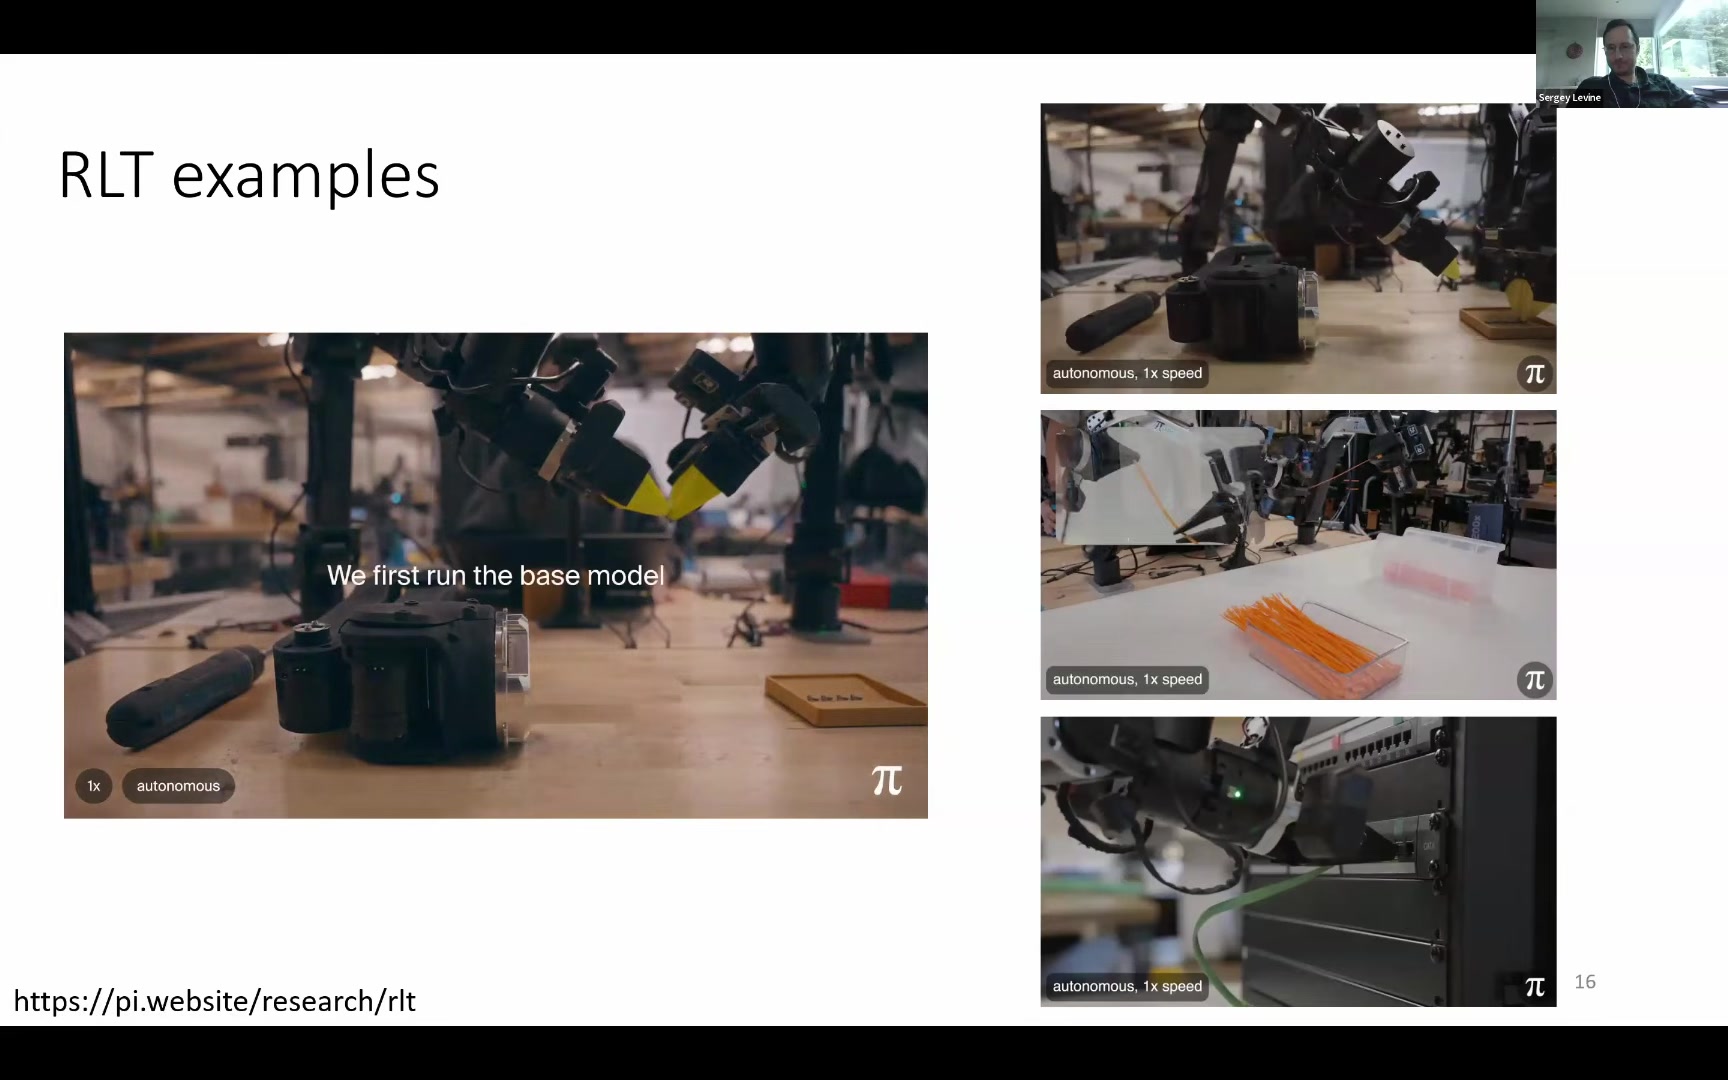
RLT는 긴 작업 전체를 RL로 다시 배우지 않는다. 상위 정책이 과제를 단계로 분할하고, 나사 조이기·zip tie 삽입·Ethernet 연결처럼 성공률을 결정하는 정밀 병목에만 RL을 적용한다. 이 설계는 RL이 필요한 상태 분포를 줄이고, 환경 리셋과 보상 판정도 단순하게 만든다.
처리량은 늘고, 성공 궤적은 짧아졌다
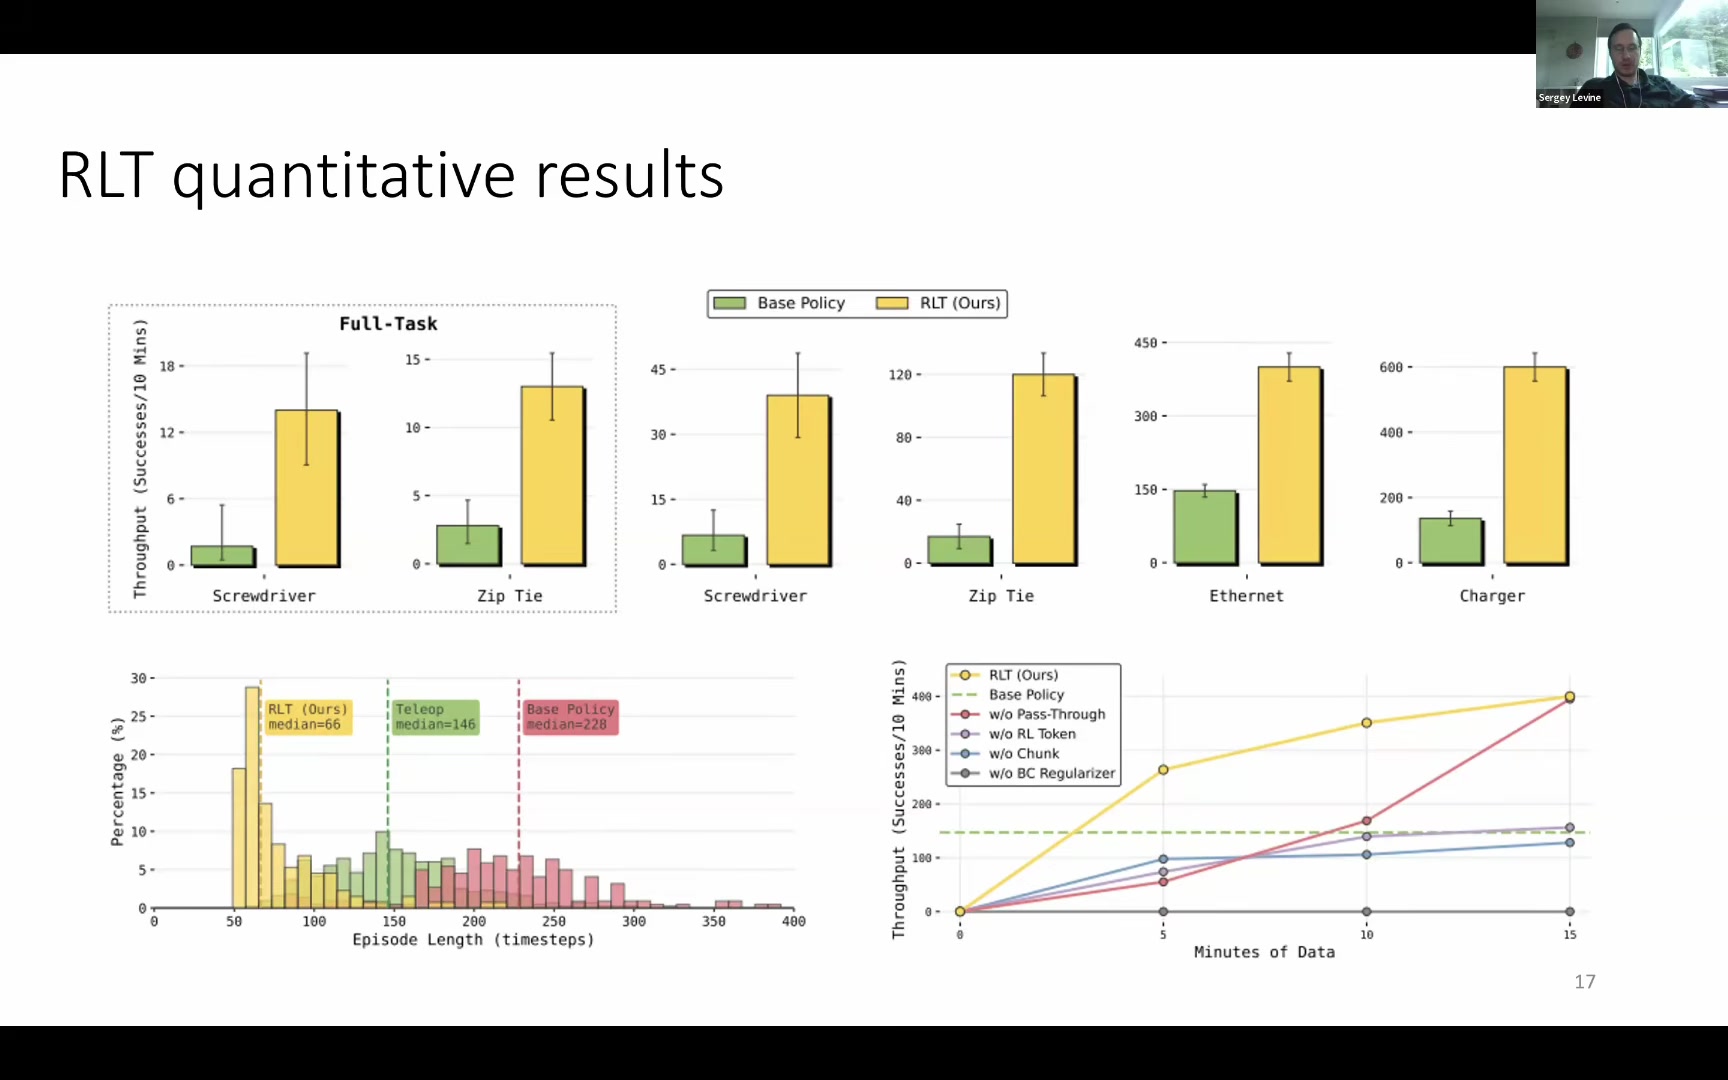
| 제거한 구성 | 관찰된 결과 | 의미 |
|---|---|---|
| BC regularizer | 기본 정책 수준에서 개선 실패 | 학습 초기에 행동 prior를 유지해야 함 |
| Action chunking | 개선 실패 | 시간적으로 일관된 동작 단위가 필수 |
| RL token | 거의 작동하지 않음 | VLA의 내부 표현이 핵심 정보원 |
| Action pass-through | 같은 성능까지 훨씬 느리게 도달 | 기본 정책의 제안 행동이 탐색을 가속 |
Part IV · Learn from Everything
성공만 골라 쓰지 않고, 실패까지 학습하는 법
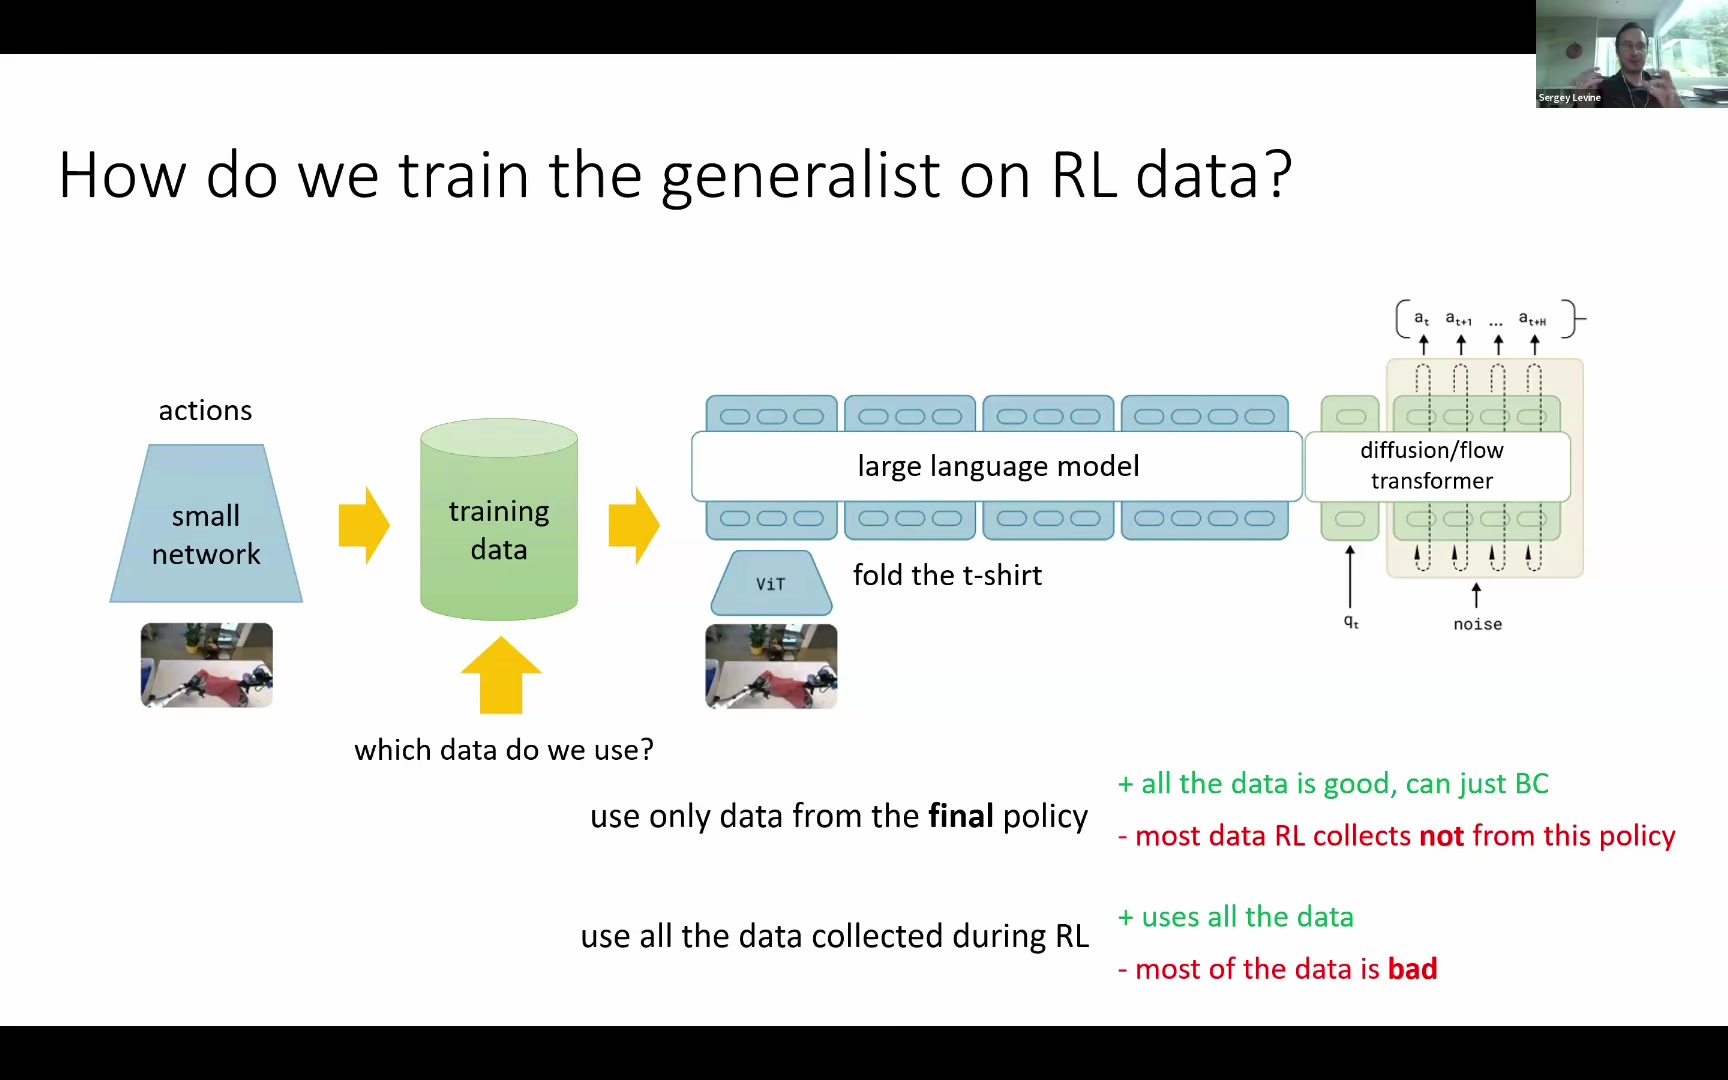
스페셜리스트의 경험을 제너럴리스트로 되돌릴 때 또 하나의 딜레마가 생긴다. 최종 정책의 성공 데이터만 쓰면 품질은 좋지만 RL 과정의 대부분을 버리게 된다. 반대로 전체 데이터를 쓰면 실수·복구·경계 상태까지 얻지만 나쁜 행동이 압도적으로 많다. CFGRL은 이 선택을 없앤다. 모든 데이터를 학습하되, 추론 시점에 좋은 행동 쪽으로 분포를 밀어낸다.
KL 정규화 RL과 diffusion guidance의 연결
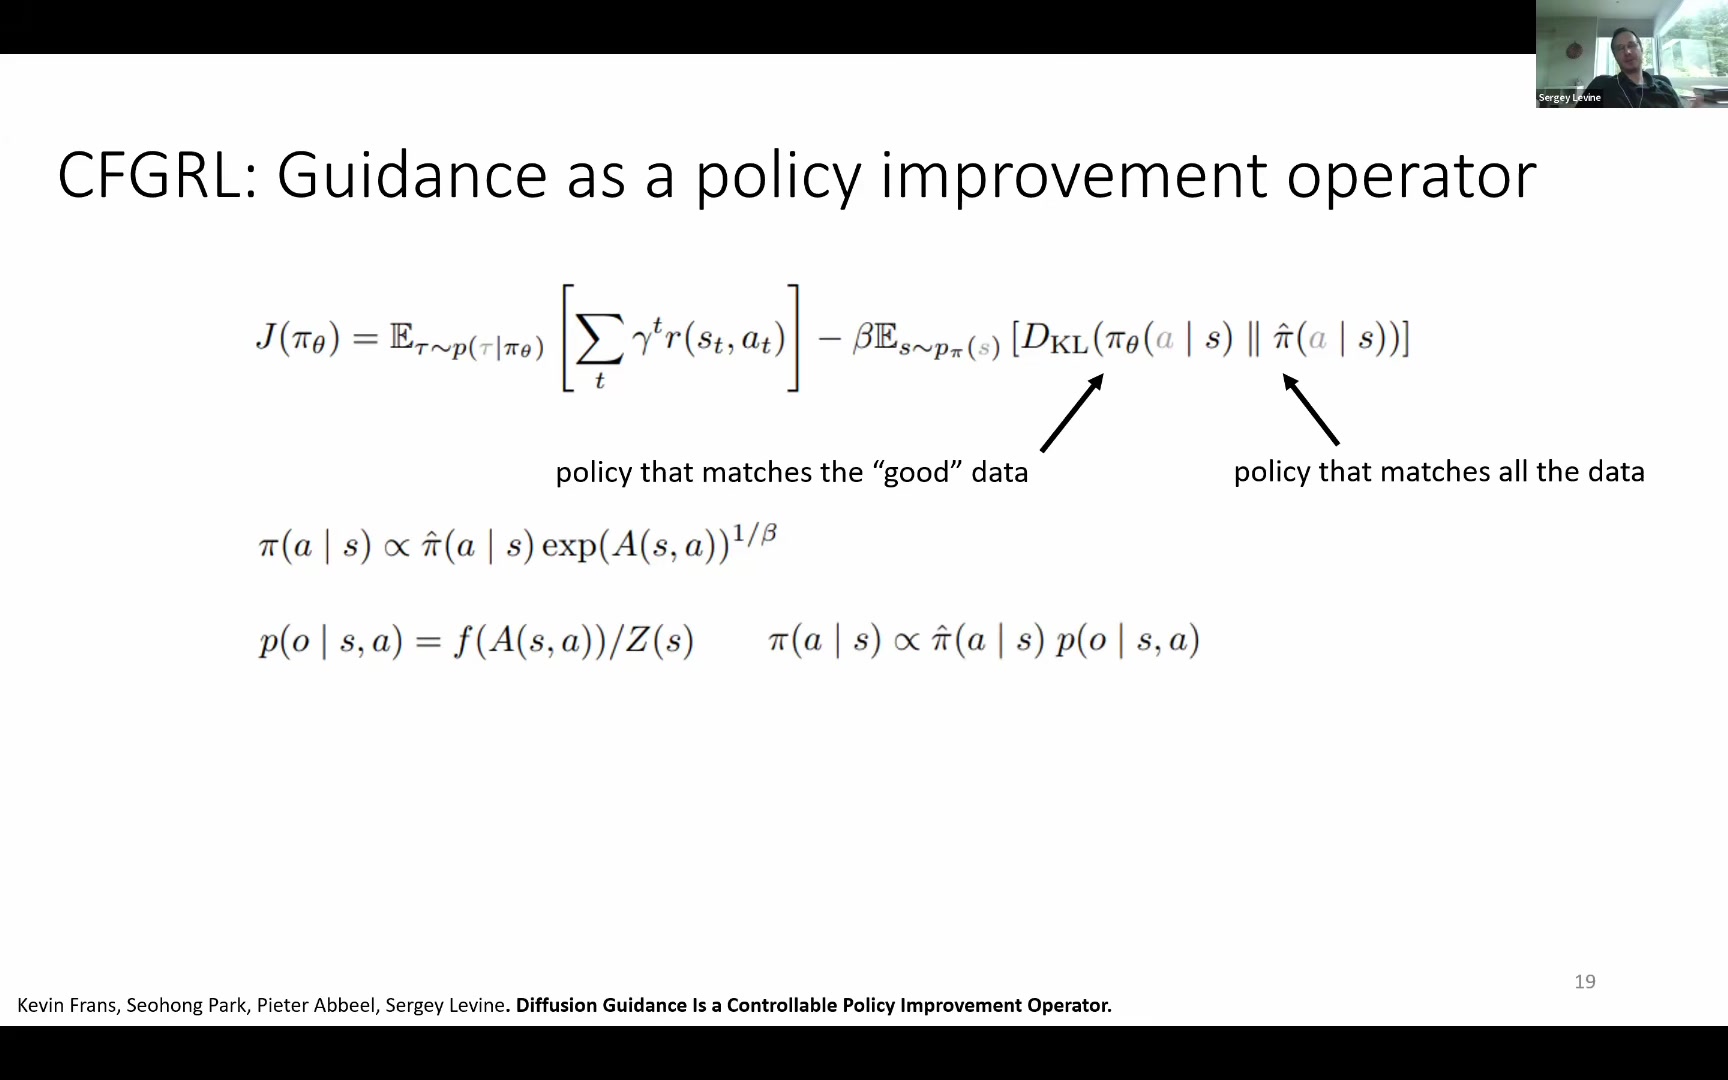
CFGRL의 출발점은 참조 정책에서 너무 멀어지지 않으면서 보상을 높이는 KL 정규화 목적함수다.
이 목적함수의 최적 정책은 참조 정책을 어드밴티지에 따라 재가중한 형태다.
이진 최적성 변수 o를 도입하면 개선 정책은 전체 데이터 정책과 “이 행동이 좋은가”라는 조건의 곱으로 나타난다.
스코어 함수를 분해하고 베이즈 정리로 재배열하면 이 형태는 diffusion 모델의 classifier-free guidance와 동형이 된다. 정책 자체를 반복 업데이트하는 대신, 전체 데이터로 조건부·무조건부 분포를 학습하고 샘플링할 때 최적성 방향을 증폭할 수 있다는 뜻이다.
좋은 데이터의 모드로 ‘줌인’한다
학습 중 최적성 조건을 무작위로 드롭하면 하나의 모델이 전체 데이터 분포와 좋은 데이터의 조건부 분포를 모두 배운다. 추론 시 guidance weight w를 높이면 단순히 “좋은 행동으로 조건화”하는 것을 넘어, 좋은 데이터가 밀집한 모드를 더 강하게 선택한다.
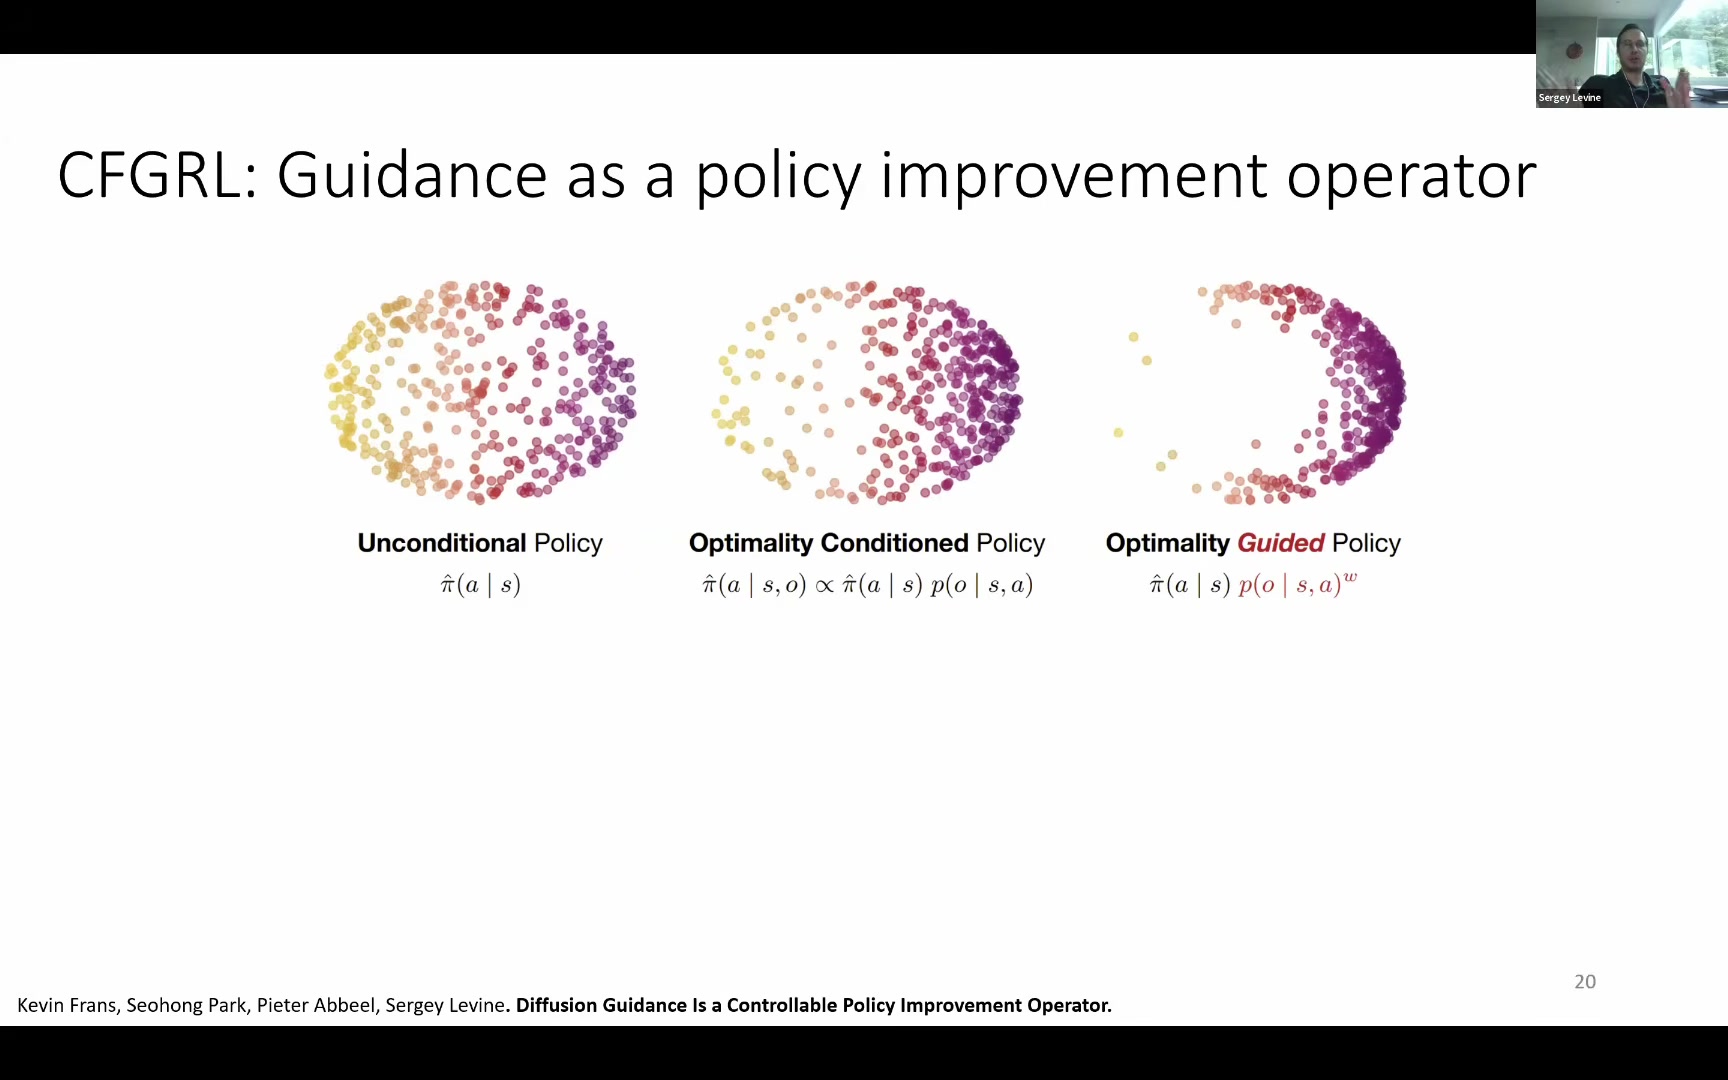
잘한 시도와 못한 시도에 각각 품질 스티커를 붙여 모두 학습한다. 실제로 행동할 때 “잘된 쪽으로 더 세게 밀어 달라”고 요청하면 모델은 성공 사례가 밀집한 영역을 선택한다. 실패는 이쪽으로 가면 안 된다는 경계 정보를 제공한다.
이 방식이 advantage-weighted regression보다 안정적인 이유도 데이터 사용량에 있다. AWR은 낮은 어드밴티지 샘플에 사실상 0에 가까운 가중치를 주지만, CFGRL은 모든 샘플을 조건 학습에 활용한다.
π*0.6: guidance를 대규모 VLA 정책 추출로 확장
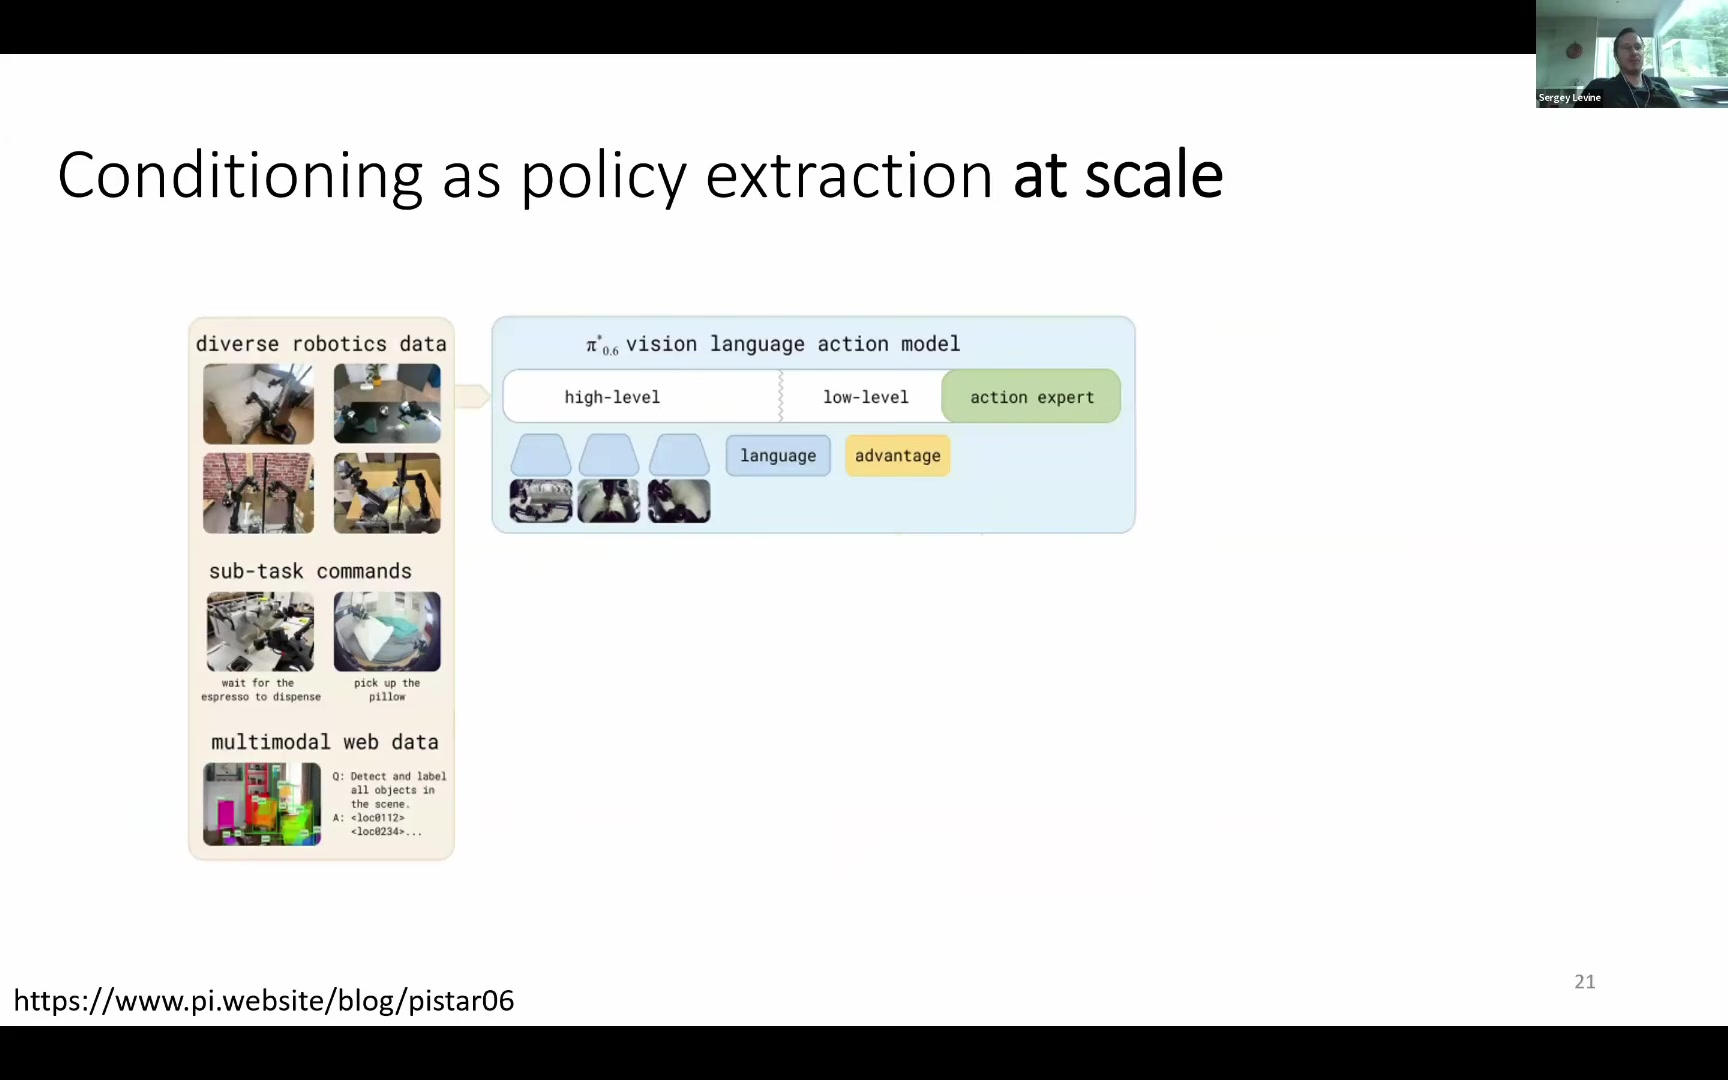
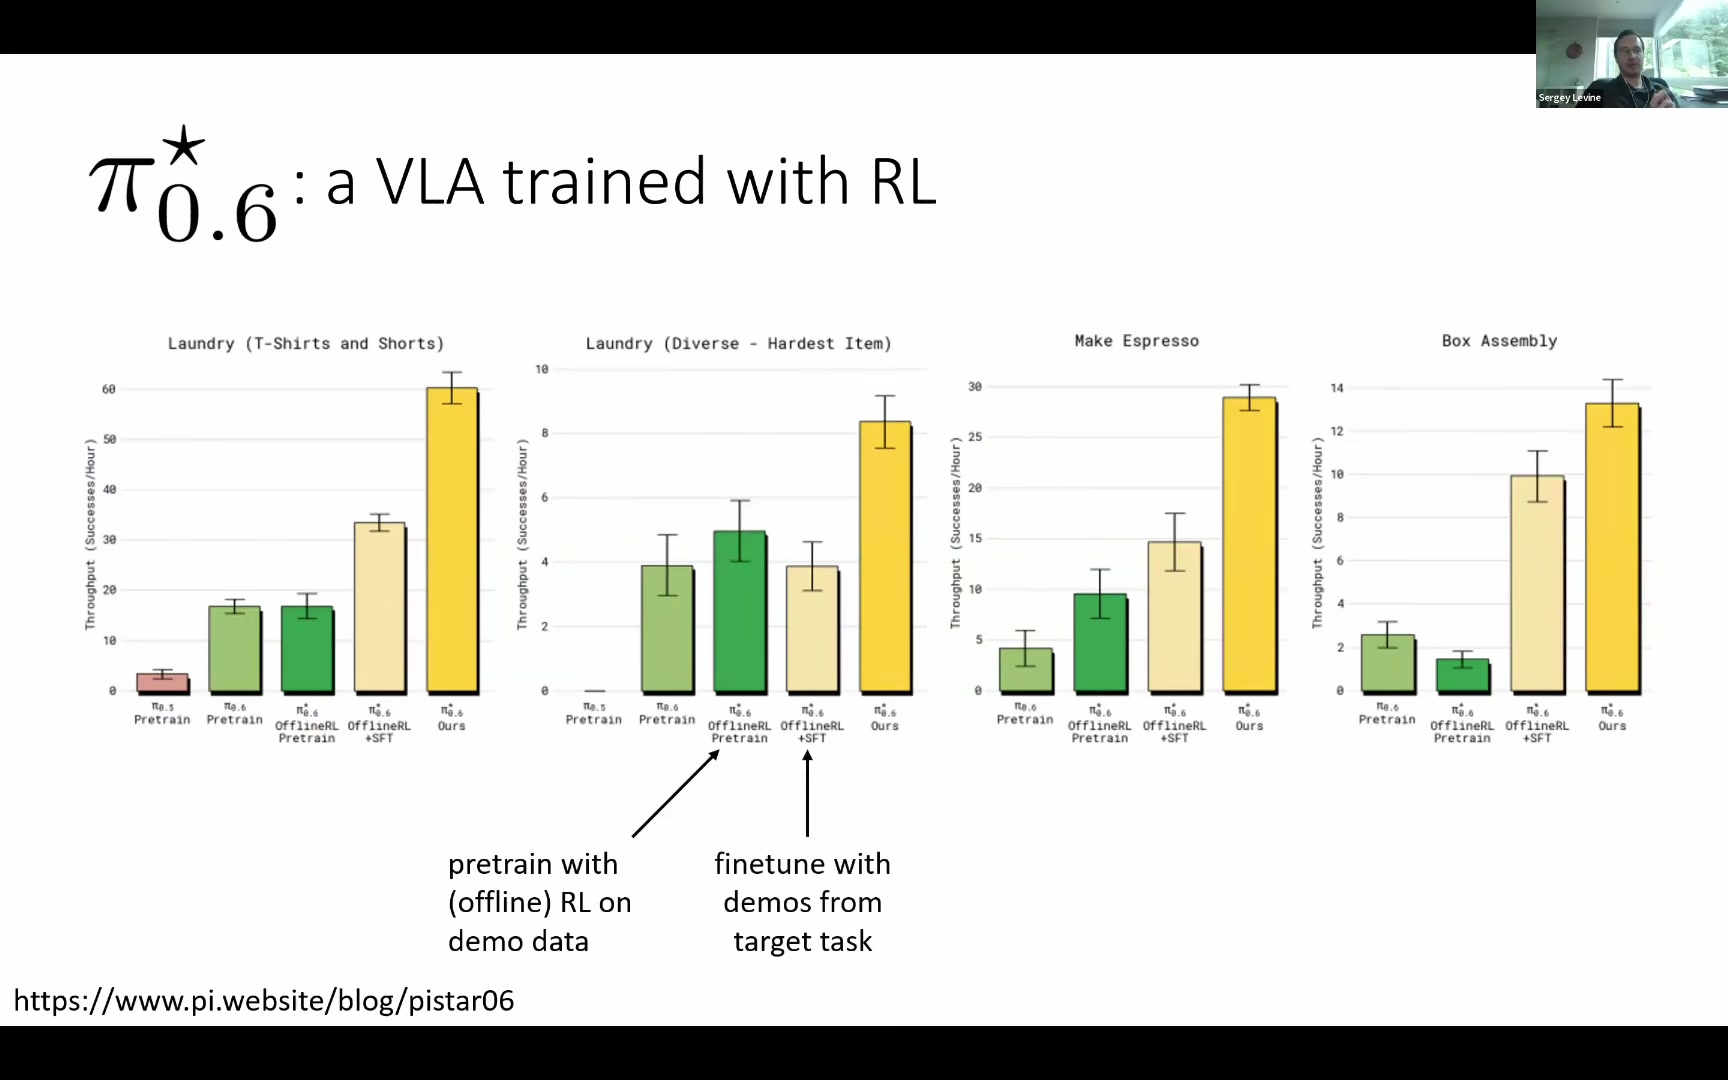
π*0.6은 언어 서브태스크, 멀티모달 웹 데이터, 다양한 로봇 궤적과 함께 advantage 조건을 학습한다. 정책은 SigLIP 400M, Gemma 4B, action expert 860M으로 구성되고, 별도의 작은 VLM과 value head가 진행도를 평가한다.
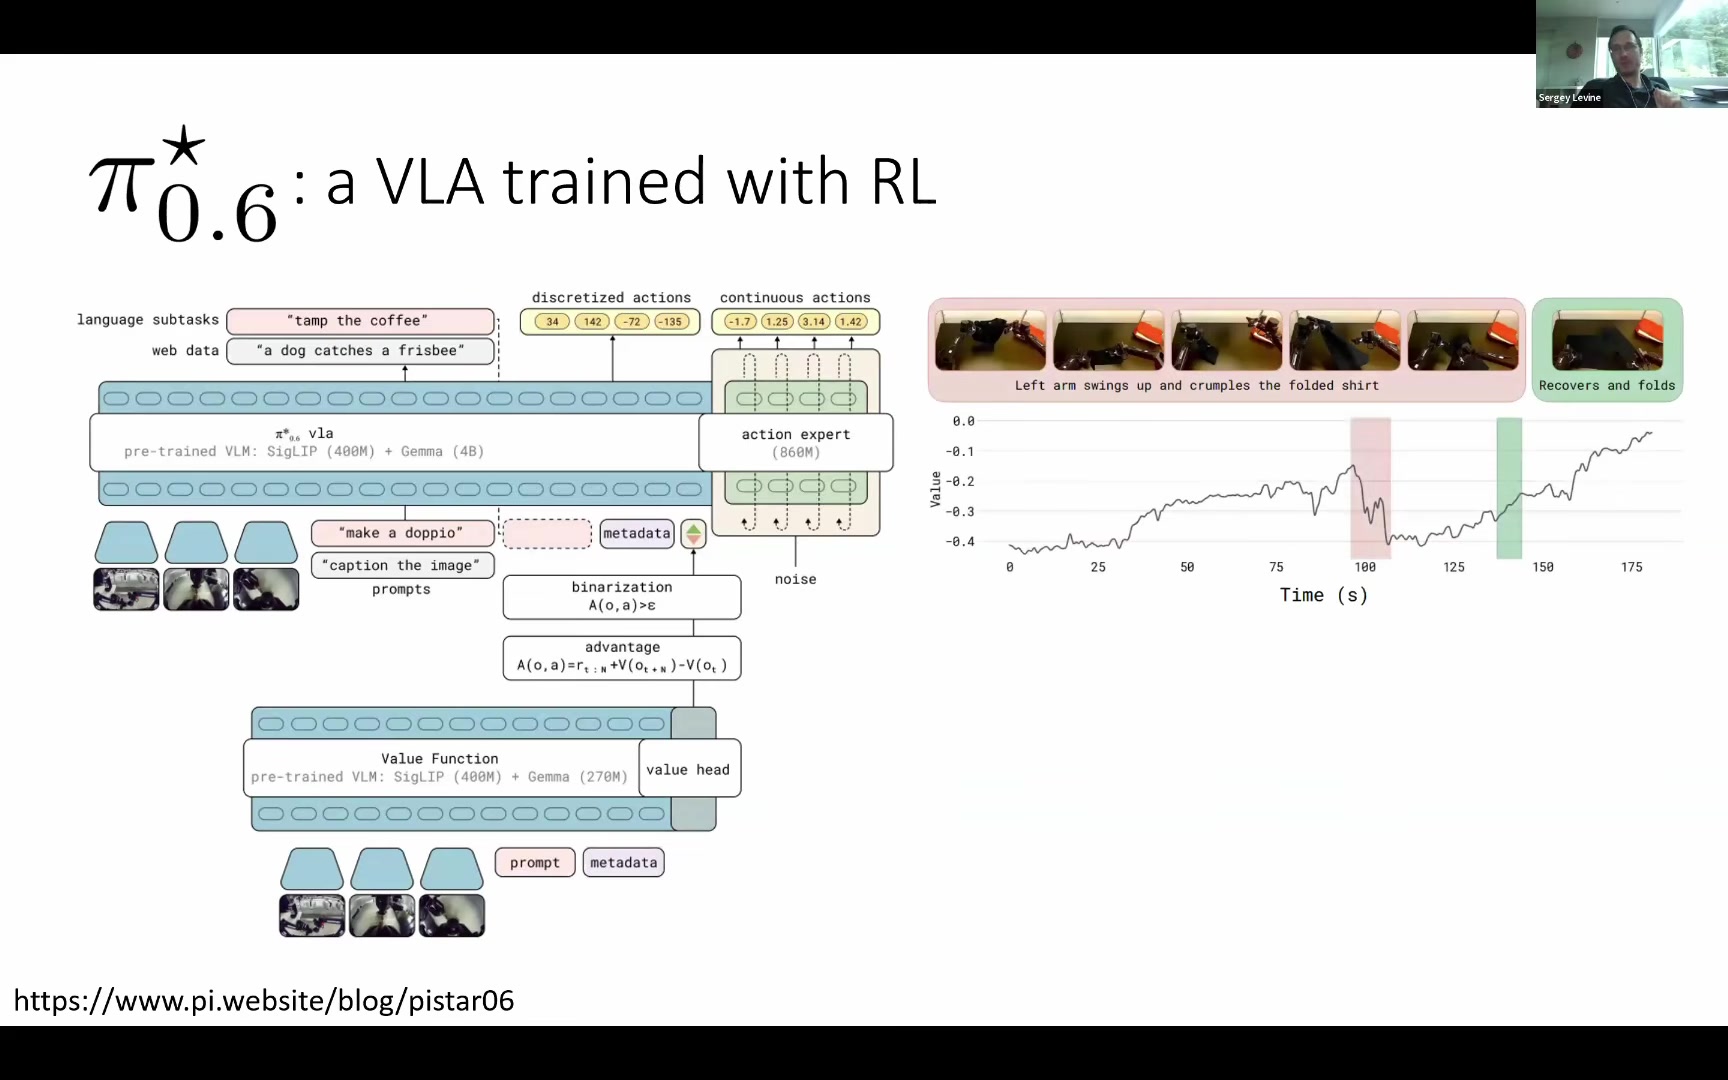
가치함수는 단순한 내부 보조 신호를 넘어 해석 가능한 진행도 지표로 작동한다. 셔츠를 접다가 이미 접은 부분을 흐트러뜨리면 값이 급락하고, 복구한 뒤 다시 접으면 값이 회복된다.
Part V · The Flywheel
파이프라인이 아니라 순환 구조로
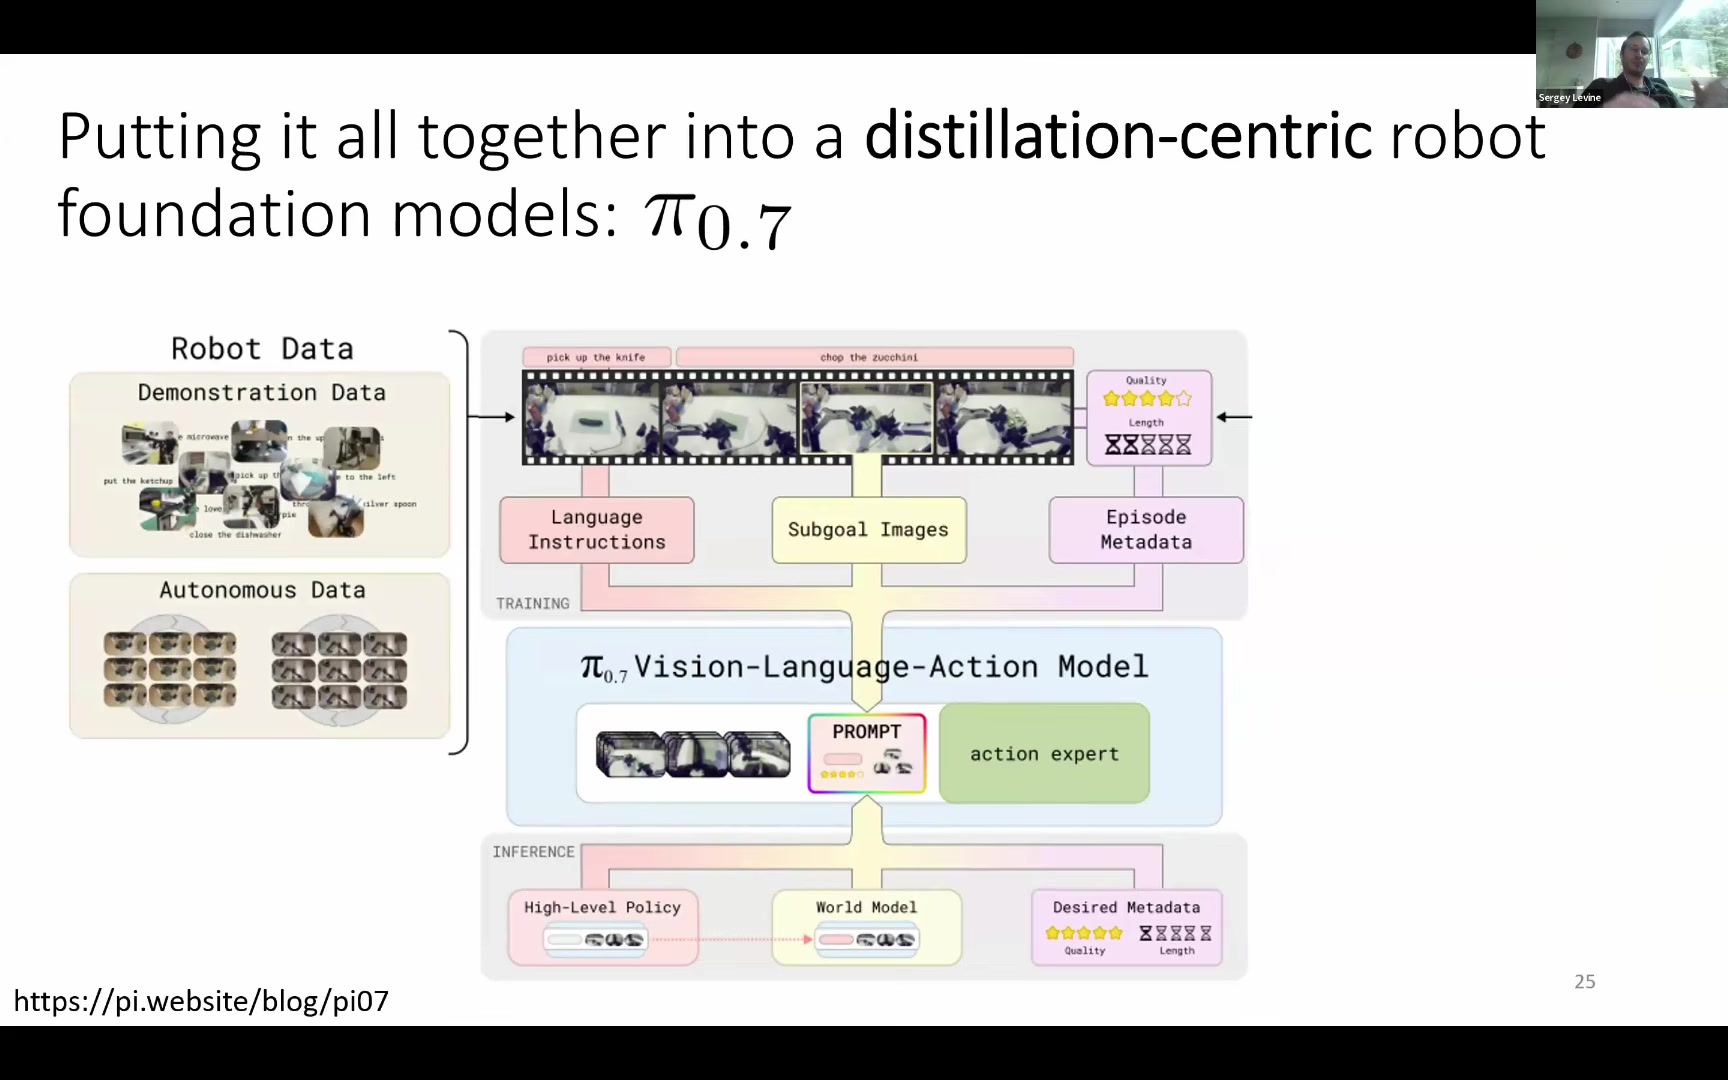
π0.7은 앞선 조각들을 통합한다. 사람 데모뿐 아니라 모든 스페셜리스트의 자율 데이터를 함께 학습하고, 언어 지시·서브골 이미지·에피소드 품질·길이를 조건으로 사용한다. 추론 시 원하는 메타데이터를 프롬프트하면 하나의 모델이 여러 스페셜리스트 과제를 비슷한 수준으로 수행한다.
Generalist–Specialist Learning Flywheel
↺ 더 나아진 제너럴리스트가 다음 스페셜리스트의 탐색을 다시 가속한다.
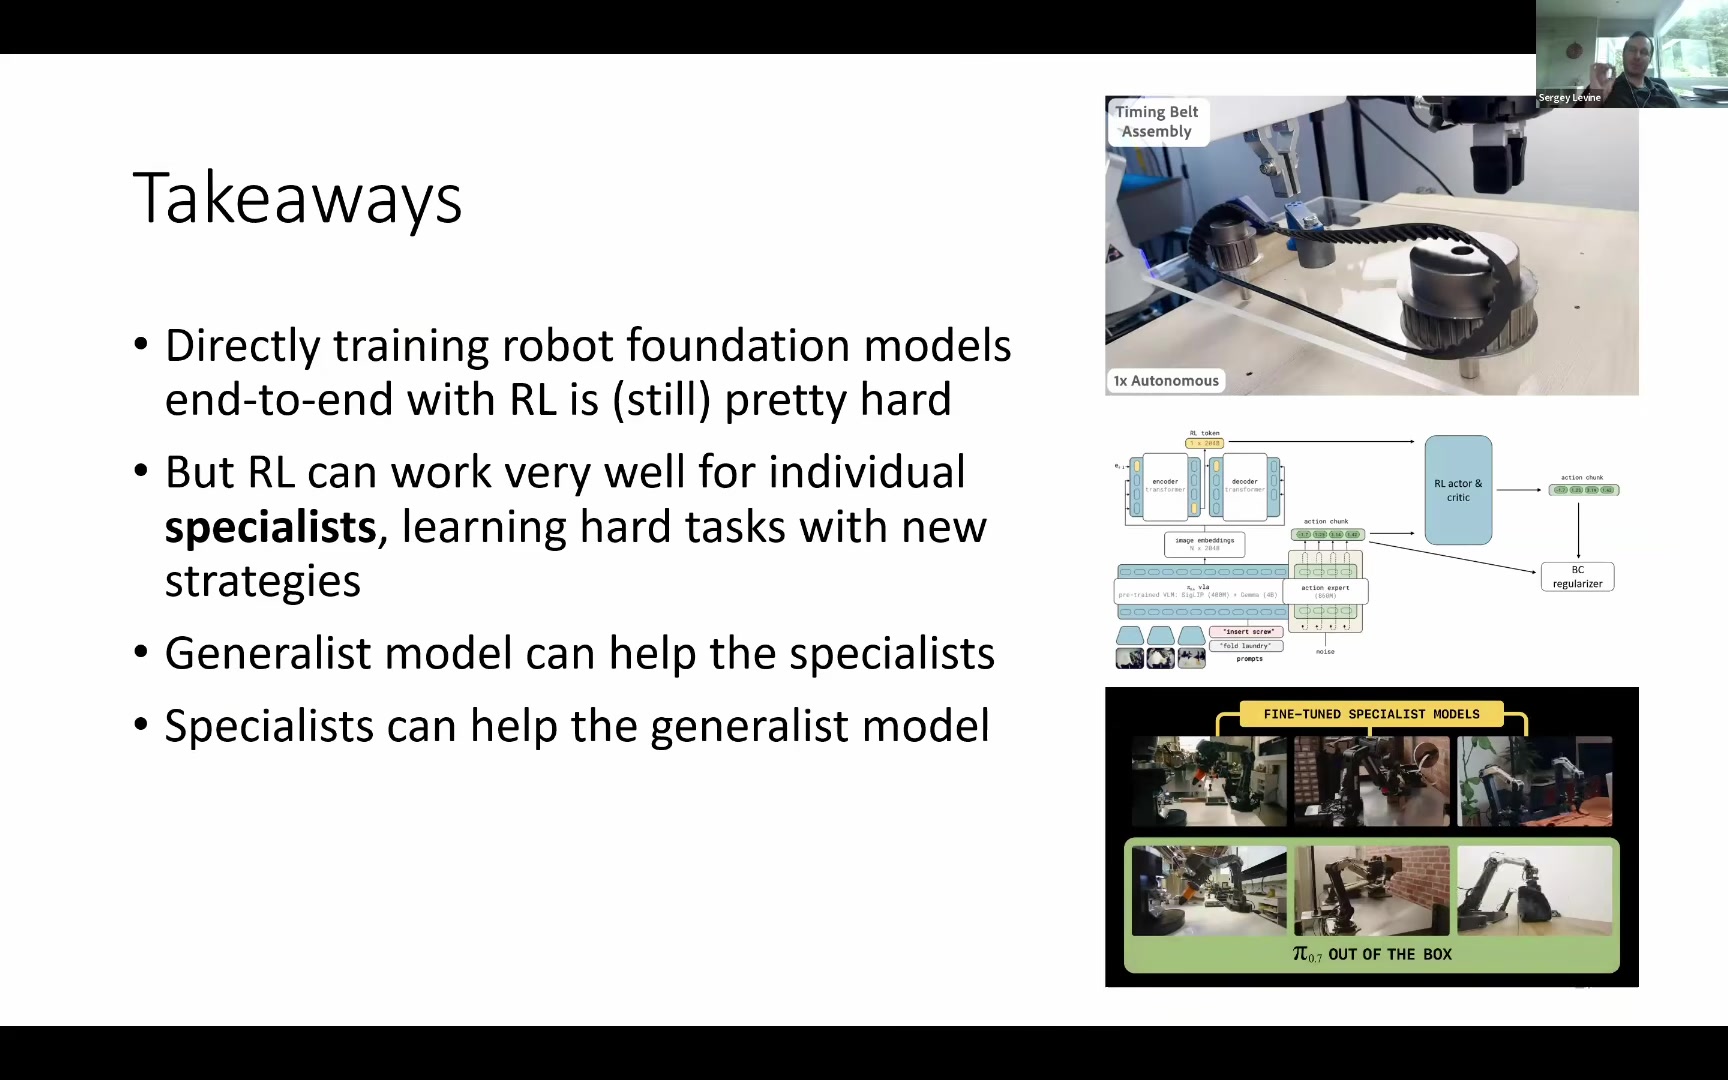
가장 큰 단일 모델보다 가장 빠른 학습 순환에서 나온다.
Implications
연구와 제품 개발에 주는 의미
1. 전체 정책보다 병목을 먼저 정의하라
장기 과제 전체를 RL로 최적화하는 대신, 성공률과 처리량을 제한하는 한두 개의 정밀 구간을 찾는 편이 효과적이다. 상위 정책은 이미 잘하는 단계를 유지하고, RL은 접촉·정렬·복구처럼 데이터 가치가 높은 구간에 집중한다.
2. 행동 prior는 탐색 알고리즘의 일부다
파운데이션 모델은 단지 초기 가중치가 아니다. 내부 표현, 액션 청크, 언어 조건을 작은 RL 정책에 노출하면 탐색 공간 자체가 달라진다. 무작위 액션 노이즈 대신 “구멍에 접근한다”, “그립을 다시 잡는다” 같은 의미적 행동 주변을 탐색할 수 있다.
3. 실패와 복구를 데이터 자산으로 관리하라
최종 성공 궤적만 보존하면 실제 배포에서 필요한 복구 능력을 잃는다. 데이터에는 성공 여부뿐 아니라 에피소드 길이, 품질, 개입 시점, 어드밴티지, 실패 유형 같은 메타데이터가 함께 기록되어야 한다.
4. 단일 성공률보다 처리량을 측정하라
성공률이 같아도 반복 시도와 느린 복구로 인해 실제 생산성은 크게 달라진다. 시간당 성공 횟수, 성공 에피소드 길이, 사람 개입 횟수, 리셋 시간을 함께 측정해야 제품 수준의 개선을 확인할 수 있다.
| 설계 질문 | 권장 판단 기준 | 관련 접근 |
|---|---|---|
| 어디에 RL을 적용할까? | 전체 성공률을 제한하는 정밀 병목 단계 | RLT, 계층적 과제 분할 |
| 탐색을 어떻게 안정화할까? | VLA 표현·기본 액션·BC regularizer 유지 | RL Token, action pass-through |
| 어떤 데이터를 증류할까? | 성공뿐 아니라 실패와 복구를 품질 조건과 함께 사용 | CFGRL, advantage conditioning |
| 성능을 무엇으로 볼까? | 성공률 + 처리량 + 에피소드 길이 + 개입 비용 | SERL·RLT 평가 방식 |
| 장기적으로 무엇을 축적할까? | 과제별 모델보다 재사용 가능한 자율 경험과 메타데이터 | RLDG, π0.7식 증류 |
Q&A에서 드러난 다음 연구 문제: 의미 공간의 탐색
“USB를 구멍에 넣을 때 사람은 구멍을 보고 접근하지만, 현재 RL 정책은 궤적 전체에서 무작위로 흔들린다”는 질문에 Levine은 제너럴리스트를 행동 사전확률로 사용할 것을 강조했다. RLT의 BC 항은 잘 모를 때 기본 모델과 비슷하게 움직이도록 한다. 더 나아가 언어 입력을 변화시키며 의미 공간에서 탐색할 수 있다. 이는 연속 액션 값에 노이즈를 더하는 방식보다 훨씬 구조화된 탐색 공간을 제공한다.
평가를 위한 체크리스트
- □ 파운데이션 모델 없이도 학습 가능한 명확한 병목 단계가 정의됐는가?
- □ 기본 정책의 표현과 액션을 RL actor에 전달할 수 있는가?
- □ 보상을 자동 판정할 단순하고 신뢰할 수 있는 신호가 있는가?
- □ 실패·복구·사람 개입 데이터를 버리지 않고 기록하는가?
- □ 성공률뿐 아니라 처리량과 실제 벽시계 학습 시간을 보고하는가?
- □ 새 경험을 다음 제너럴리스트 버전으로 되돌리는 증류 경로가 있는가?
Video Guide
32분 발표 타임라인
발표자 소개
LLM의 텍스트 계획과 물리적 실행 사이의 간극
로봇 파운데이션 모델 분야의 현황
Pre-training과 post-training의 역할
지도학습 정책의 숙련도·속도 한계
실세계 RL이 필요한 이유
Big model × sample-efficient RL × hard task
RLPD 스페셜리스트 학습 레시피
SERL 실세계 데모와 결과
RLDG: 스페셜리스트 경험의 제너럴리스트 증류
RLT와 RL Token 구조
장기 과제 중 병목 단계만 RL로 개선
처리량·에피소드 길이·어블레이션 결과
전체 RL 데이터를 제너럴리스트에 넣는 문제
KL 정규화 목적함수와 classifier-free guidance
좋은 행동의 모드로 줌인하는 시각적 해석
π*0.6과 대규모 advantage conditioning
π0.7 통합 증류 모델
제너럴리스트↔스페셜리스트 순환 결론
행동 prior와 의미 공간 탐색에 관한 Q&A
Reader’s Ending
한 문장으로 남기면
로봇 파운데이션 모델의 다음 도약은 모든 것을 한 번에 학습하는 데서가 아니라, 넓게 아는 모델과 깊게 숙달한 모델이 서로를 반복해서 개선하는 데서 시작된다.
엔드투엔드 RL은 장기 목표로 남겠지만, 그때도 스페셜리스트는 사라지지 않을 가능성이 크다. 작은 정책은 더 빠르게 배우고, 위험을 격리하며, 병목에 집중할 수 있기 때문이다. 중요한 질문은 “어느 모델이 최종 승자인가”가 아니라 “새 과제에서 얻은 경험이 다음 모델을 얼마나 빠르게 더 낫게 만드는가”다.
Sources & Method
출처와 연구 노트
이 글은 YouTube 자동 생성 영어 자막과 발표 슬라이드 23장을 대조해 구성했다. RLPD, SERL, RLDG, CFGRL, π*0.6, π0.7 등 고유명사는 화면 표기와 연결된 연구 페이지를 기준으로 정리했다. 정량 수치는 발표 슬라이드에 제시된 범위와 조건을 유지했으며, 특정 환경에서의 결과를 일반적인 로봇 성능으로 확대 해석하지 않았다.
- Sergey Levine — RL for Robot Foundation Models, 발표 영상
- ICRA 2026 Workshop on RL in the Era of IL
- Luo, Hu, Xu et al. SERL: A Software Suite for Sample-Efficient Robotic Reinforcement Learning, 2024.
- Luo, Xu, Wu, Levine. Precise and Dexterous Robotic Manipulation via Human-in-the-Loop Reinforcement Learning, 2025.
- Xu, Li, Luo, Levine. RLDG: Robotic Generalist Policy Distillation via Reinforcement Learning.
- Frans, Park, Abbeel, Levine. Diffusion Guidance Is a Controllable Policy Improvement Operator.
- Physical Intelligence — RLT: RL Token
- Physical Intelligence — π*0.6
- Physical Intelligence — π0.7