화려한 데모 ≠ 지능
백덤블링도 발차기도 성공 +100 / 실패 −1 형태의 보상 설계로 수렴한 행동이다. 이해가 아니라 최적화의 산물이다.
연구 노트 · Physical AI
Atlas의 공중제비와 Unitree H2의 발차기에는 ‘왜’가 없다. 보상함수가 시킨 대로 수렴한 궤적일 뿐이다. 챗GPT의 지능을 로봇 몸에 이식하려는 VLA(Vision-Language-Action) 연구가 SayCan에서 OpenVLA를 거쳐 2026년 여섯 갈래로 갈라지기까지 — 그 계보와, 남아 있는 진짜 병목에 대한 기록.
초록 · Abstract
인터넷을 휩쓴 휴머노이드 영상 대부분은 시뮬레이션 안에서 보상함수를 최대화하도록 학습된 강화학습의 결과물이다. 로봇은 냉장고를 옮기지만, 그것이 냉장고인지도 왜 옮겨야 하는지도 모른다. 이 발표는 바로 그 지점 — ‘상황 이해의 부재’ — 에서 출발한다.
대안으로 제시되는 것이 VLA(Vision-Language-Action) 모델이다. LLM(Language→Language)과 VLM(Vision+Language→Language)이 확보한 지능을 로봇의 몸에 이식해, 출력만 단어에서 관절값으로 바꾸자는 발상이다. 본 노트는 SayCan(2022)의 실행가능성 결합, 스케일링 법칙과 창발 능력의 가설 이식, Open X-Embodiment라는 대규모 공유 데이터셋, 그리고 오픈소스 기점이 된 OpenVLA(2024)까지의 계보를 정리한다.
이어서 OpenVLA가 드러낸 네 가지 구조적 한계(속도·정밀도·기억·감각)와, 이를 각각 공략하는 2024–2026년의 여섯 갈래 연구 방향(Action Expert, CoT, Memory, RL, Tactile/Force, Data Synthesis)을 검토한다. 결론은 두 가지다. 첫째, VLA의 구조 진화는 인간의 뇌를 부품별로 재구성하는 방향으로 수렴하고 있다. 둘째, 소프트웨어 이론의 발전은 예정된 수순이며 진짜 병목은 배터리·내구성·가격·센서·하드웨어, 그리고 데이터다.
백덤블링도 발차기도 성공 +100 / 실패 −1 형태의 보상 설계로 수렴한 행동이다. 이해가 아니라 최적화의 산물이다.
세상 자체를 시뮬레이션하는 월드모델+RL(NVIDIA)과, 로봇 데이터를 언어모델에 밀어 넣는 VLA+모방학습(DeepMind, Physical Intelligence).
LLM → VLM → VLA. 입력에 시각을 더하고, 출력을 언어에서 행동으로 바꾼 자연스러운 다음 칸이다.
구조와 가중치가 모두 공개되어 변형이 쉬웠다. 이 모델의 네 가지 한계가 곧 이후 연구의 좌표계가 됐다.
RLDX-1은 비디오 생성 모델로 로봇 데이터를 증강한다. 비디오 생성 모델은 곧 월드모델이다.
배터리, 내구성, 가격, 센서, 하드웨어, 그리고 데이터. 발표자가 꼽은 실제 제약 목록이다.
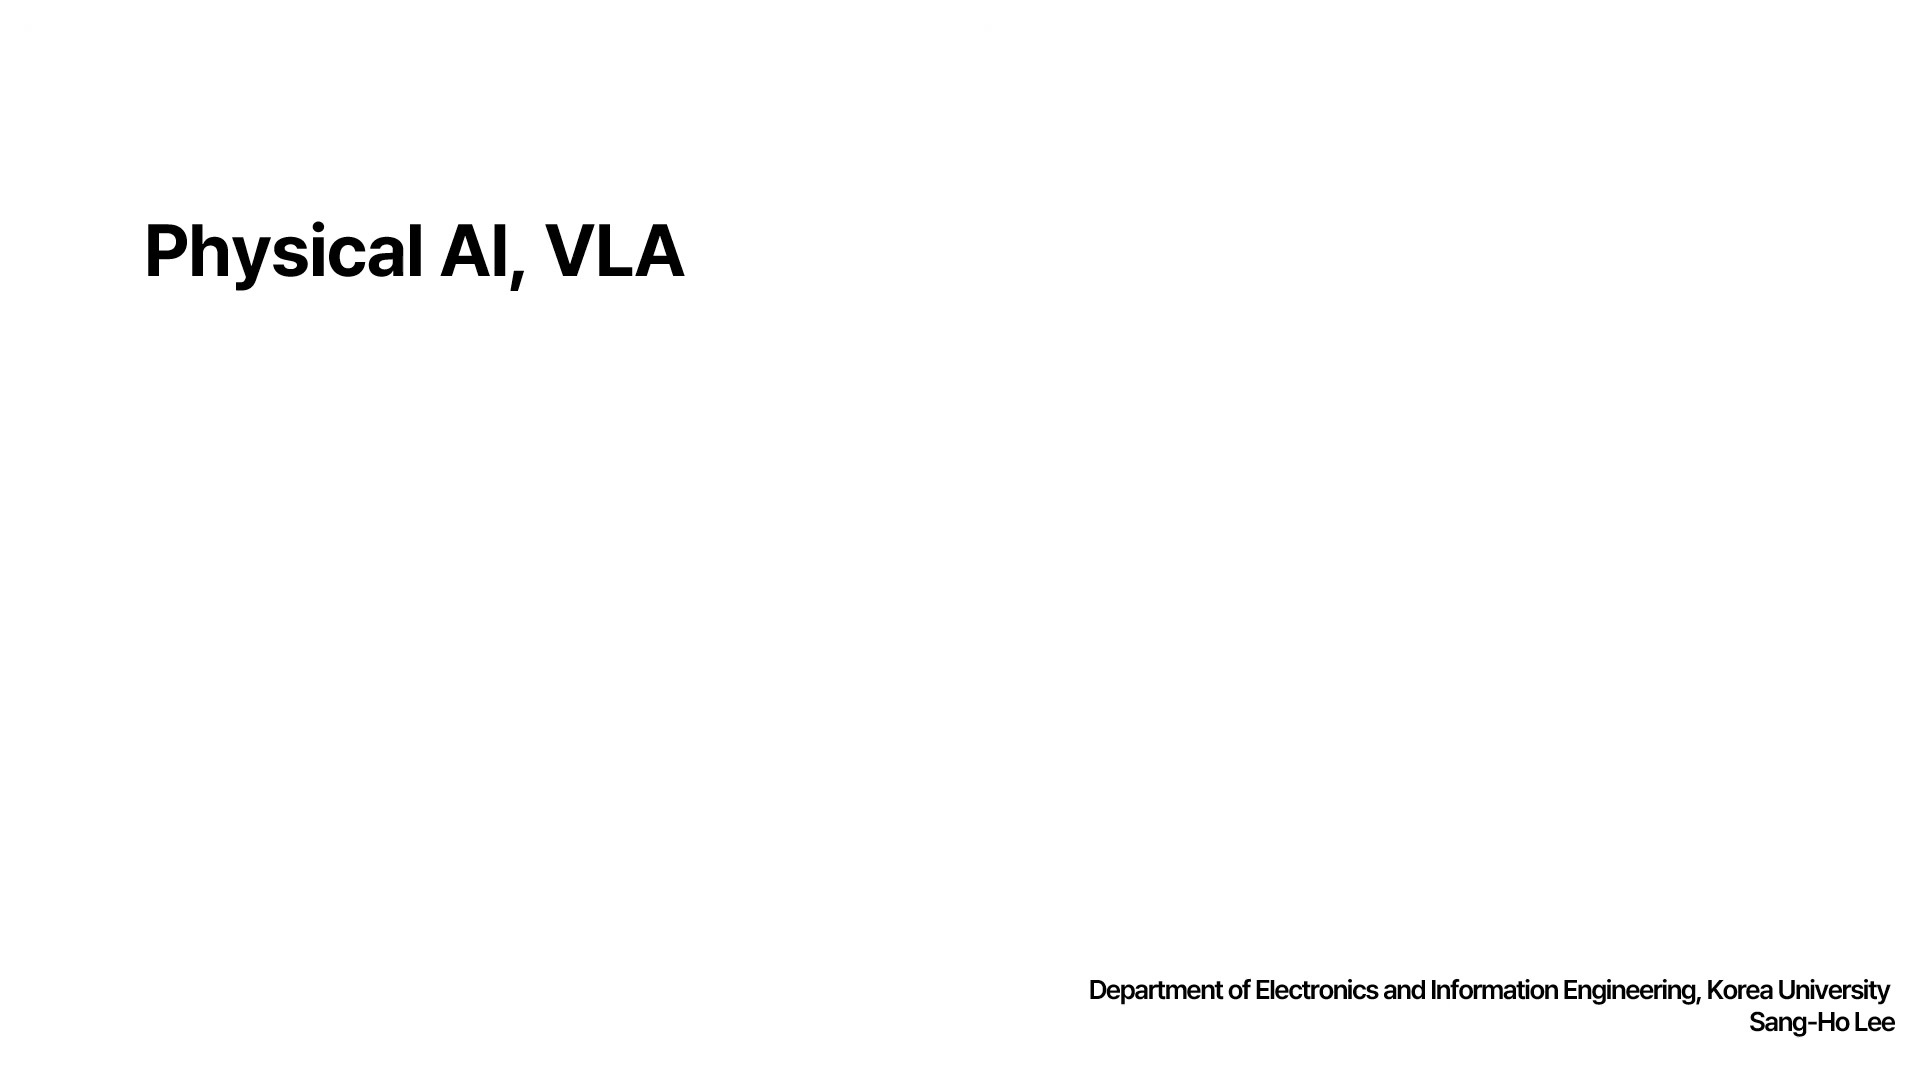
발표는 두 장의 영상으로 시작한다. 사람과 다른 방향으로 관절을 꺾으며 움직이는 Boston Dynamics의 Atlas, 그리고 발차기를 선보이는 Unitree H2. 타임라인을 점령했던 바로 그 장면들이다. 발표자의 첫 문장은 냉정하다 — “이런 데모들을 진정한 의미의 피지컬 AI로 보기는 어렵다.”
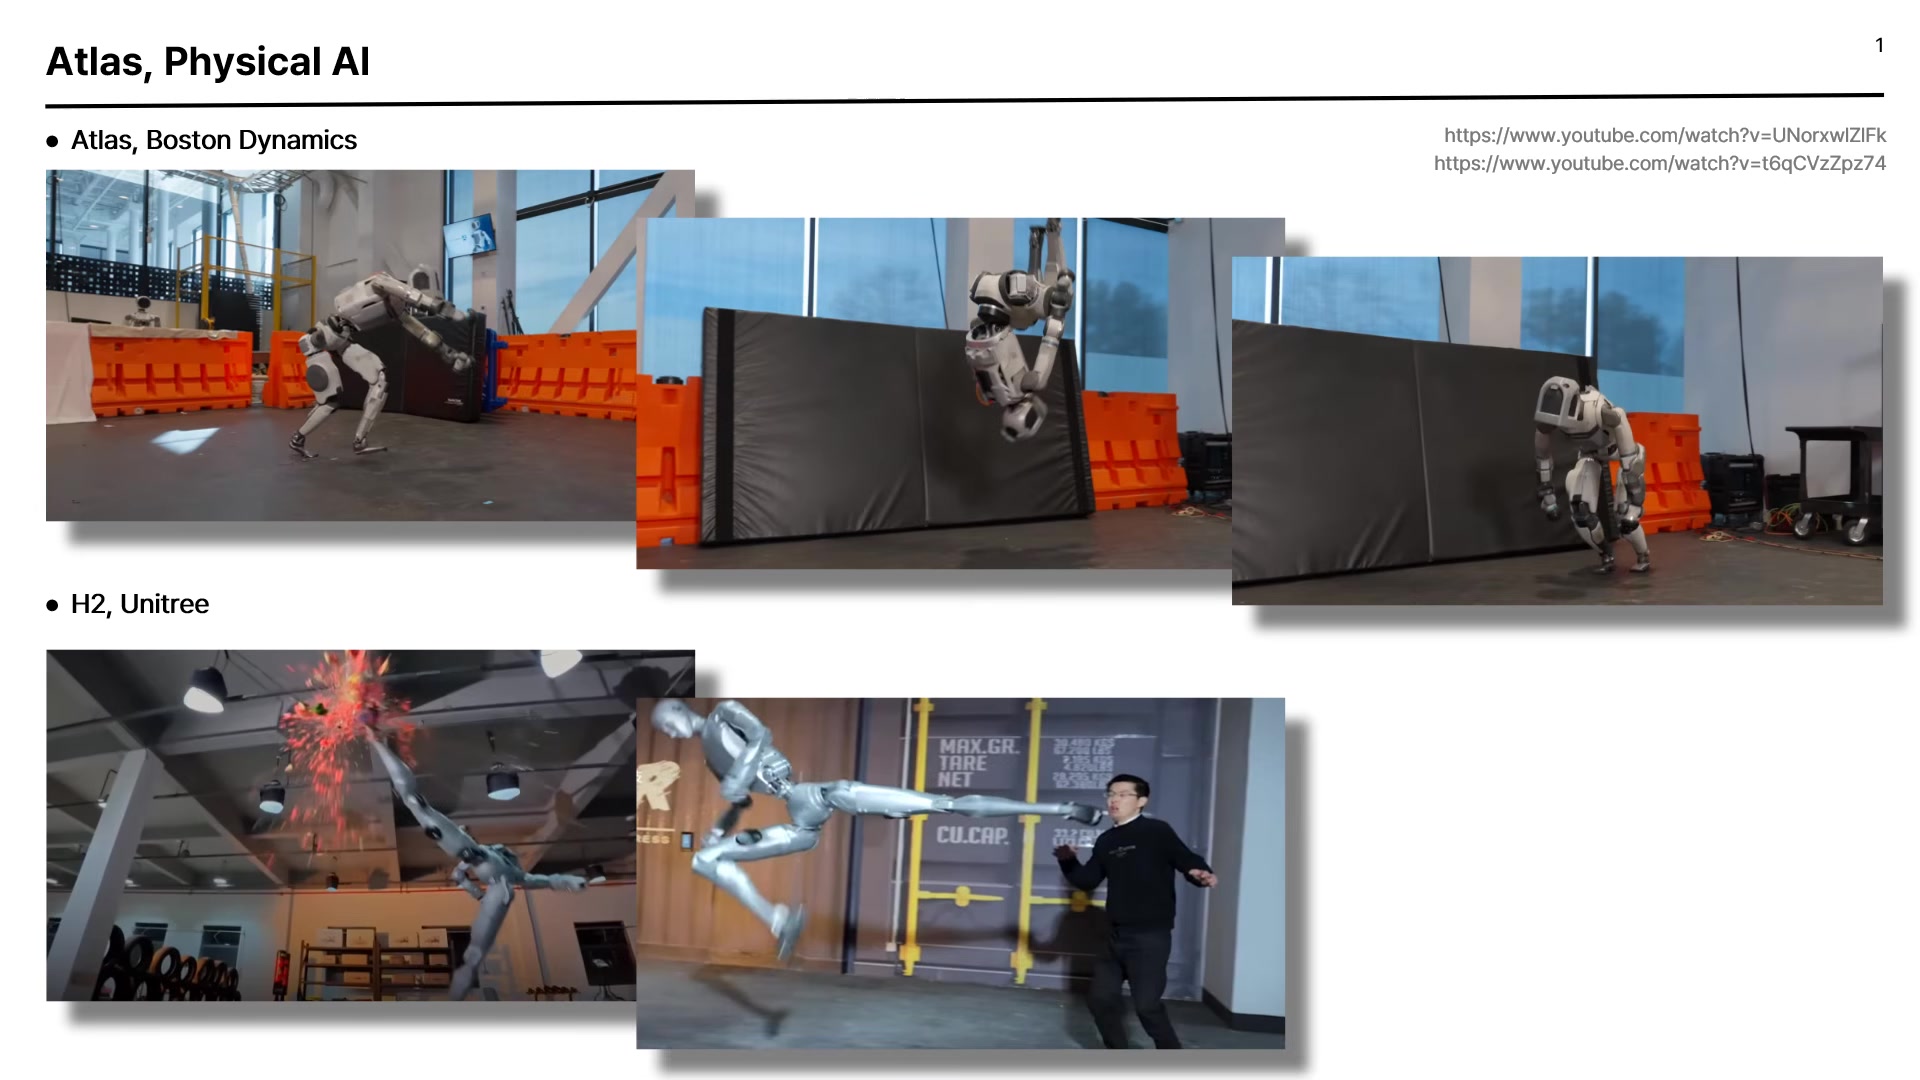
실제로 무슨 일이 벌어지고 있는가. 다음 슬라이드가 답한다. 왼쪽은 Atlas가 냉장고를 옮기는 실제 영상, 오른쪽은 같은 로봇과 냉장고를 시뮬레이션 안에 대량 복제해 놓은 병렬 학습 환경이다. 아래에는 보상함수가 그대로 적혀 있다.
| 조건 | 보상 | 의미 |
|---|---|---|
| 냉장고를 성공적으로 옮김 | +100 | 목표 달성 |
| 제한시간 내 실패 | −100 | 시간 제약 학습 |
| 냉장고를 떨어뜨리거나 손상 | −200 | 가장 강한 페널티 |
여기에 PPO(Proximal Policy Optimization)를 붙이면 끝이다. 정책은 보상값이 큰 쪽으로 점진적으로 이동하고, 결국 “냉장고를 옮기는 올바른 행동”으로 수렴한다. 백덤블링도 발차기도 다르지 않다. 성공 +100, 실패 −1. 설계만 바꿨을 뿐 메커니즘은 동일하다.
로봇은 냉장고를 옮기지만, 그것이 냉장고라는 사실도 왜 옮겨야 하는지도 모른다. 보상이 가리키는 방향으로 수렴했을 뿐이다.— 발표의 문제의식을 한 문장으로
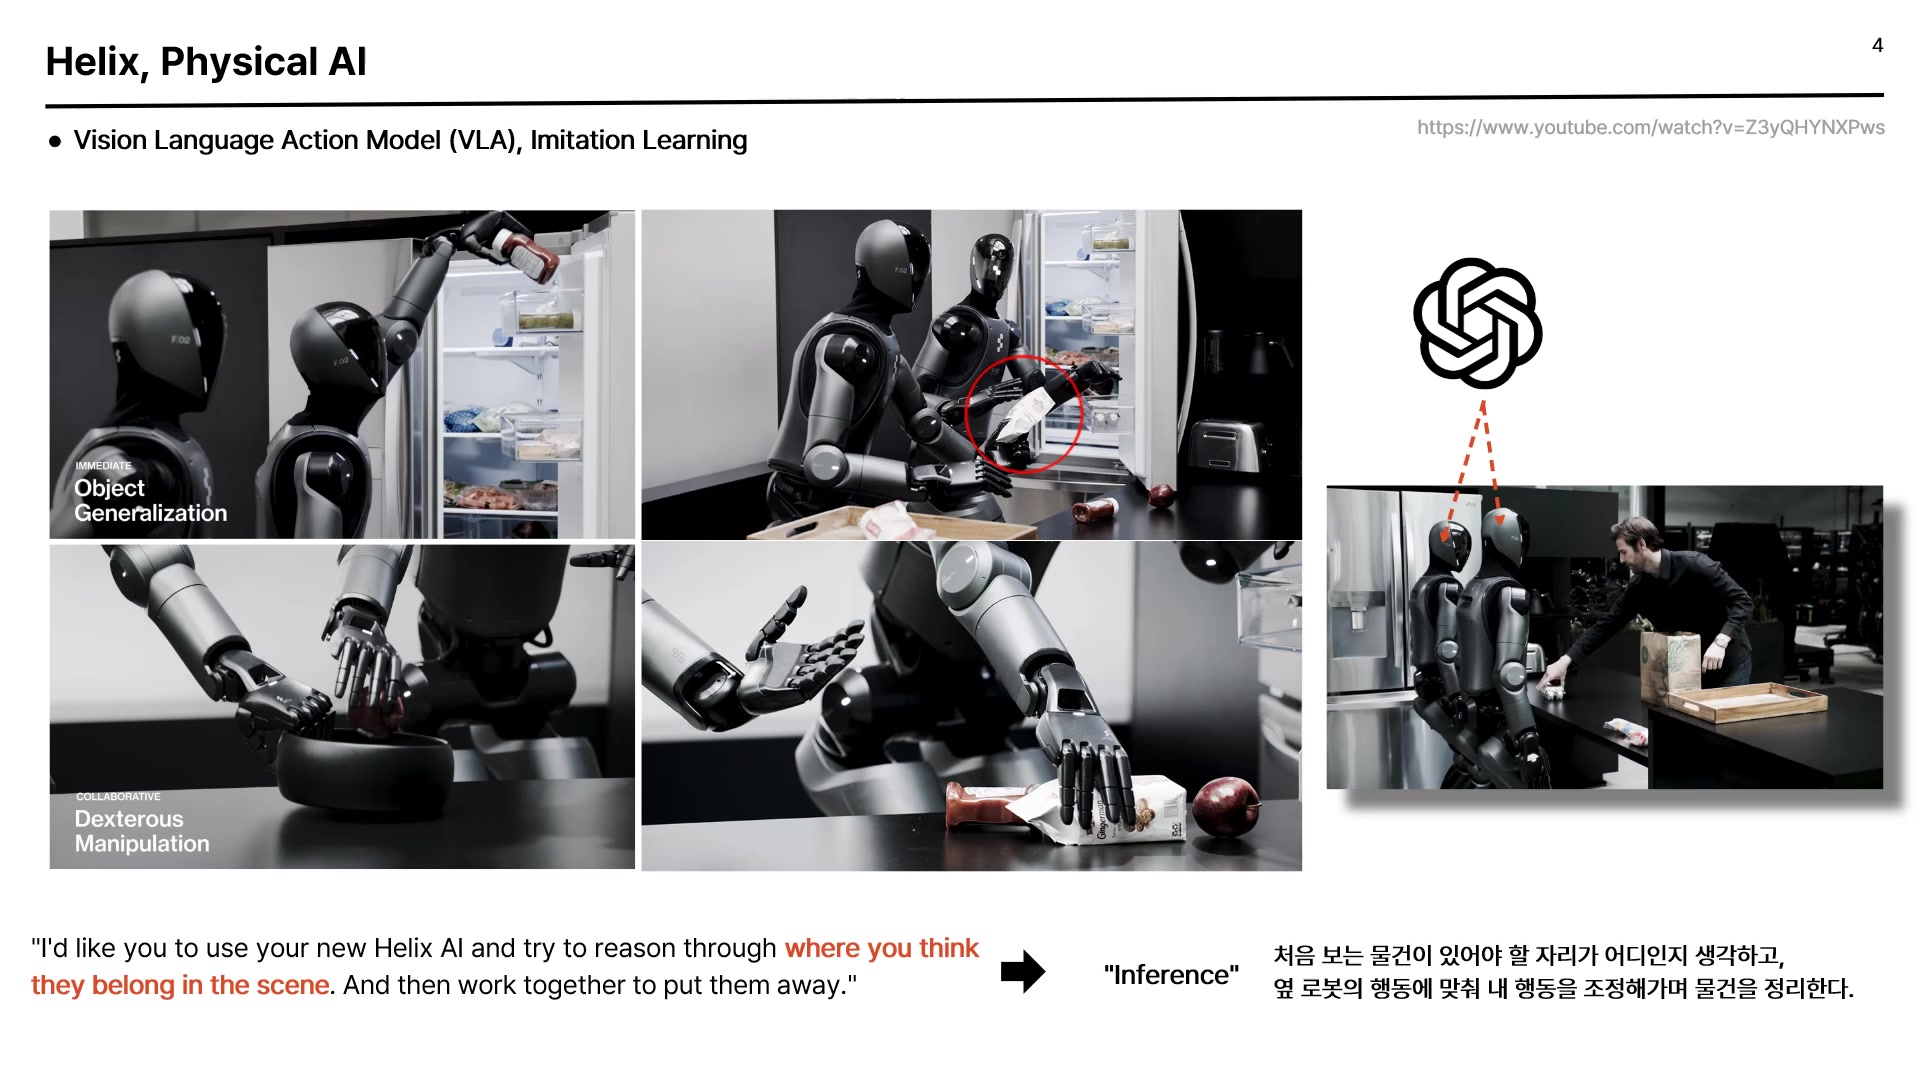
대조군으로 제시되는 것이 Figure의 Helix다. 슬라이드에 인용된 명령은 이렇다 — “I’d like you to use your new Helix AI and try to reason through where you think they belong in the scene. And then work together to put them away.”
처음 보는 물건이 냉장고에 들어가야 할지, 서랍에 들어가야 할지, 바구니에 담겨야 할지를 판단한다. 옆에 있는 다른 로봇이 무엇을 집었는지 보고 자기 행동을 실시간으로 조정한다. 동작은 느리고 영상은 덜 화려하다. 그러나 여기에는 상황 이해가 개입한다.
발표자는 피지컬 AI를 두 갈래로 정리한다. 슬라이드 한 장이 좌우로 갈라져 있고, 각각에 대표 기업의 로고가 붙는다.
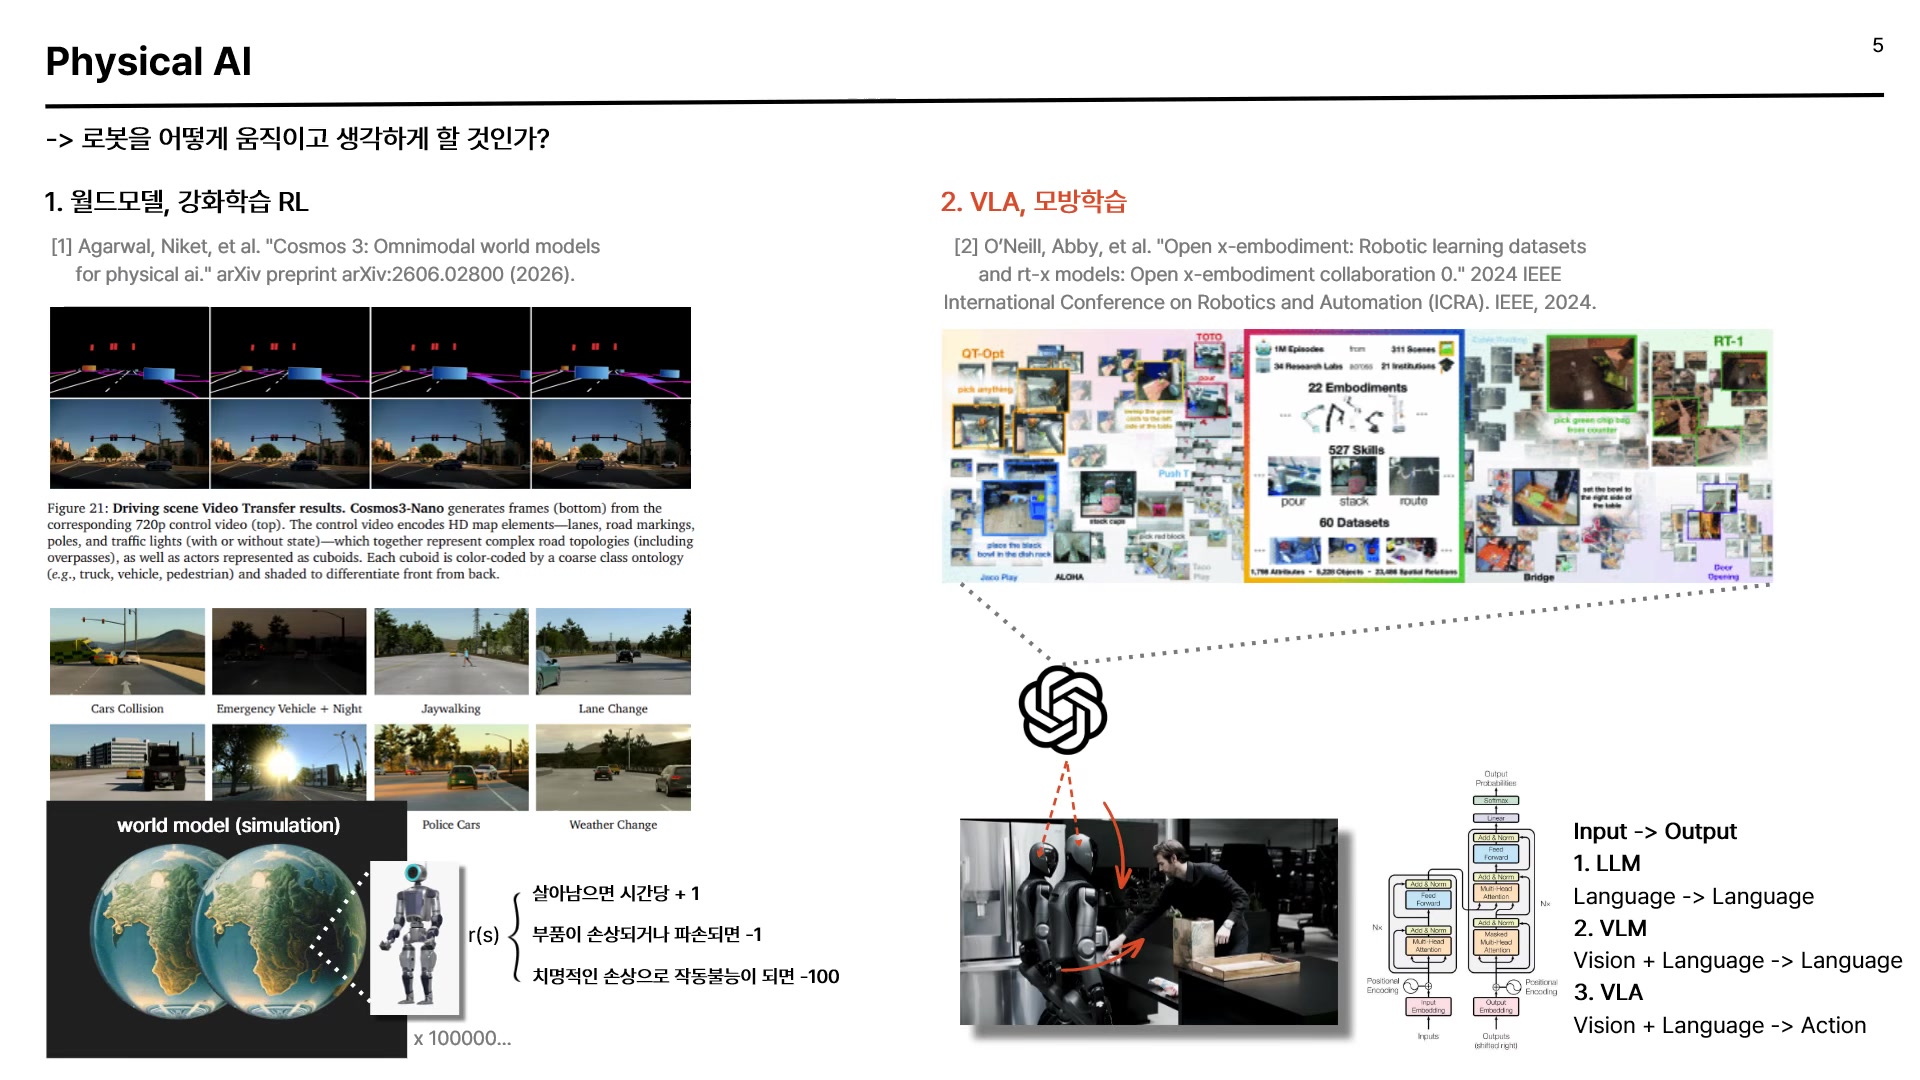
| ① 월드모델 + 강화학습 | ② VLA + 모방학습 | |
|---|---|---|
| 핵심 아이디어 | 세상을 정교하게 시뮬레이션한 뒤, 그 안에 로봇을 수십만 대 올려놓고 생존 보상을 준다 | 방대한 로봇 데이터를 VLM에 넣어, 언어모델의 지능을 그대로 행동 출력으로 전이시킨다 |
| 학습 신호 | r(s) = 살아남으면 시간당 +1 / 부품 손상·파손 −1 / 작동불능 −100 |
정답 시연(동영상 + 관절값)에 대한 지도학습 |
| 대표 | NVIDIA | Google DeepMind, Physical Intelligence (π) |
| 기대 효과 | “세상에서 살아남는 법”을 스스로 습득 | 가르치지 않은 행동까지 수행하는 범용 정책 |
| 난점 | 정교한 월드모델 = 사실상 AGI. 현 연구는 “가능함을 보여주는 정도” | 로봇 데이터의 절대량 부족, 하드웨어 다양성 |
발표자의 평가
세상을 정교하게 시뮬레이션하는 월드모델을 만든다는 것은 사실상 AGI를 개발하겠다는 말과 거의 같다. 방향 자체가 매우 어렵고, 현재의 연구 결과들도 성능이 뛰어나다기보다 “이런 방식이 가능함을 보여주는 정도”에 그친다.
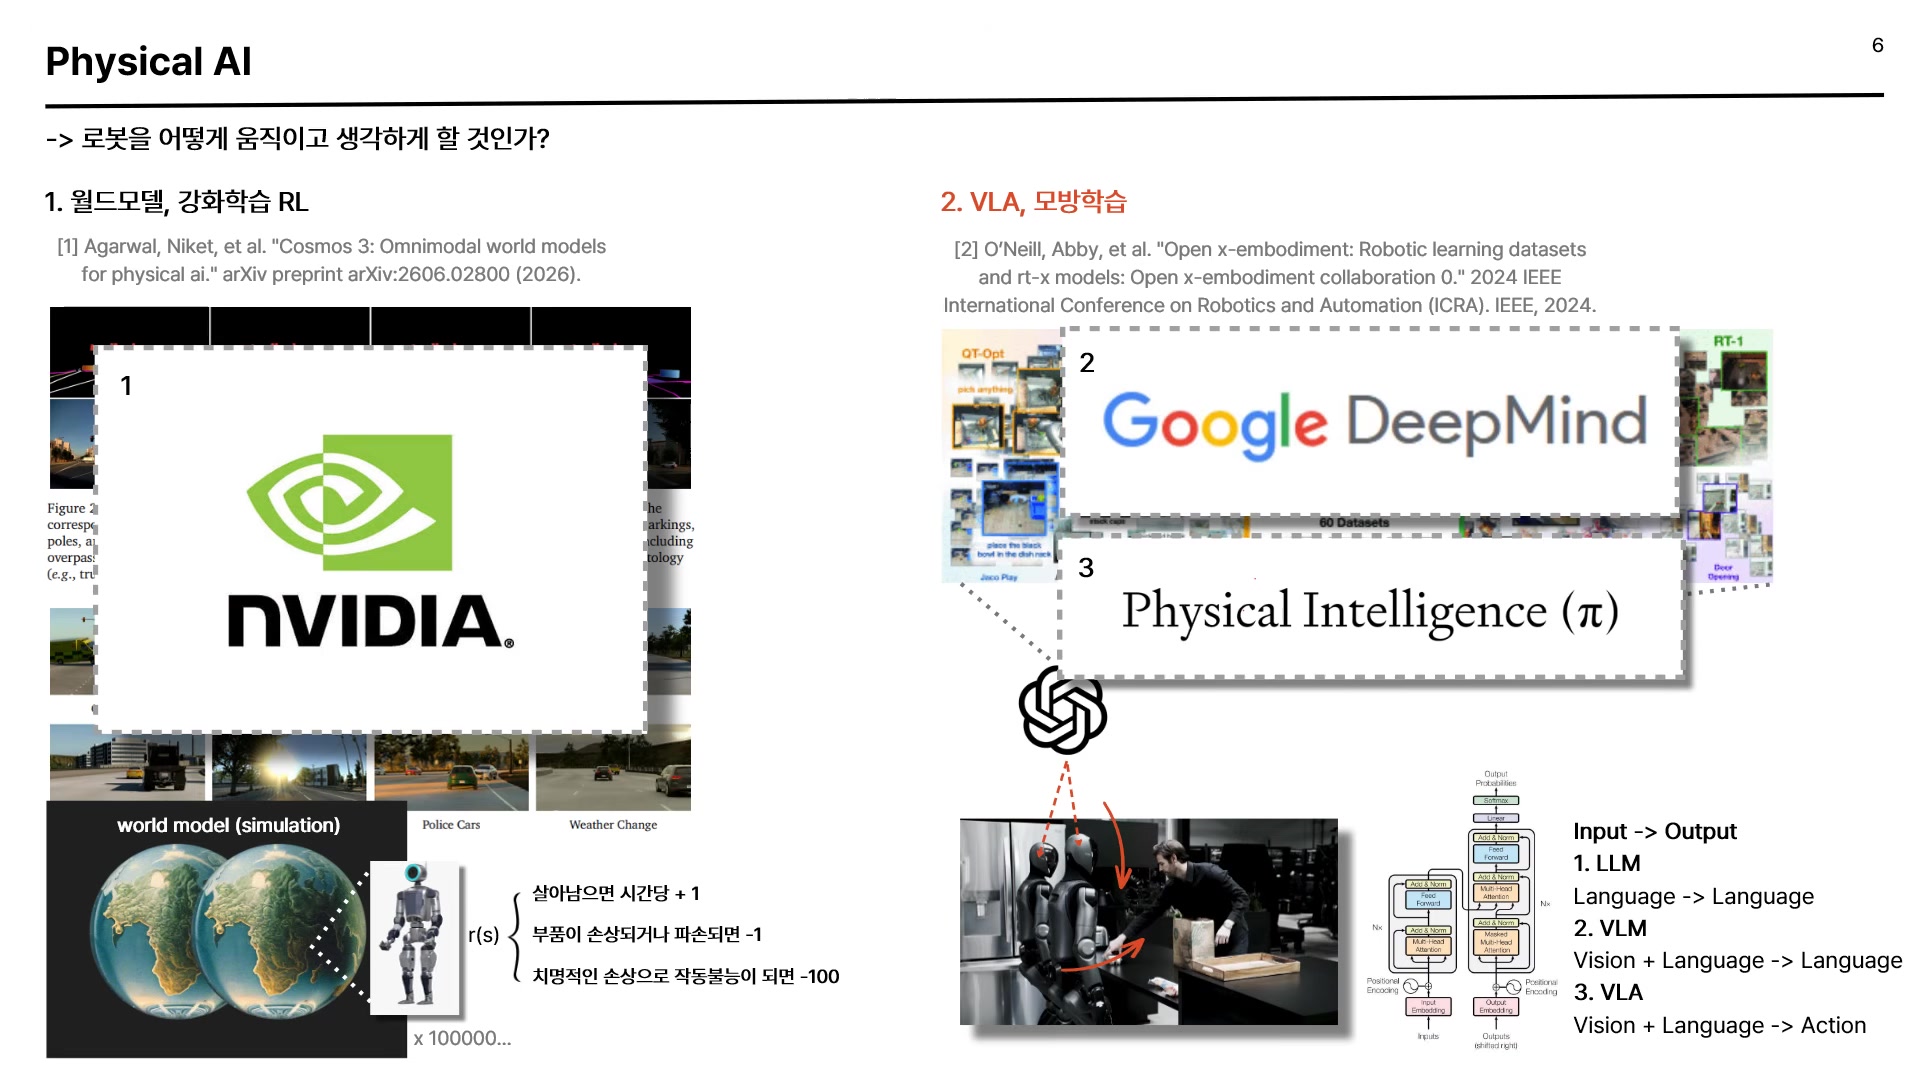
VLA는 어느 날 등장한 아이디어가 아니다. 입력에 시각을 더하고, 출력을 언어에서 행동으로 바꾼 아주 단순한 확장의 연속이었다.
2020 · GPT-3
LLM
Language → Language
2021 · CLIP
VLM
Vision + Language → Language
2022– · SayCan, RT-2, OpenVLA
VLA
Vision + Language → Action
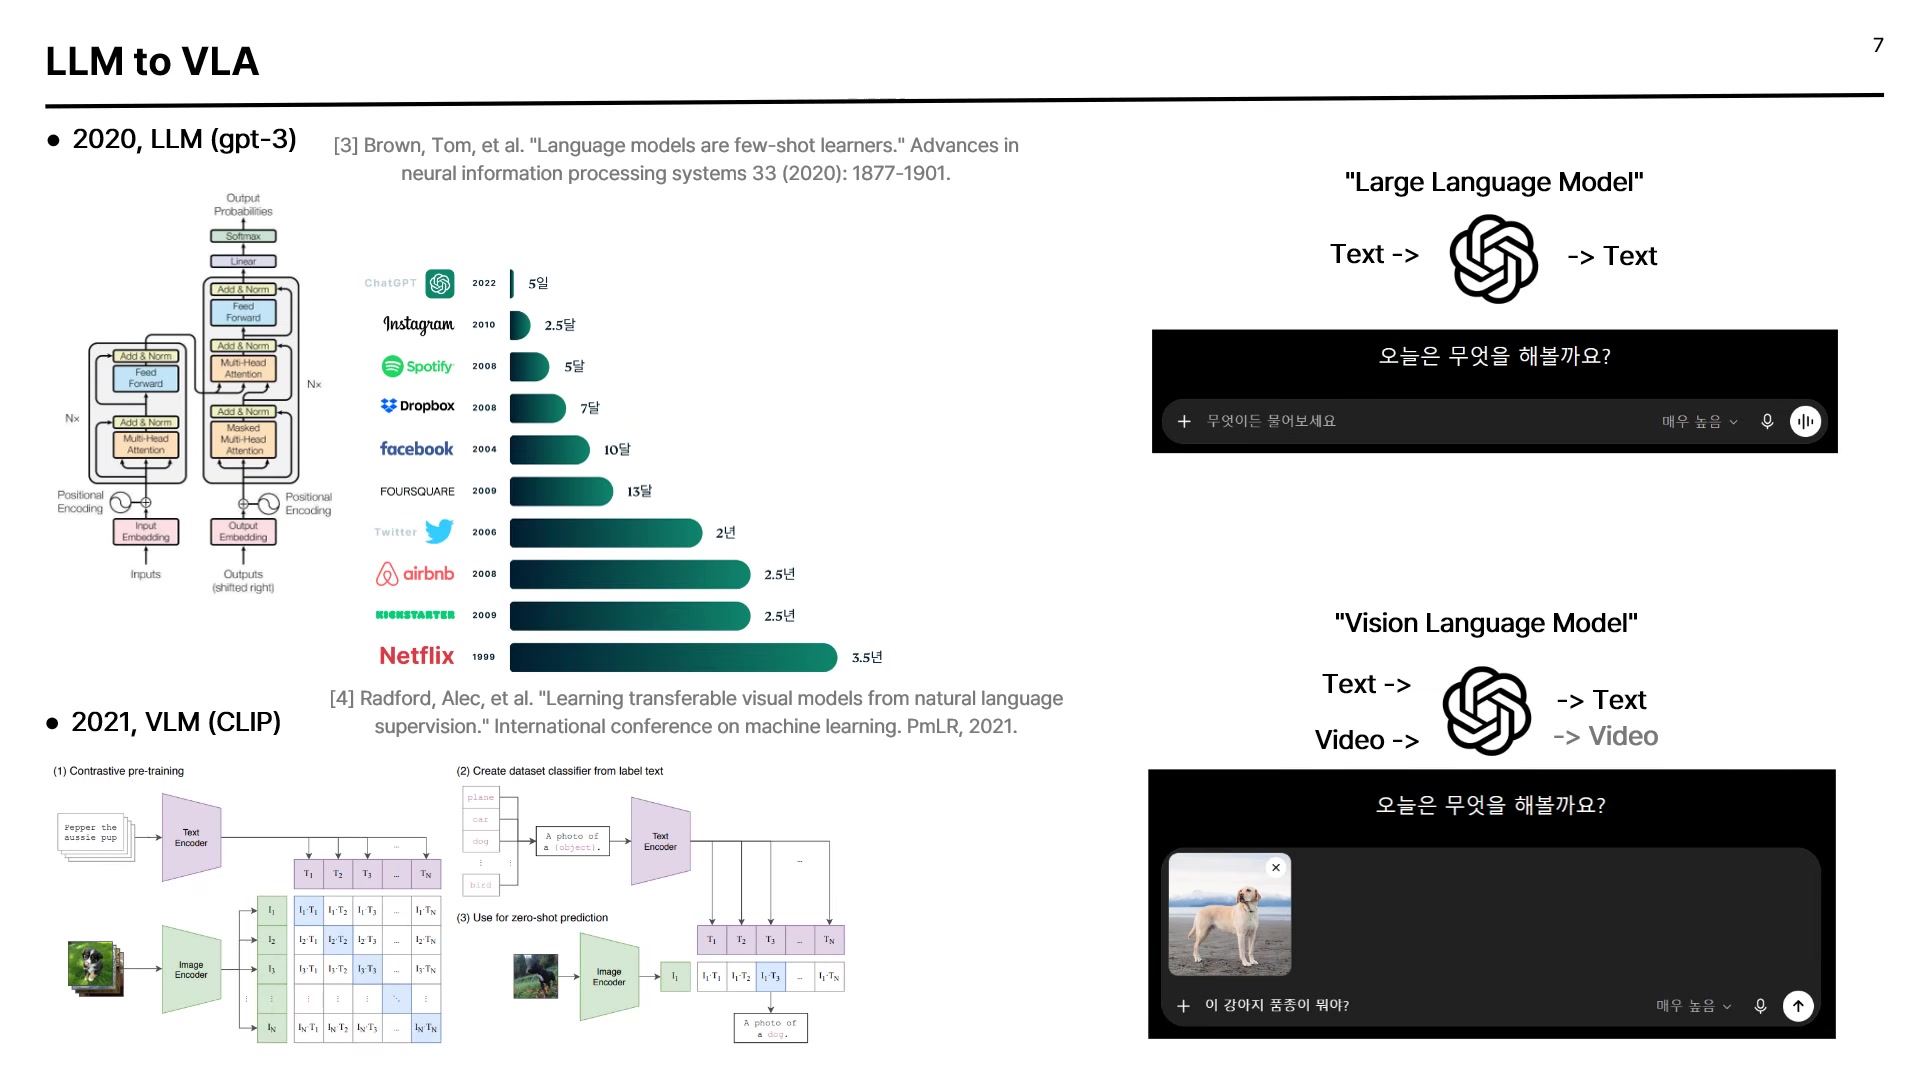
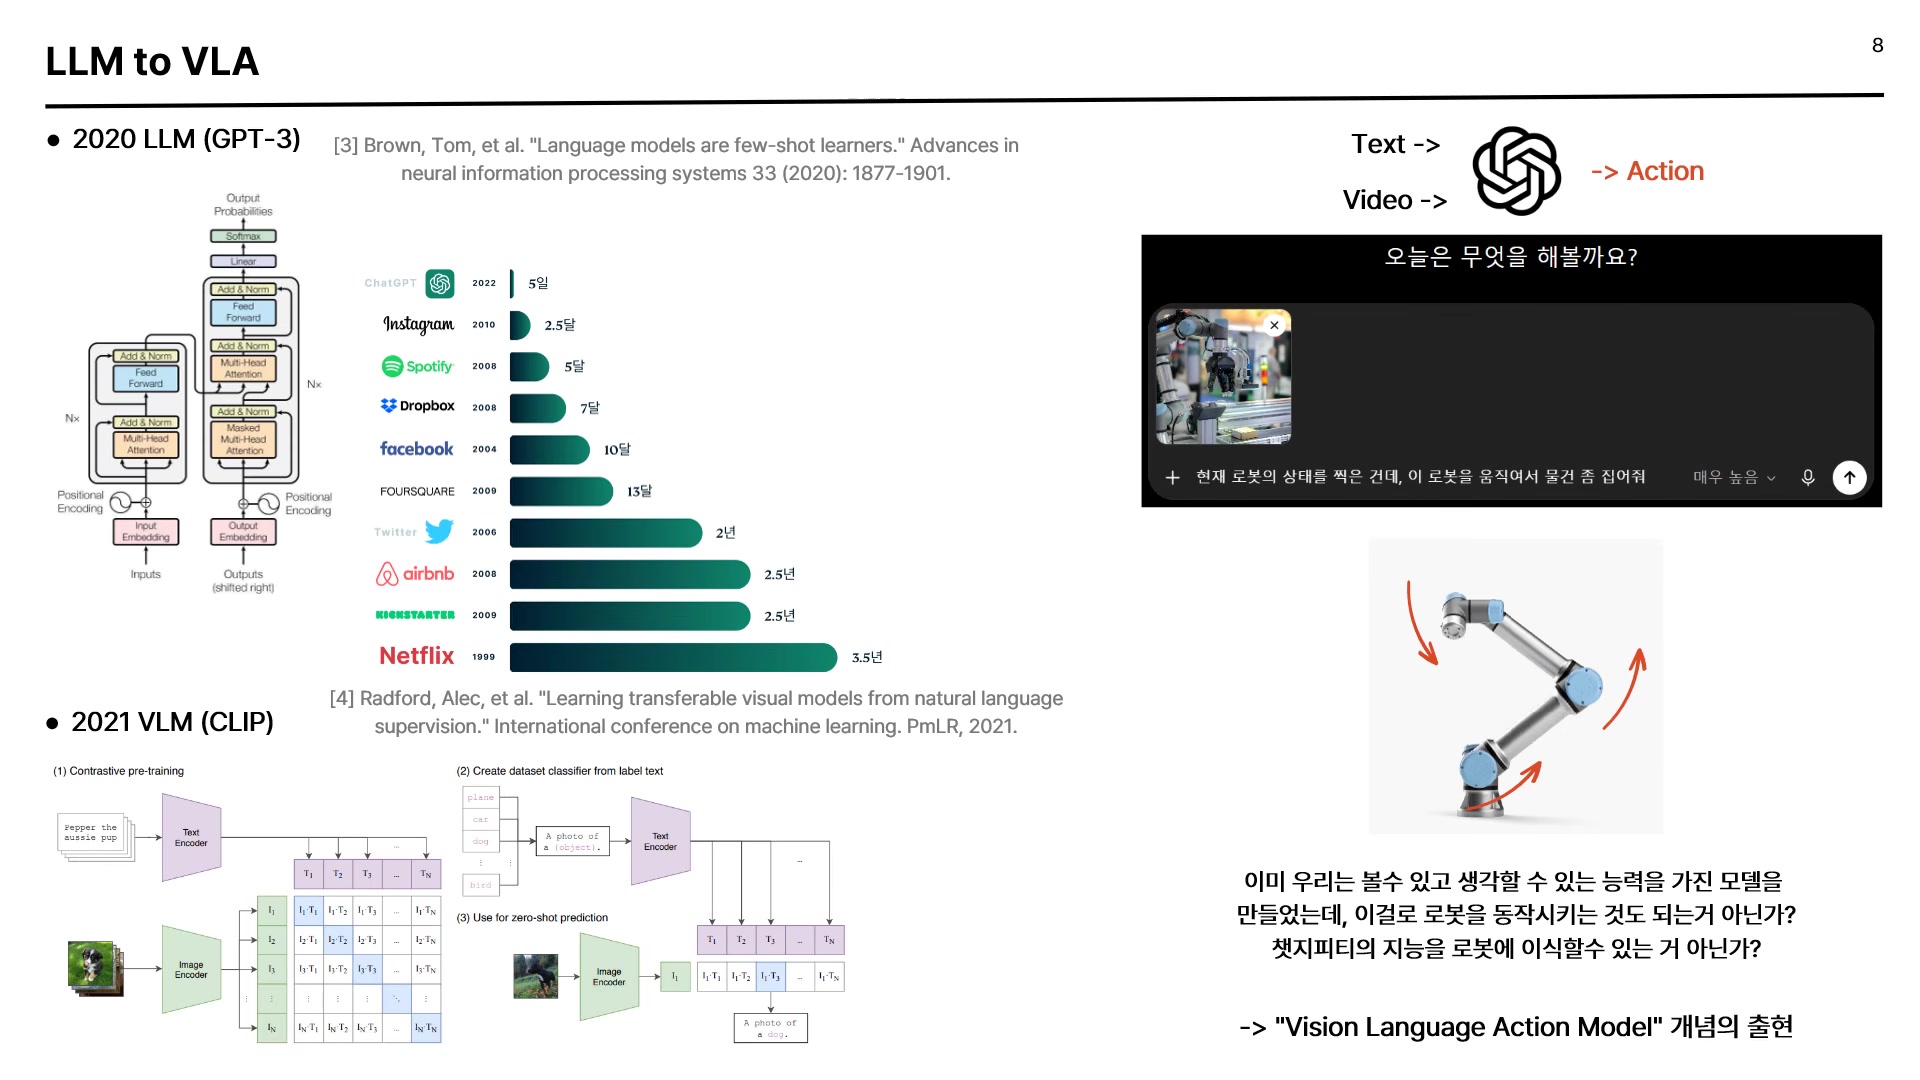
다음 슬라이드에서 우상단의 출력이 -> Action으로 바뀌고 로봇 팔 그림이 추가된다.
슬라이드에 적힌 문제의식은 놀랄 만큼 단순하다.
이미 우리는 볼 수 있고 생각할 수 있는 모델을 만들었는데, 이걸로 로봇을 동작시키는 것도 되는 게 아닌가? 챗GPT의 지능을 로봇에 이식할 수 있는 게 아닌가?— “Vision Language Action Model” 개념의 출현
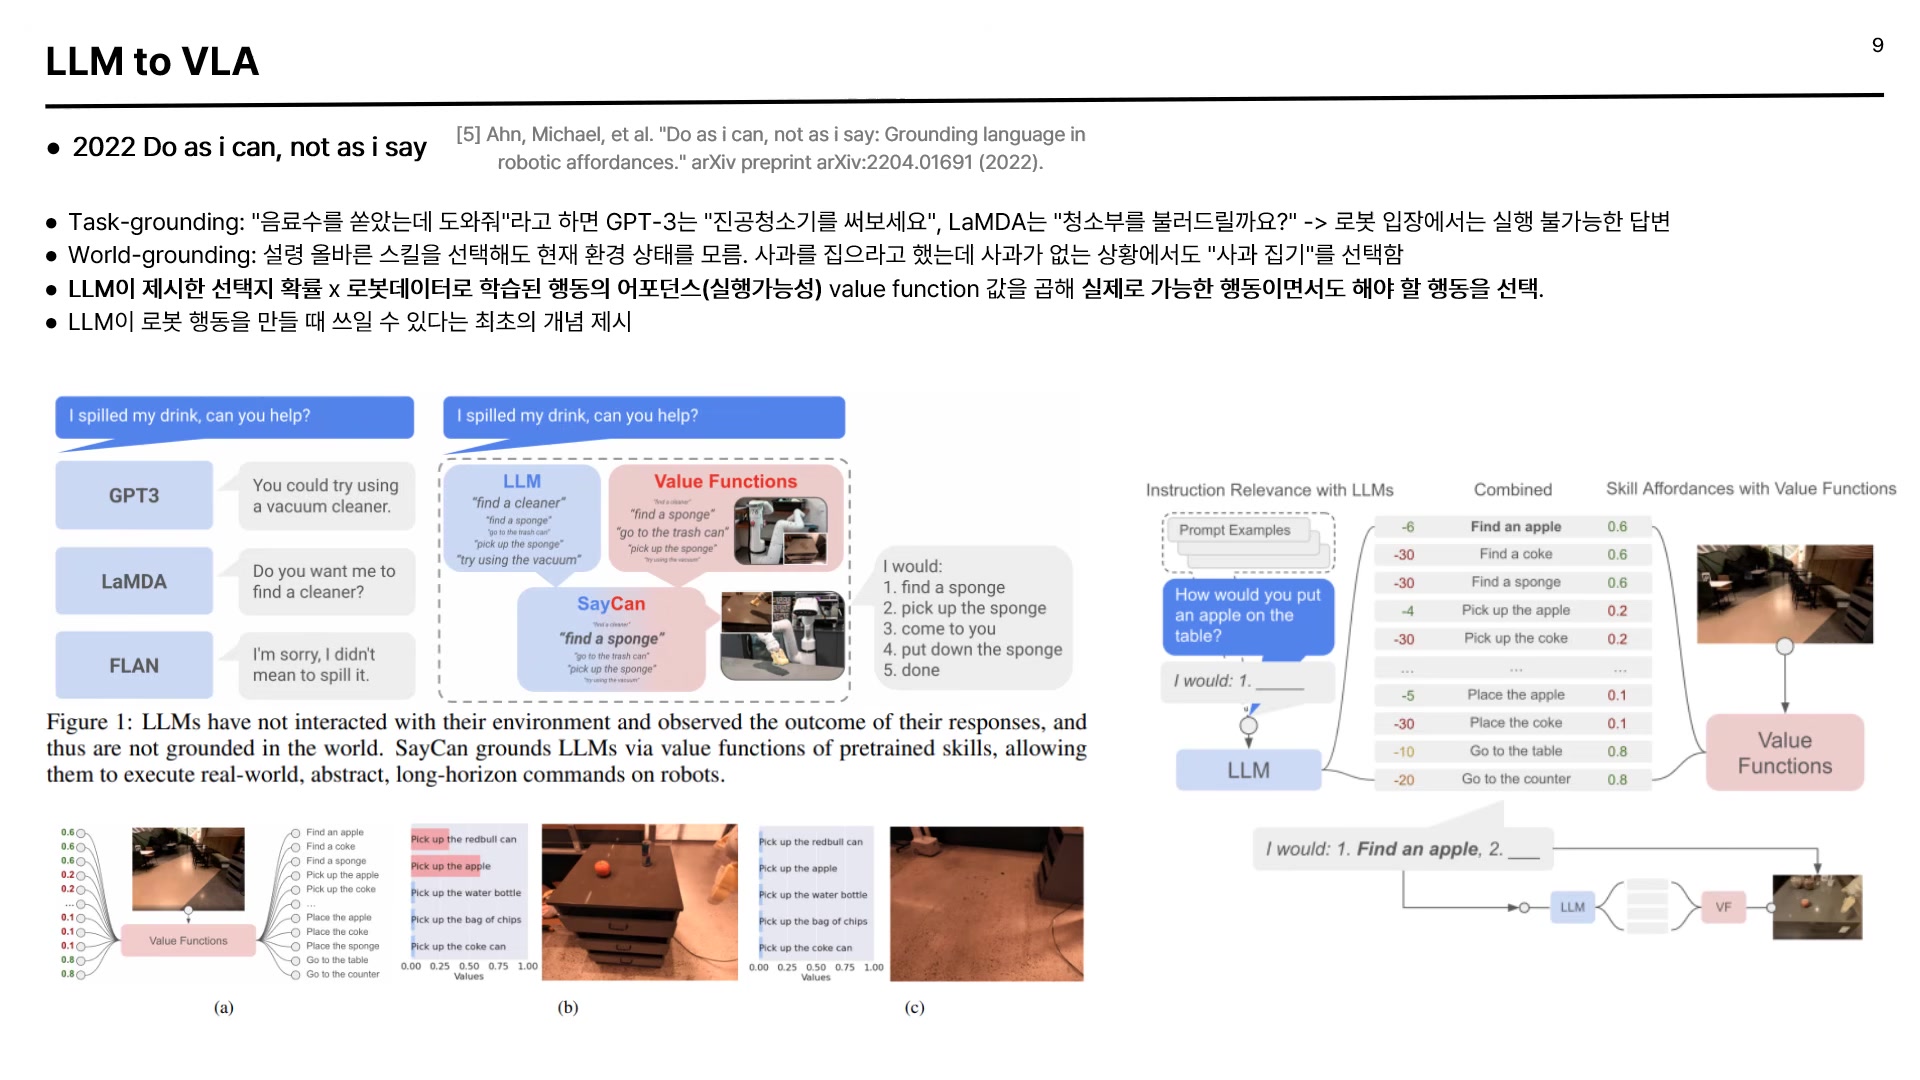
언어모델을 로봇에 붙이자마자 벽에 부딪힌다. “음료수를 쏟았는데 도와줘”라는 입력에 GPT-3는 “진공청소기를 써보면?”이라 답하고, LaMDA는 “청소부를 불러드릴까요?”라고 답한다. 언어적으로는 흠잡을 데 없지만, 로봇 입장에서는 실행할 수 없는 문장이다.
Do as I can, not as I say(Ahn et al., 2022)의 해법은 문제를 둘로 쪼개는 것이었다. Task-grounding(맥락상 해야 할 일인가)과 World-grounding(물리적으로 할 수 있는 일인가). LLM이 제시한 선택지의 확률에, 로봇이 실제로 그 행동을 수행할 수 있는지를 나타내는 Value Function(실행가능성) 값을 곱한다. 두 조건을 모두 만족하는 행동만 선택된다.
LLM 연구에서 얻은 두 가지 경험칙이 VLA에 그대로 가설로 이식된다. 하나는 Kaplan et al.의 스케일링 법칙 — 계산량·데이터셋 크기·파라미터 수에 대해 테스트 손실이 멱법칙으로 감소한다. 다른 하나는 Wei et al.의 창발 능력 — 일정 규모를 넘으면 가르친 적 없는 능력이 급격히 발현된다.
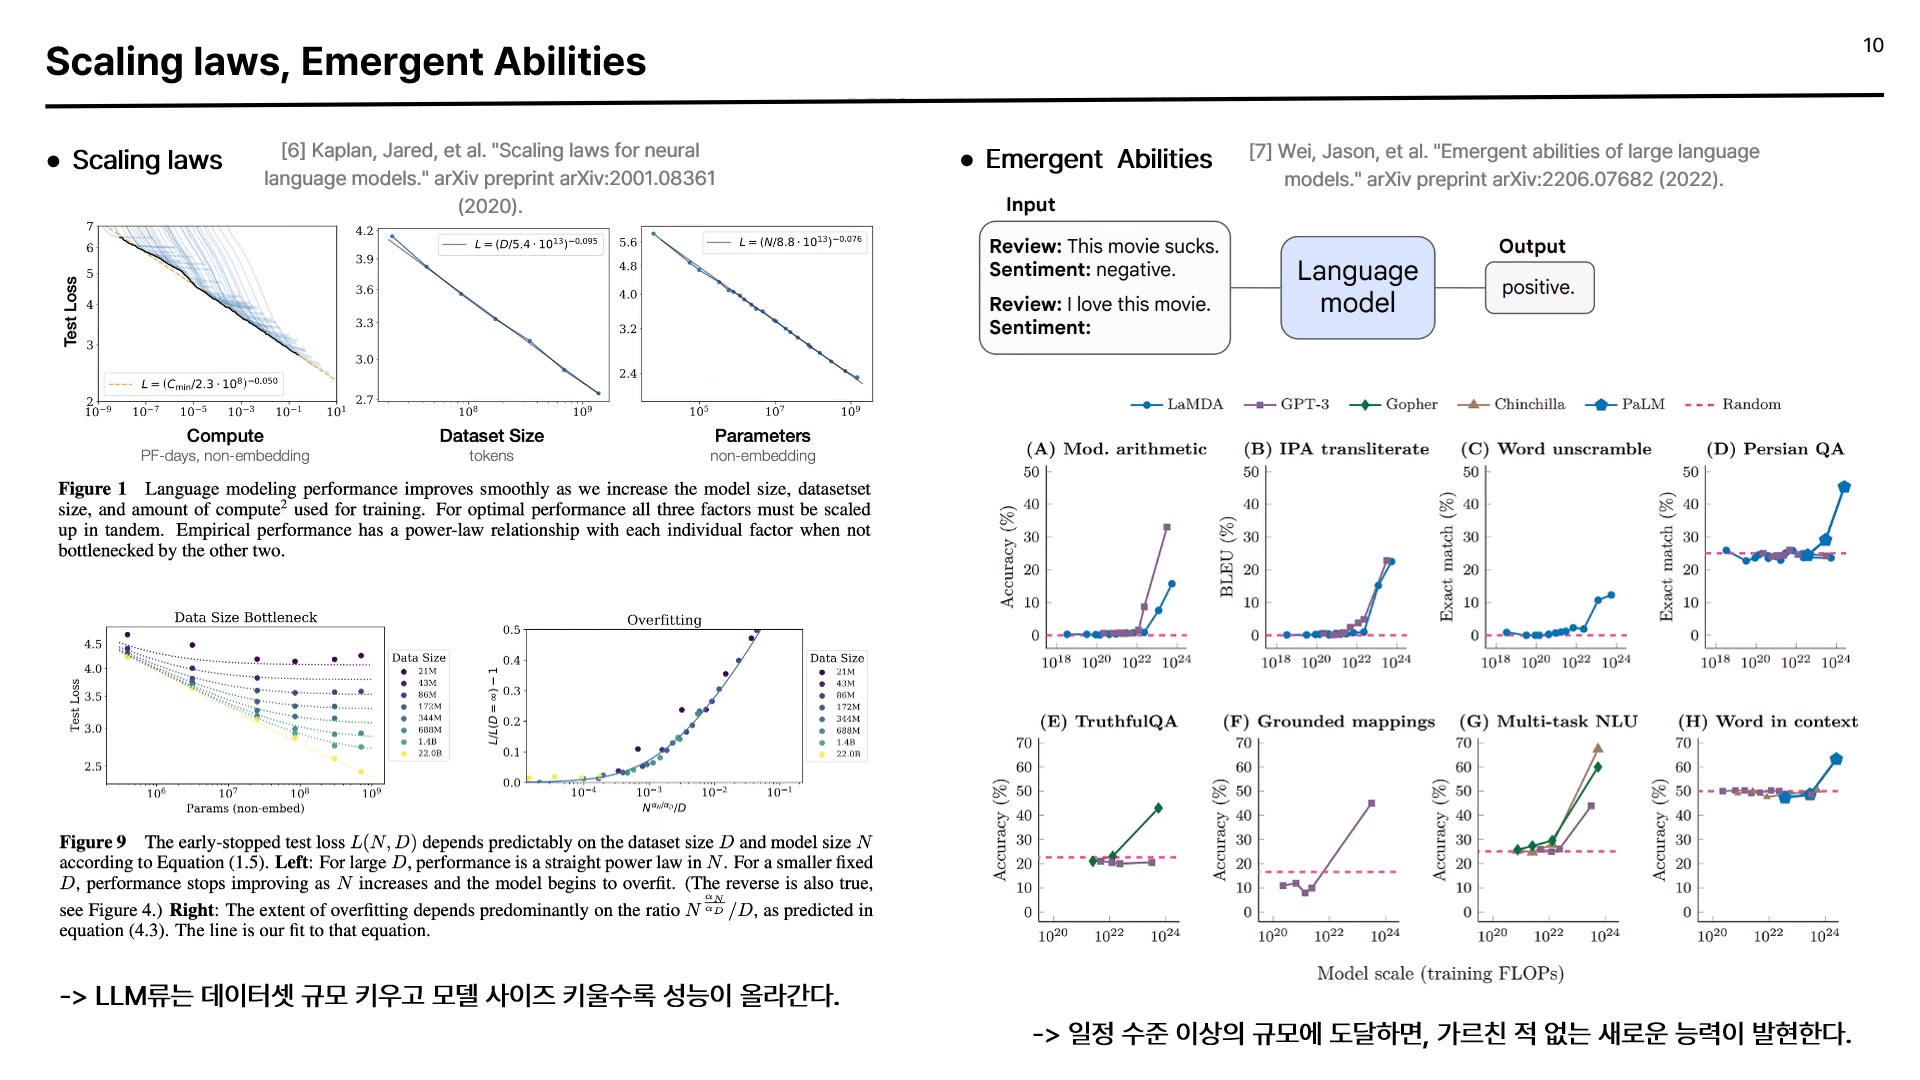
결론은 단순한 삼단논법이 된다. LLM류는 규모를 키울수록 좋아진다 → 규모가 임계를 넘으면 새 능력이 나온다 → 그렇다면 로봇 데이터를 아주 많이 모아 VLM에 직접 넣어보자.
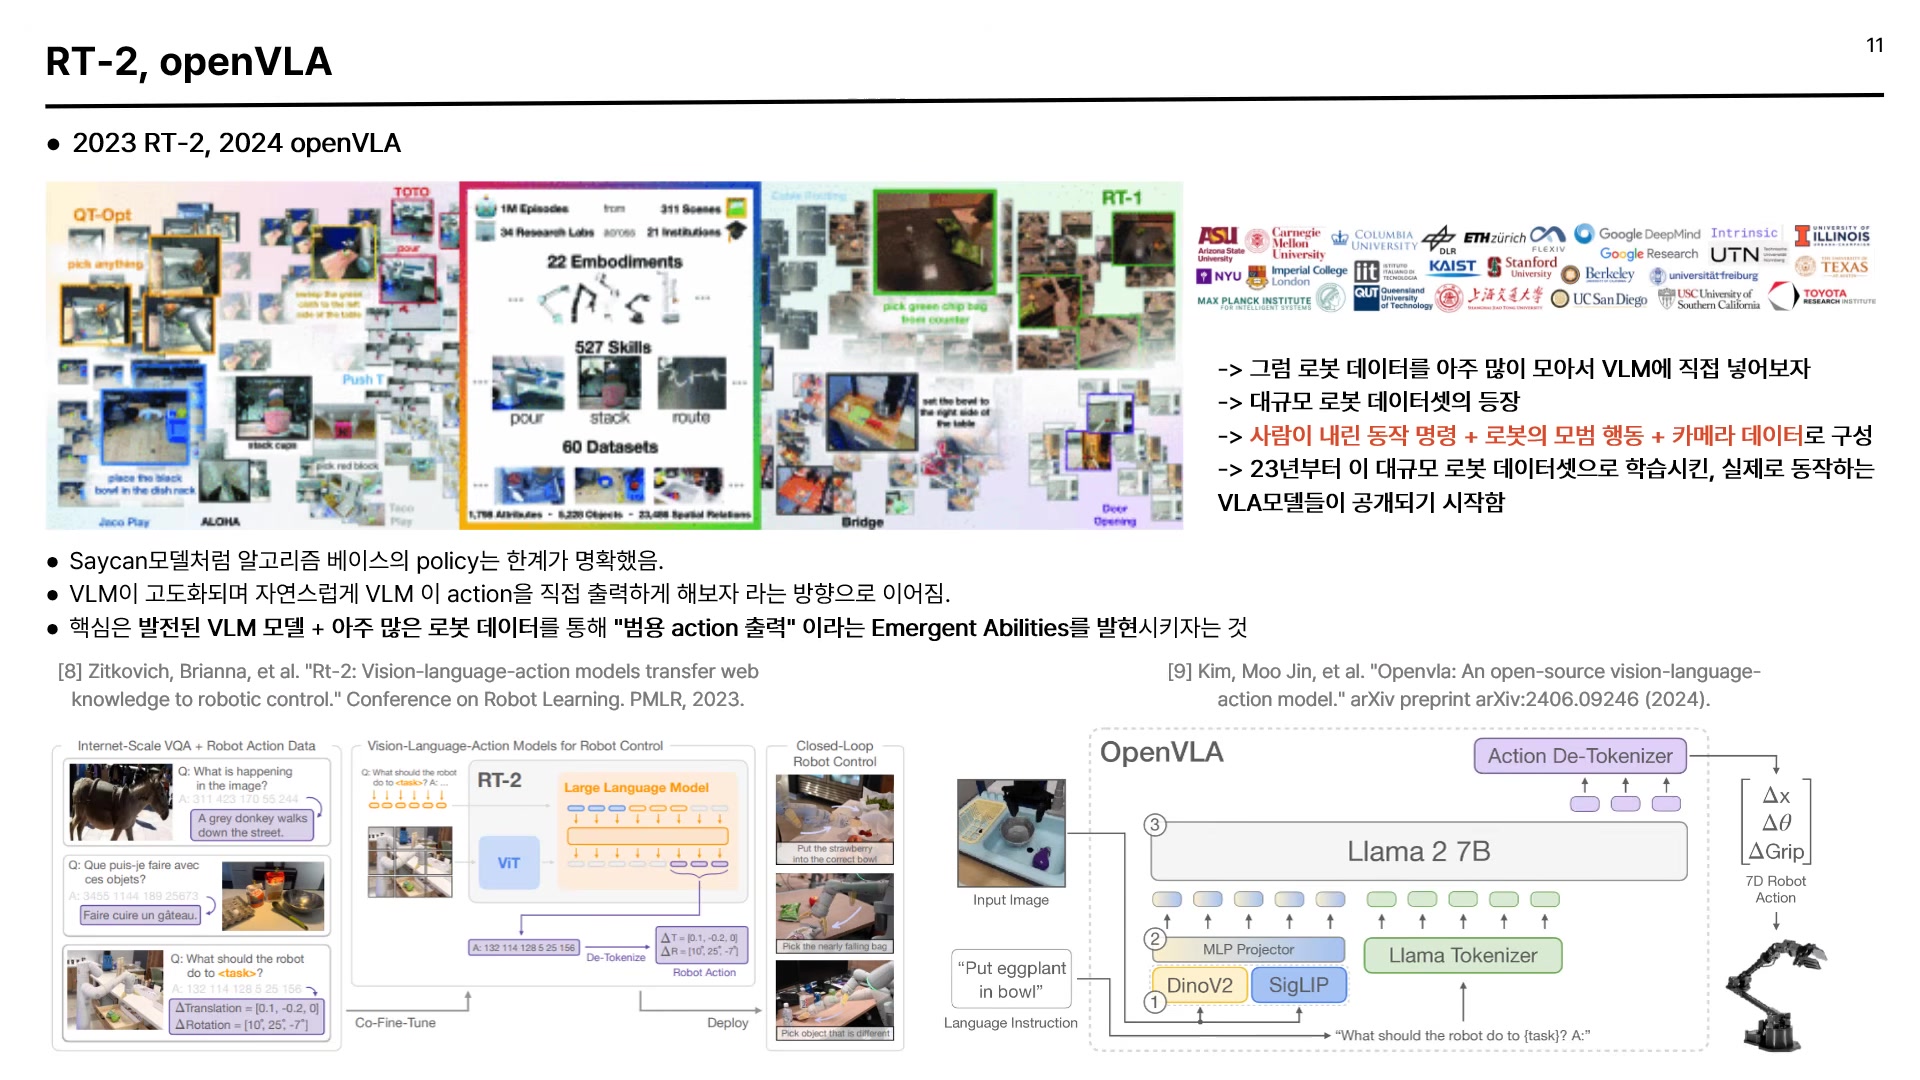
여러 기관의 로봇 데이터를 합친 대형 컬렉션 Open X-Embodiment가 등장한다. 구성은 사람의 동작 영상, 로봇의 모방 행동, 그리고 카메라 데이터다. 2023년부터 이 데이터셋으로 학습한, 실제로 동작하는 VLA 모델들이 공개되기 시작한다 — RT-2(Zitkovich et al., 2023)와 OpenVLA(Kim et al., 2024).
로봇 데이터란 무엇인가
명령을 올바르게 수행하는 로봇을 촬영한 동영상 + 그때 녹화된 관절값의 쌍이다. VLA는 매 순간의 이미지 프레임과 사용자 명령을 받아 바로 다음 순간의 정답 행동을 출력하며, 명령을 완수할 때까지 이 추론을 계속 반복한다.
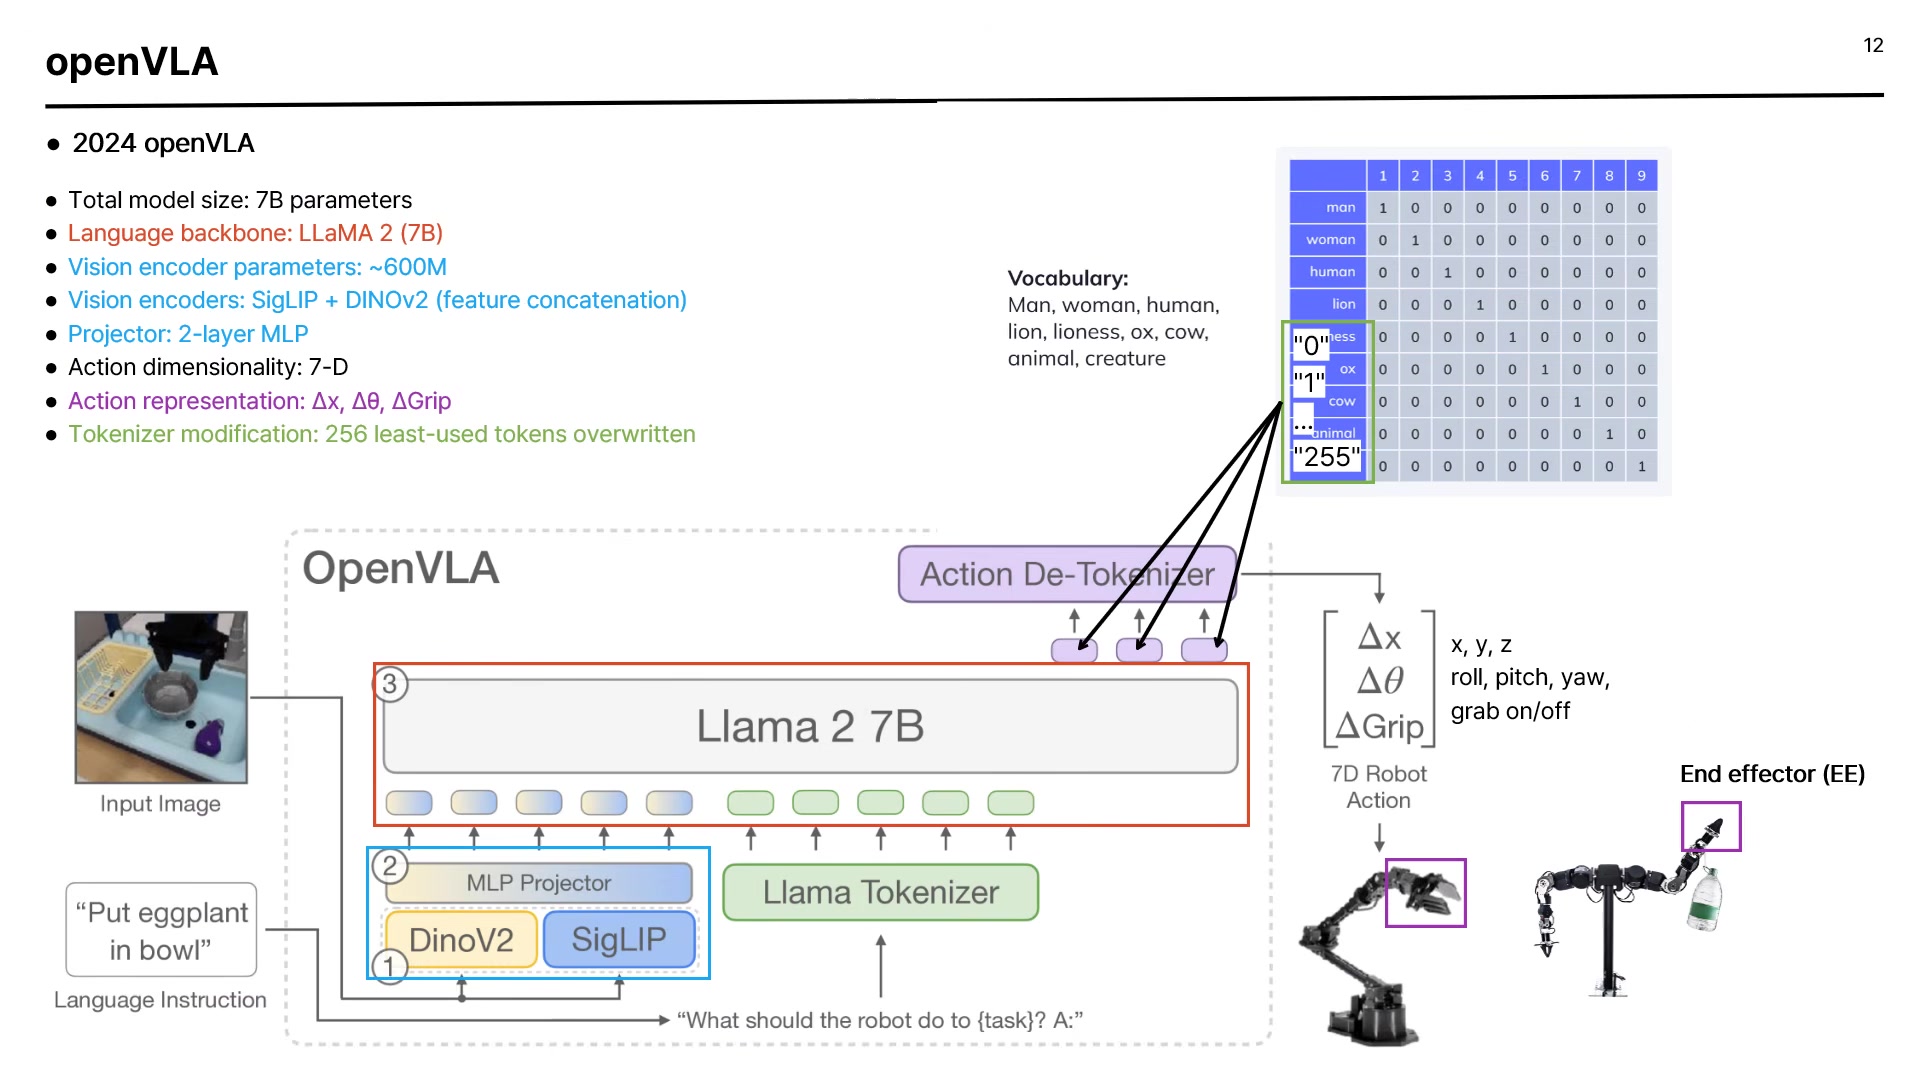
OpenVLA가 특별한 이유는 성능만이 아니다. 구조와 가중치가 모두 공개되어 변형과 응용이 쉬웠다. 이 모델을 기점으로 VLA 연구 물량이 폭발적으로 늘었다.
| 항목 | 값 |
|---|---|
| Total model size | 7B parameters |
| Language backbone | LLaMA 2 (7B) |
| Vision encoders | SigLIP + DinoV2 (feature concatenation) |
| Vision encoder parameters | ~600M |
| Projector | 2-layer MLP |
| Action dimensionality | 7-D |
| Action representation | Δx, Δθ, ΔGrip |
| Tokenizer modification | 256 least-used tokens overwritten |
마지막 항목이 이 모델의 트릭이다. 어휘 토큰 중 가장 덜 쓰이는 256개를 덮어써서 단어 대신 0~255 사이의 숫자를 뱉게 만든다. 그 숫자를 De-Tokenizer로 풀면 7차원 엔드이펙터 행동이 된다. 언어모델의 몸통은 그대로 두고, 출력 어휘만 바꿔치기한 셈이다.
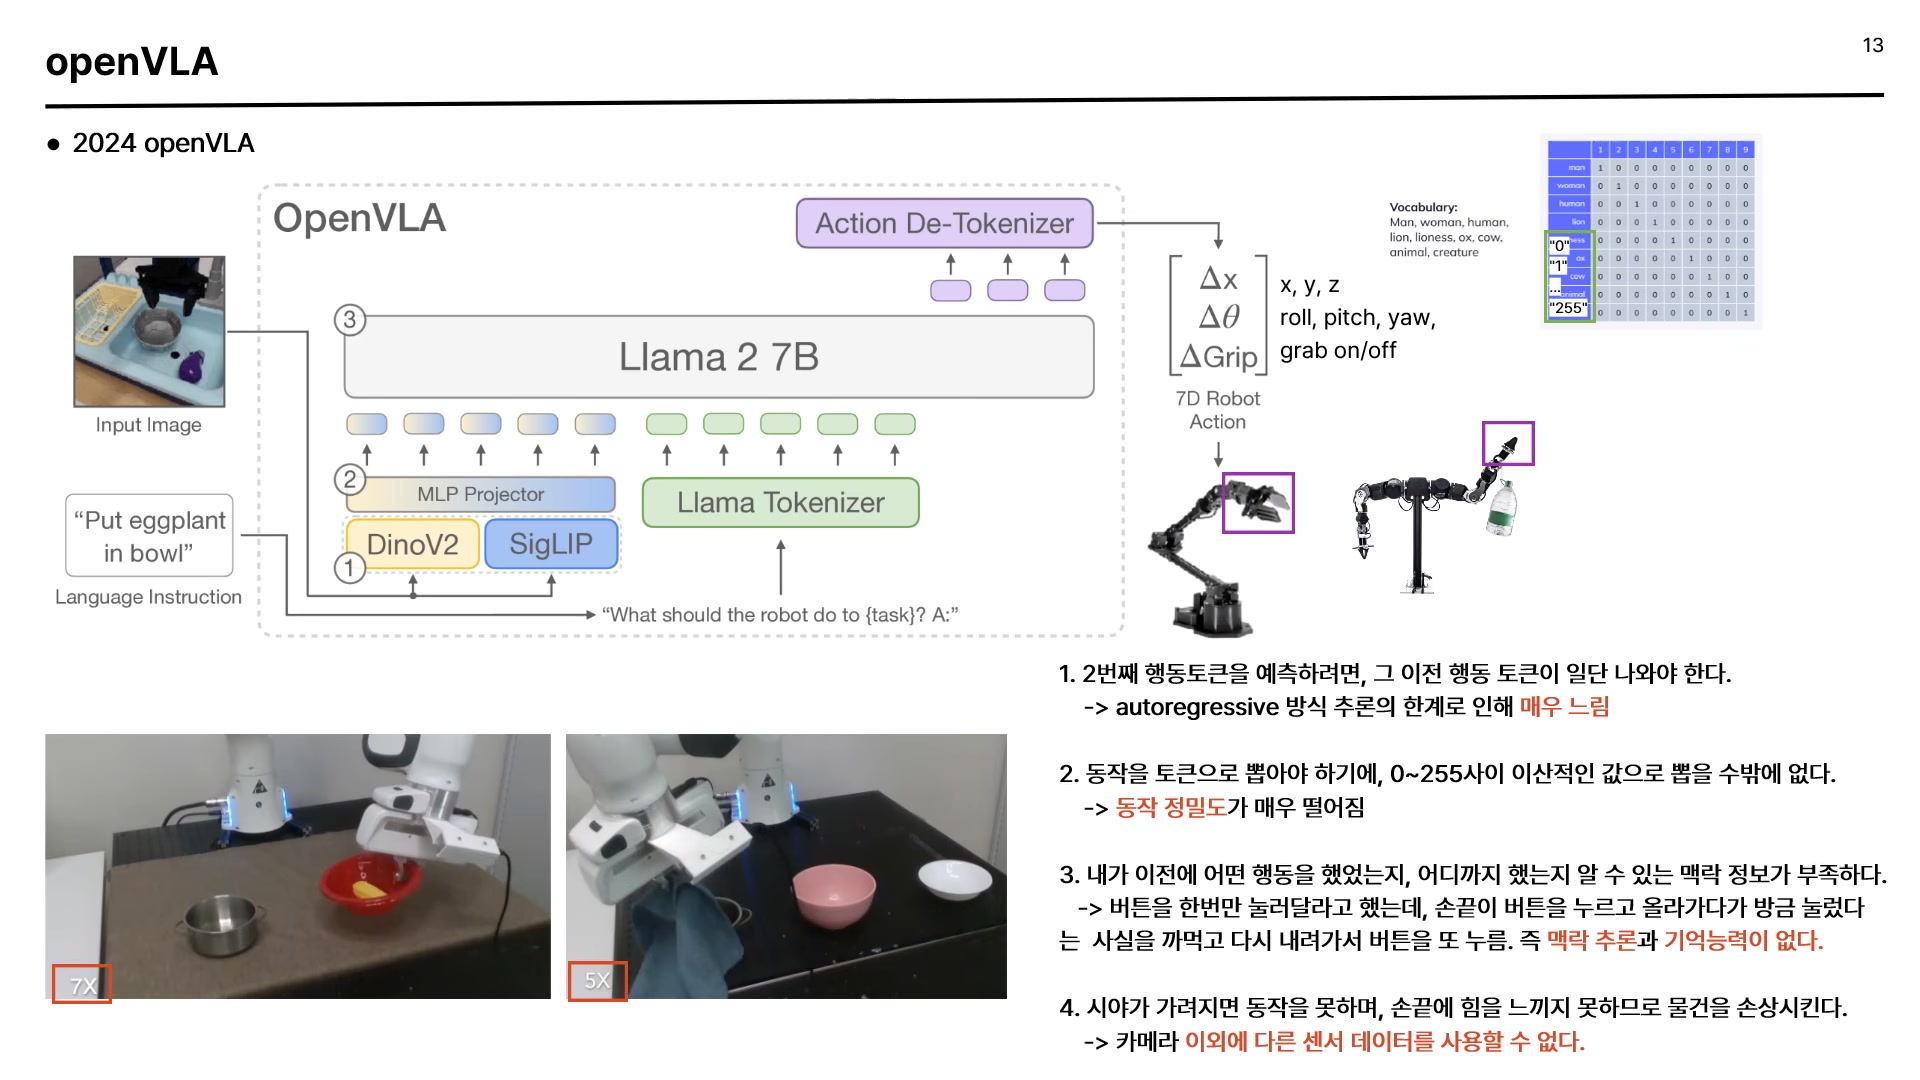
| # | 한계 | 원인 | 대응 방향 |
|---|---|---|---|
| 1 | 느리다 | autoregressive — 두 번째 행동 토큰을 예측하려면 첫 번째 토큰이 먼저 나와야 한다 | Action Expert / Action Chunk |
| 2 | 정밀도가 낮다 | 동작을 토큰으로 뽑아야 하고, 0~255의 이산 값으로만 표현된다 | Action Expert (연속값 예측) |
| 3 | 맥락 기억이 없다 | 누르러 내려갈 때와 누르고 올라갈 때의 사진이 비슷하다 — 기억이 없으면 필연적 오류 | Memory Module / CoT |
| 4 | 보이지 않으면 못 하고, 힘을 모른다 | 카메라 이외의 센서 데이터를 사용할 수 없다 | Tactile / Force 모달리티 |
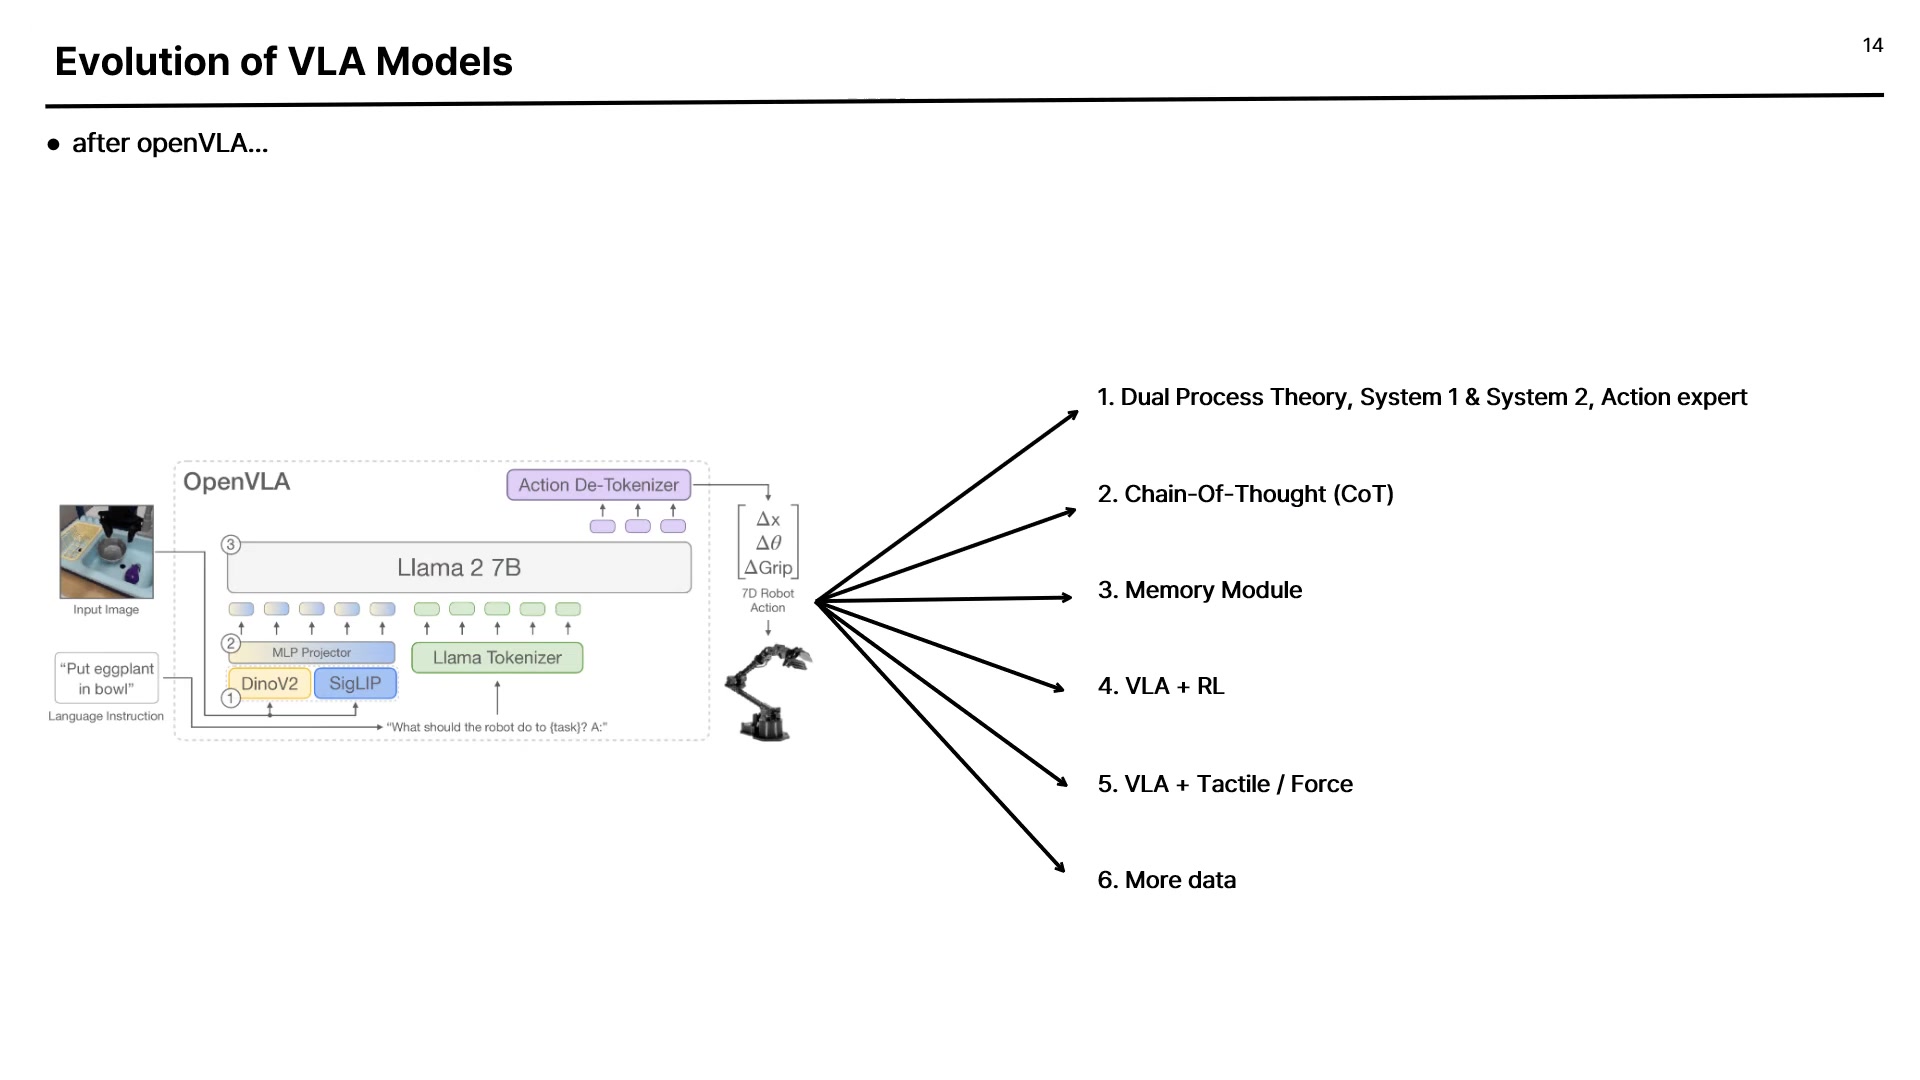
“Evolution of VLA Models — after openVLA…” 슬라이드에서 OpenVLA 구조로부터 여섯 개의 화살표가 뻗어 나온다. 각 화살표는 위 표의 한계 하나씩을 겨냥한다.
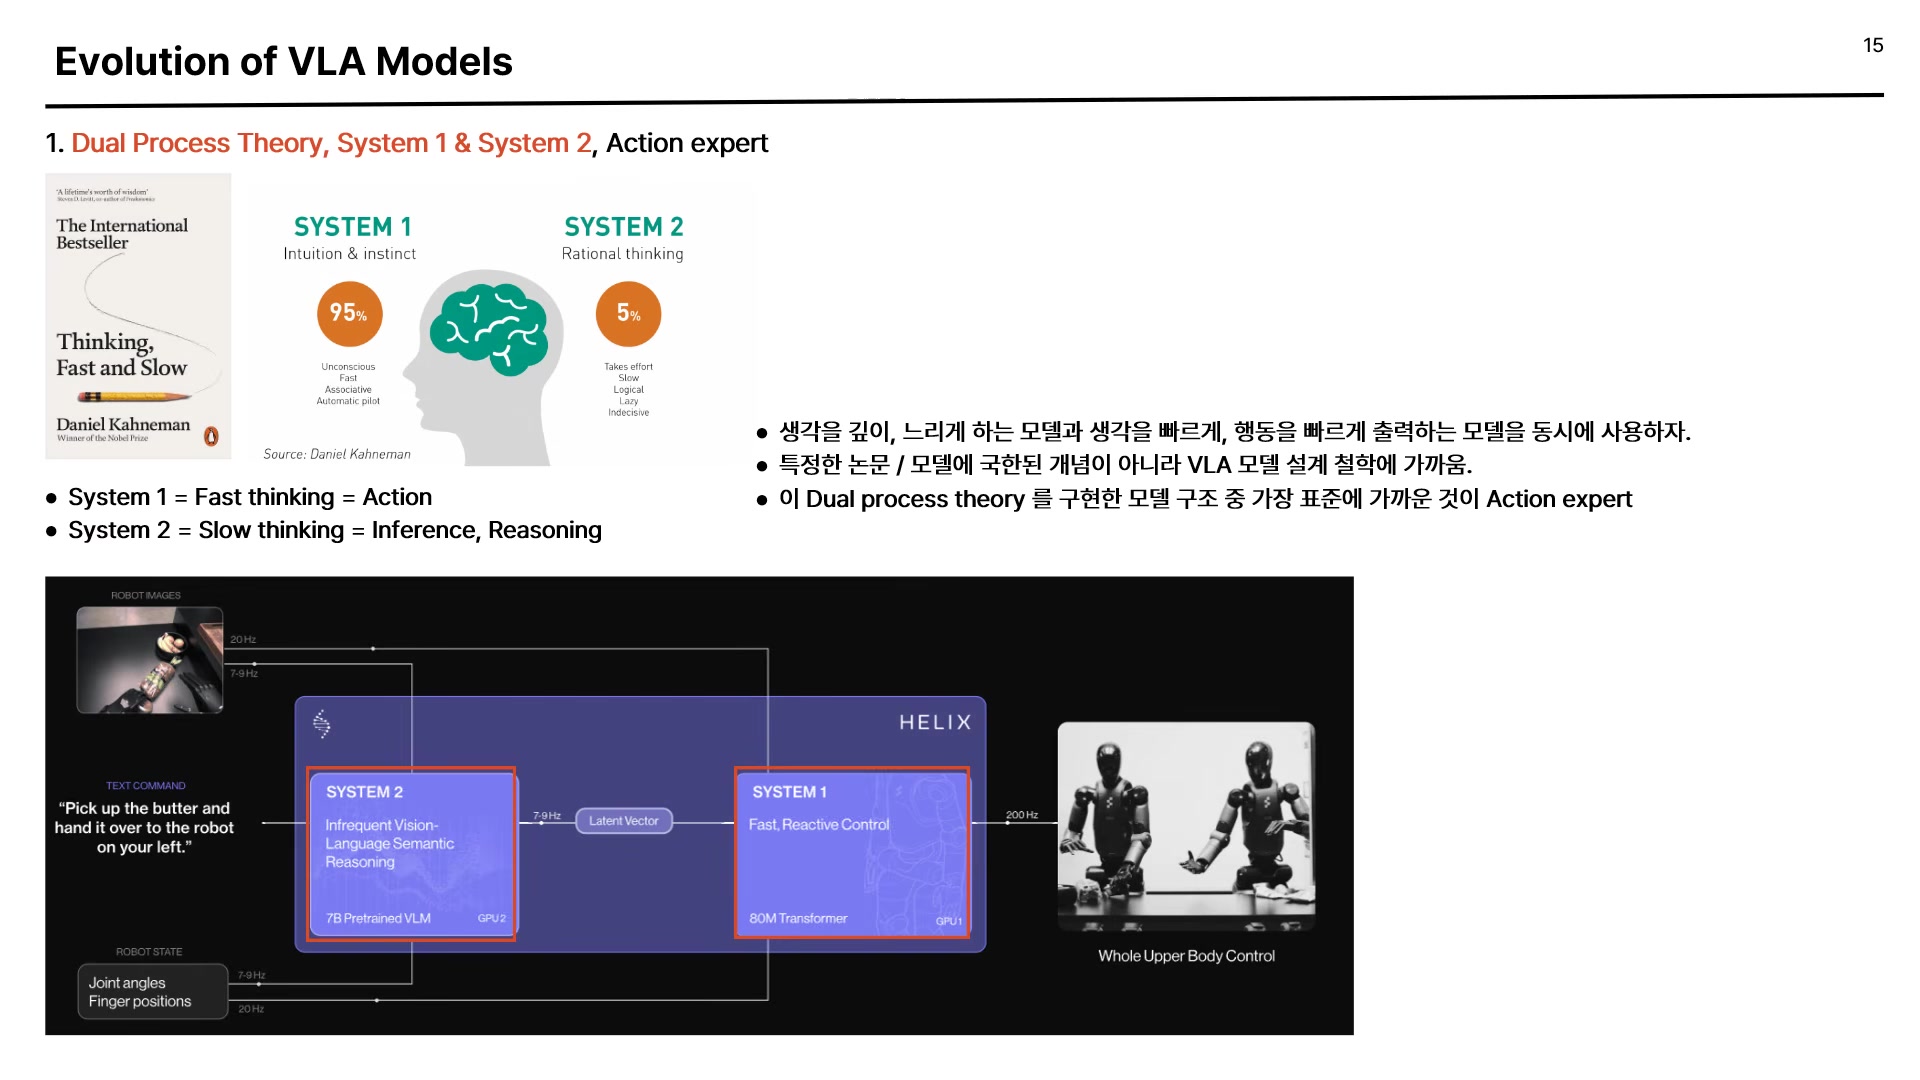
카너먼의 Thinking, Fast and Slow가 로봇 설계 철학으로 들어온다. System 1(Fast thinking = Action)과 System 2(Slow thinking = Inference, Reasoning)를 분리하는 것. Helix가 두 시스템을 실제로 분리한 구조를 보여준다 — “Pick up the butter and hand it over to the robot on your left.”
π0(Black et al., 2024, A Vision-Language-Action Flow Model for General Robot Control)은 이를 구체화한다. 사전학습 VLM 옆에 별도의 action expert 블록이 붙는다. 핵심 통찰은 이것이다 — 시간에 따른 연속 관절값을 Joint No. × Time의 2차원 표로 그리면 이미지 형태가 된다. 이미지라면 한 번에 예측할 수 있다. 그렇게 일정 구간의 액션을 통째로 뽑는 것이 action chunk다.
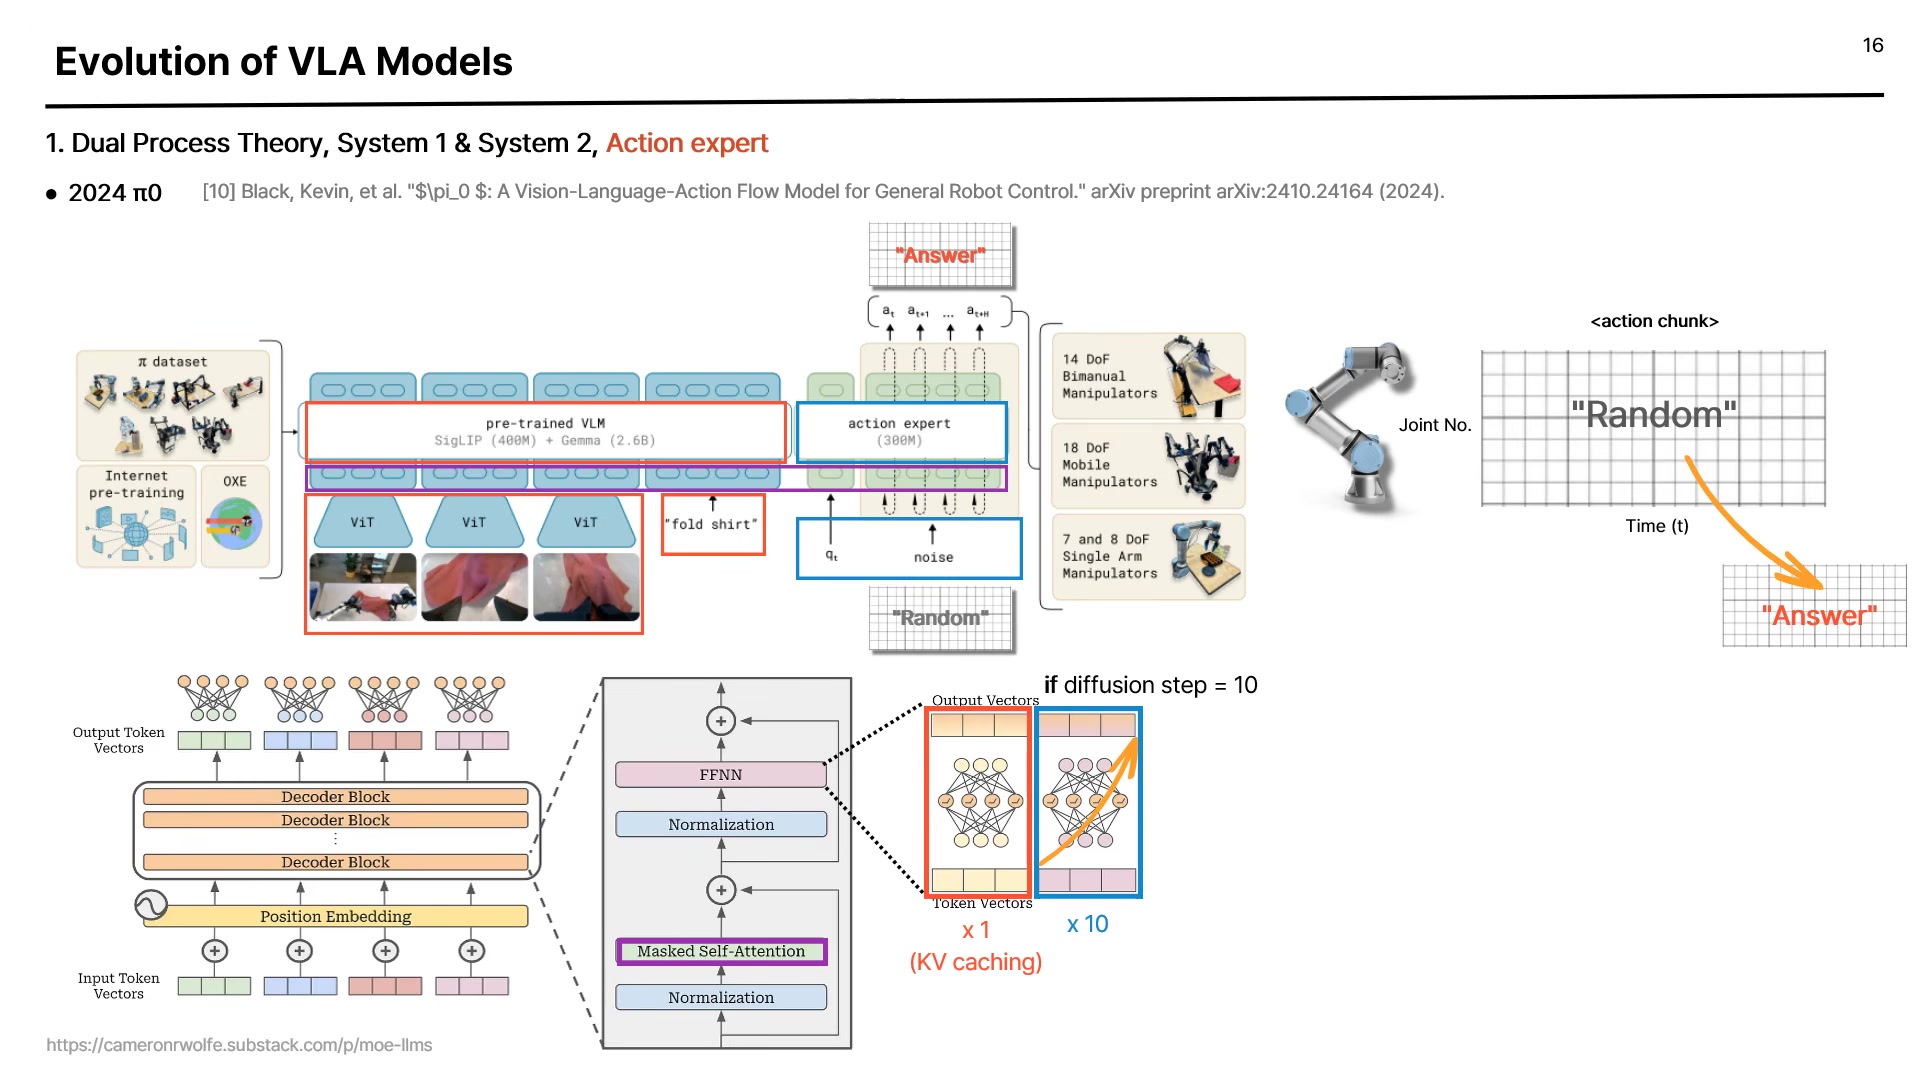
if diffusion step = 10, x1 (KV caching) / x10으로 갈라지는 흐름을 보여준다.
트랜스포머 내부 MLP층을 분리해 전체 모델보다 빠른 주파수로 돌리는 것이 action expert의 핵심이다.
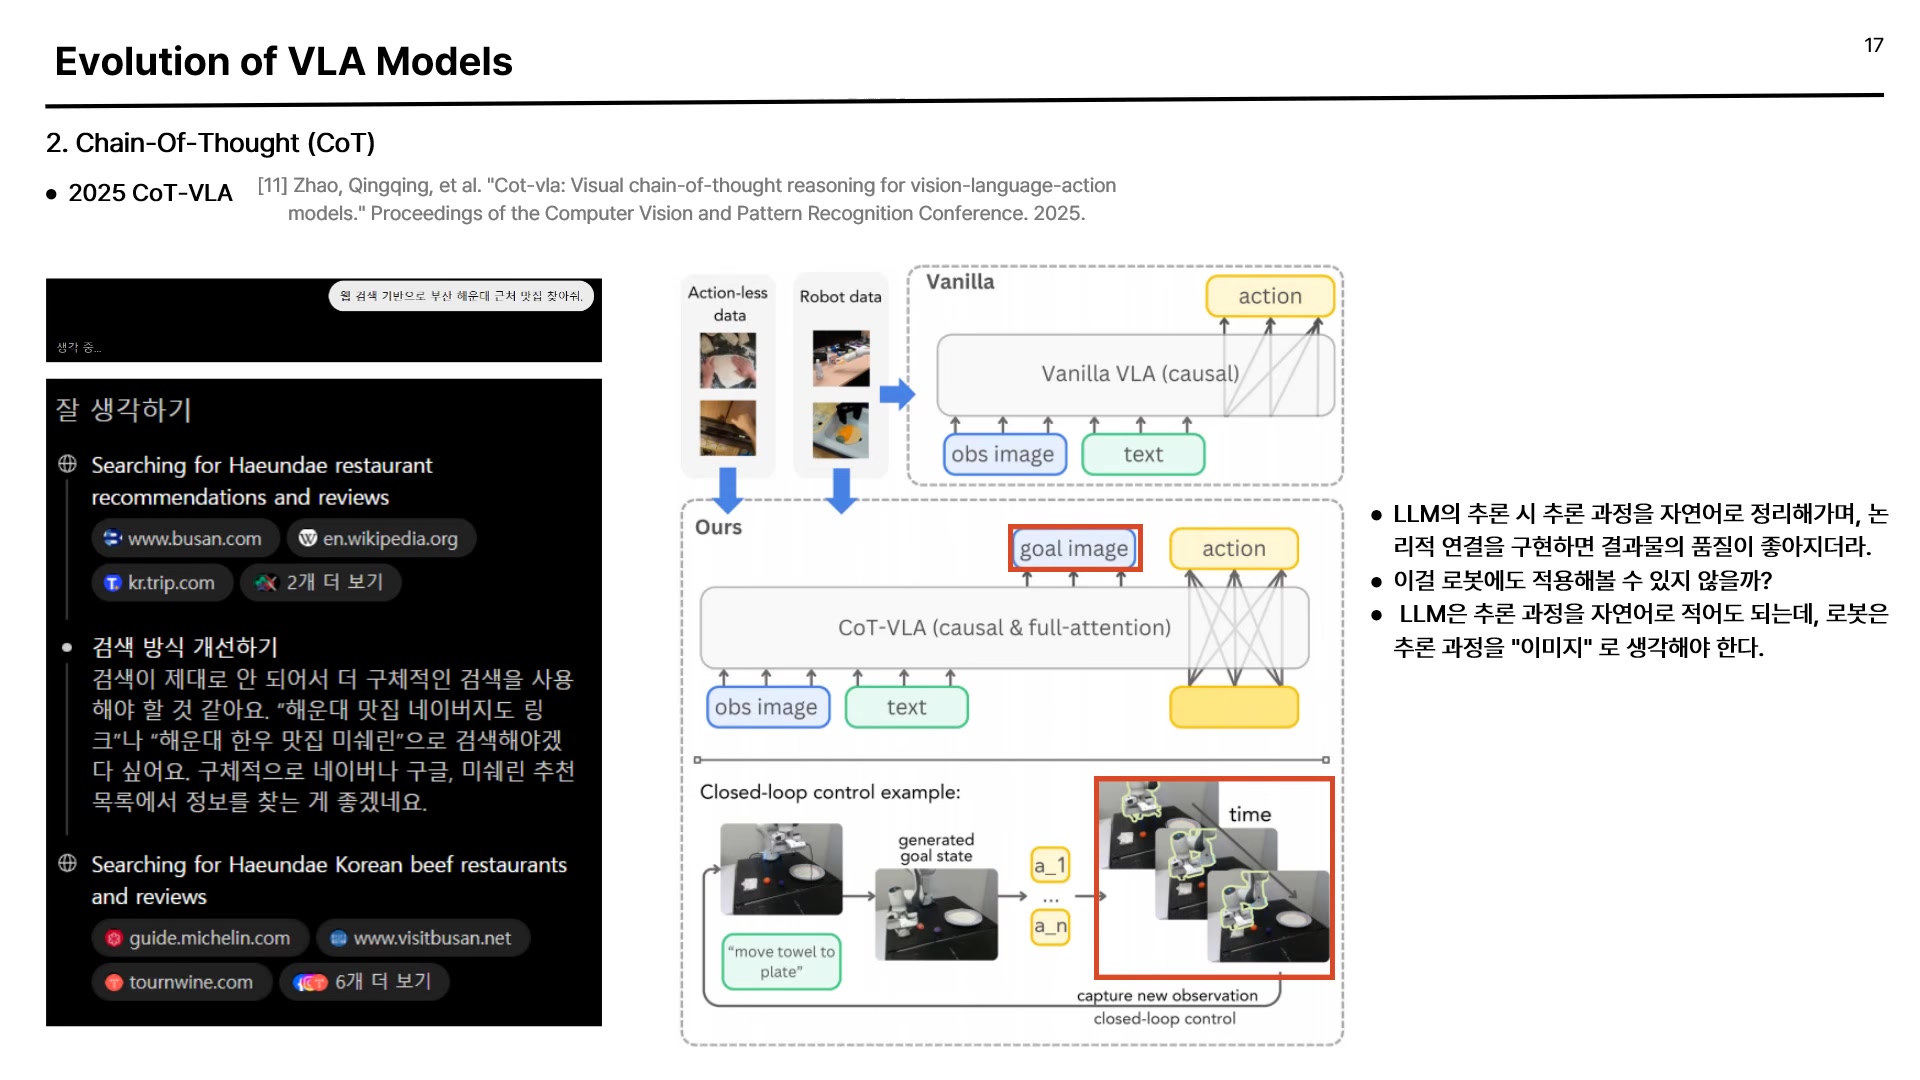
CoT-VLA(Zhao et al., CVPR 2025)의 출발점은 LLM의 사고 사슬이다. 그런데 그대로 옮길 수 없다. LLM은 추론 과정을 자연어로 적어도 되지만, 로봇의 출력은 액션이다. 중간 과정을 자연어로 적는 순간 정보 손실이 생긴다.
로봇은 추론 과정을 ‘이미지’로 생각해야 한다.— CoT-VLA 슬라이드 메모
구조적 차이는 명확하다. Vanilla VLA는 obs image + text에서 바로 action으로 간다. CoT-VLA는 중간에 goal image를 먼저 예측한다. 생성된 목표 상태를 기준으로 새 관측을 받아 반복하는 폐루프가 완성된다.
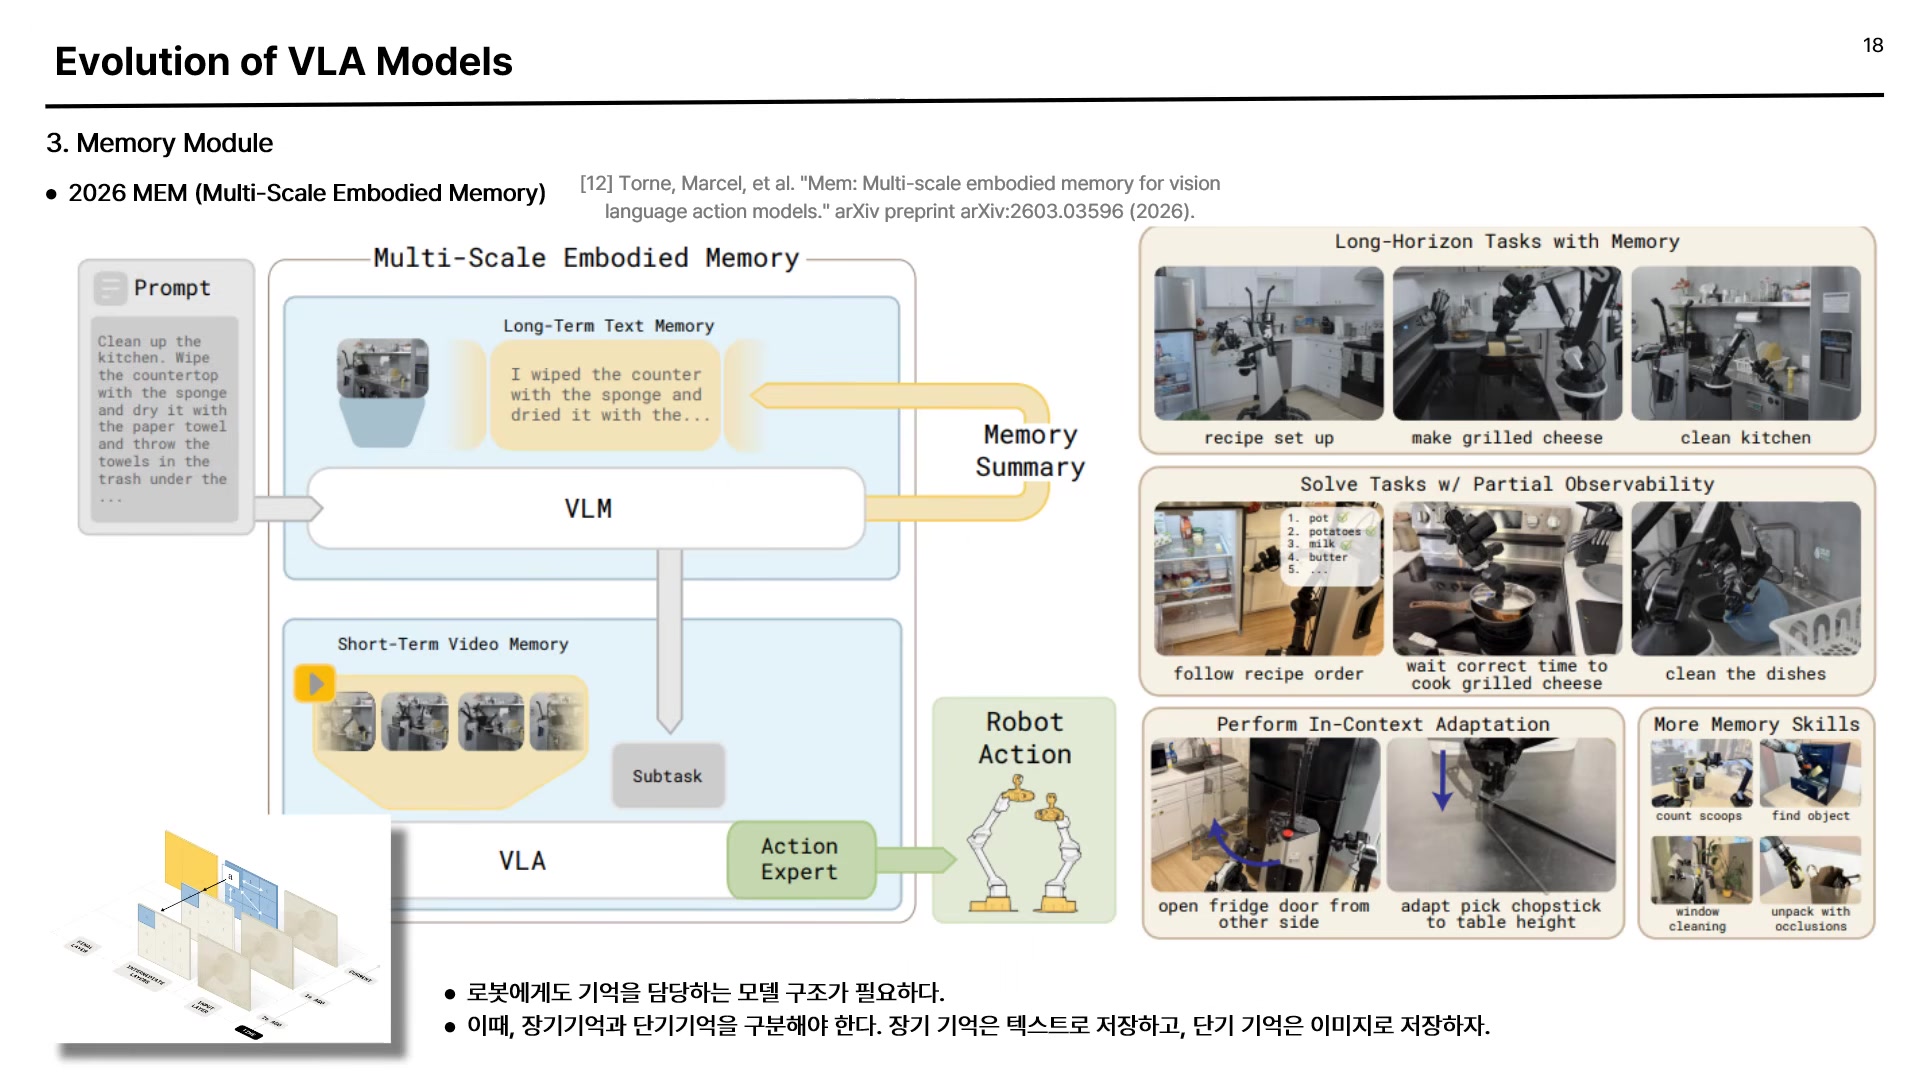
MEM(Torne et al., 2026, Multi-Scale Embodied Memory)은 기억을 두 종류로 나눈다.
이 구조로 가능해진 과제는 세 묶음이다 — Long-Horizon Tasks with Memory(recipe set up, make grilled cheese, clean kitchen), Solve Tasks w/ Partial Observability, Perform In-Context Adaptation. 개수를 세며 물건을 꺼내거나, 주방 전체를 정리하는 일이 여기 들어간다.
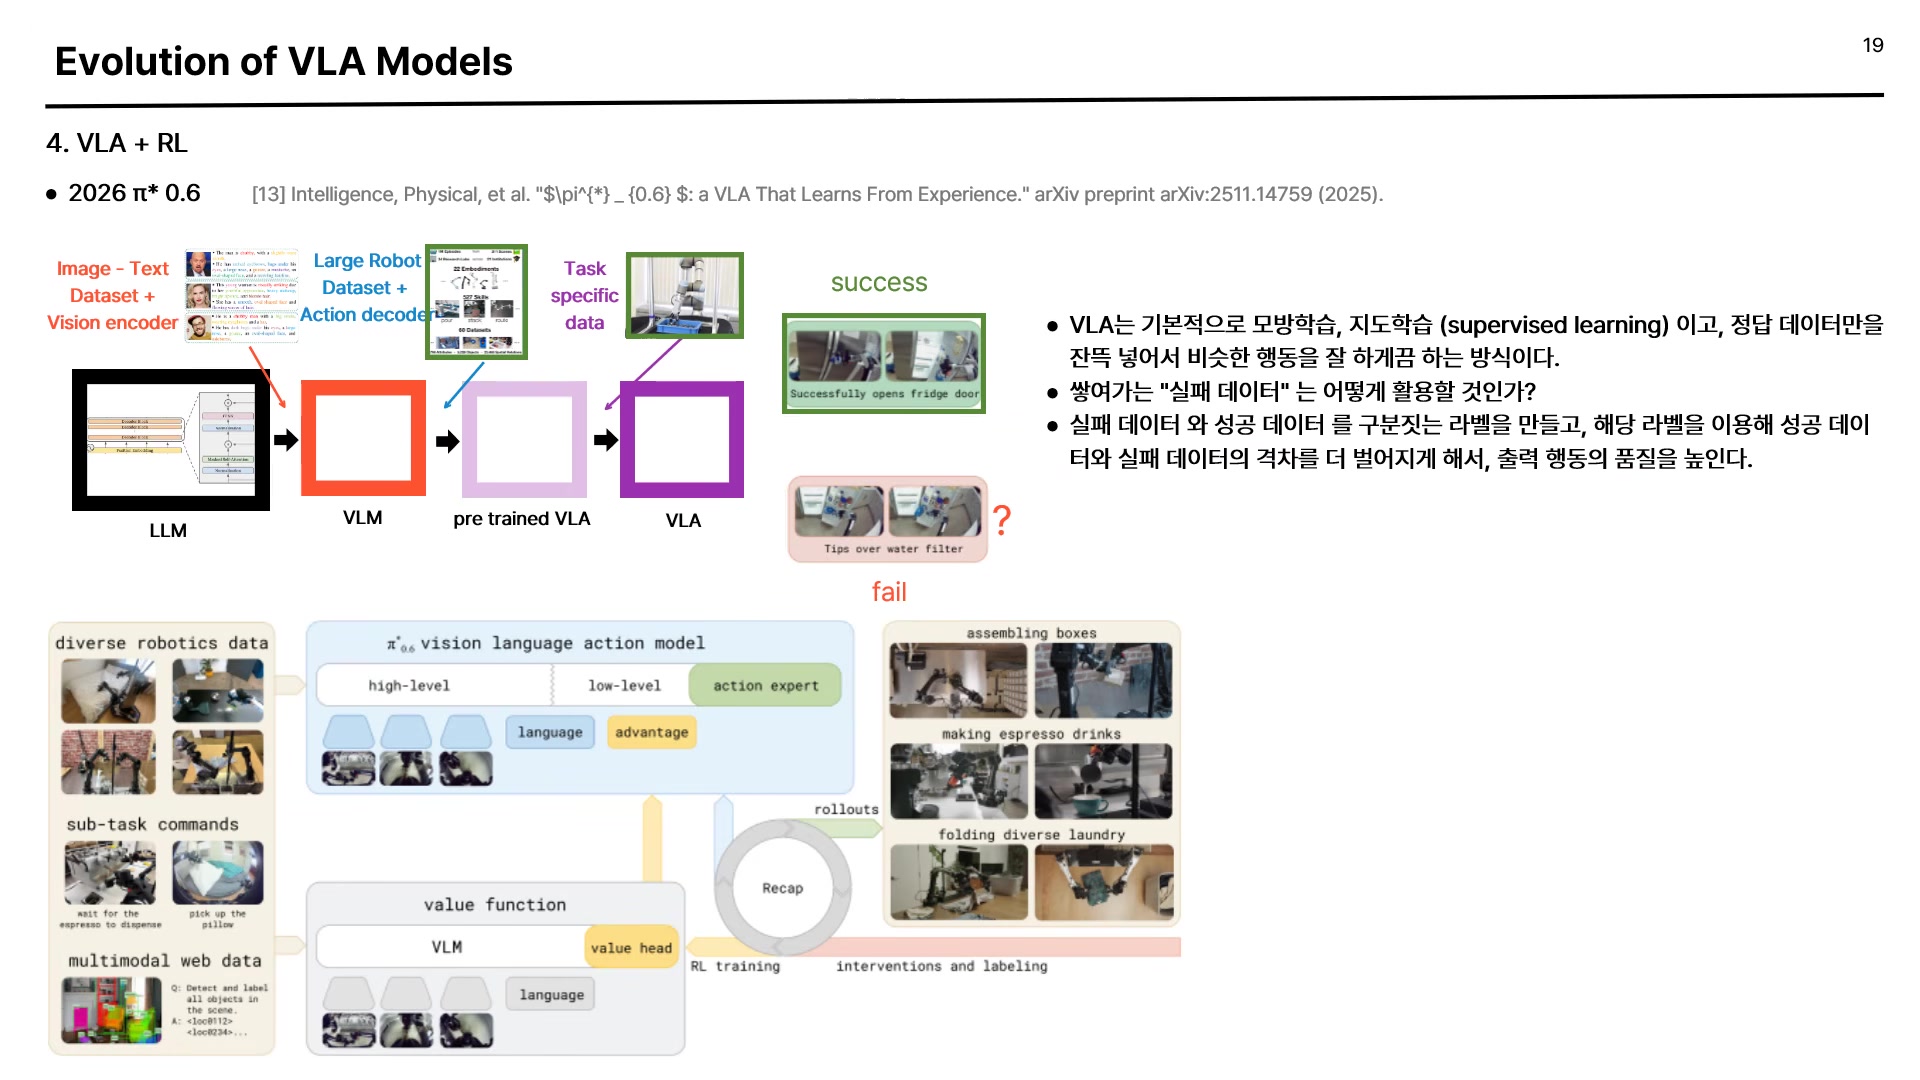
VLA는 기본적으로 모방학습이자 지도학습이다. 정답 데이터만 전부 넣어서 비슷한 행동을 잘 하게 만든다. 여기서 빠지는 것이 실패 데이터다. 로봇이 수없이 만들어내는데도 학습에 쓰이지 않는 자원이다.
π*0.6(Physical Intelligence, 2026, a VLA That Learns From Experience)의 해법은 로봇 데이터를 VLA에 넣기 전에 value function 역할의 VLM에 먼저 통과시키는 것이다. 방금 그 행동이 성공에 도움이 되었는지 판단해 이진 advantage 신호를 만들고, 태그로 붙여 VLA에 넣는다. Action expert는 실패 행동의 분포에서 멀어지도록 학습되고, 성공과 실패의 격차가 벌어지면서 출력 품질이 올라간다.
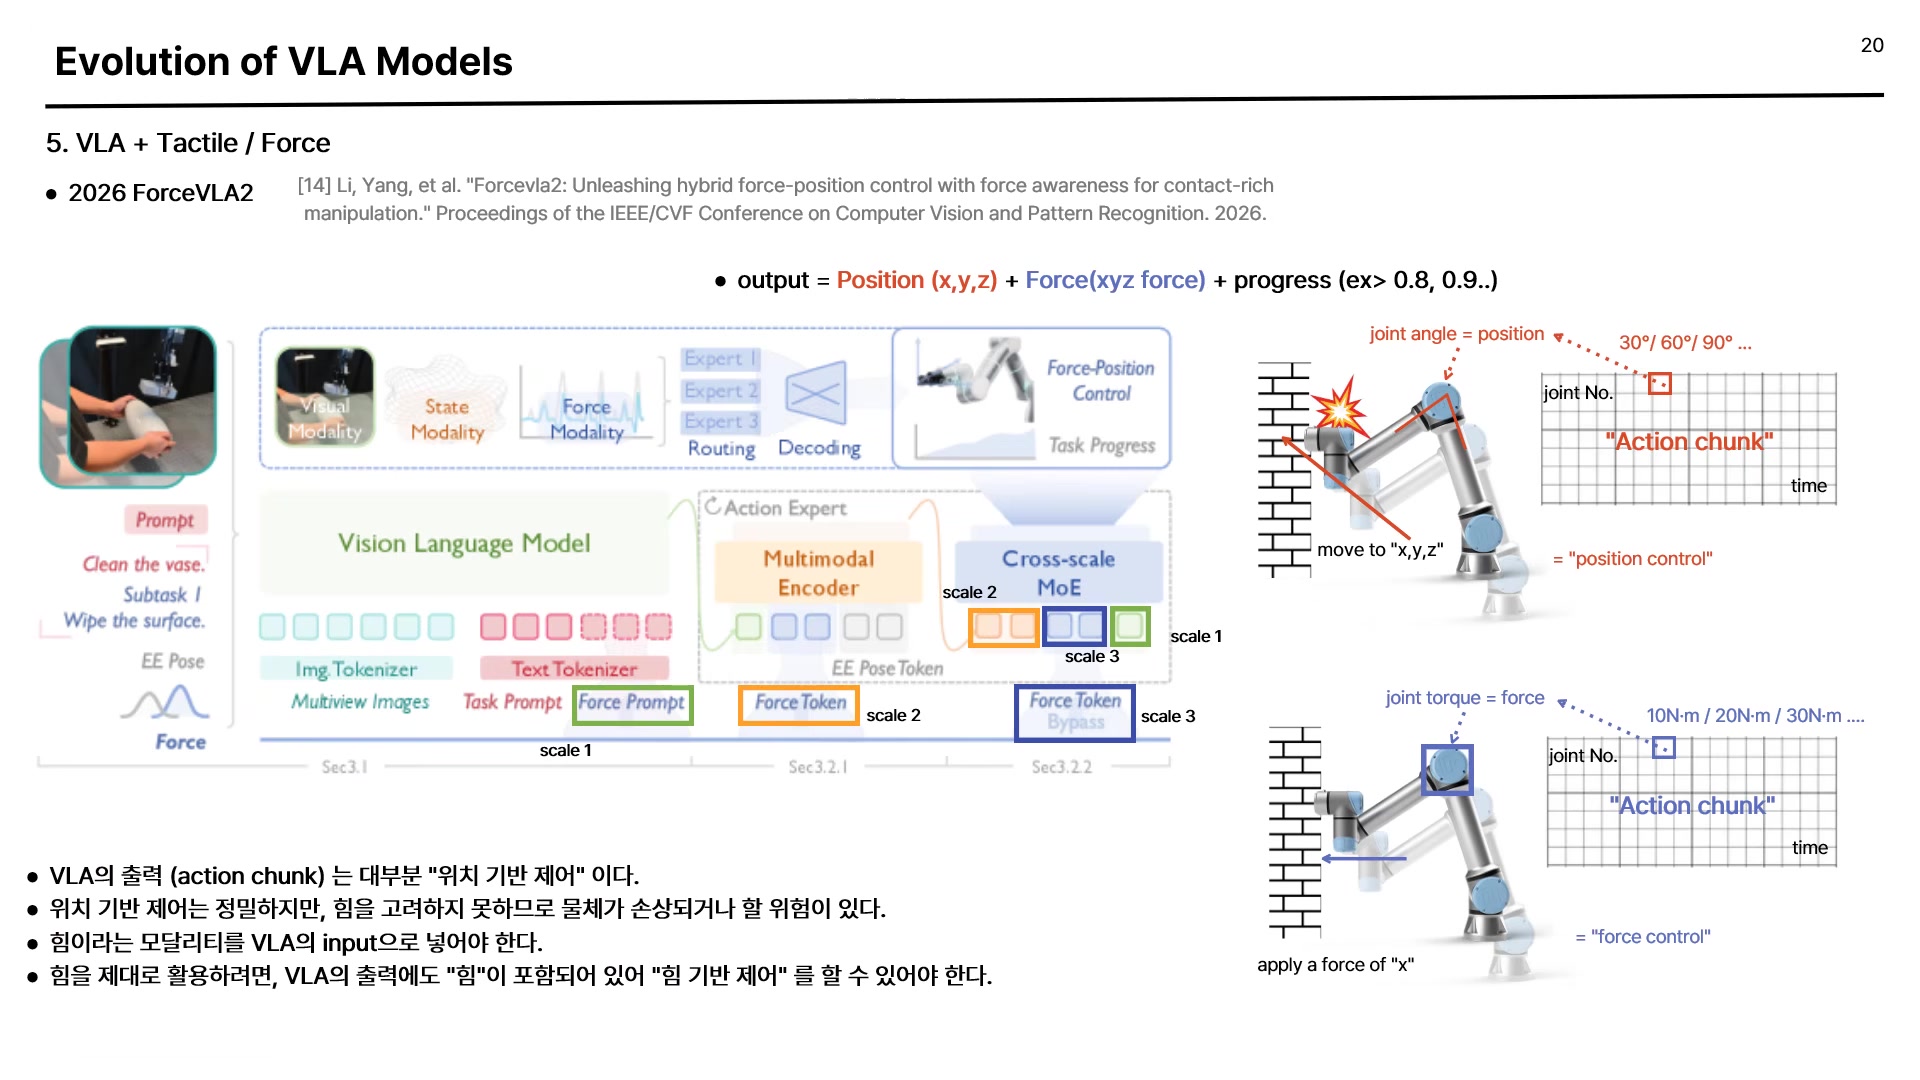
VLA의 출력인 action chunk는 대부분 위치 기반 제어다. 정밀하지만 힘을 고려하지 못한다. 계란을 집으면 깨고, 문고리를 돌리면 망가뜨린다. 힘이라는 모달리티를 입력에 넣어야 하고, 출력에도 힘이 포함되어야 힘 기반 제어가 가능해진다.
ForceVLA2(Li et al., CVPR 2026)의 출력은 이렇게 정의된다 —
Position (x,y,z) + Force(xyz force) + progress (ex> 0.8, 0.9…).
Vision Language Model 아래 Action Experts 안에 Multimodal Encoder와 Cross-scale MoE가 배치되어
Force Token / Force Prompt를 함께 처리하고, action chunk 격자가 “position control”용과 “force control”용 두 벌로 그려진다.
이 방향만의 트레이드오프
VLA의 목표는 어떤 로봇 하드웨어에도 적용 가능한 범용 액션 파운데이션 모델이다. 그런데 새로운 모달리티를 추가하면 센서 종류와 데이터 형태마다 모델을 따로 학습시켜야 한다. 범용성이라는 장점과 정면으로 모순된다.
게다가 기존 산업용 로봇은 설계 단계부터 위치 기반 제어를 중시해, 힘 기반 제어를 아예 제공하지 않는 하드웨어도 많다.
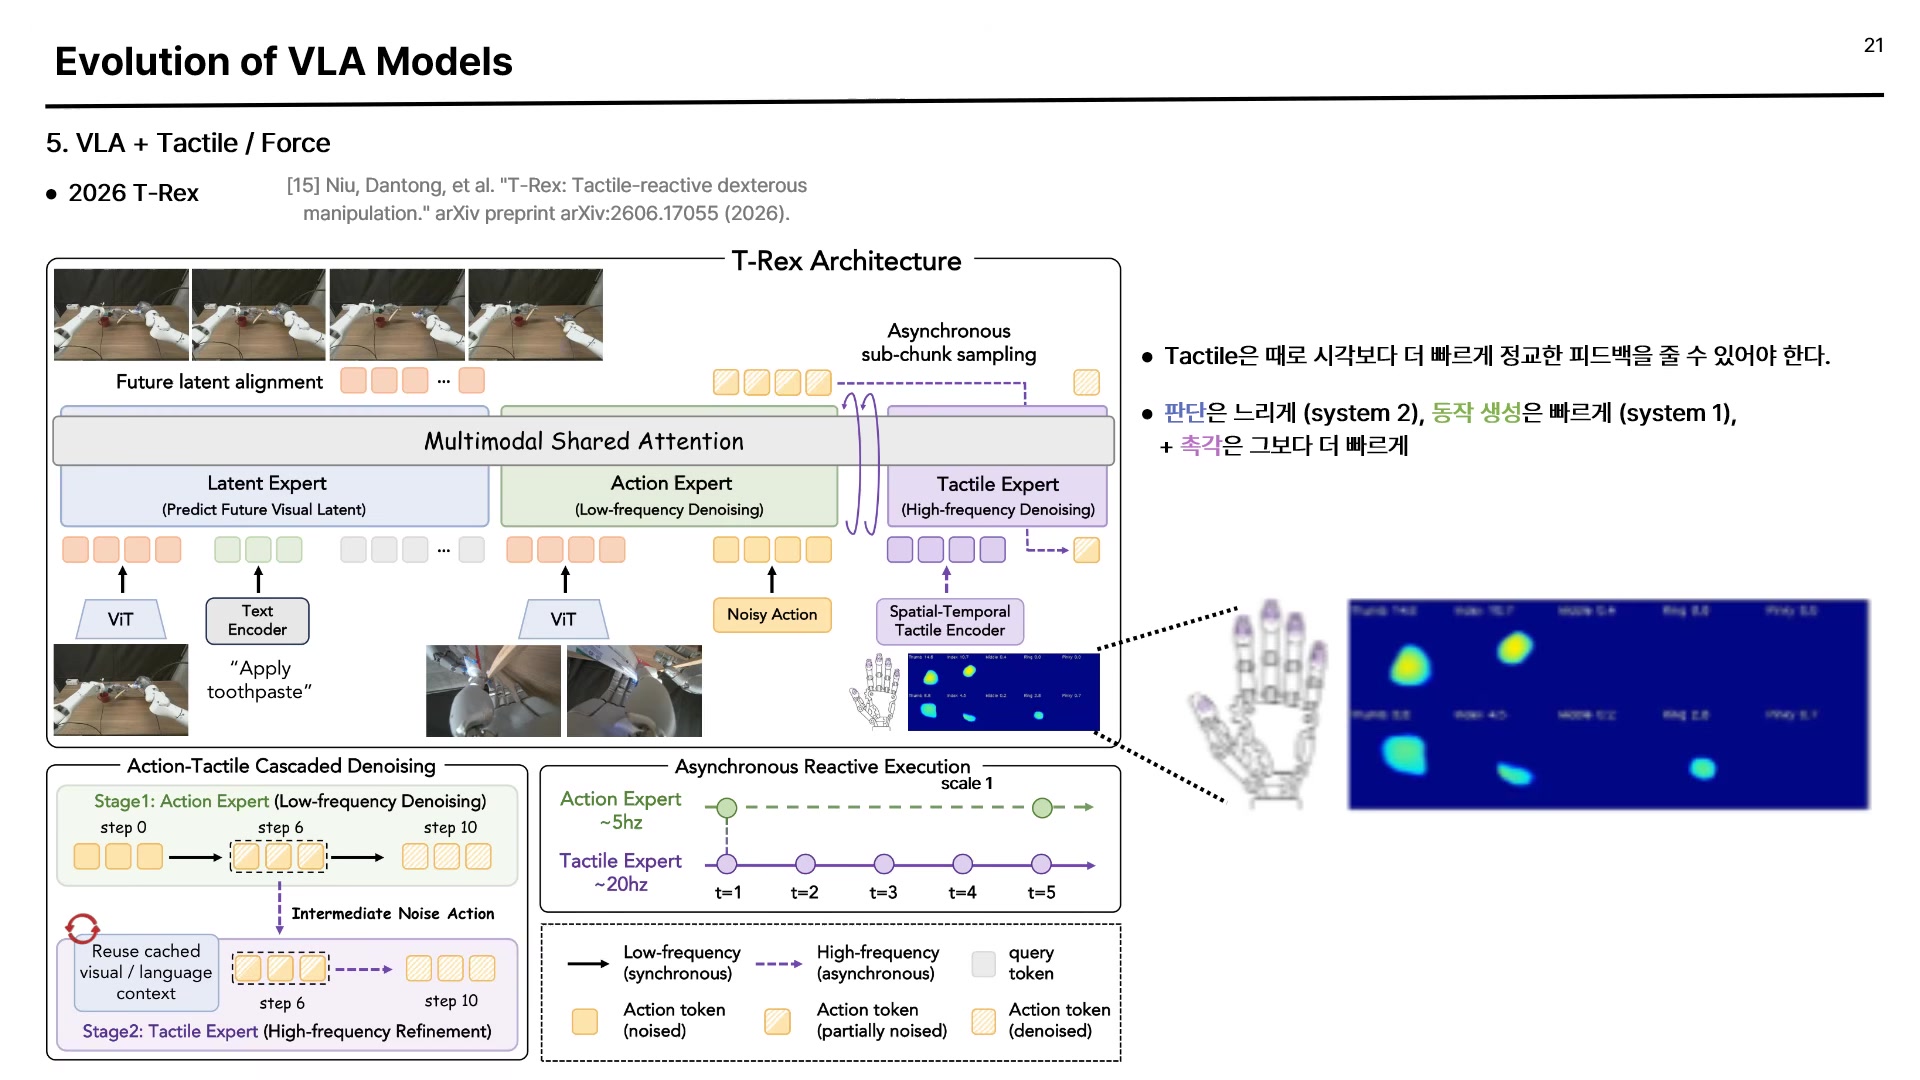
T-Rex(Niu et al., 2026, Tactile-reactive dexterous manipulation)는 여기서 한 발 더 나간다. Multimodal Shared Attention을 공유하면서 세 전문가가 갈라진다 — Latent Expert(Predict Future Visual Latent), Action Expert(Low-Frequency Denoising), 그리고 Tactile Expert(High-Frequency Denoising).
Action Expert ~5Hz, Tactile Expert ~20Hz가 t+1…t+5에 걸쳐 비동기로 실행된다. 판단은 느리게(System 2), 동작 생성은 빠르게(System 1), 촉각은 그보다 더 빠르게.
중요한 점은 촉각 전문가도 어텐션 레이어 자체는 공유한다는 것이다. 분리되는 것은 MLP뿐이다. 덕분에 큰 행동 생성부터 미세 보정까지 촉각이 일관되게 반영된다.
마지막 방향은 데이터 그 자체다. RLDX-1 테크니컬 리포트(Kim et al., 2026)에서 가져온 파이프라인으로, 발표자는 이를 “한국의 리얼드라는 기업”이 낸 모델로 소개한다.
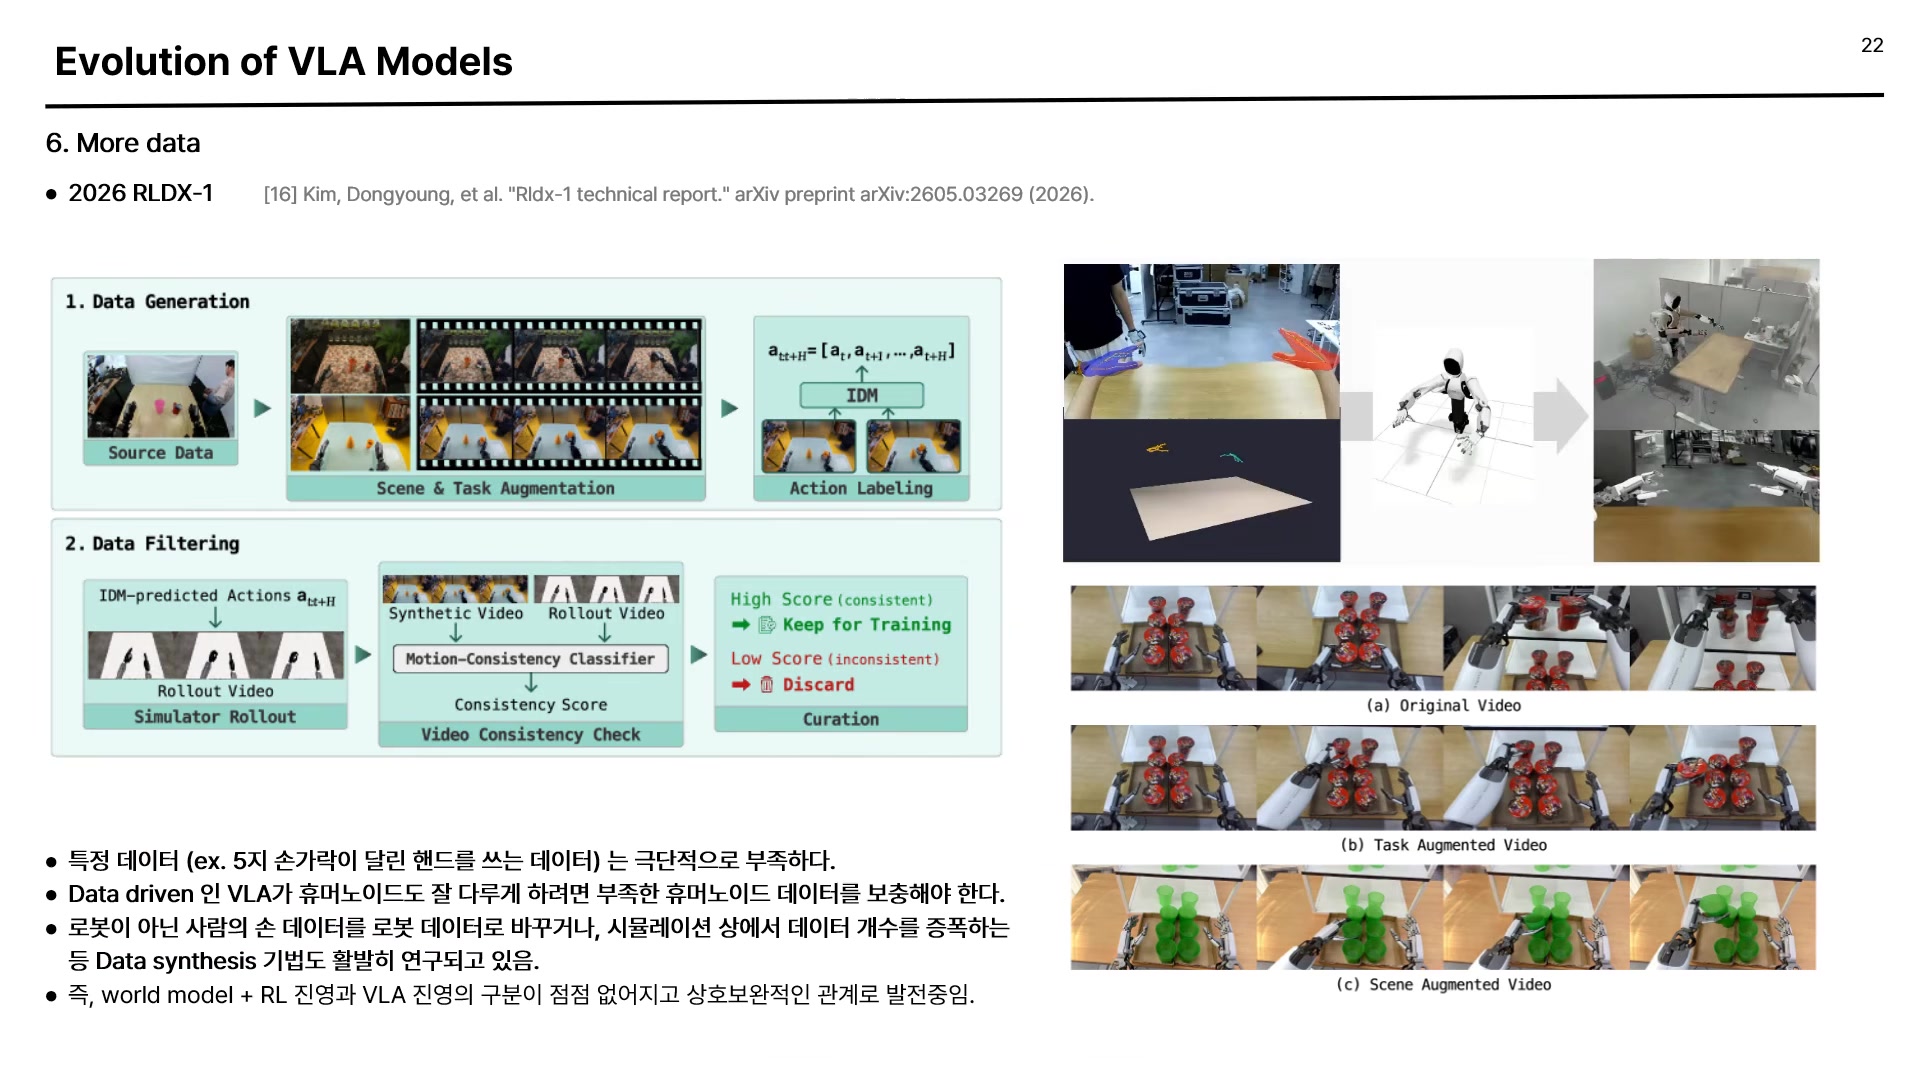
즉, world model + RL 진영과 VLA 진영의 구분이 점점 없어지고 상호보완적인 관계로 발전 중이다.— 슬라이드 마지막 줄. 비디오 생성 모델은 결국 월드모델이다.
| 방향 | 대표 연구 | 겨냥한 한계 | 핵심 아이디어 |
|---|---|---|---|
| Action Expert | π0 (2024) | 속도 · 정밀도 | 관절값 시계열을 이미지처럼 한 번에 예측(chunk), MLP만 분리해 고주파 실행 |
| Chain-of-Thought | CoT-VLA (2025) | 맥락 · 장기 과제 | 중간 추론을 자연어가 아닌 목표 이미지로 예측 |
| Memory Module | MEM (2026) | 맥락 · 부분 관측 | 장기=텍스트 요약, 단기=압축 비디오 피처 |
| VLA + RL | π*0.6 (2026) | 출력 품질 | value function VLM으로 advantage 태그 부여, 실패 데이터 활용 |
| Tactile / Force | ForceVLA2, T-Rex (2026) | 감각 결여 | 힘을 입출력 모두에 포함, 촉각 전문가를 ~20Hz로 비동기 실행 |
| More Data | RLDX-1 (2026) | 데이터 부족 | 비디오 생성 모델로 증강 후 consistency 자동 필터링 |
마지막 슬라이드에는 뇌 단면도가 놓이고, 그 위에 VLA의 구성요소가 하나씩 대응된다. 여섯 갈래의 연구가 각자 다른 논문에서 출발했는데, 모아놓고 보면 하나의 그림이 된다.
| VLA 구성요소 | 대응 | 역할 |
|---|---|---|
| VLA | 뇌 | 전체 판단과 행동 생성 |
| CoT VLA | 전전두엽 | 계획, 단계적 추론 |
| Action Expert | 소뇌 | 빠른 운동 제어 |
| Memory Module | 해마 | 장·단기 기억 |
| Vision sensor | 눈 | 시각 입력 |
| Tactile sensor | 손 | 접촉·힘 피드백 |
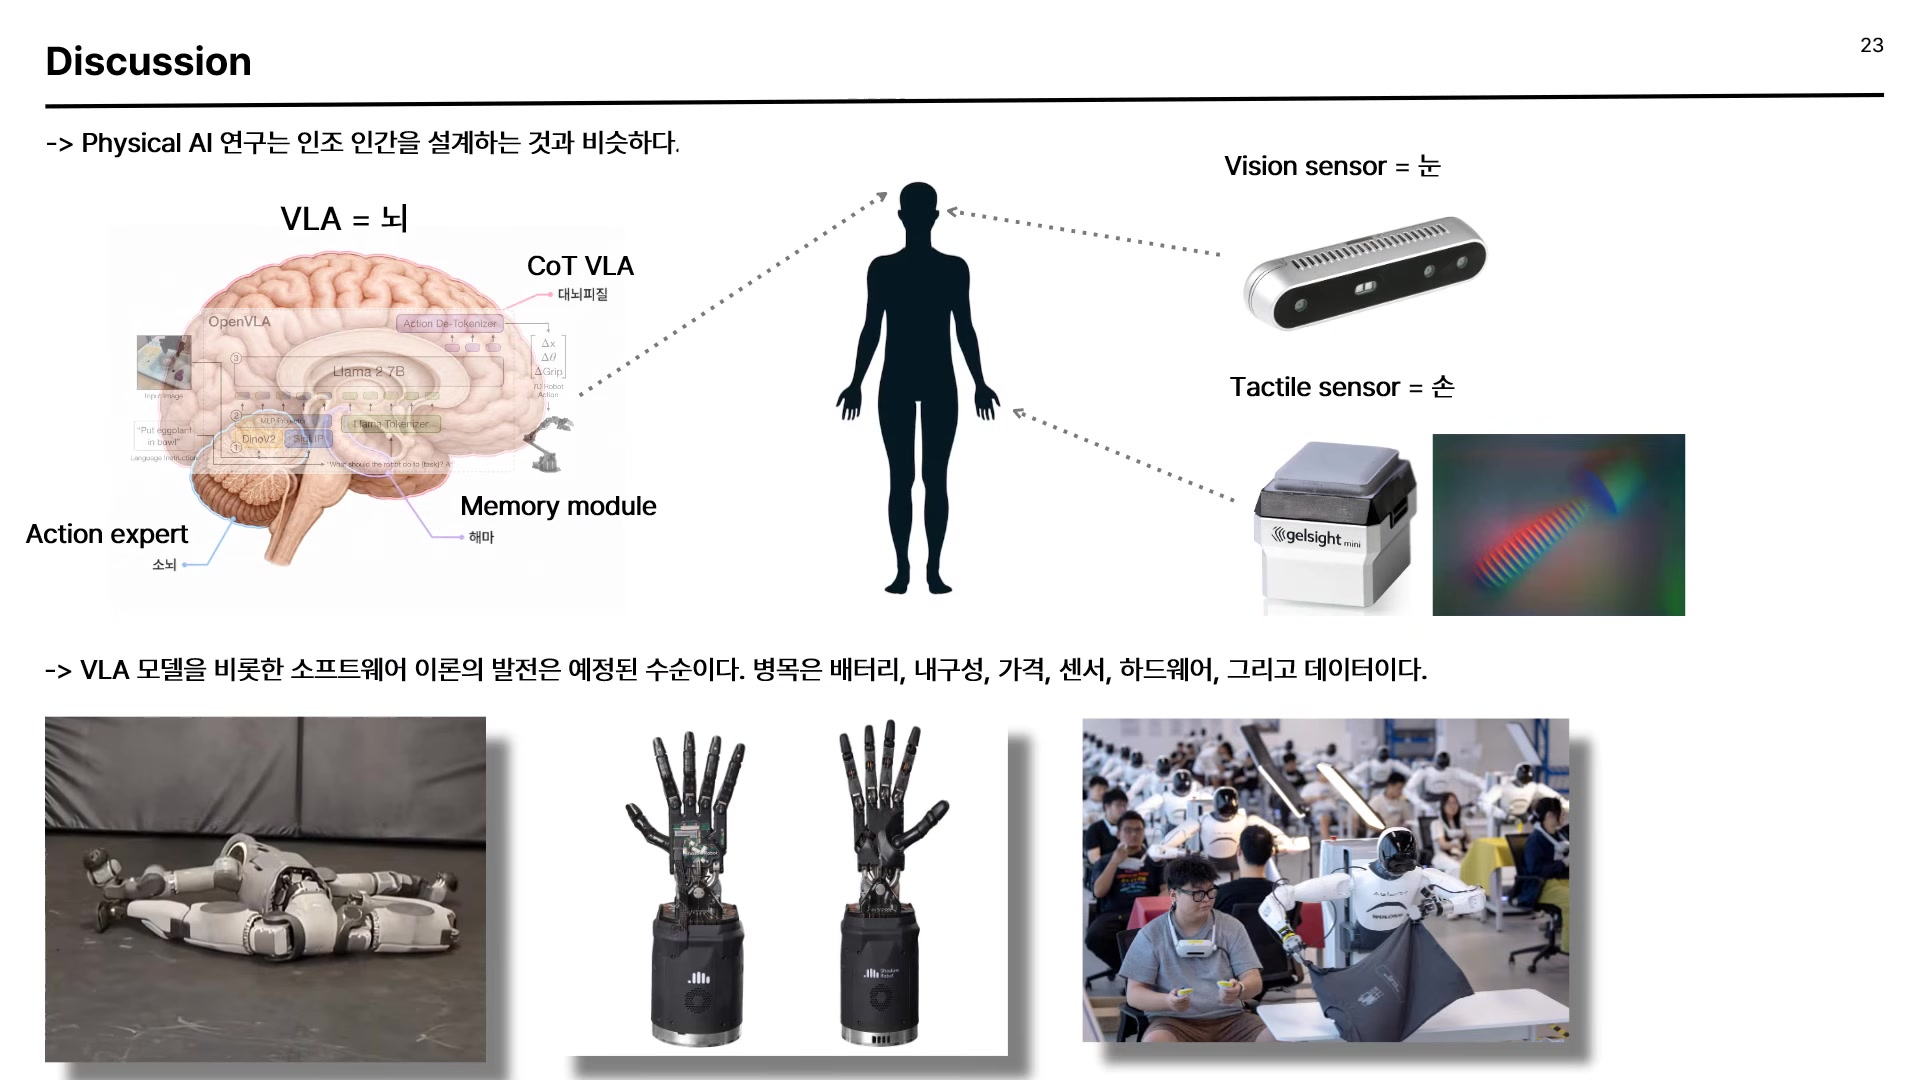
VLA 모델을 비롯한 소프트웨어 이론의 발전은 예정된 수순이다. 병목은 배터리, 내구성, 가격, 센서, 하드웨어, 그리고 데이터이다.— 발표 마지막 슬라이드
우리는 로봇에게 공중제비를 가르치는 법은 이미 안다. 남은 질문은 그 로봇이 왜 넘어야 하는지를 스스로 판단하게 만드는 일이고, 이 발표의 대답은 뇌를 한 부품씩 다시 만드는 중이라는 것이다. 그리고 그 작업이 끝나갈 즈음 우리를 기다리는 것은 알고리즘이 아니라 배터리와 손끝의 감각일 가능성이 크다.