신뢰성과 상업성은 서로 다른 문제였다
오프라인 RL은 24시간 신뢰성을 만들었지만, 처리량과 빠른 에러 회복은 사람 개입 기반 능동 학습이 개선했다.
Production Robotics
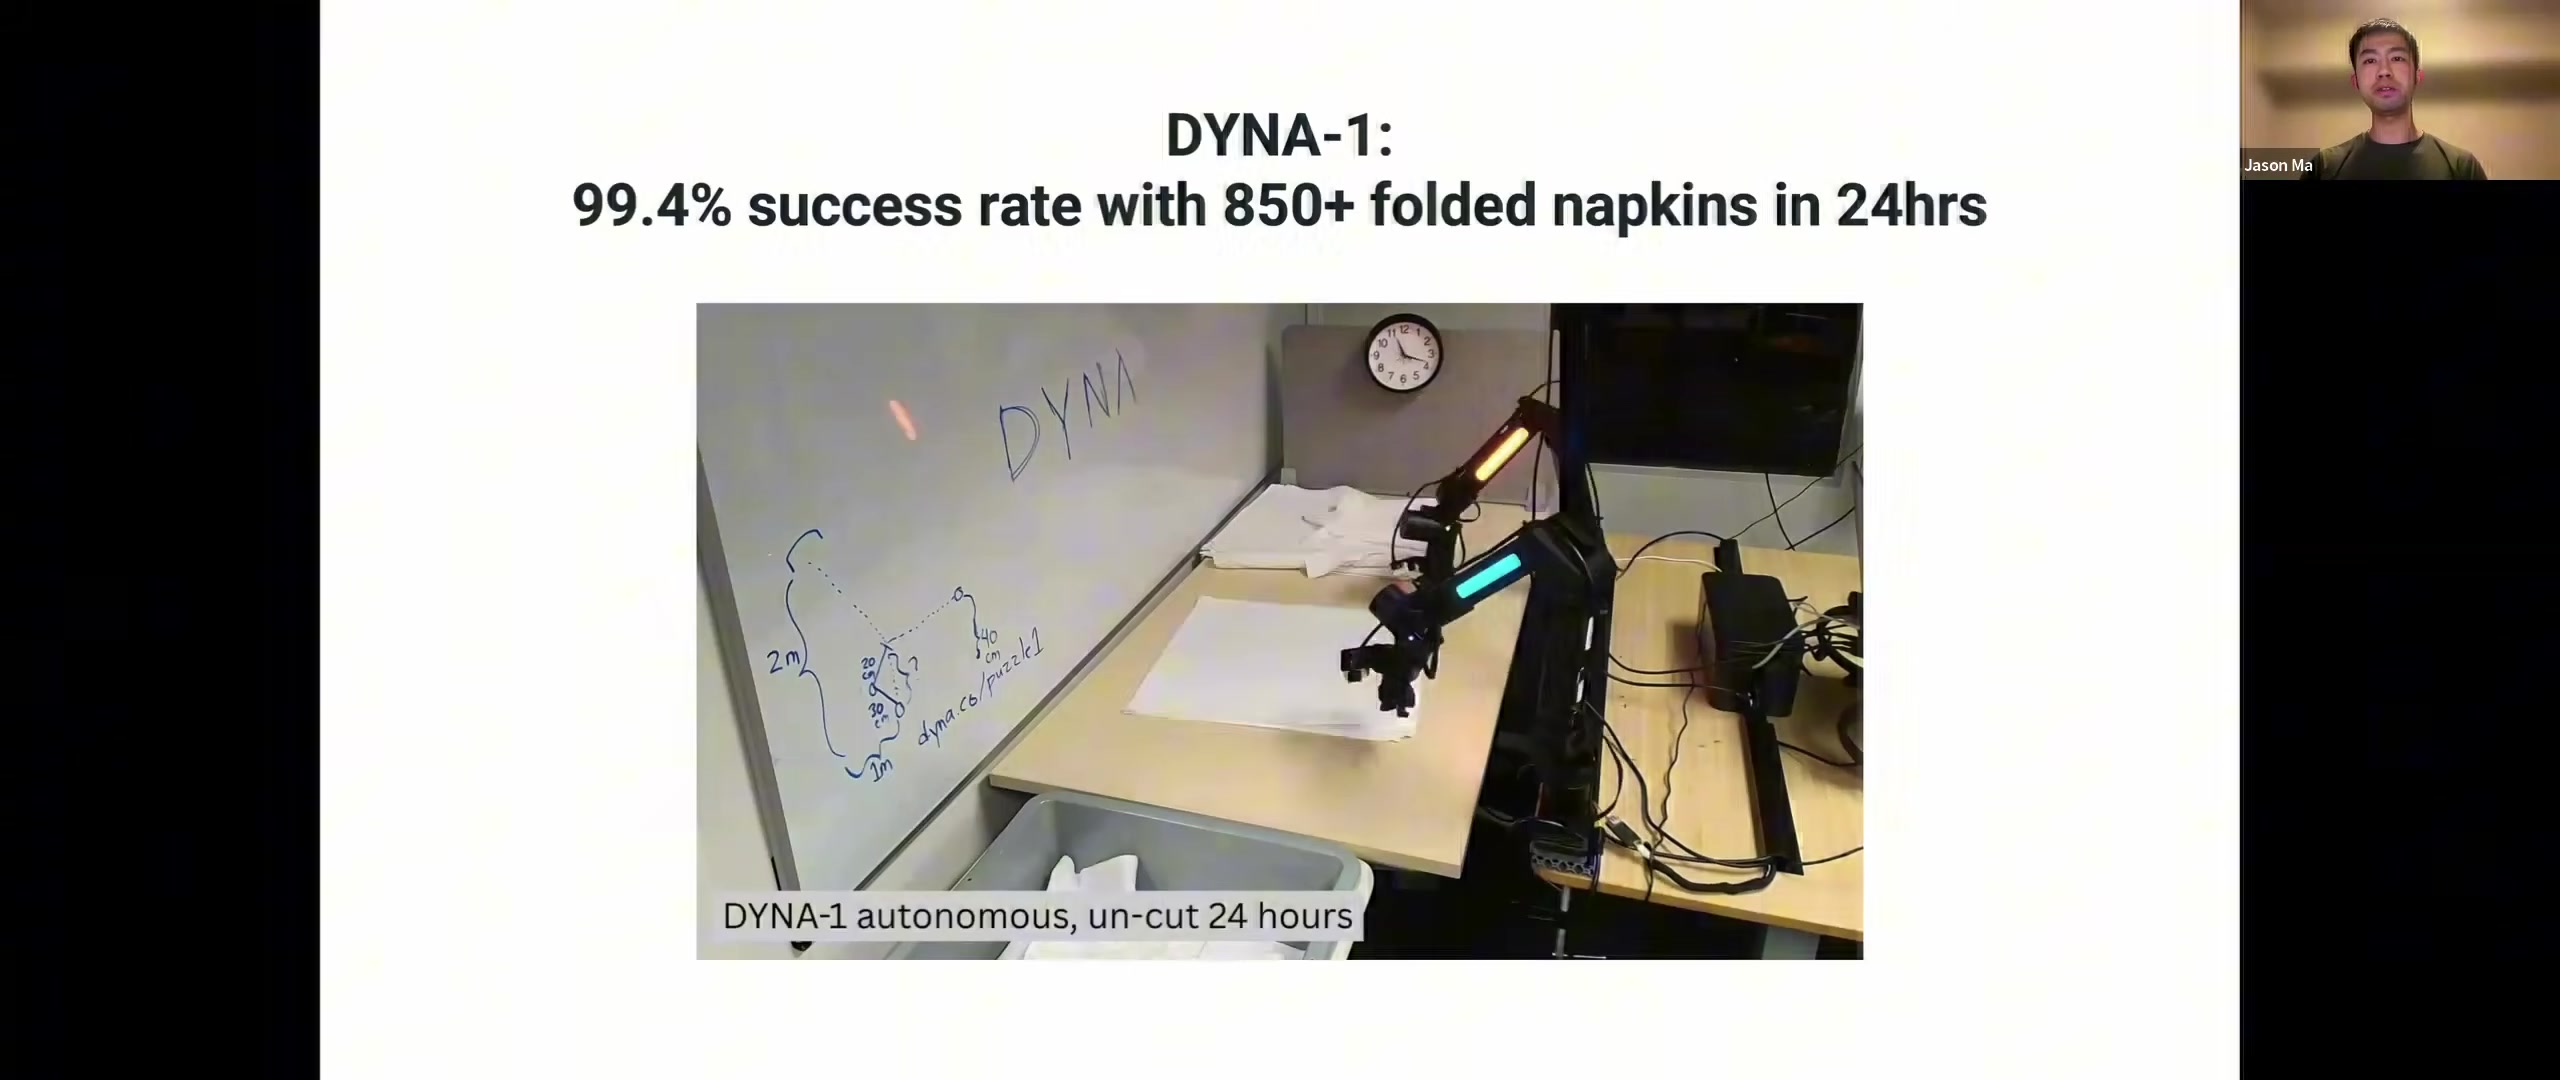
Dyna Robotics 공동창업자 Jason Ma는 24시간 동안 냅킨 850장 이상을 접은 로봇에서 가장 중요했던 것이 정교한 실세계 강화학습이 아니었다고 말한다. 보상 모델을 사람의 개입과 운영 관측성을 배분하는 도구로 바꾼 것이 결정적이었다.
Abstract
이 보고서는 Jason Ma의 발표를 바탕으로 Dyna Robotics가 연구용 보상 모델을 상업용 로봇 학습·운영 시스템으로 확장한 과정을 분석한다. 초기에는 reward-weighted regression을 이용한 오프라인 RL로 24시간 신뢰성을 확보했지만, 정책은 에러 상태에서 2~3분씩 멈추며 상업적 처리량을 내지 못했다.
전환점은 보상 모델을 정책 최적화용 점수 함수가 아니라 실패 위치를 찾고 사람의 데이터 수집 시간을 배분하는 감독 도구로 사용한 것이었다. 같은 진행도 신호는 배치 후 작업 완료 분절, 사이클 시간 측정, 이상치 탐지에도 재사용됐다. 사례가 제시하는 중심 명제는 단순하다. 프로덕션 로보틱스에서 현재의 병목은 실세계 RL 자체보다 사전학습, 데이터 루프, 인프라, 하드웨어, 모니터링을 결합하는 시스템 설계에 더 가깝다는 것이다.
오프라인 RL은 24시간 신뢰성을 만들었지만, 처리량과 빠른 에러 회복은 사람 개입 기반 능동 학습이 개선했다.
진행도 곡선이 깨지는 구간만 찾아 데이터 수집 인력을 투입함으로써 로봇 시간을 무작위 탐색보다 효율적으로 사용했다.
진행도 0→1 사이클은 완료 건수, 작업 시간, 이상치를 자동으로 추출하는 프로덕션 모니터가 됐다.
기반 모델과 인프라를 개선한 뒤에는 1시간 미만의 과제 데이터와 표준 SFT만으로 더 나은 결과를 얻었다고 보고했다.
Evidence 01
연구 기반 · 발표자의 박사 연구와 Dyna 확장 사례
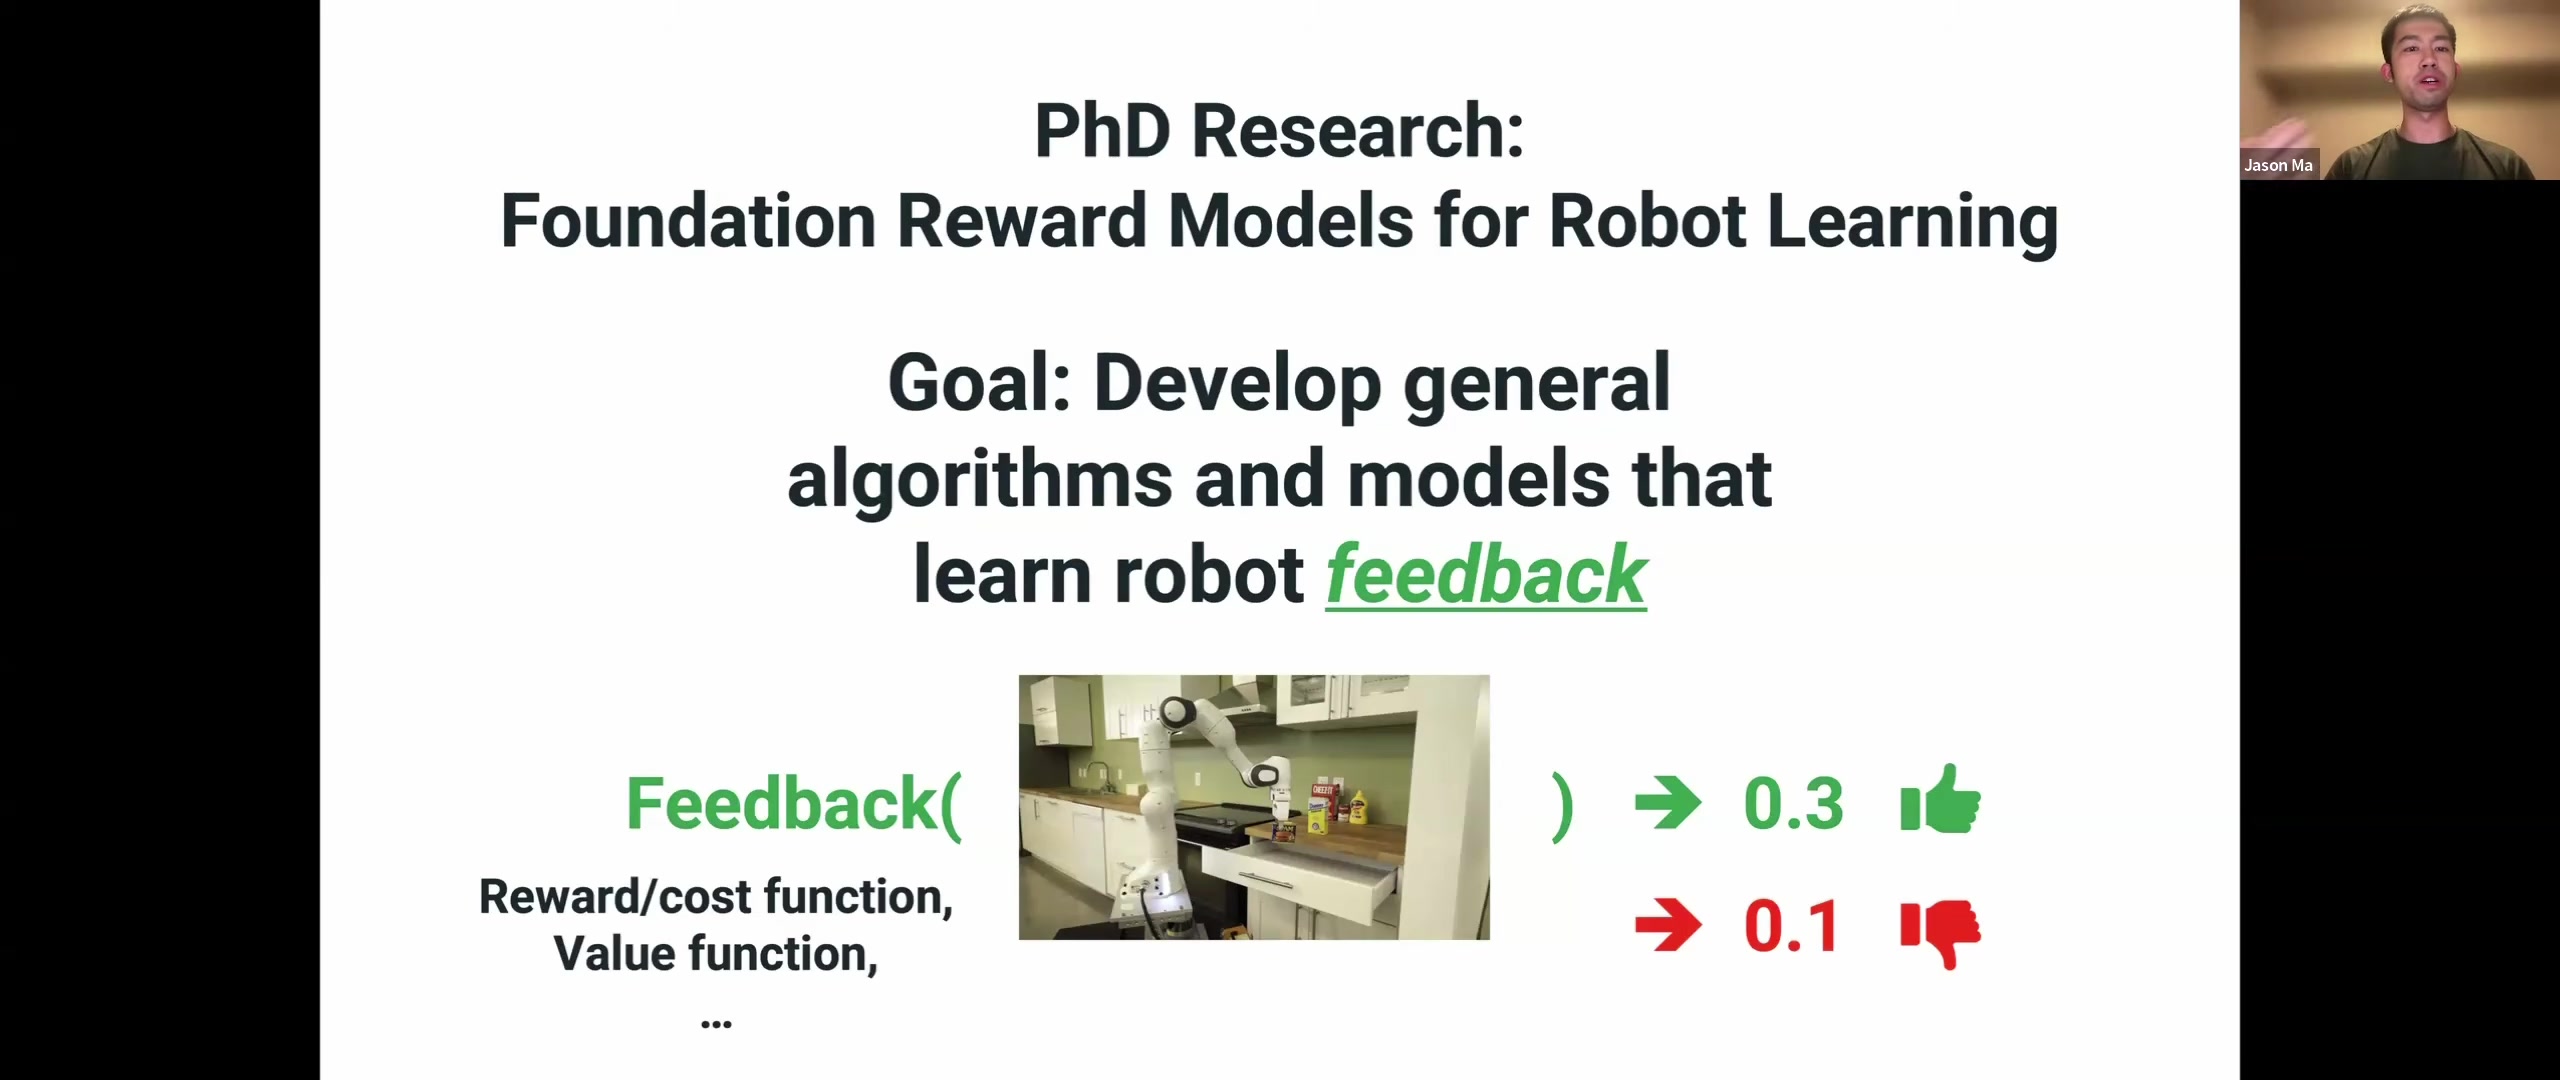
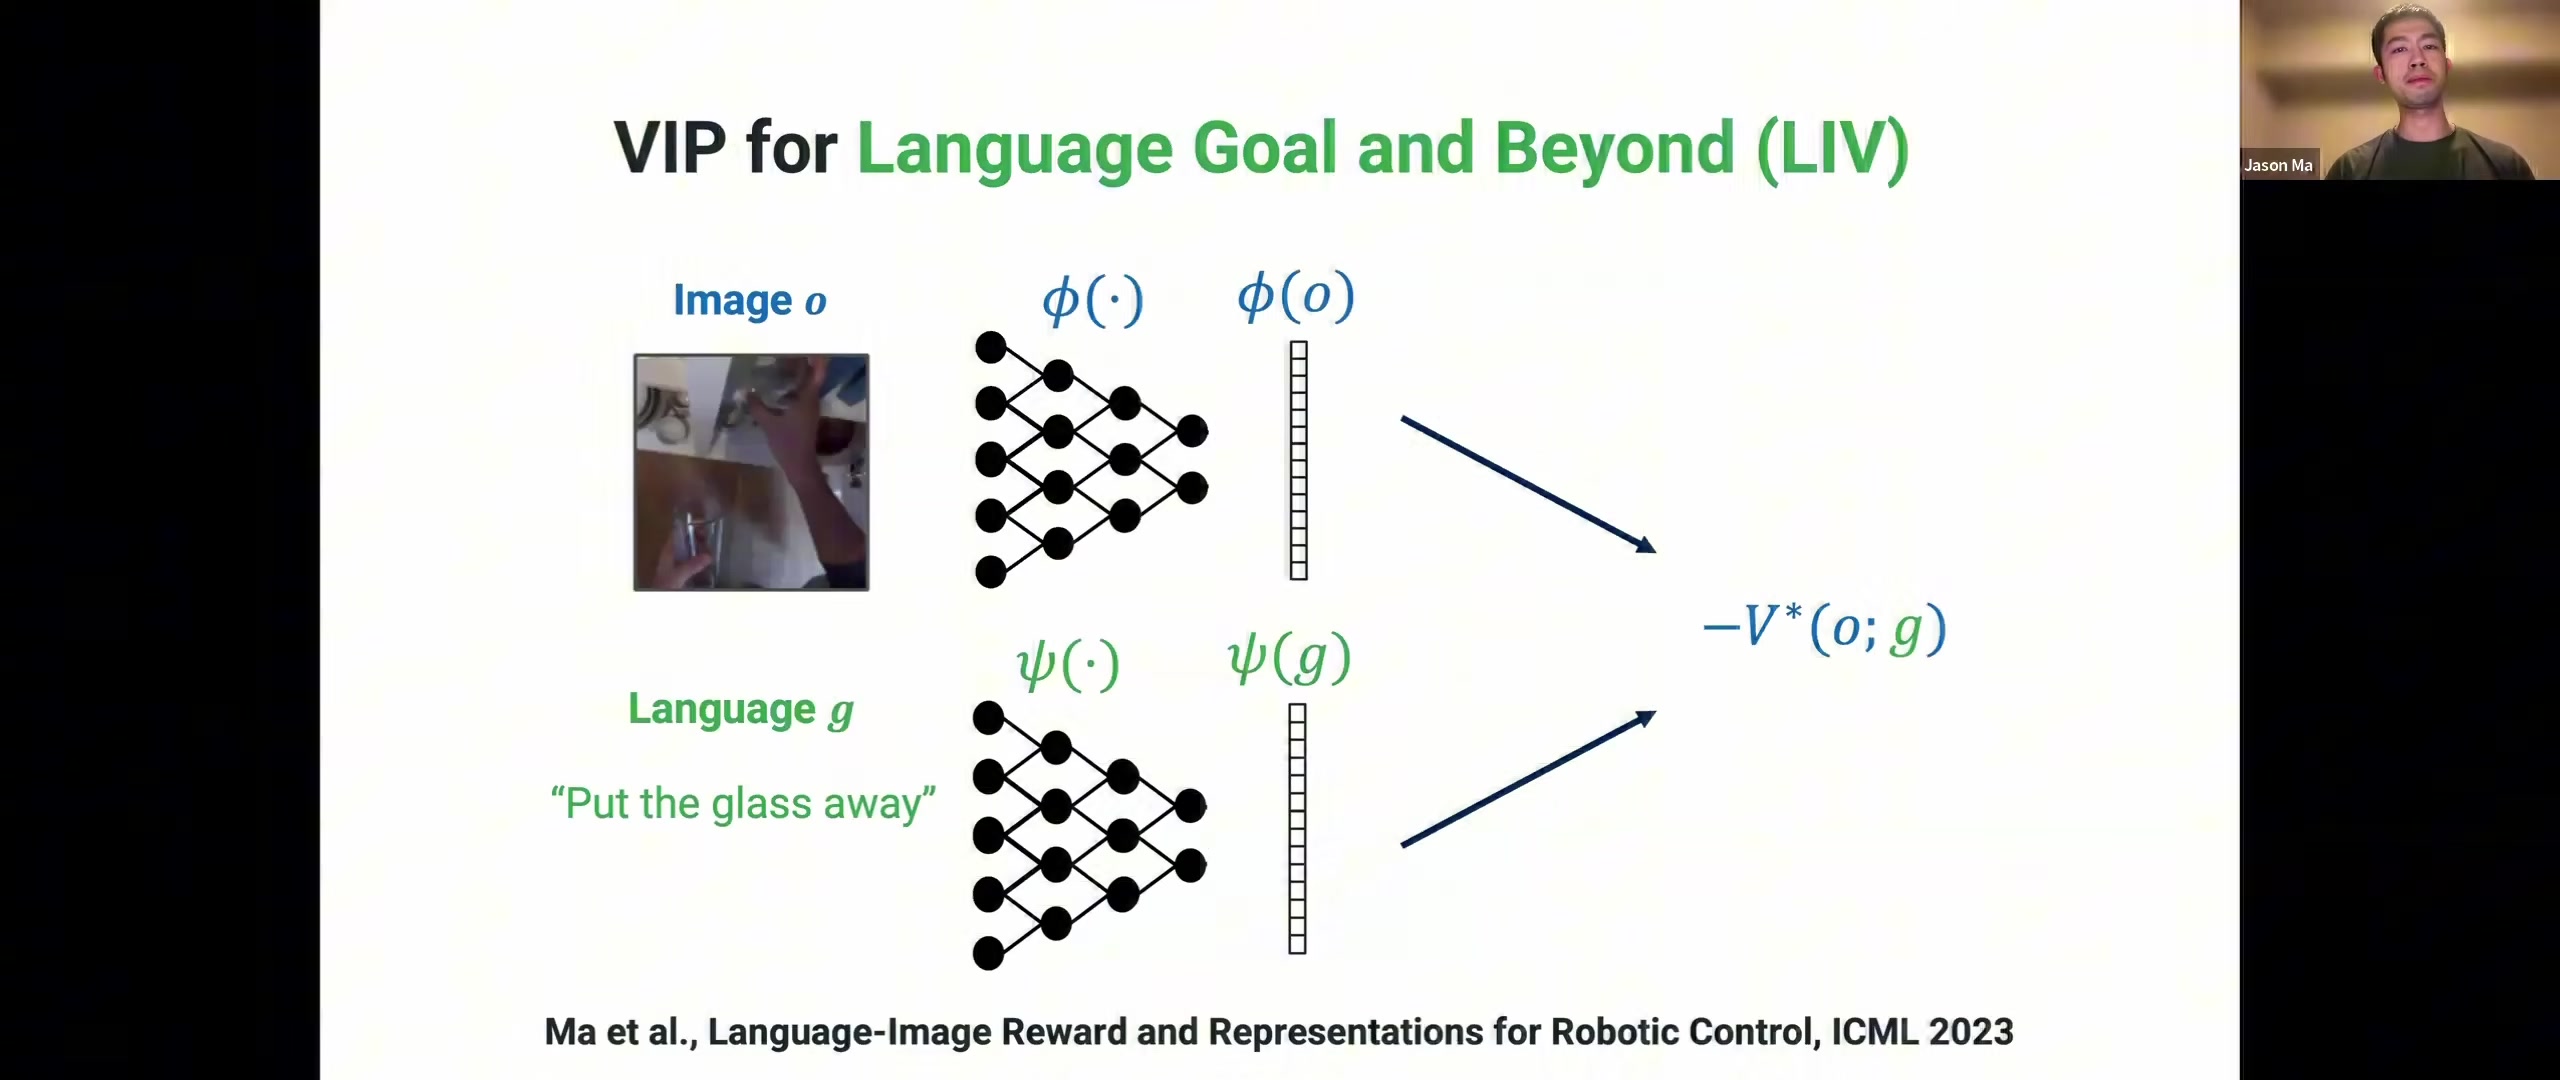
Ma의 연구 질문은 로봇과 세계의 상태를 보고 과제 진행도를 평가하는 범용 피드백 모델을 만들 수 있는가였다. 입력은 이미지 같은 관측이며 출력은 보상, 비용 또는 가치다. 같은 장면이라도 목표에 가까우면 높은 점수, 멀면 낮은 점수를 주도록 학습한다.
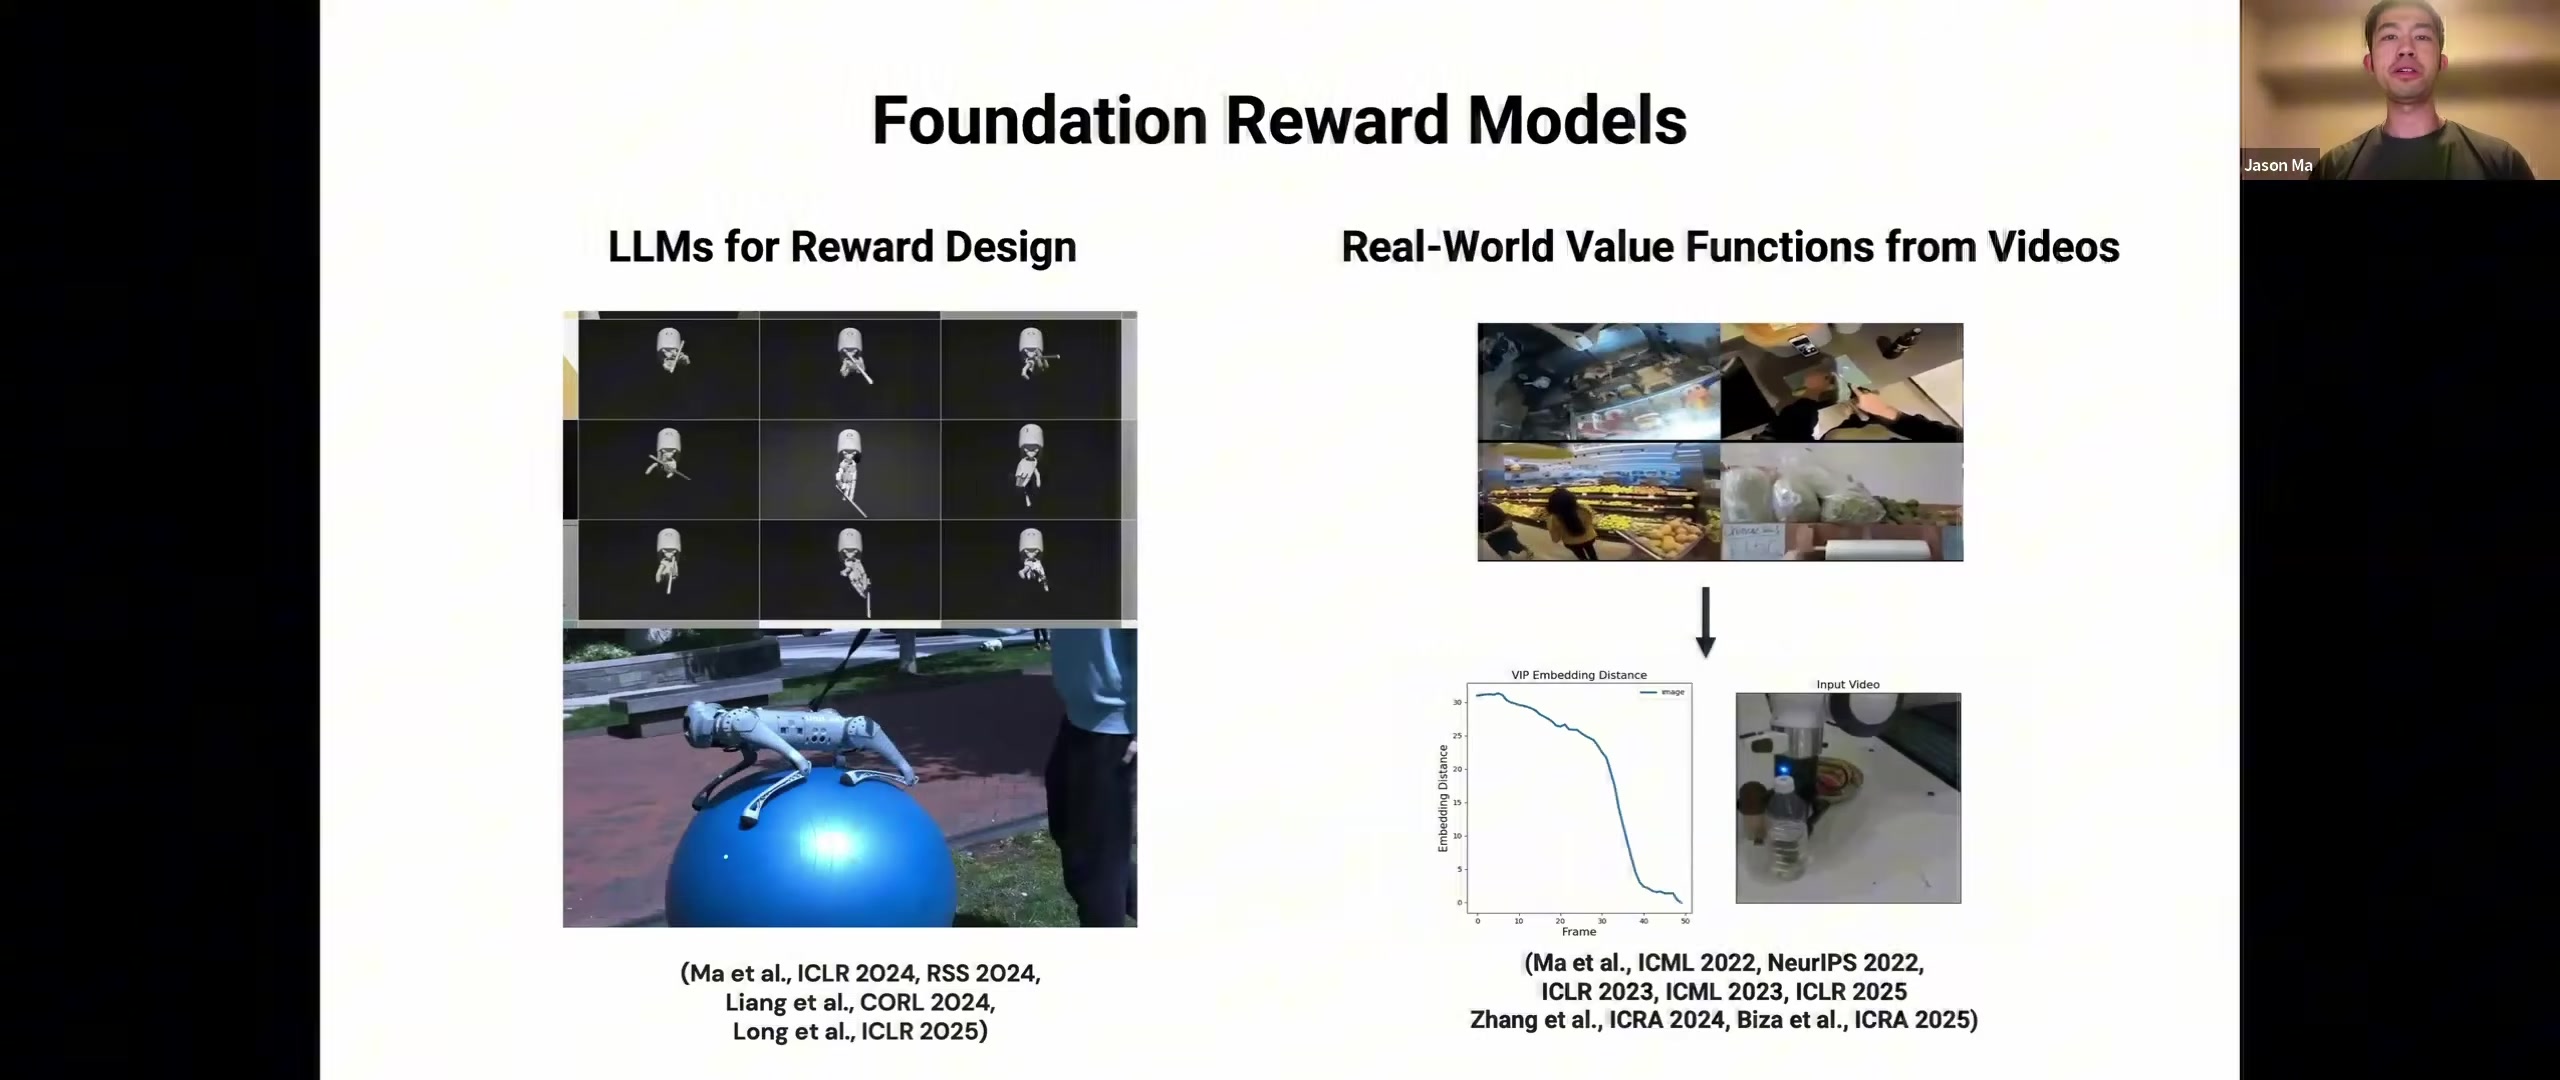
VIP/LIV 계열의 아이디어는 입력 관측과 목표를 같은 잠재 공간에 배치한 뒤, 두 임베딩 사이의 거리를 가치함수처럼 사용하는 것이다. 목표는 이미지뿐 아니라 “유리잔을 치워라” 같은 언어 지시로도 표현할 수 있다. Ego4D 같은 대규모 인간 비디오로 학습한 표현이 학습 중 보지 못한 로봇 영상에서도 합리적인 진행도를 추정했다는 것이 출발점이다.
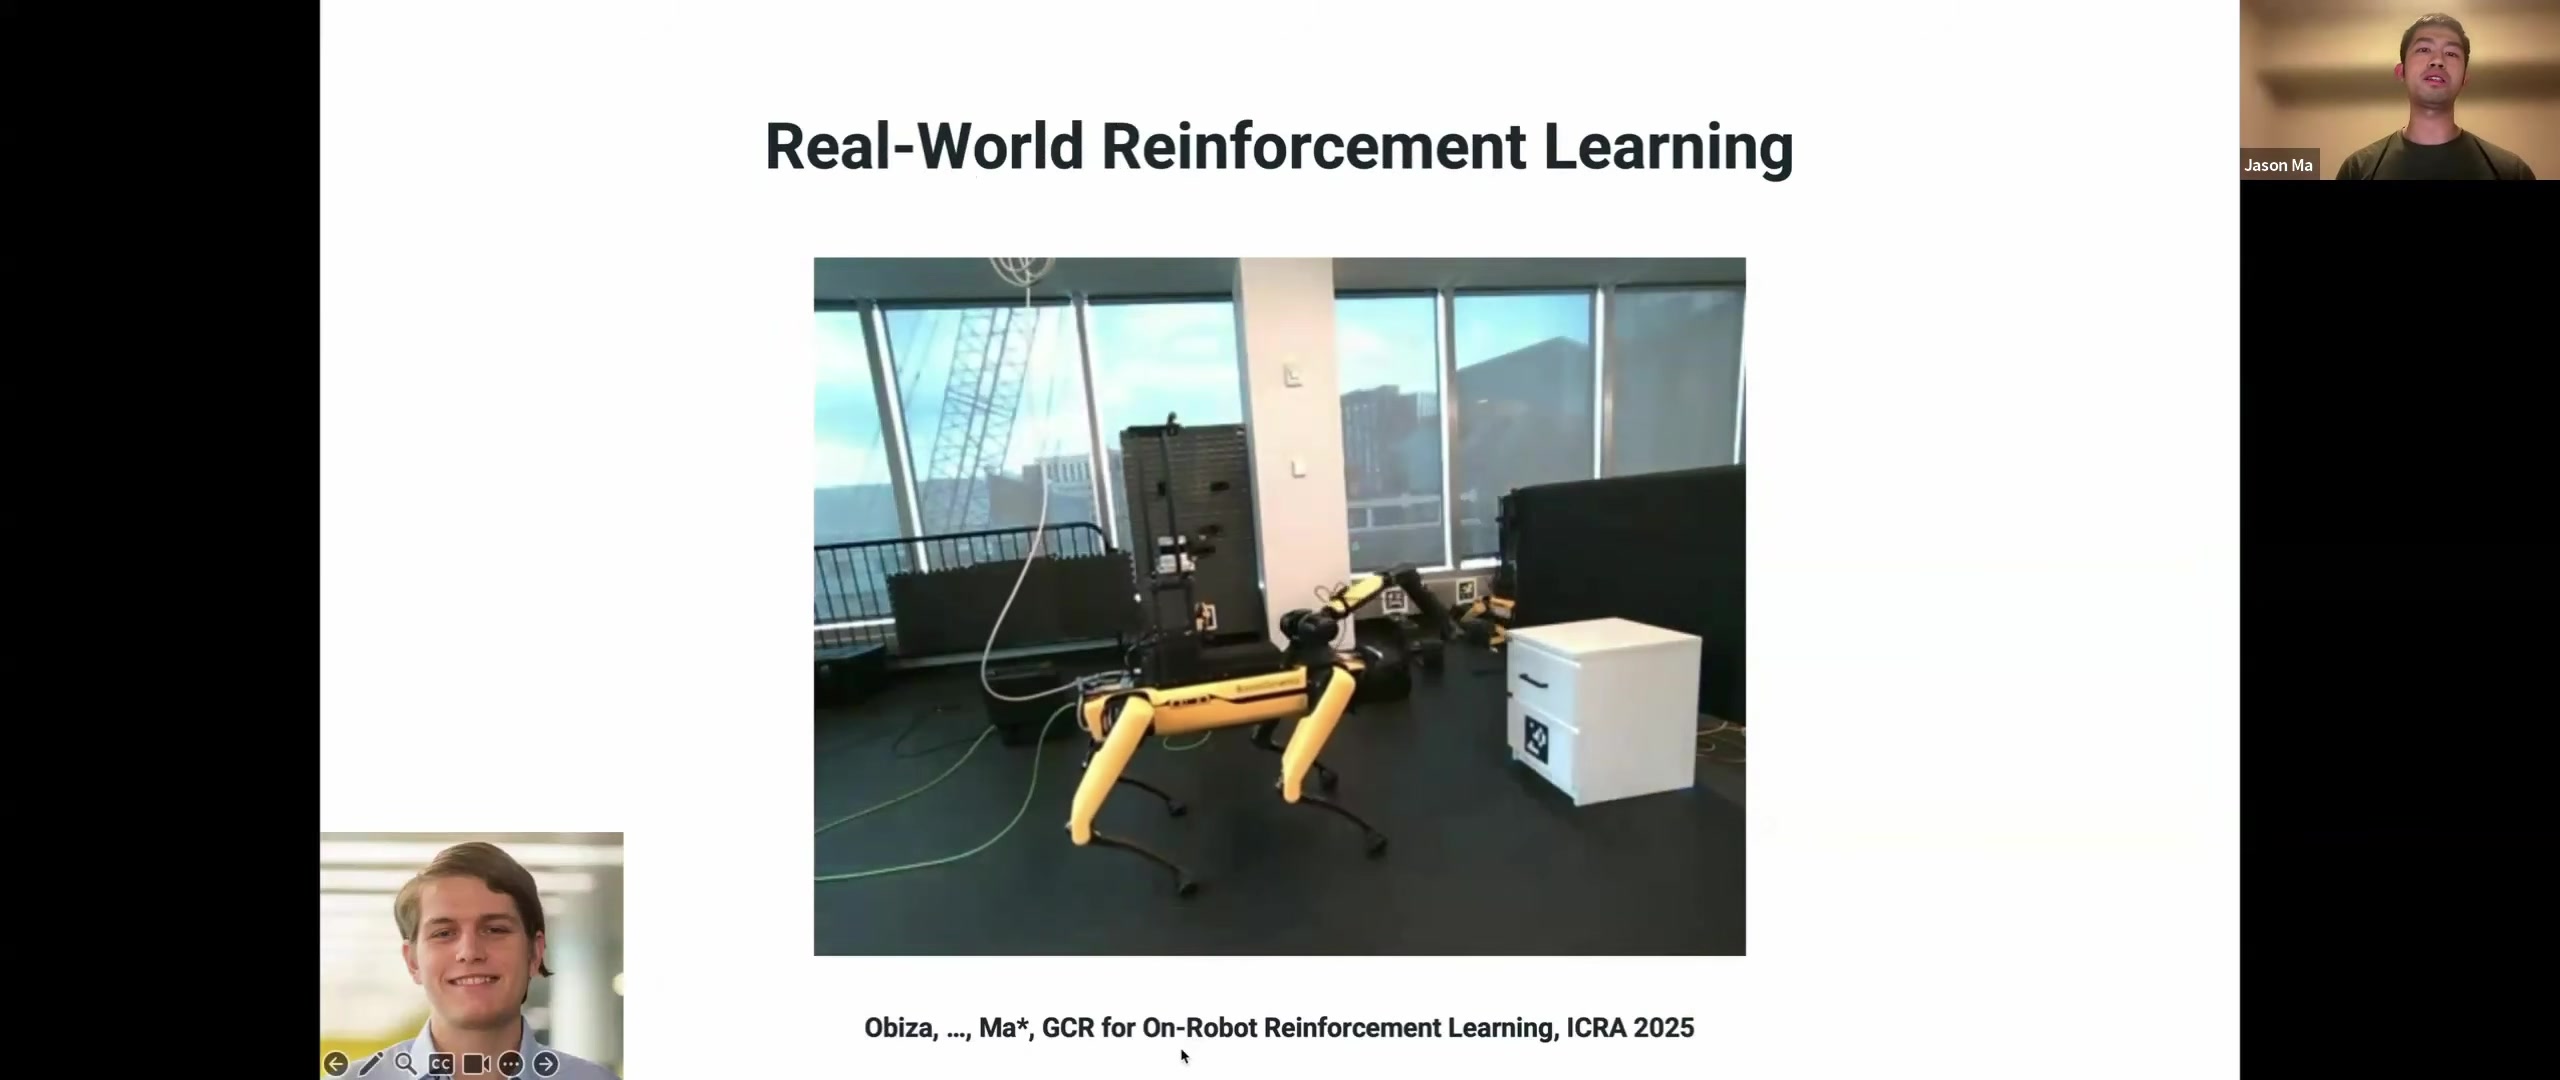
학습한 보상 모델로 로봇이 서랍 열기 정책을 처음부터 학습하도록 감독할 수 있었다. 그러나 Ma는 이 방법을 오늘날 기준으로 “상당히 비효율적”이라고 평가한다. 가능한 연구 결과와 배치 가능한 제품 사이에는 로봇 시간, 실패 복구, 데이터 운영이라는 별도의 문제가 있었기 때문이다.
Evidence 02
현장 사례 · 고객 사이트와 공개 데모
Dyna의 창업 동기는 연구실에서 유효했던 아이디어를 실제 고객 환경으로 옮겼을 때 무엇이 깨지는지 확인하는 것이었다. Ma가 제시한 배치 기준선은 70~80%가 아니라 99.9%에 가까운 신뢰성이다. 논문이나 짧은 데모에서 허용되는 작은 실패율도 하루 수백 번 반복되는 작업에서는 지속적인 운영 중단으로 누적된다.
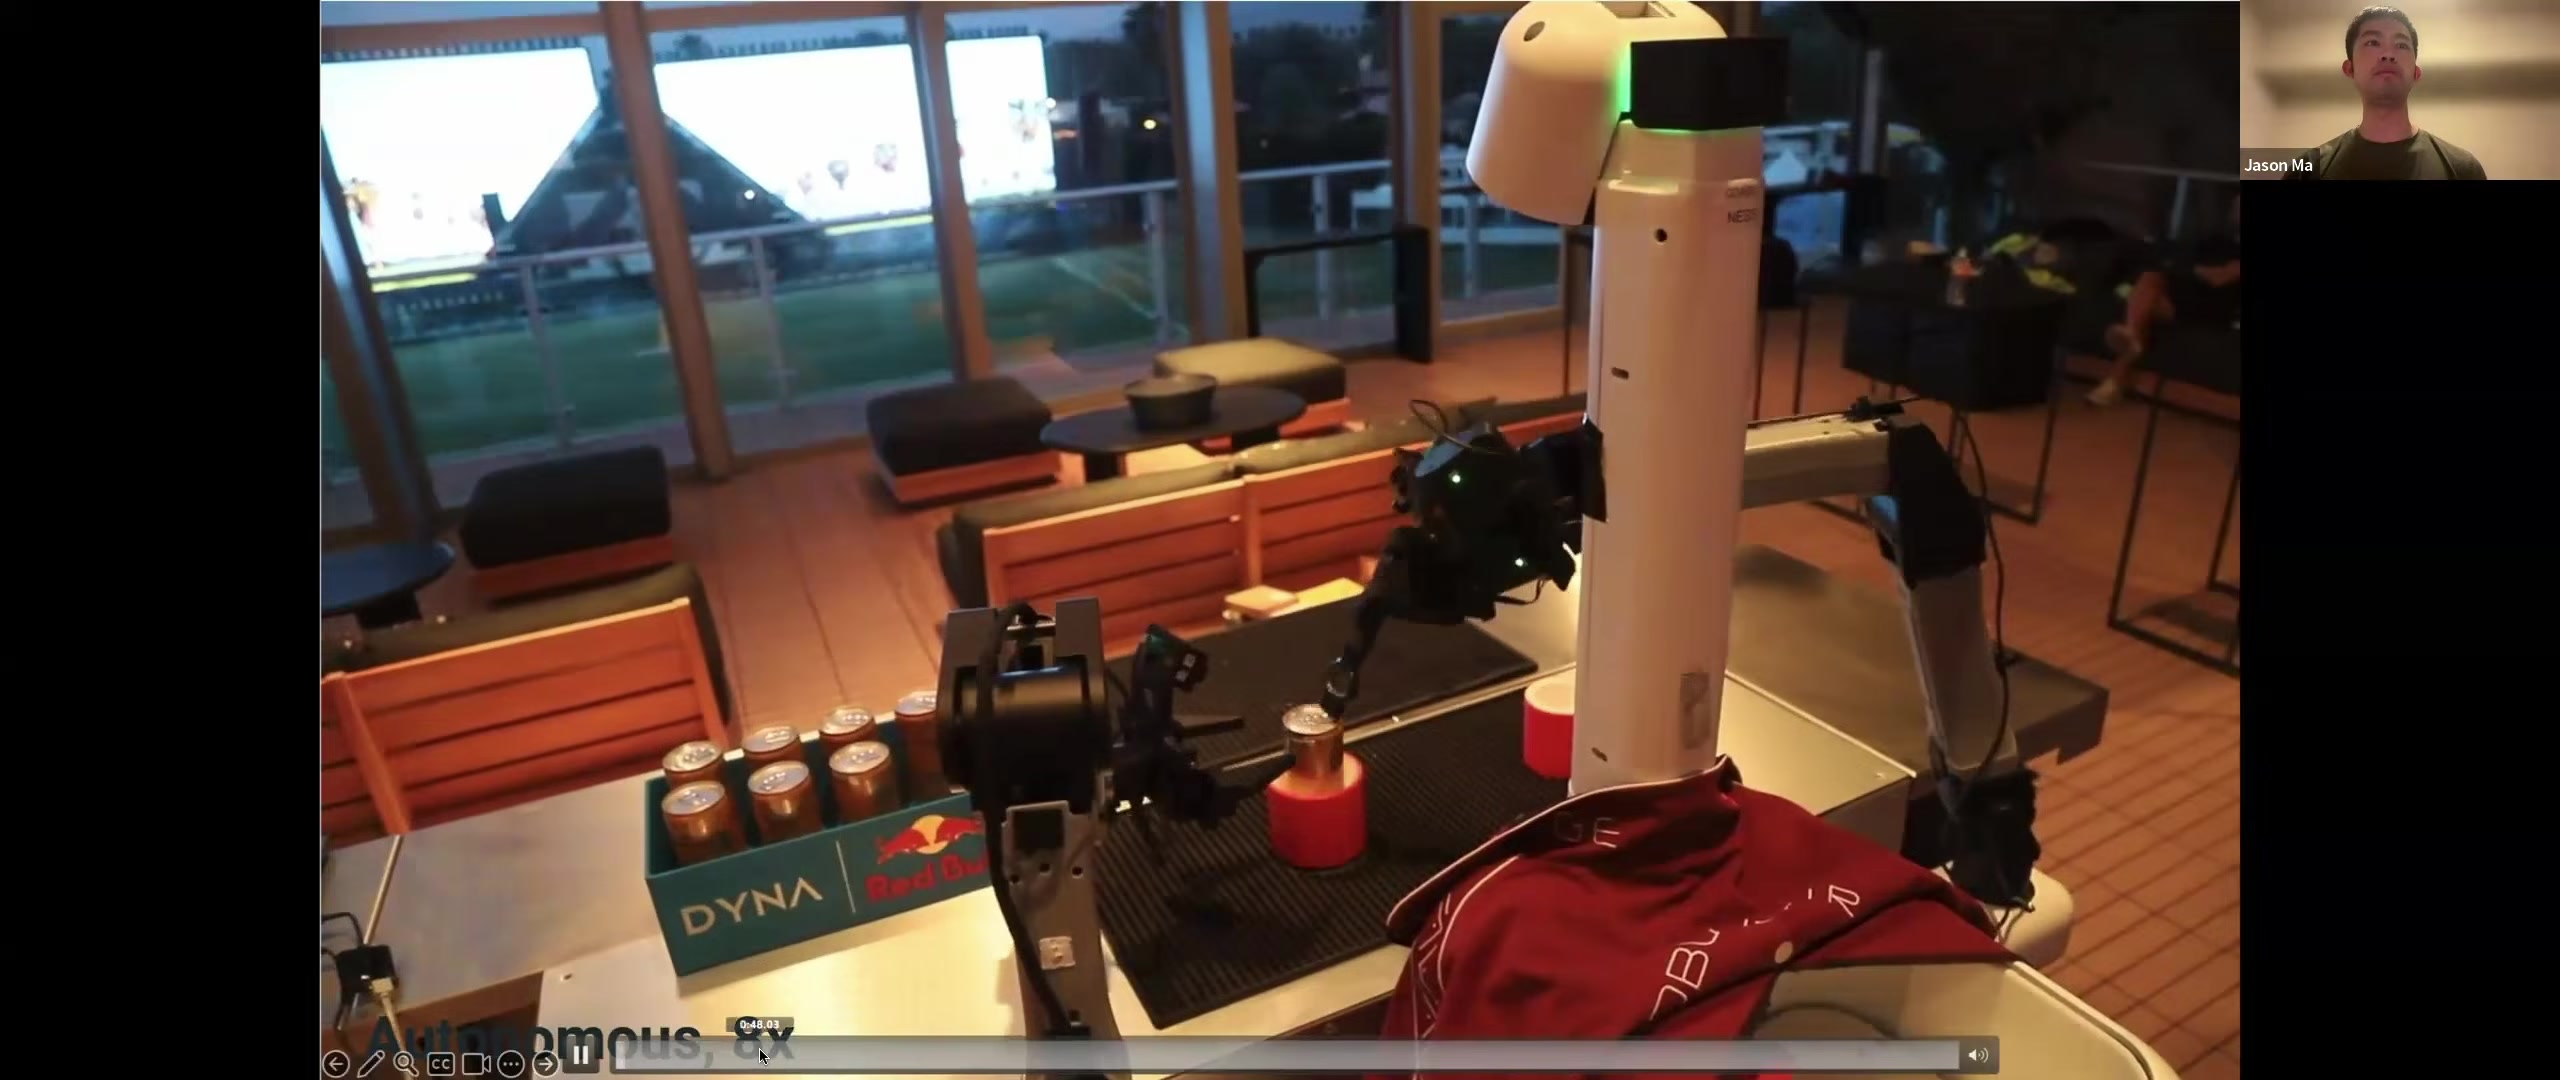
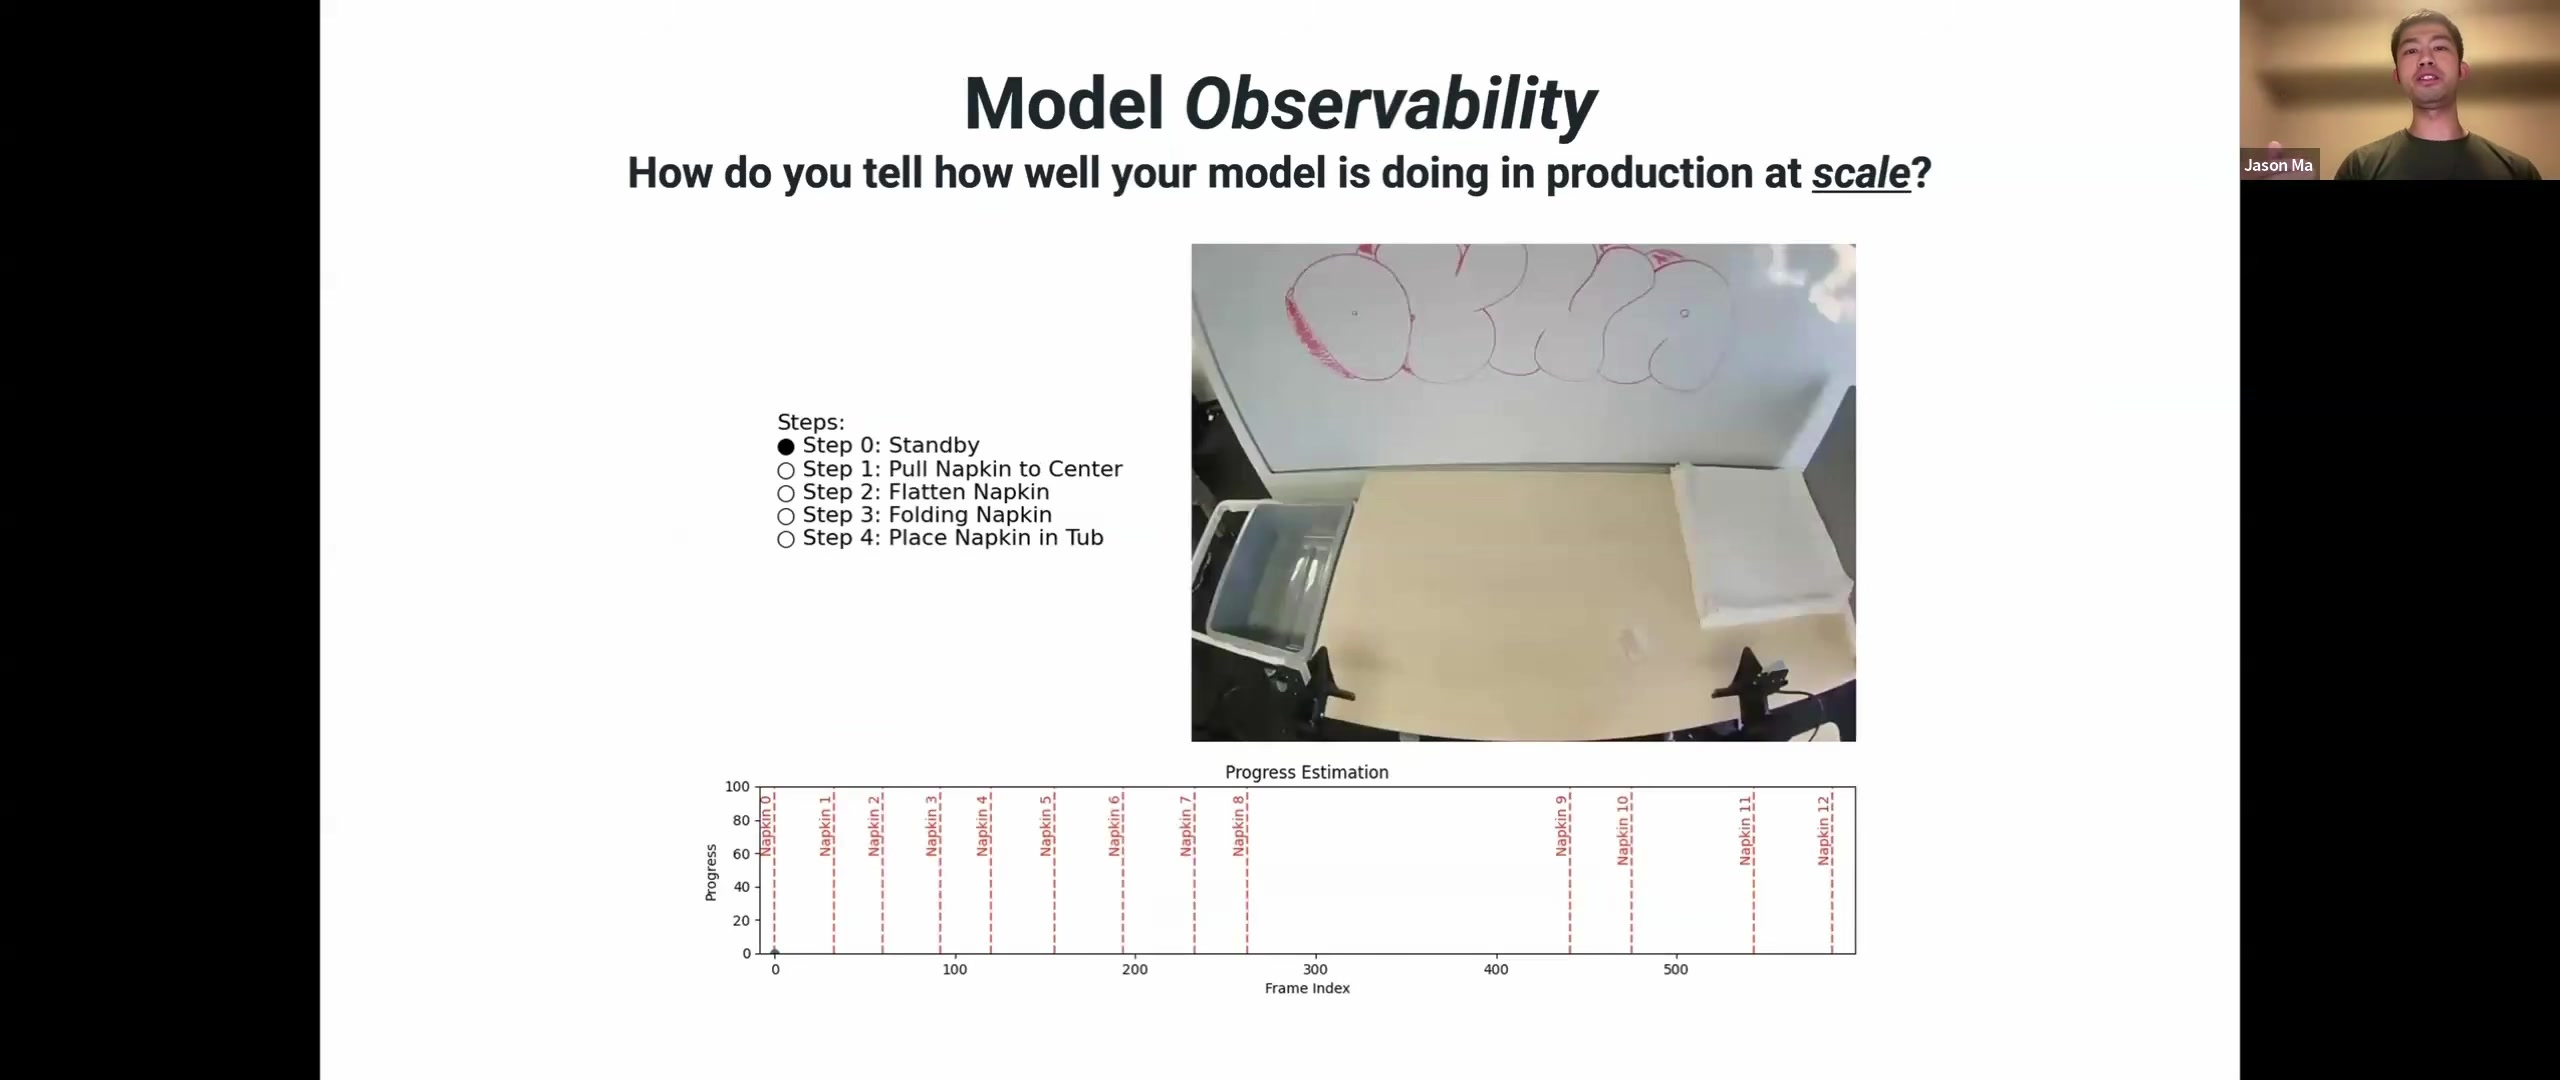
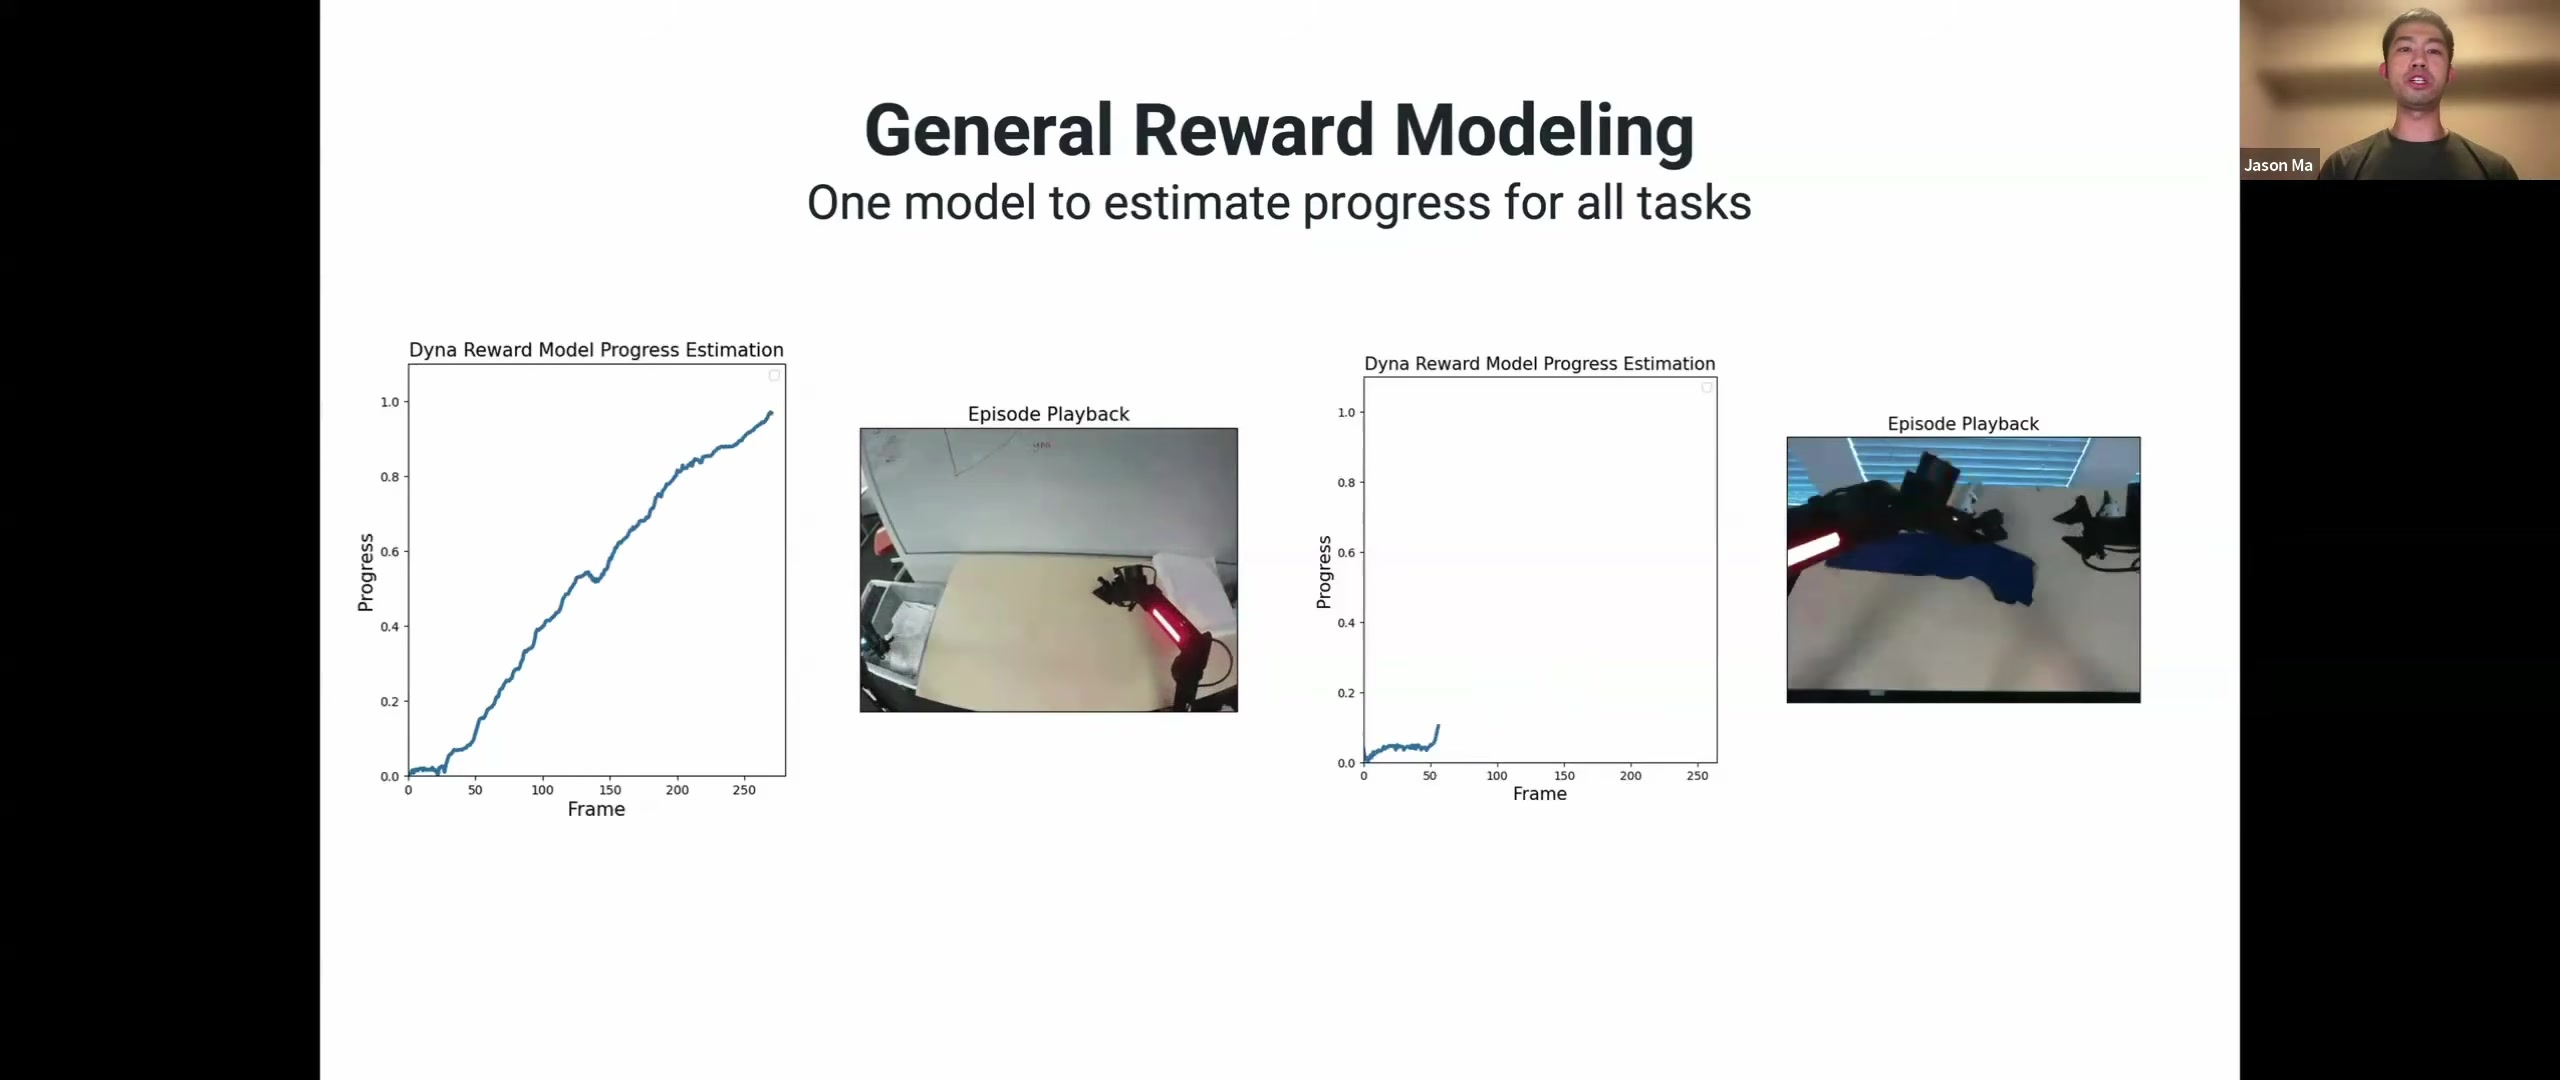
Dyna의 진행도 모델은 단순한 pick-and-place를 넘어 티셔츠와 냅킨 접기처럼 1분 이상 이어지는 변형체 조작의 진행도를 추정했다. 장기 과제에서는 단순한 성공·실패 라벨보다 “어느 시점에서 진전이 멈췄는가”가 훨씬 유용한 운영 정보가 된다.
팀은 범용 로봇 문제와 프로덕션 시스템 문제를 동시에 풀지 않기 위해 범위를 좁혔다. 레스토랑 뒷방에서 하루 수백 번 반복되고 수요가 명확한 냅킨 접기를 선택했다. 이는 단순한 데모 선정이 아니라 상업적 학습 전략이었다. 과제의 범위를 고정해야 처리량, 신뢰성, 비용, 원격 운영 같은 시스템 변수를 별도로 최적화할 수 있기 때문이다.
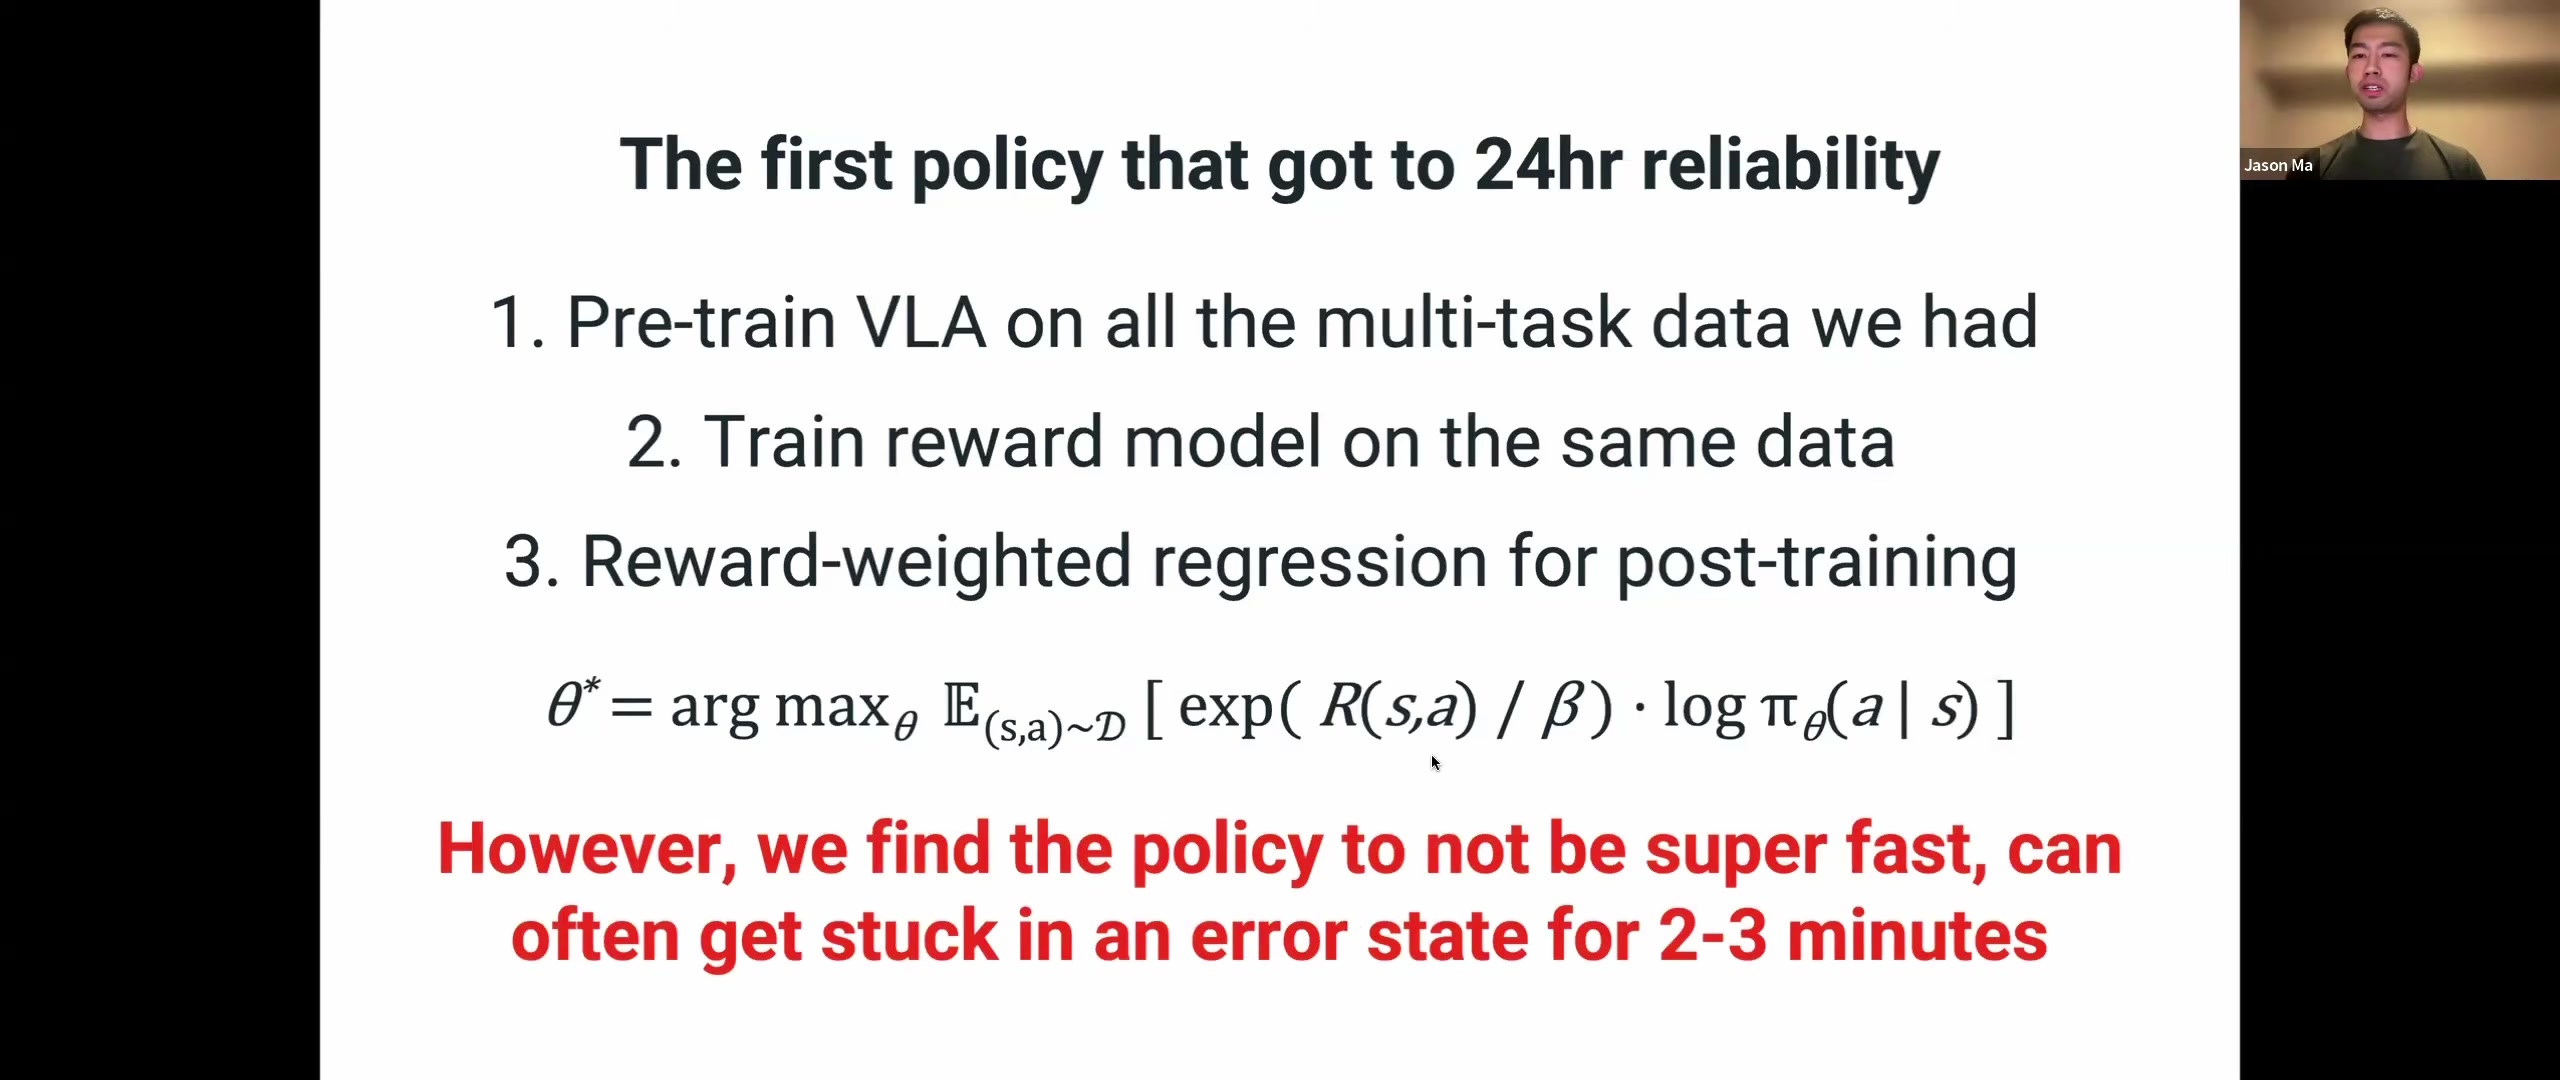
초기 레시피는 세 단계였다. 멀티태스크 데이터로 VLA를 사전학습하고, 같은 데이터로 보상 모델을 학습한 뒤, 보상이 높다고 평가한 샘플에 더 큰 가중치를 주는 reward-weighted regression으로 정책을 후속 학습했다. 온라인 탐색을 사용하지 않은 오프라인 RL이다.
이 정책은 장시간 신뢰성을 달성했지만 에러 상태에서 2~3분씩 멈췄다. “끝까지 성공한다”는 조건은 만족했어도 한 시간에 처리할 수 있는 냅킨 수가 부족했다. 프로덕션에서는 성공률과 함께 복구 시간과 처리량이 독립적인 KPI라는 사실이 드러났다.
Evidence 03
핵심 방법 · Human-in-the-loop active learning
정상 작업에서는 진행도 점수가 대체로 0에서 1을 향해 상승한다. 로봇이 실수하거나 멈추면 이 단조 증가 패턴이 깨진다. Dyna는 정책과 보상 모델을 동시에 실행해 이상 구간을 자동 표시하고, 데이터 수집 인력을 바로 그 실패 상태에 투입했다.
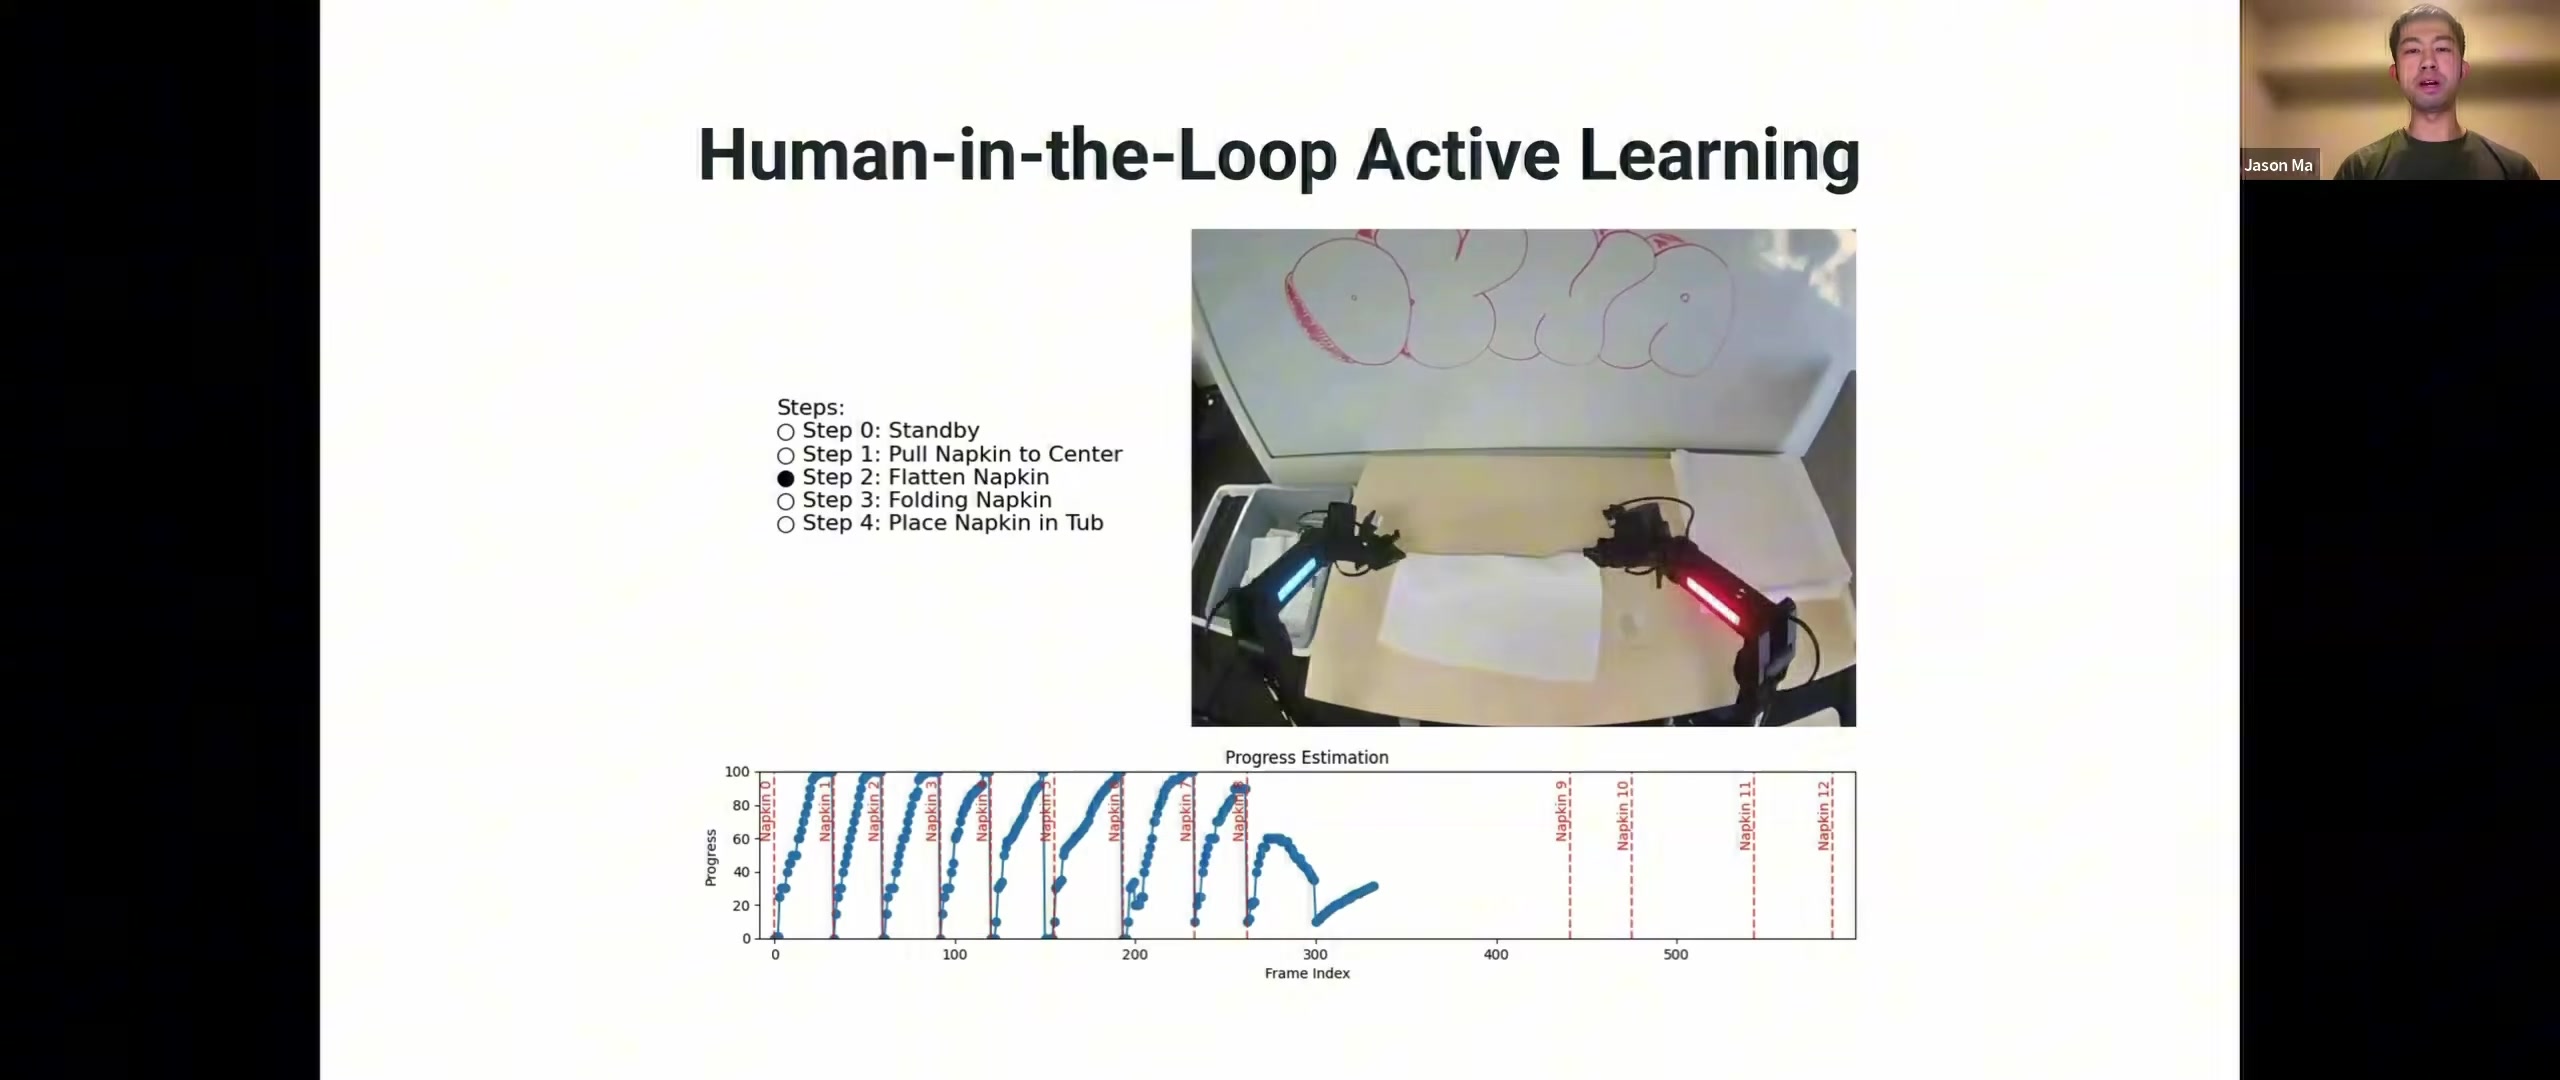
보상 모델의 가장 큰 가치는 정책에 점수를 주는 것이 아니라, 사람의 시간을 어디에 쓸지 알려주는 데 있었다.
발표 내용에 대한 본 보고서의 핵심 해석능동 학습 루프를 거친 DYNA-1은 24시간 무중단 시험에서 냅킨 850장 이상을 접었고 99.4% 성공률을 기록했다. Ma는 발표 시점의 처리량이 이 시험보다 다시 약 80% 개선됐으며, 사무실에서 네 차례 진행한 24시간 시험도 모두 좋은 결과를 보였다고 설명했다. 수치는 발표자가 보고한 결과이며 독립적인 외부 검증치는 아니다.
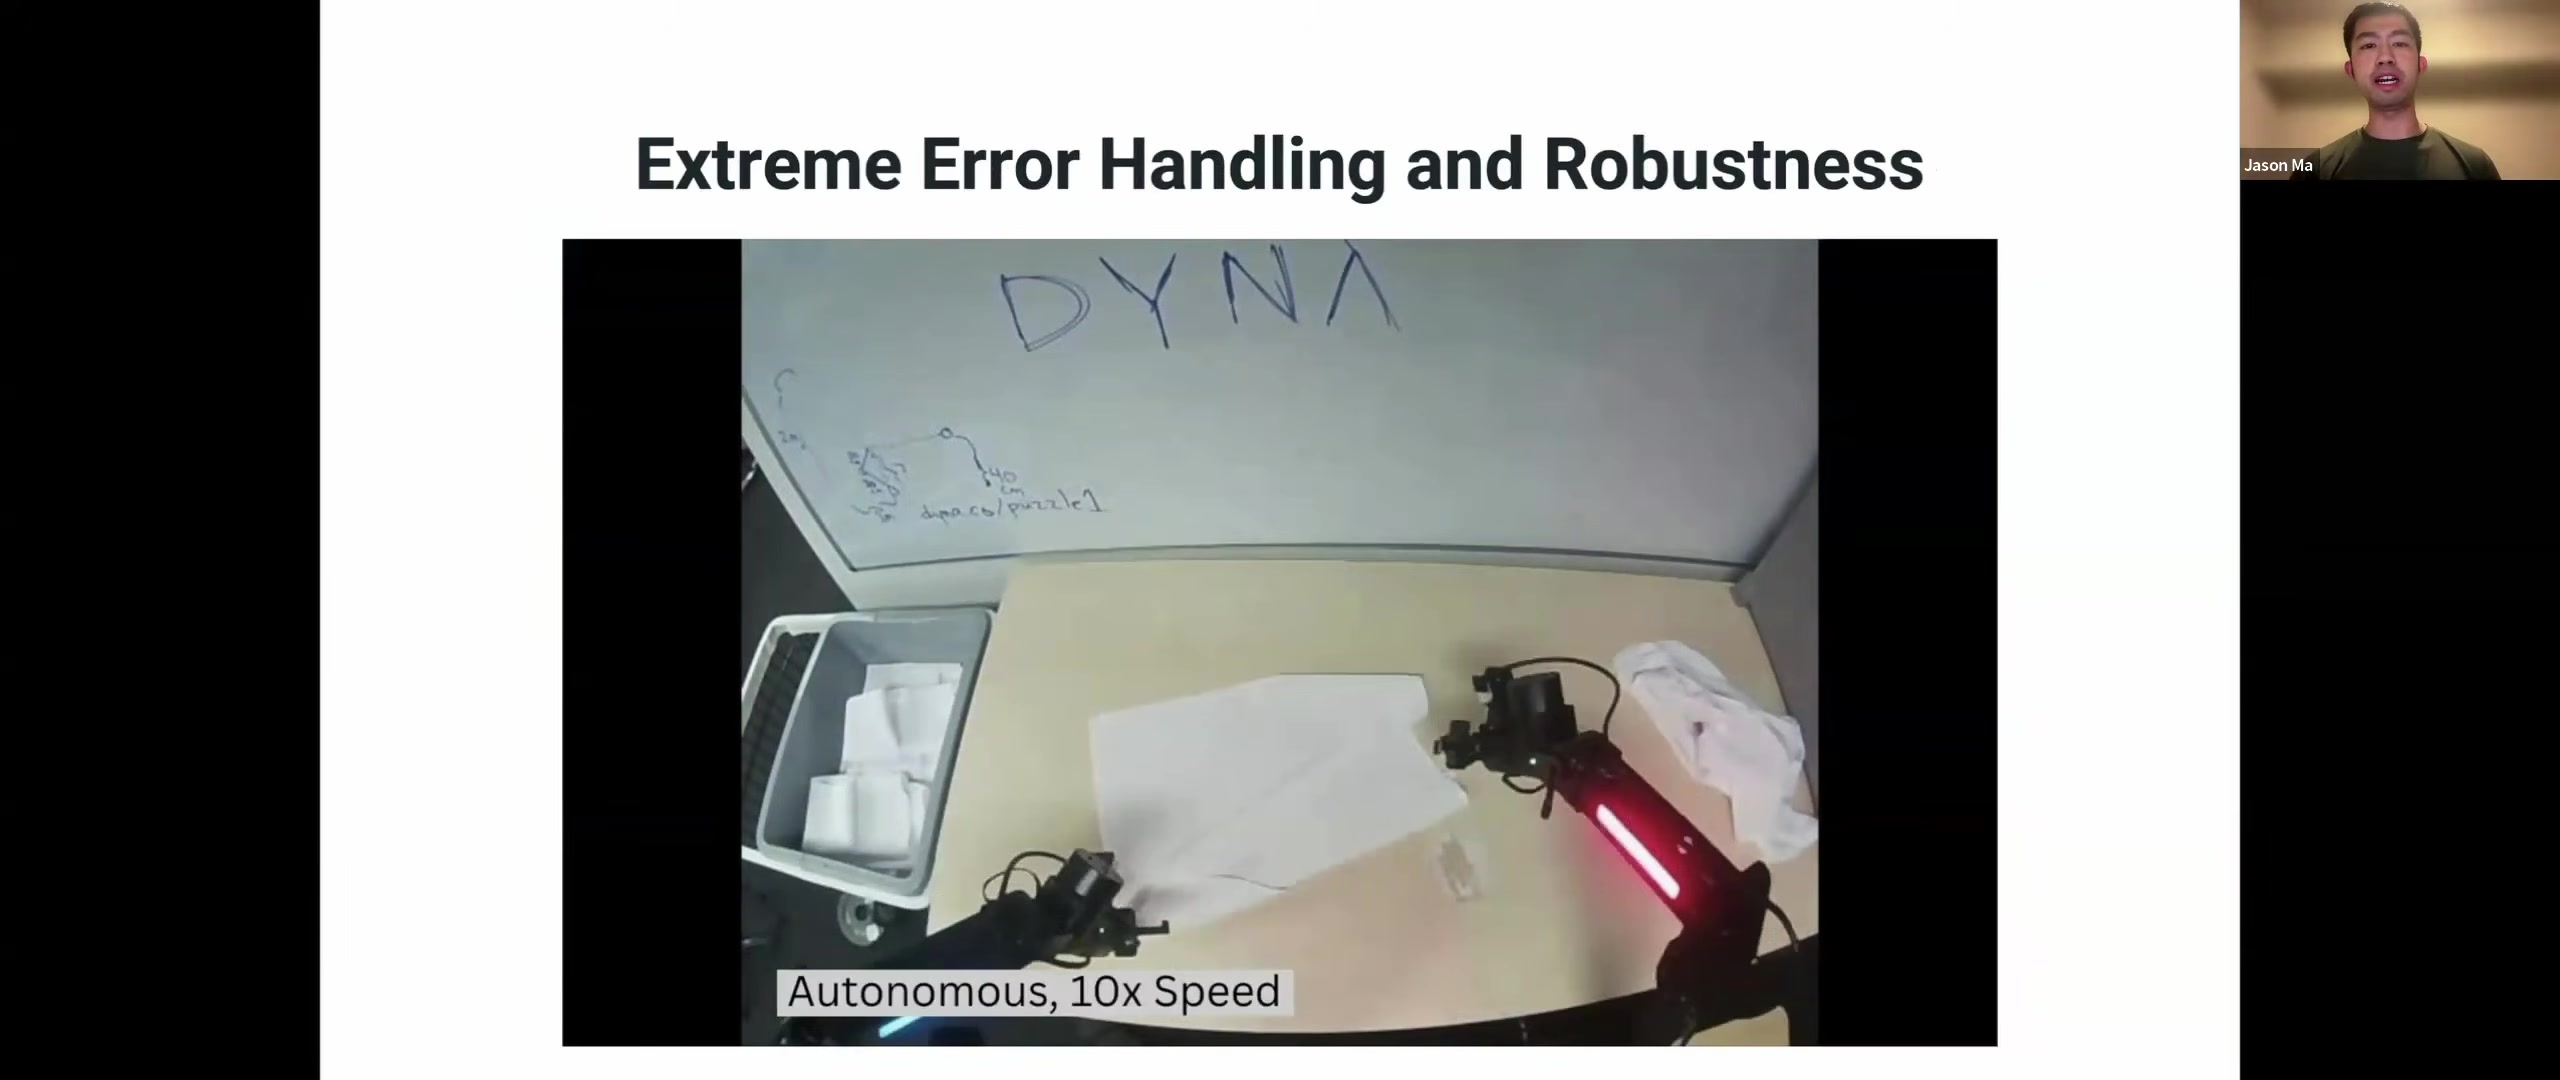
촬영 도중 로봇이 냅킨 더미 전체를 쓰러뜨리는 심각한 실패가 발생했지만, 정책은 스스로 상태를 수습하고 작업을 이어갔다. 모든 실패를 열거하기 어려운 변형체 조작에서 몇 차례의 능동 수집만으로 훈련 데이터에 없던 실수까지 회복이 일반화됐다는 점을 Ma는 가장 놀라운 결과로 꼽았다. 다만 발표에는 이러한 일반화가 발생한 원인이나 체계적인 범위 분석은 포함되지 않았다.
| 접근 | 로봇 시간의 사용 | 주요 효용 | 프로덕션 위험 |
|---|---|---|---|
| 실세계 온라인 RL | 환경에서 탐색하고 시행착오를 축적 | 사람이 제공하기 어려운 행동 발견 가능 | 느린 탐색, 안전 부담, 장비 점유 |
| 오프라인 RWR | 기존 데이터에 보상 기반 가중치 적용 | 온라인 탐색 없이 신뢰성 개선 | 데이터 밖의 실패 상태가 남을 수 있음 |
| 사람 개입형 능동 학습 | 모델이 어려워하는 구간에만 수집 집중 | 처리량과 에러 회복을 빠르게 개선 | 운영 인력과 정확한 이상 탐지가 필요 |
| 표준 SFT | 작은 과제별 데이터로 정책 적응 | 시스템과 기반 모델이 충분할 때 단순하고 효율적 | 기반 표현과 데이터 품질에 크게 의존 |
Evidence 04
발표 후반부에서 Ma는 자신의 견해를 명시적으로 “hot take”라고 부른다. 그가 RL 자체를 부정하는 것은 아니다. 현재 프로덕션 조작이 아직 인간 수준에 못 미치는 상황에서, 초인적 최적화를 위해 강점을 발휘하는 RL을 먼저 적용하는 것이 자원 배분상 최선인지 묻는다.
Dyna가 실세계 RL에 기대했던 문제는 결과적으로 더 나은 엔지니어링, 사전학습, 하드웨어, 데이터 인프라로 해결됐다. 시스템이 개선된 뒤에는 한 시간 미만의 과제별 데이터와 표준 지도 후속 학습만으로 이전보다 좋은 결과를 얻었다고 한다. 이 사례에서 RL의 비중은 제품이 발전할수록 커지지 않고 오히려 줄었다.
다만 이 결론은 “현재 조작 성능이 사람 이하”라는 조건에 묶여 있다. 사람이 쉽게 시범을 제공할 수 없거나 초인적 성능이 필요한 단계에 도달하면 탐색과 장기 최적화의 상대적 가치가 다시 커질 수 있다. 따라서 더 정확한 해석은 “RL이 불필요하다”가 아니라 “현재의 프로덕션 병목을 확인하기 전에 RL부터 선택하지 말라”에 가깝다.
Evidence 05
운영 시스템 · Progress-based observability
여러 고객 사이트에서 로봇이 자율로 작동하면 엔지니어는 모든 영상을 볼 수 없다. 성공률을 계산하려면 먼저 작업의 시작과 종료를 알아야 하고, 문제가 발생한 구간을 수십 시간의 영상에서 찾아야 한다. 보상 모델은 이때 학습 신호가 아니라 운영 관측성 계층이 된다.
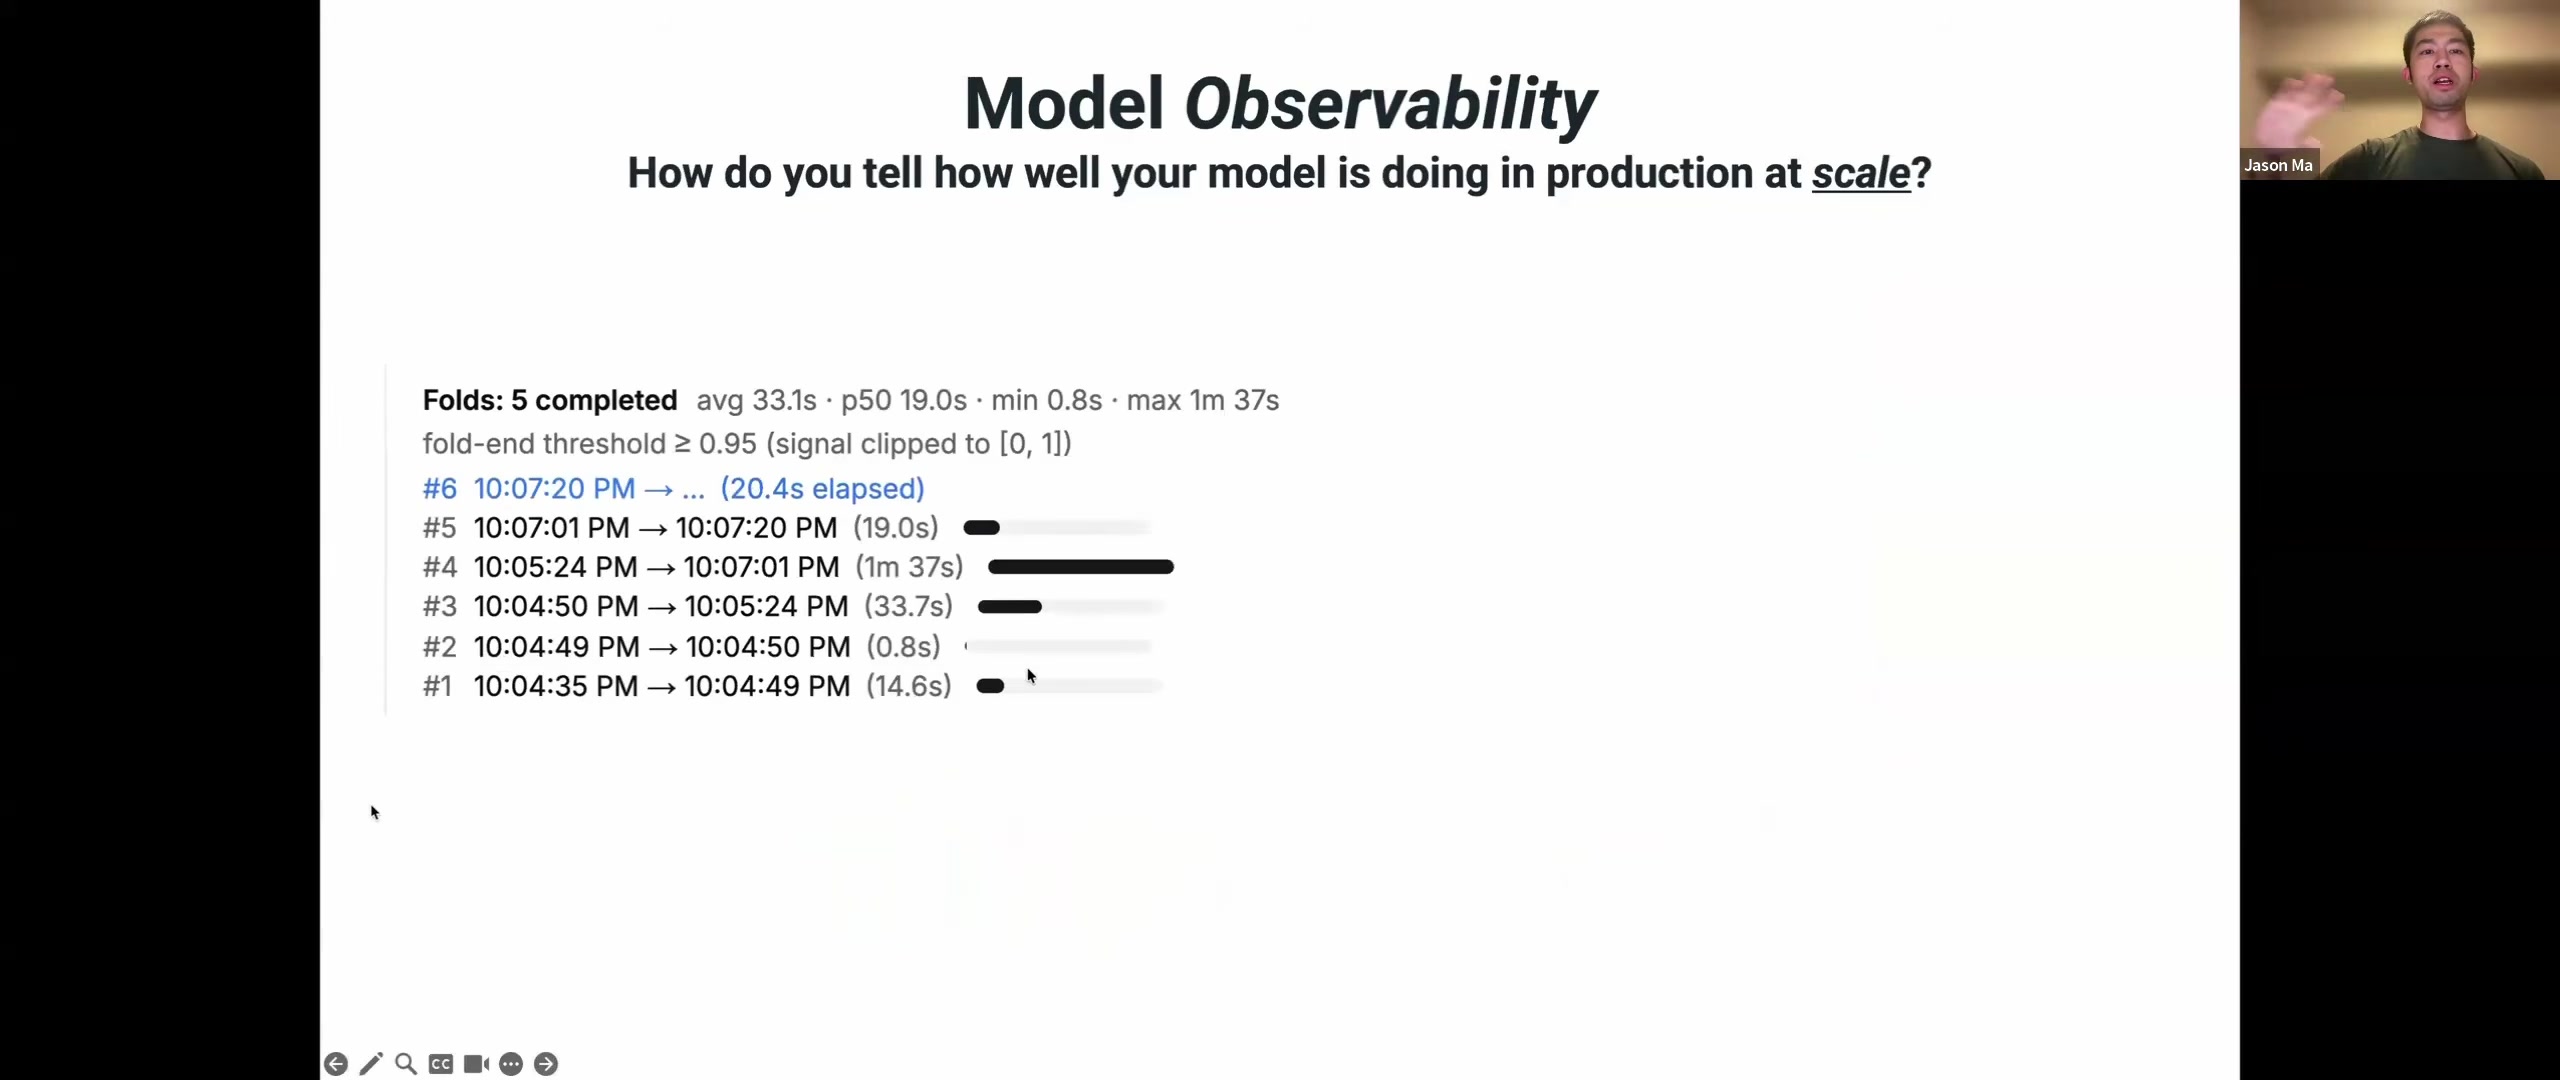
진행도가 0에서 1로 상승하면 한 번의 접기 사이클이고, 다시 0으로 돌아가면 새 작업의 시작으로 해석할 수 있다. 이 신호만으로 완료 건수, 평균·중앙값 소요 시간, 긴 정체 구간을 자동 산출할 수 있다. 정책과 진행도 추정기를 분리하면 정책이 계속 후속 학습되더라도 모니터링 기준선은 안정적으로 유지할 수 있다.
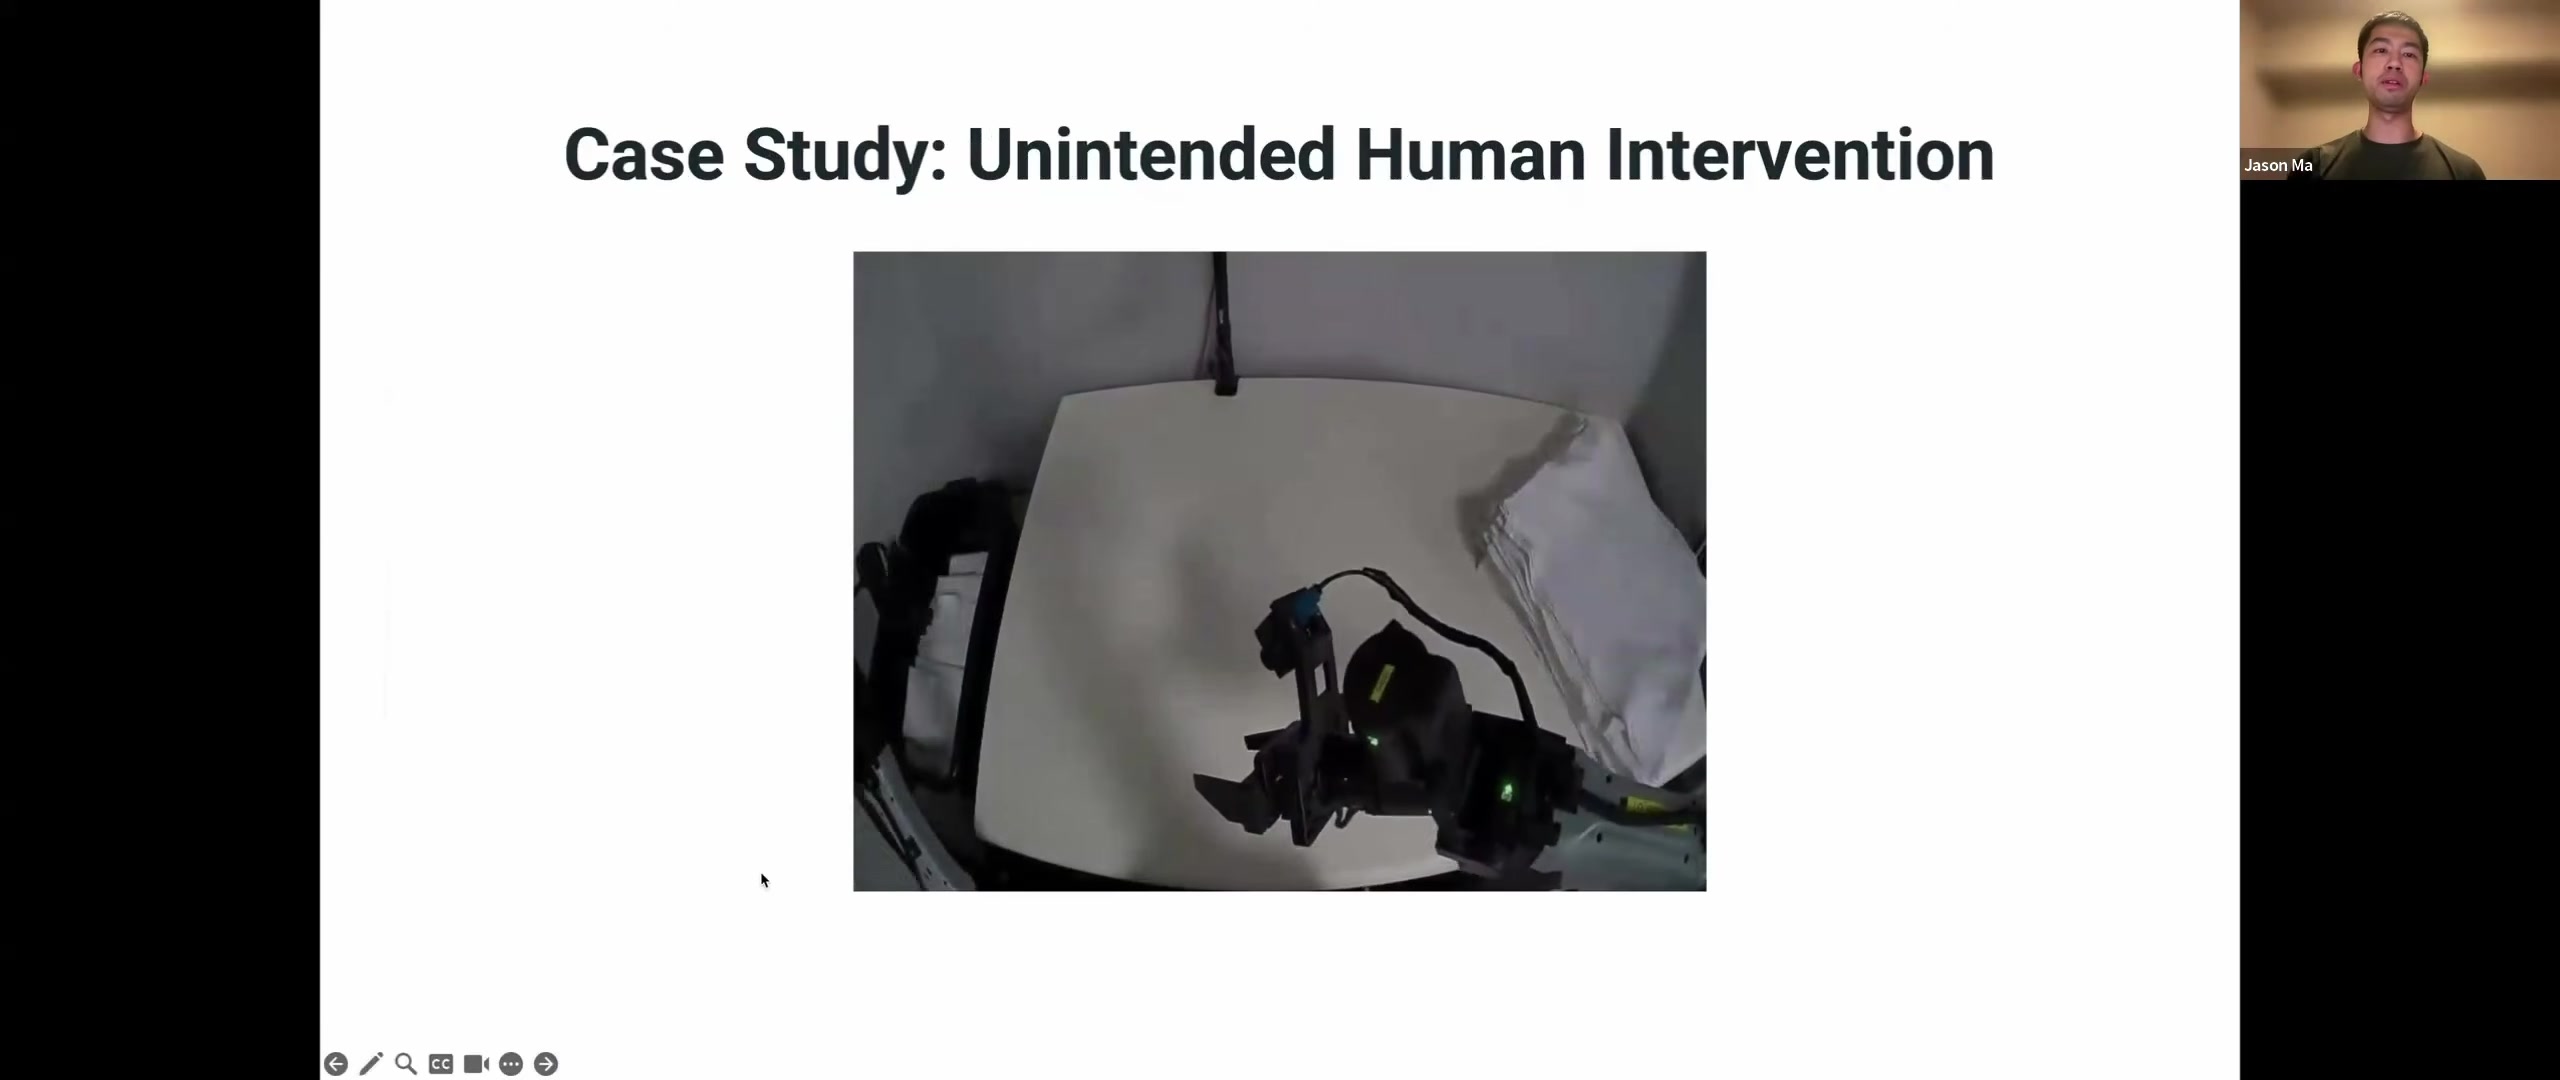
중앙값이 약 25초인 작업에서 14~15초 만에 끝난 기록이 발견됐다. 해당 영상만 추출해 확인하자 호기심 많은 식당 직원이 냅킨을 로봇 앞에 놓아준 장면이었다. 모델은 이를 비정상적으로 빠른 성공으로 기록했다. 이상 탐지 도구가 없었다면 엔지니어는 최대 16시간 분량의 영상을 직접 훑어야 했다.
가장 성능이 좋은 ‘RL 시스템’은 RL보다 시스템에 더 집중한다.
Jason Ma 발표의 결론을 한국어로 요약
Implications
냅킨 접기와 굴착·상차는 규모와 위험이 크게 다르다. 그러나 실제 현장에서 값을 만들고 원격으로 운영해야 한다는 시스템 조건은 닮아 있다. 특히 안전상 무작위 탐색이 불가능한 중장비에서는 이 발표의 데이터 운영 방식이 더 직접적인 의미를 가진다.
| 냅킨 접기 시스템 | 중장비 적용 예 | 관측 가능한 KPI |
|---|---|---|
| 진행도 0→1 | 굴착→선회→배출→복귀 사이클 | 사이클 완료 수, 평균·중앙값 시간 |
| 진행도 정체 또는 하락 | 버킷 진입 실패, 토질 변화, 장애물 회피 | 정체 시간, 수동 개입률, 복구 성공률 |
| 빠르거나 느린 이상치 | 불완전 적재, 작업자 개입, 예외 경로 | 이상 사이클 자동 추출 및 검토 우선순위 |
| 능동 데이터 수집 | 숙련 오퍼레이터가 실패 상태에서 복구 시범 제공 | 수집 시간당 신규 실패 유형, 재발률 감소 |
롱테일 실패를 찾으려면 결국 최신 정책을 현장에서 실행해야 한다. 차이는 사람이 계속 지켜보는 대신 예상보다 오래 걸린 구간만 나중에 추출한다는 점이다. 필요하다면 장면을 의도적으로 교란해 실패를 유도할 수도 있다. 반복 과정에서 모델의 취약 패턴을 알게 되면 탐색 주기도 짧아진다.
변형체 시뮬레이션은 현실과의 물리 차이가 크고, 충실도를 높이면 속도가 크게 떨어진다. Dyna는 냅킨 접기에서는 시뮬레이터를 조정하는 것보다 실세계 반복이 더 빨랐다고 판단했다. 반대로 사람과 장비의 안전이 중요한 도메인에서는 Real-to-Sim-to-Real 경로의 가치가 더 커질 수 있다.
VLA에 진행도 예측 헤드를 함께 붙이는 것은 표현 학습에는 도움이 될 수 있지만, 운영 기준선의 안정성을 위해 정책과 모니터를 분리하는 편이 낫다는 조언도 주목할 만하다. 정책이 새 데이터로 계속 변할 때 모니터까지 함께 표류하면 장기간의 성능 비교가 어려워진다.
Limitations & Source Notes
Closing Perspective
이 발표의 가장 이식성 높은 아이디어는 특정 RL 알고리즘이 아니다. 학습을 위해 만든 진행도 모델을 데이터 수집의 우선순위 결정, 원격 모니터링, 사이클 통계, 이상치 추출에 연속적으로 재사용한 시스템 설계다.
프로덕션에서 좋은 모델은 더 높은 벤치마크 점수만 내는 모델이 아니다. 실패했을 때 무엇이 잘못됐는지 알려주고, 다음 데이터 한 시간을 어디에 써야 하는지 결정하며, 현장에 배치된 뒤에도 오늘 제대로 일했는지를 설명할 수 있어야 한다.
먼저 로봇을 인간 수준으로 신뢰할 수 있게 만들고, 그다음 인간을 넘어서는 최적화를 묻는다.