Abstract
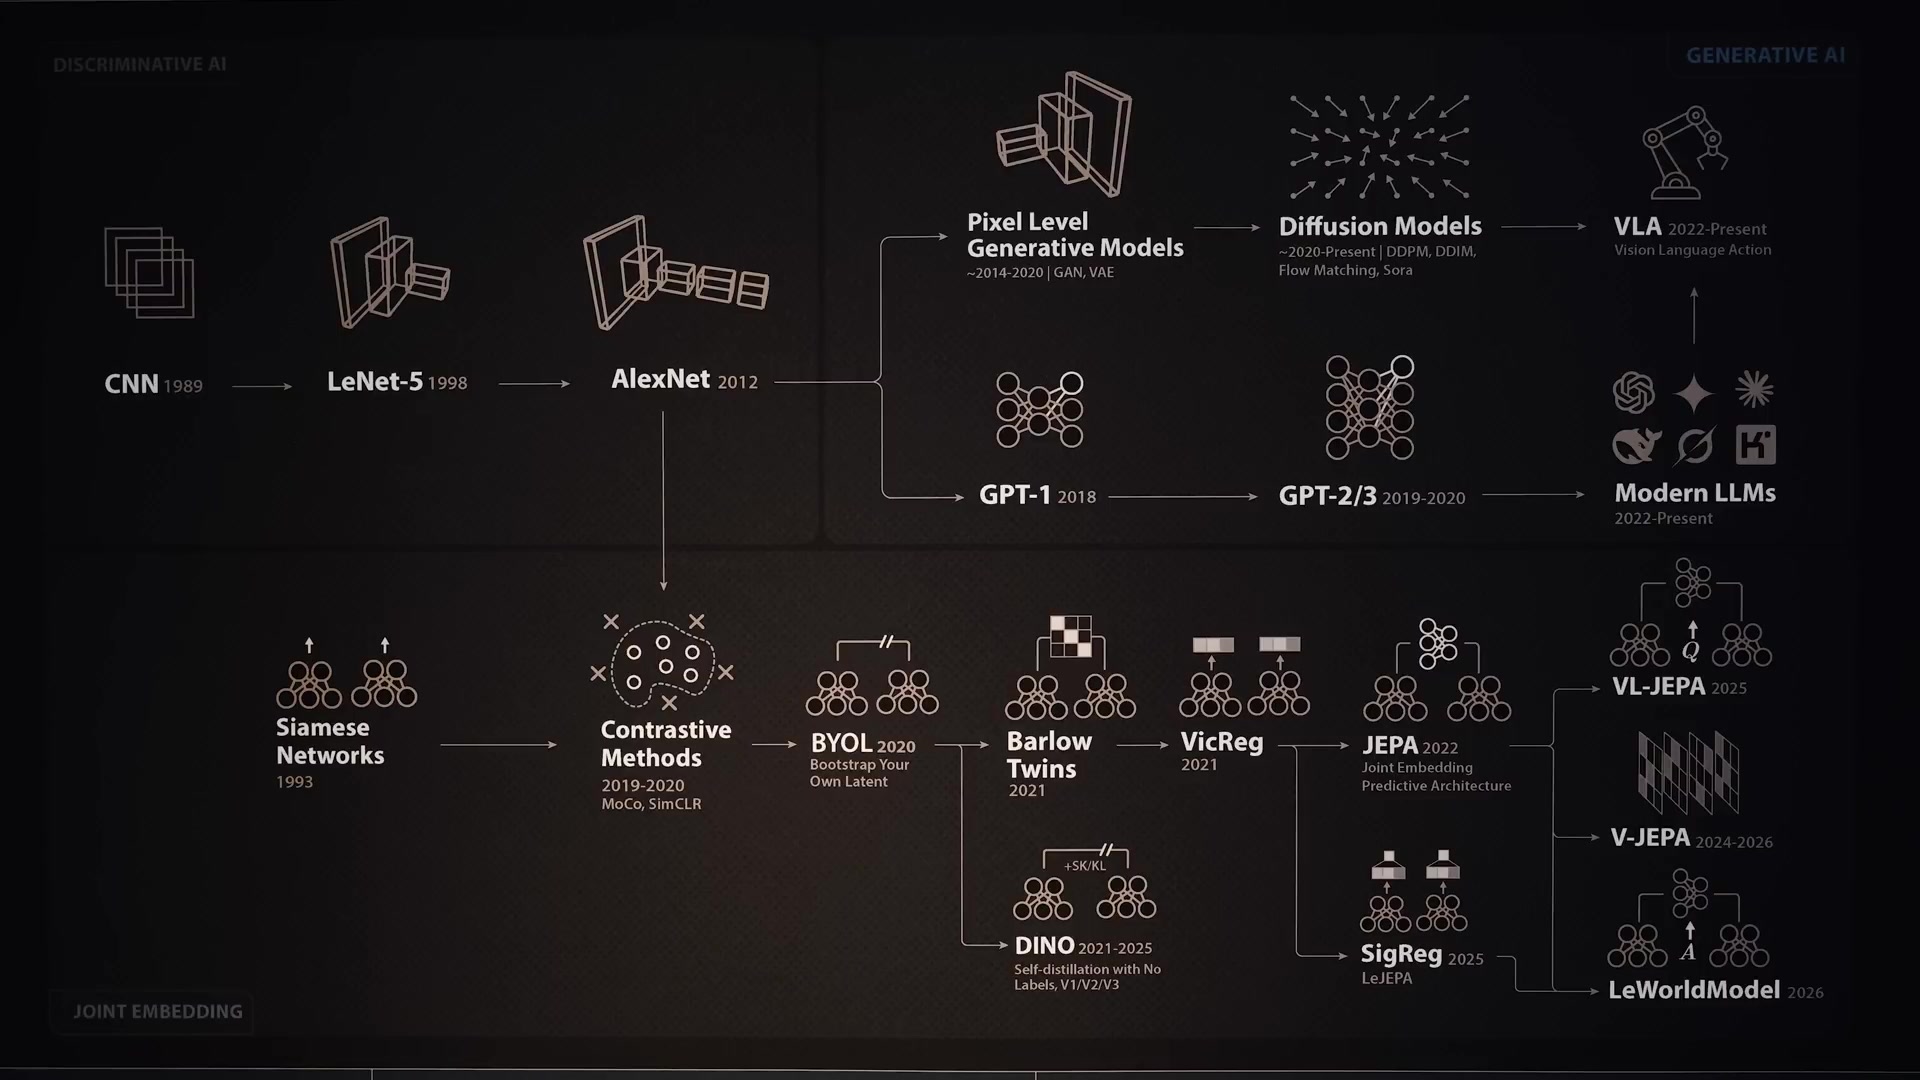
이 보고서의 결론은 양쪽 모두에 냉정하다. 언어 감독 없이 비디오를 학습한 V-JEPA 2는 인식과 시간적 이해에서 최상위권 성능을 보이고, VL-JEPA는 출력 문장 대신 의미 임베딩을 예측해 학습 효율을 크게 높인다. 하지만 행동 조건부 월드 모델의 로봇 제어는 아직 VLA보다 극적으로 뒤처진다. LeCun의 베팅이 겨냥하는 것은 현재의 승자가 아니라, 행동하기 전에 결과를 예측하고 탐색할 수 있는 장기적 시스템 구조다.
Executive summary
먼저 읽는 다섯 가지 결론
JEPA의 성과는 층별로 다르다
비전 인코더, 비전-언어, 로봇 제어를 하나의 승패로 묶으면 핵심을 놓친다. 인식에서는 강하고, 제어에서는 아직 약하다.
언어 없이 배운 표현도 언어 모델과 결합된다
V-JEPA 2는 비디오 100만 시간으로 세계의 시각적 변화를 학습한 뒤 LLM과 정렬해 여러 비디오 벤치마크에서 SOTA급 결과를 냈다.
VL-JEPA의 장점은 ‘절대 승리’보다 효율
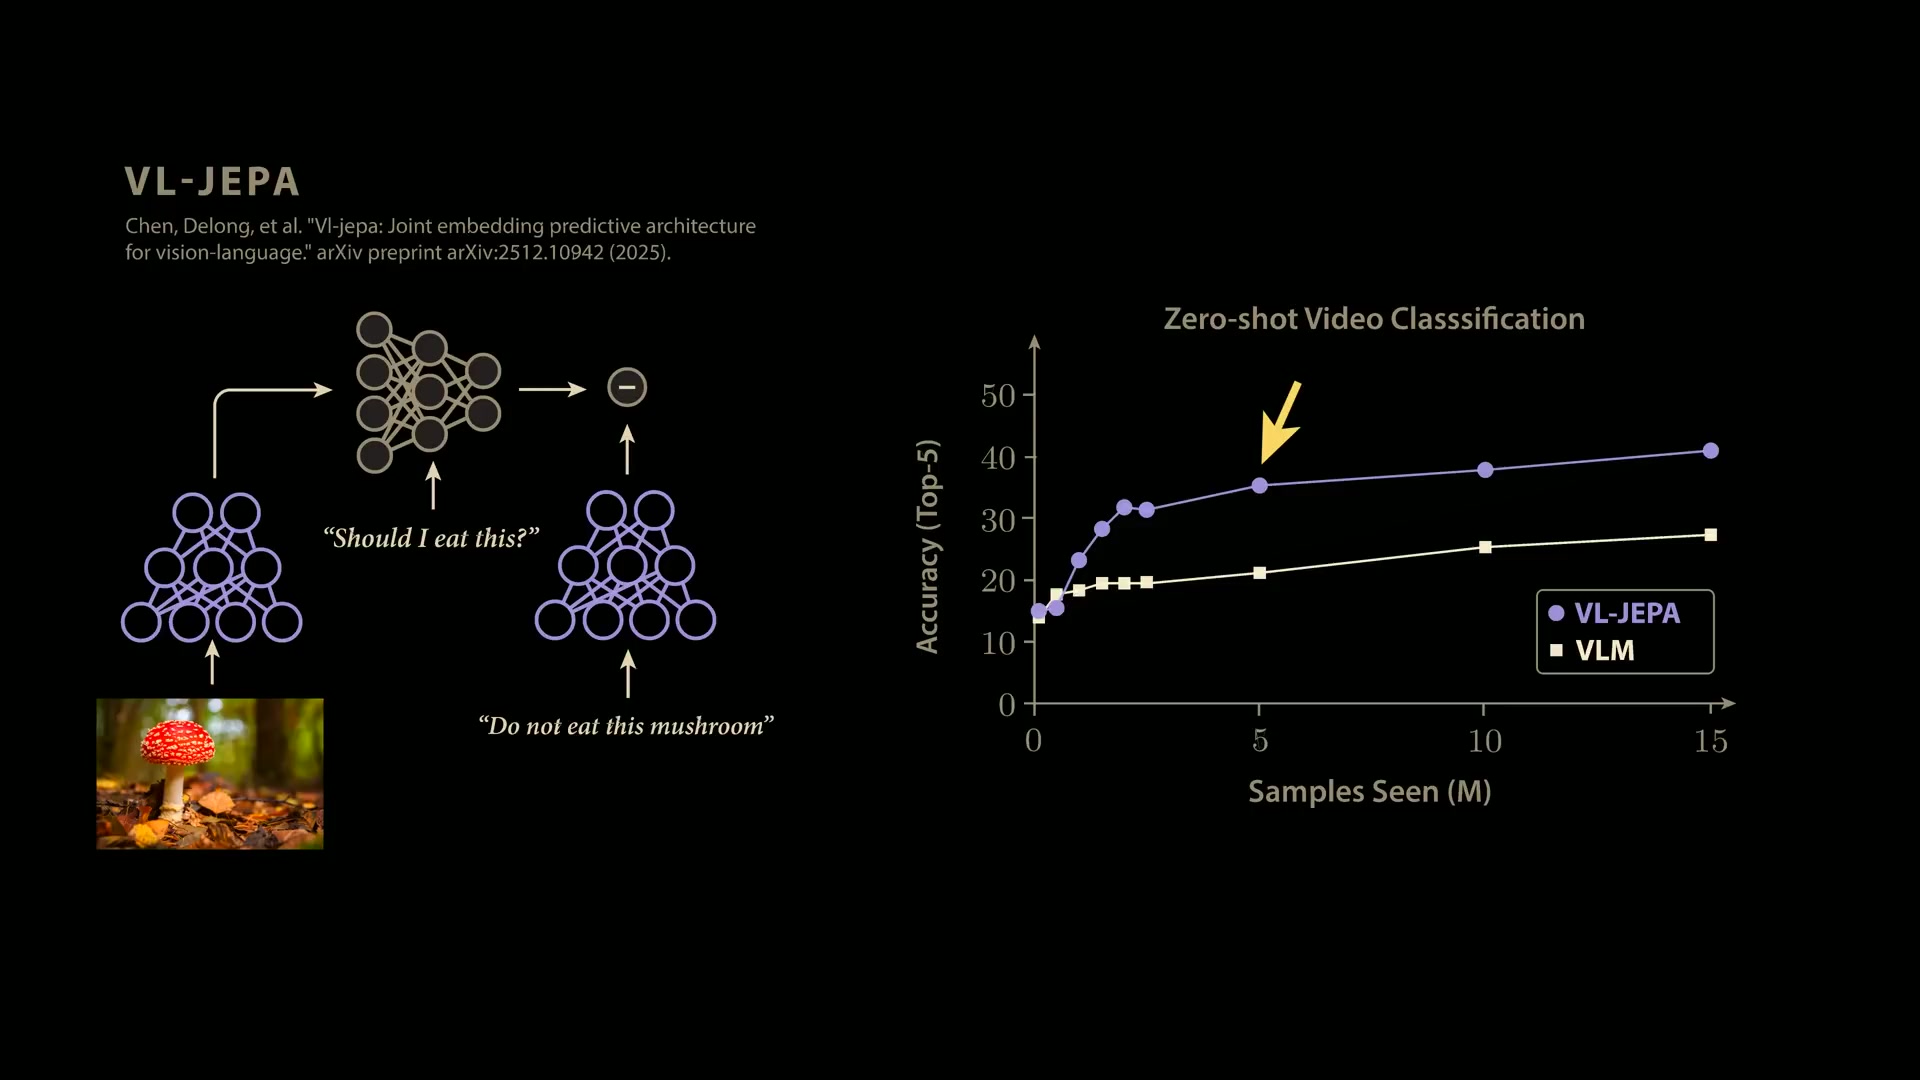
500만 학습 예시에서 Top-5 정확도 35% 대 20%. 그러나 GQA에서는 일부 7B 모델을 앞설 뿐 최상위 비교군에는 뒤진다.
VLA 비판의 핵심은 일반화와 계획
행동 복제는 시연 분포에 의존하고, 종단간 정책은 명시적으로 결과를 예측하지 않는다. 다만 RT-2 이후 VLA도 시연 밖 일반화를 보여왔다.
JEPA 진영의 병목은 계획 지평
예측을 되먹일수록 오차가 누적된다. Push-T의 단일 계층 지평은 약 5회였고, 2계층 모델은 이를 15스텝으로 늘렸다.
최종 판정은 아직 유보
JEPA가 스케일업되어 차세대 AI의 기반이 될지, 더 큰 해법의 한 부품에 머물지는 아직 증명되지 않았다.
01 · The contest
같은 로봇, 전혀 다른 출발점
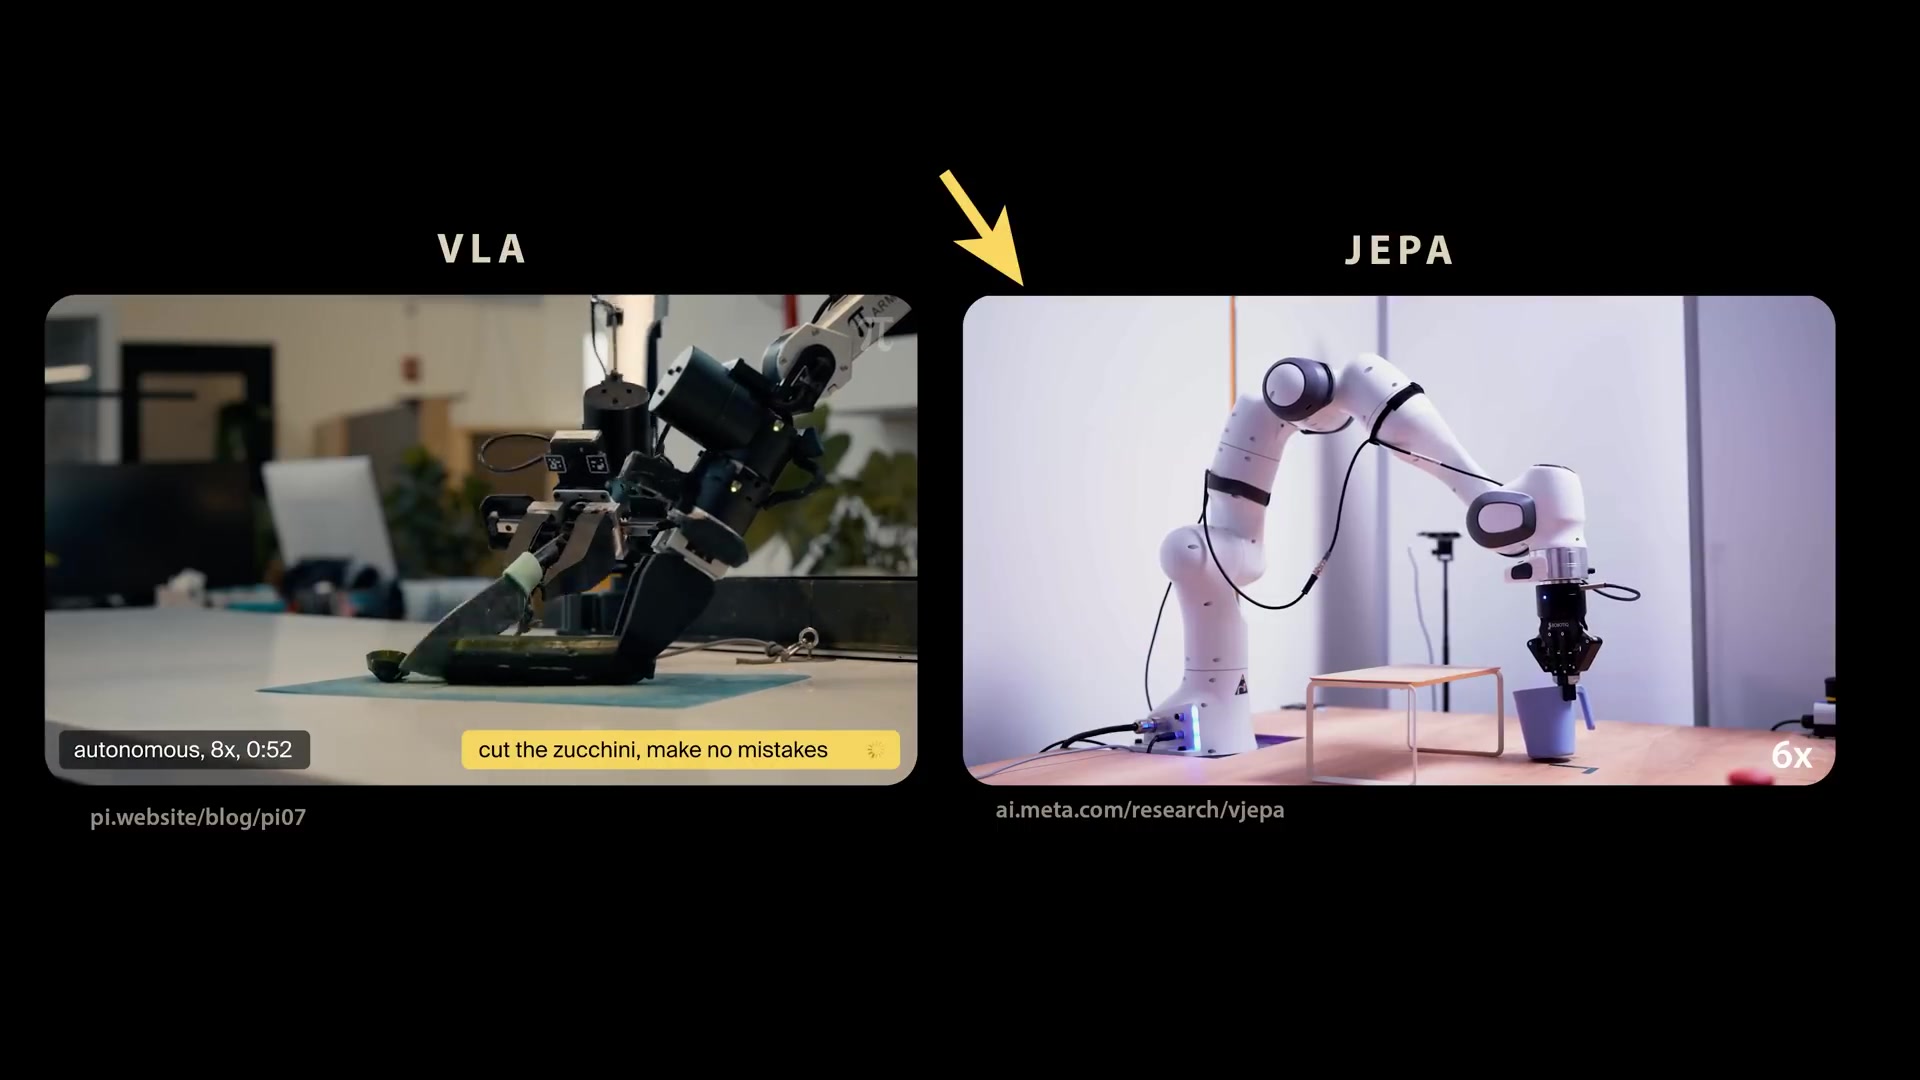
영상은 일부러 불리한 장면에서 시작한다. 한쪽에서는 Physical Intelligence의 π0.7이 애호박을 자르고, 다른 쪽에서는 V-JEPA 기반 로봇이 컵 하나를 옮기는 데 60초를 쓴다. 질문은 “JEPA가 이미 더 좋은가”가 아니다. 왜 LeCun은 지금 뒤처진 접근에 10억 달러를 걸었는가다.
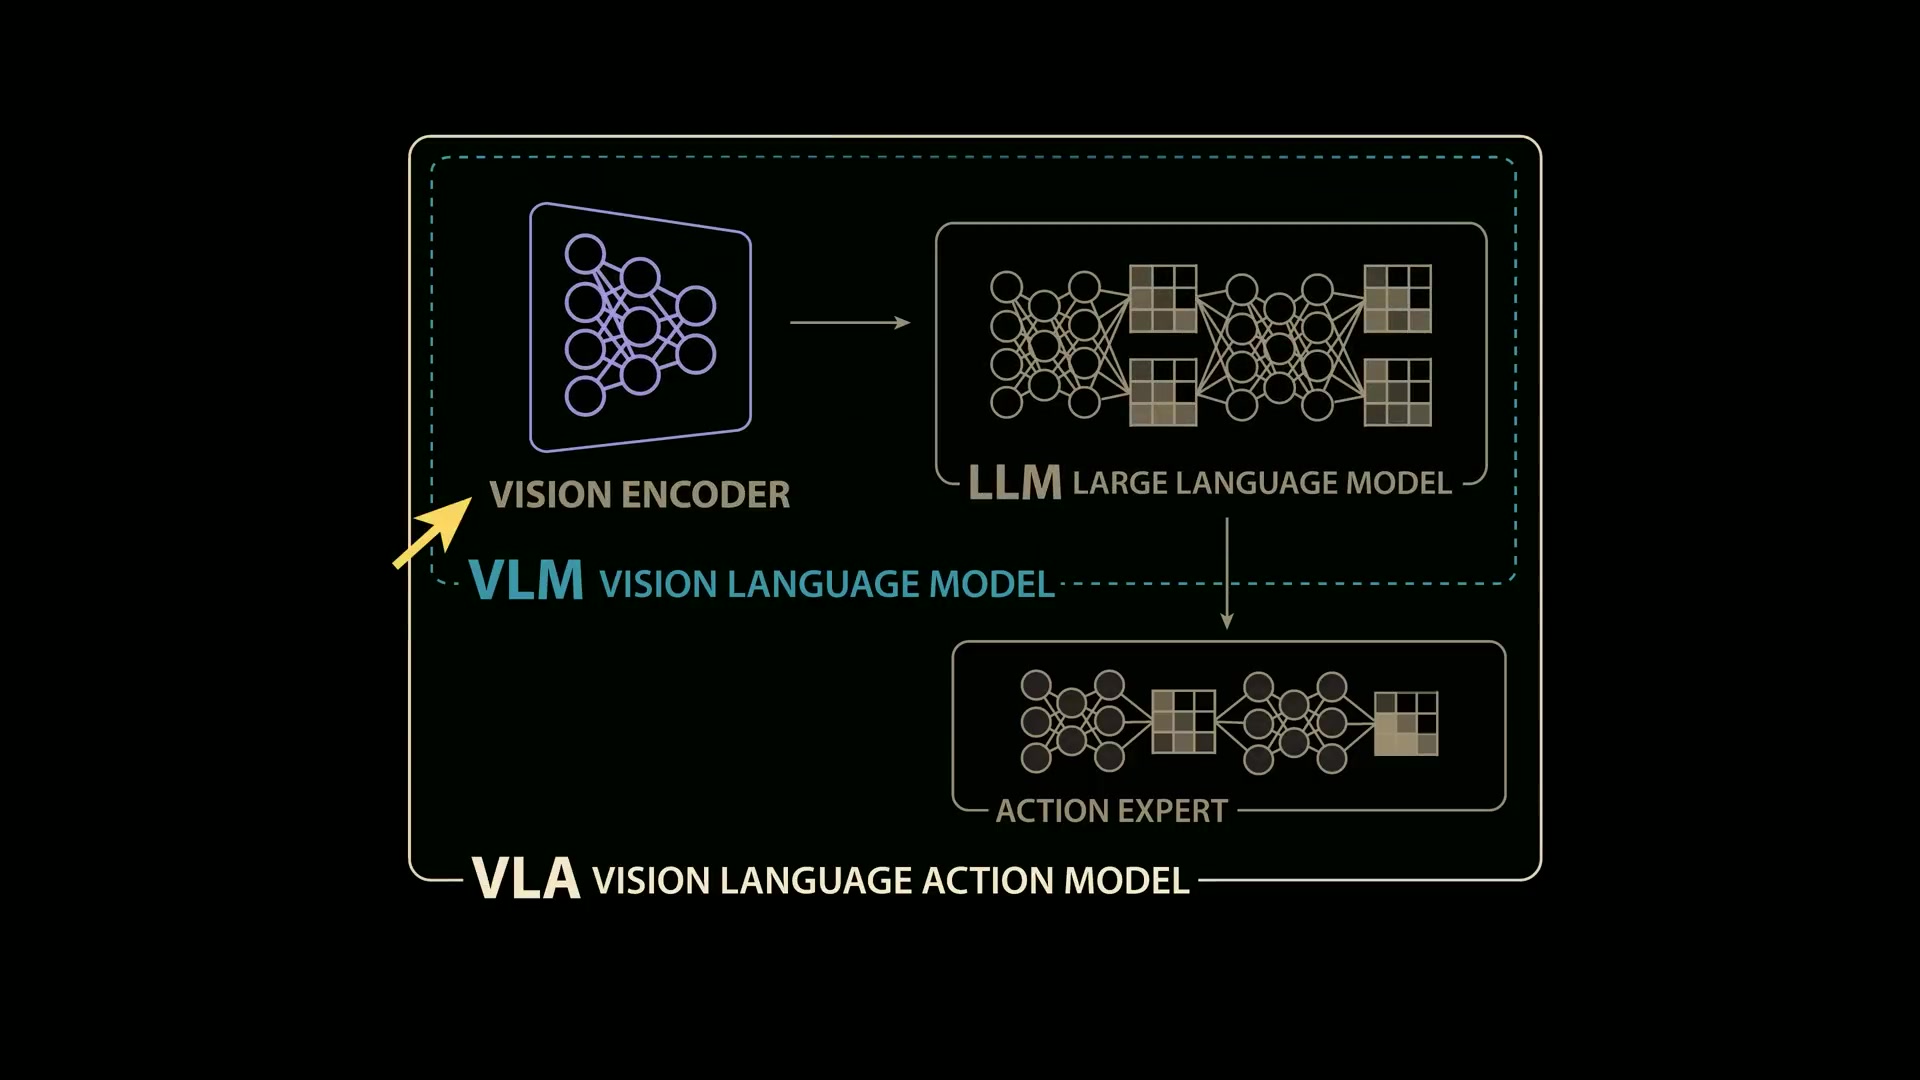
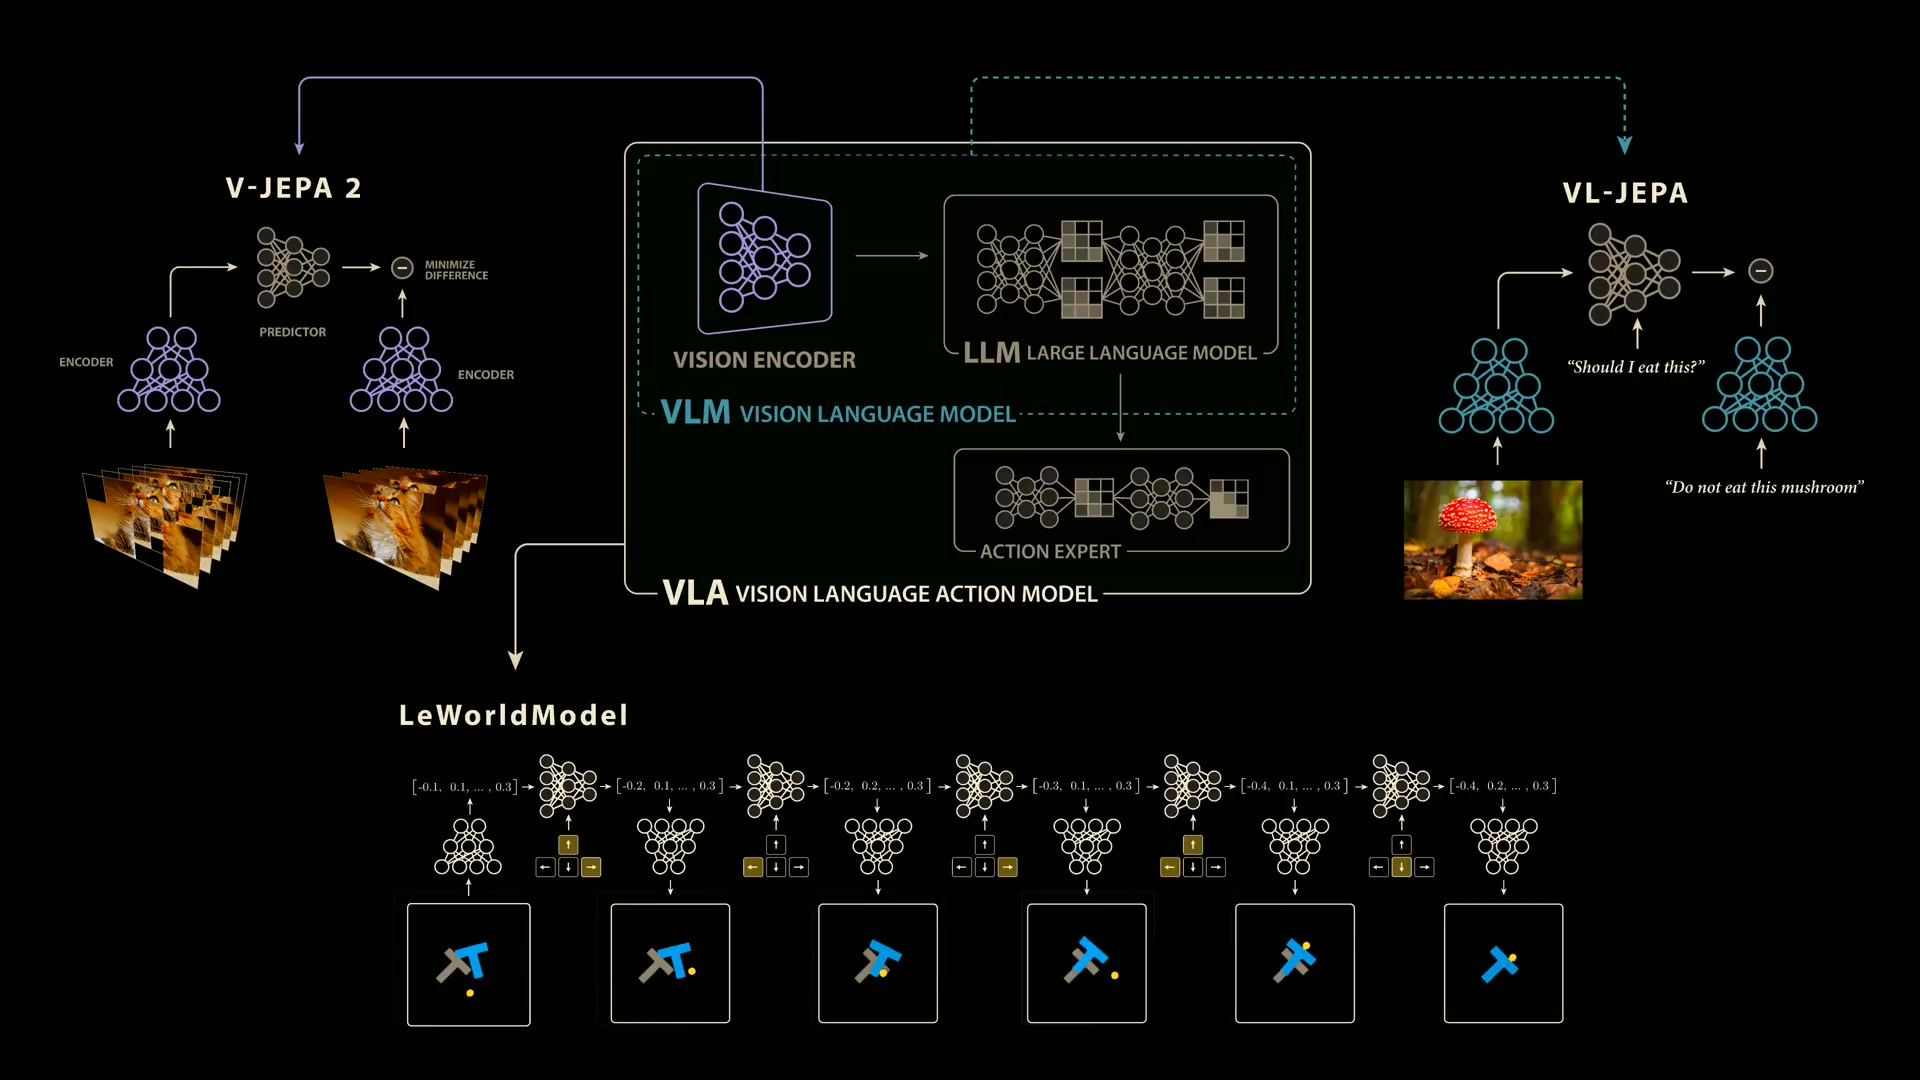
Architecture map · 층별 대응 관계
현재의 생성형 스택
공동 임베딩 대안
언어 감독 없는 비디오 표현이 SOTA급 결과를 낸다.
효율은 강하지만 절대 성능의 전면 우위는 아니다.
월드 모델은 계획 지평과 실제 조작에서 크게 뒤처진다.
02 · Perception
언어를 버리고도 세계를 이해할 수 있는가
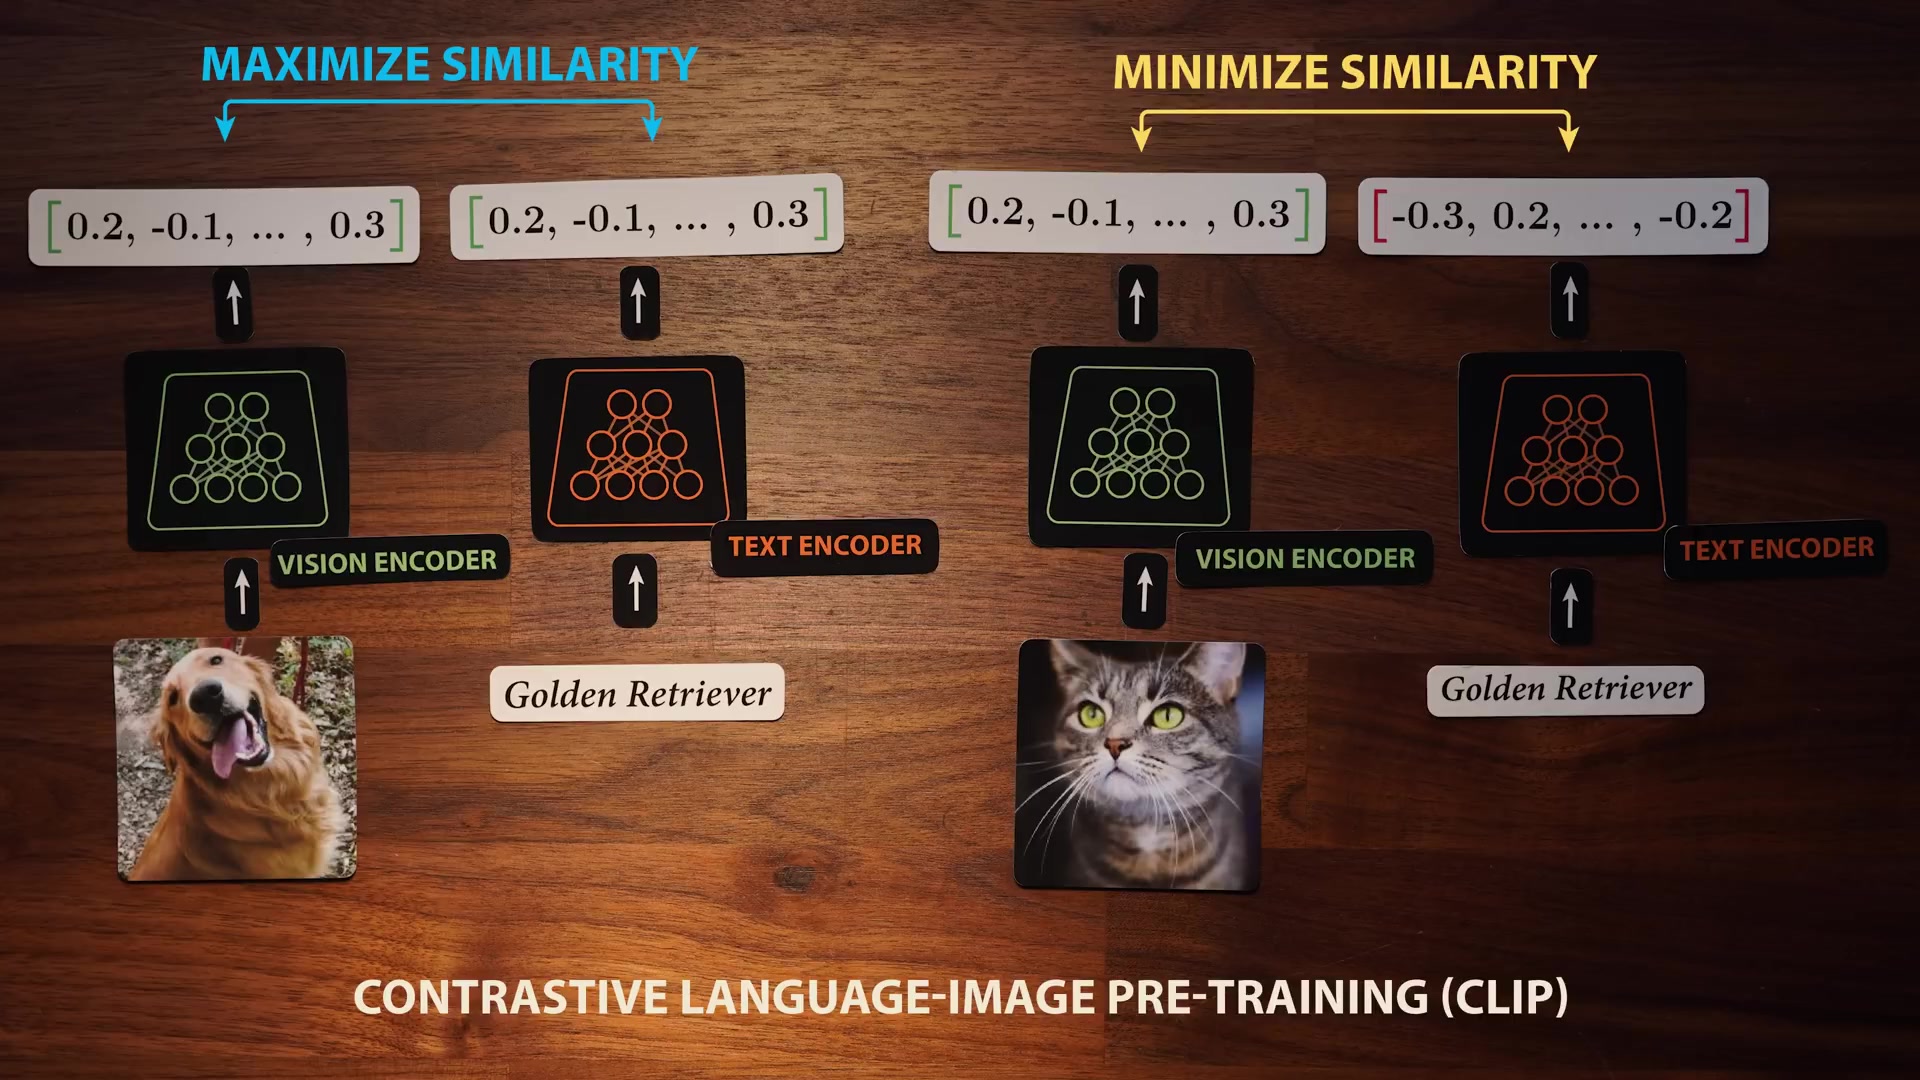
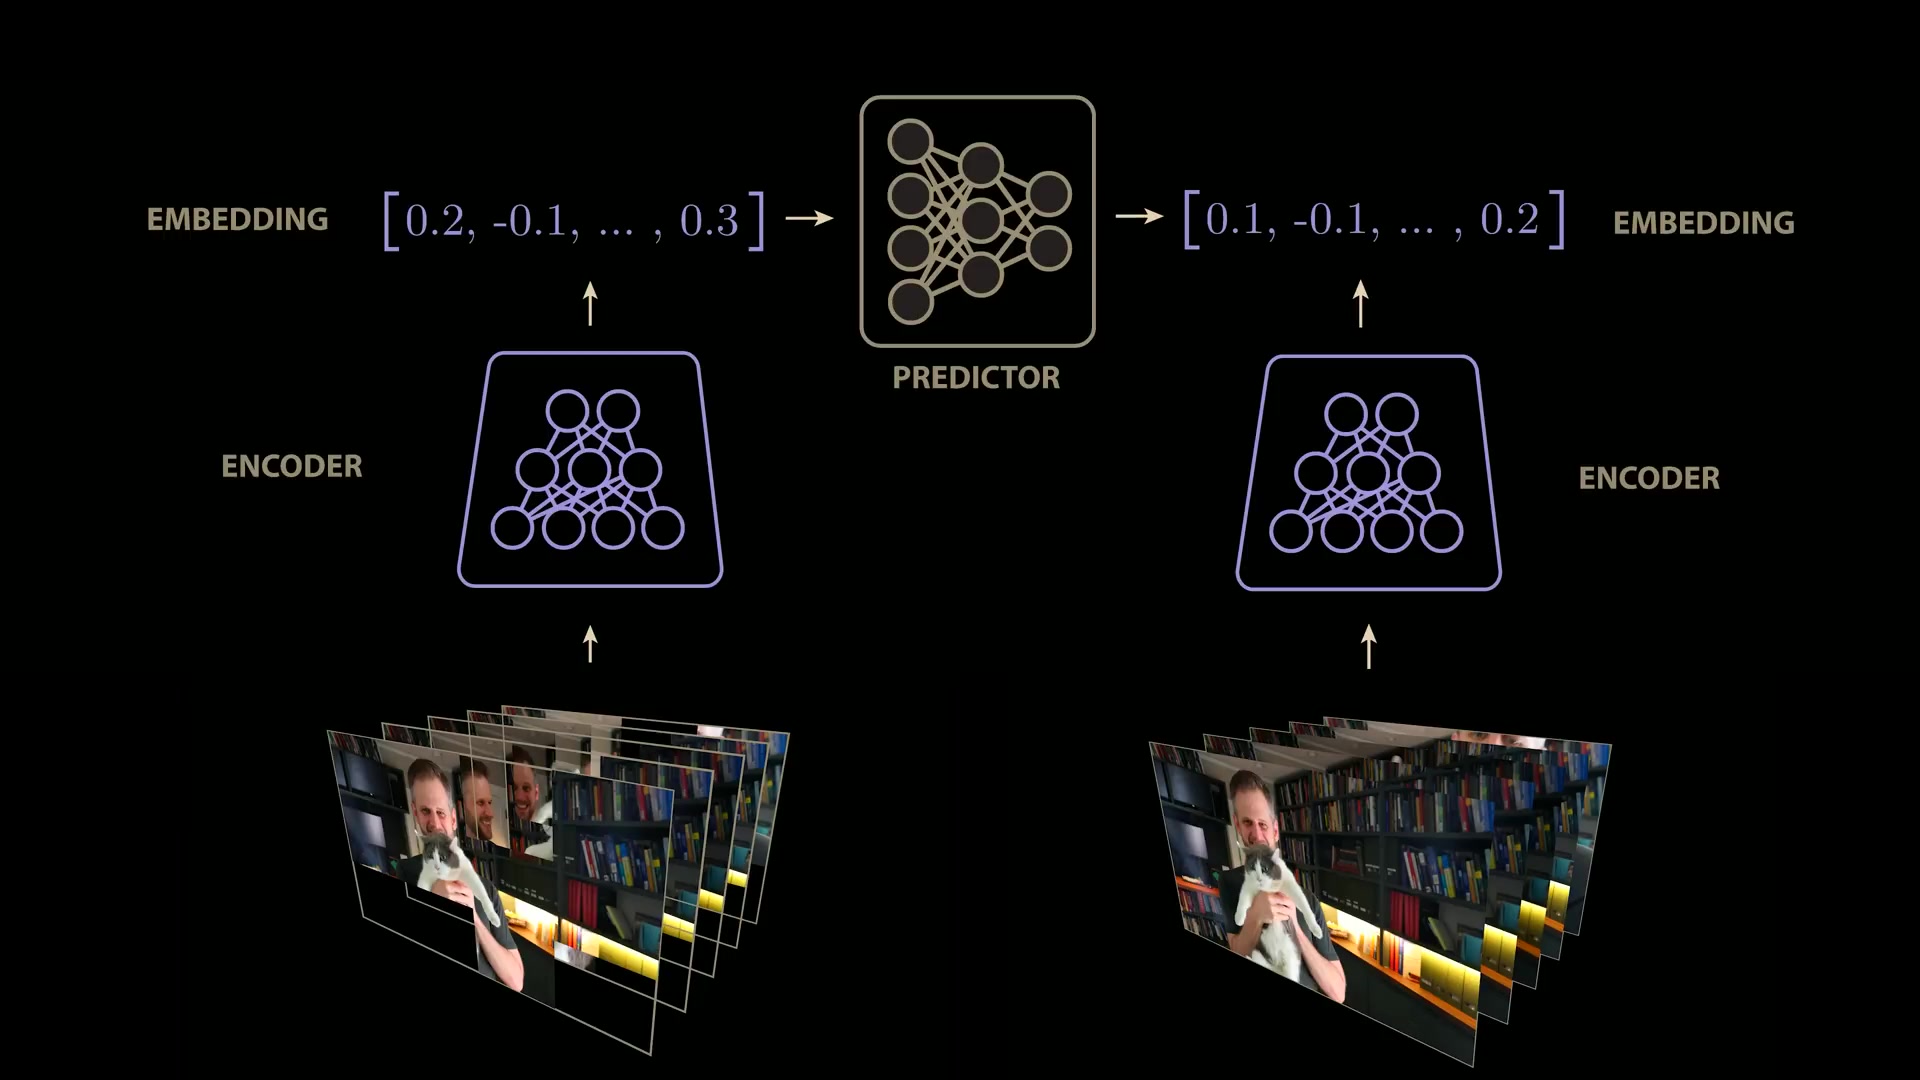
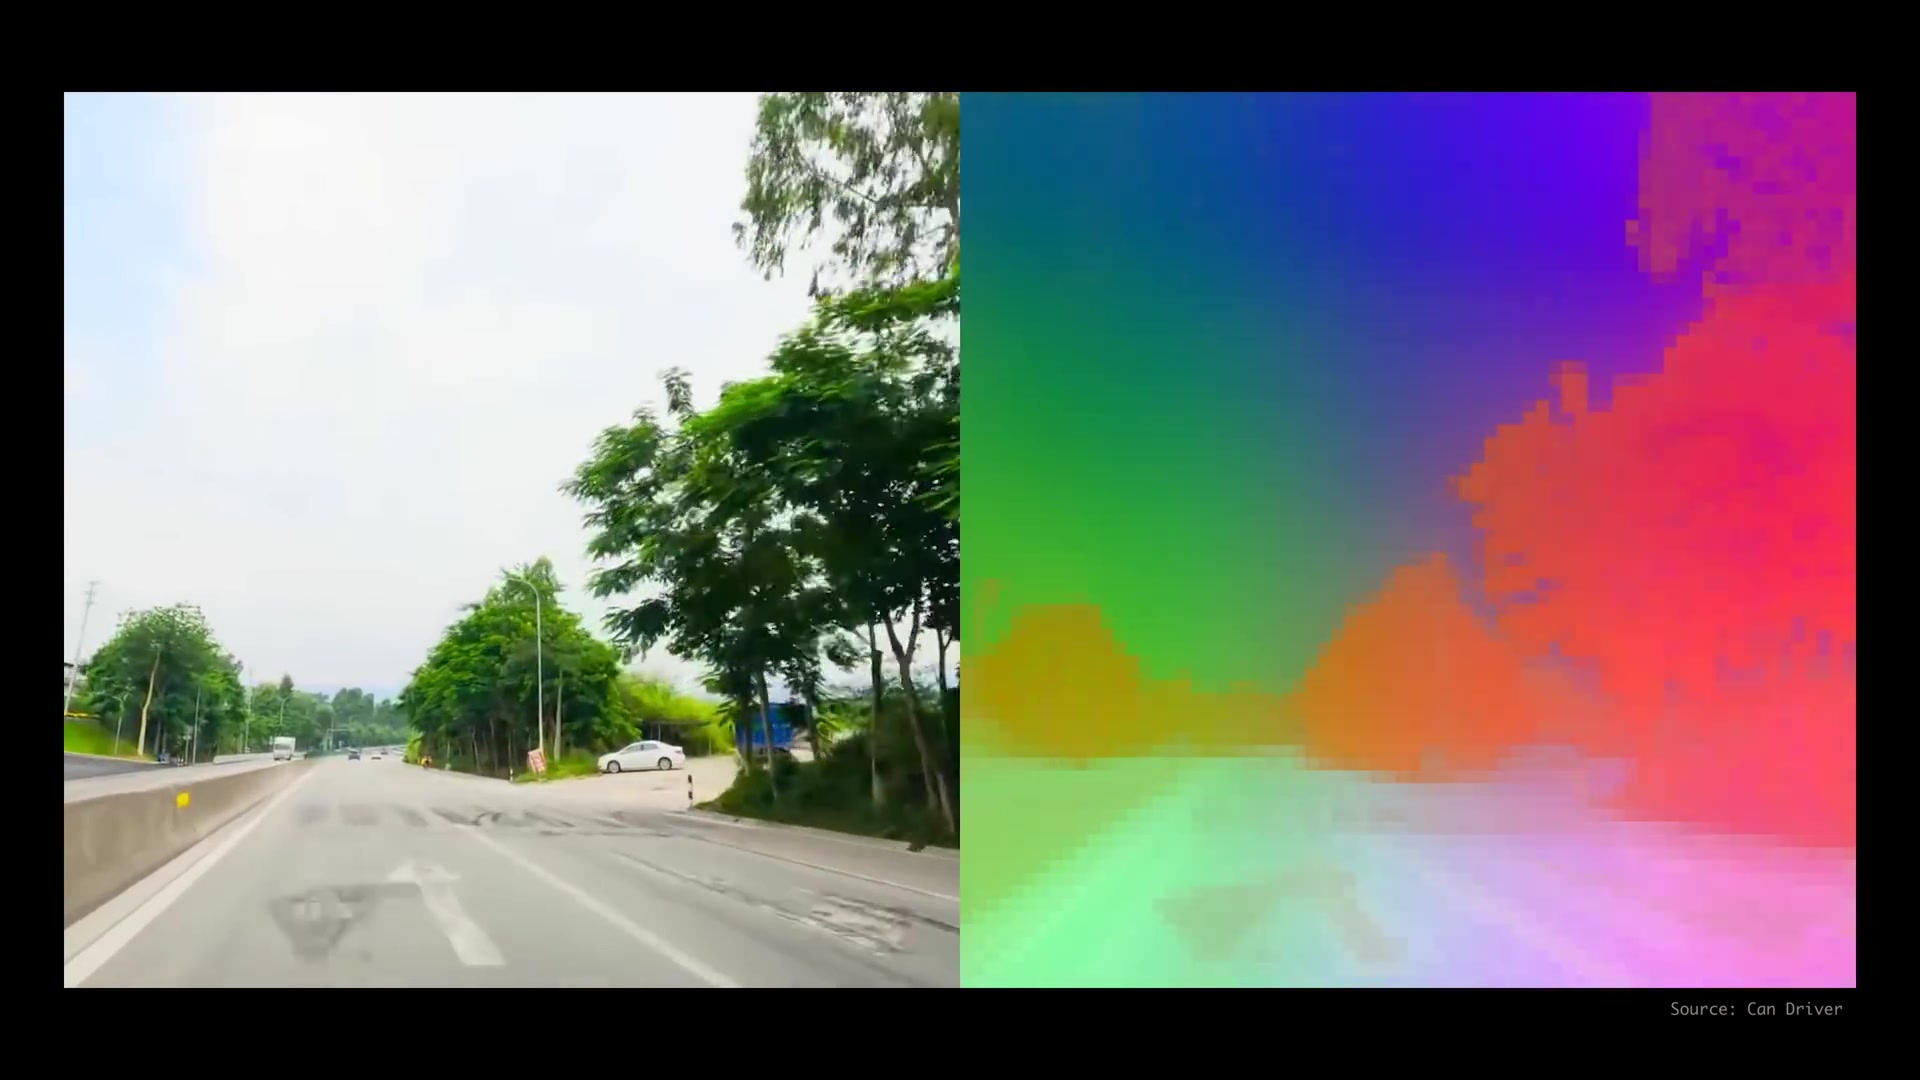
CLIP은 이미지를 사람이 쓴 캡션에 맞추지만, V-JEPA는 비디오에서 가려진 부분의 표현을 예측한다. 전자는 시각을 언어에 정렬하고, 후자는 언어에 구속되지 않은 채 세계의 변화 규칙을 학습하려 한다.
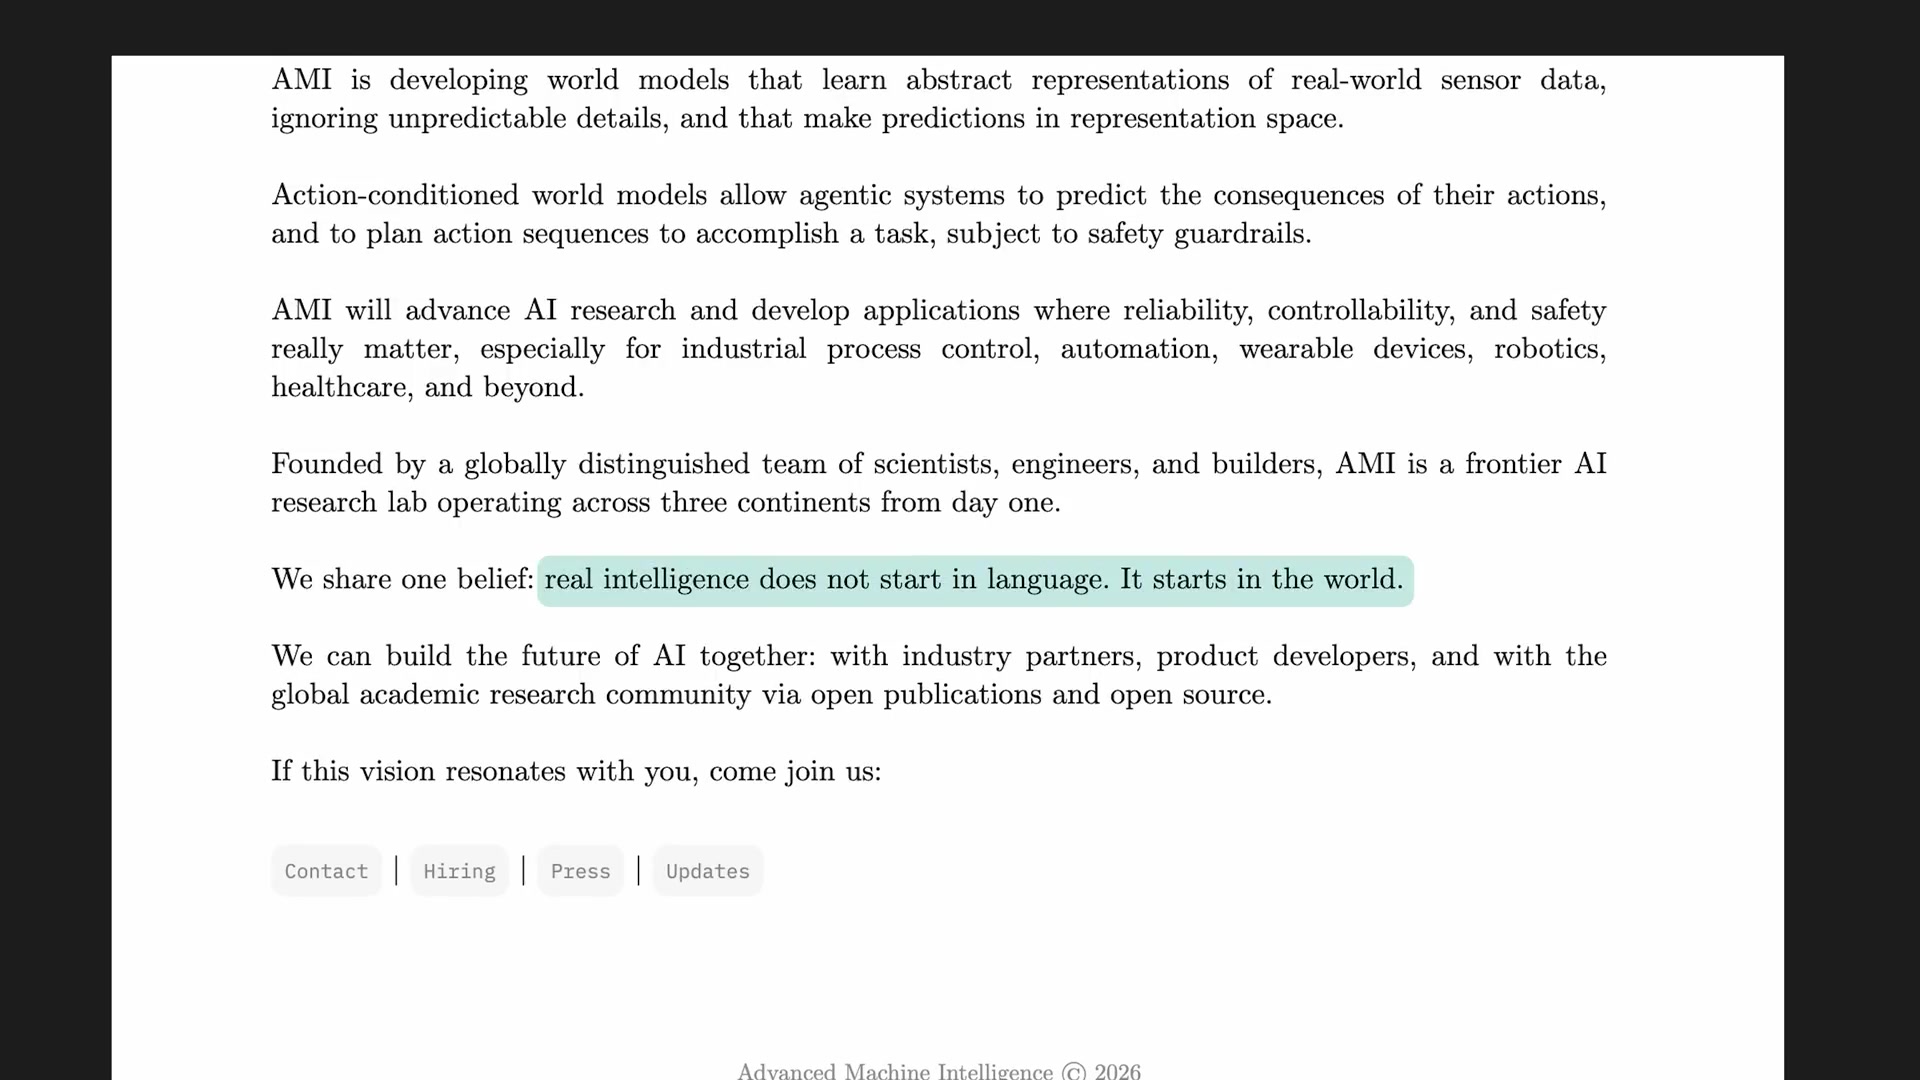
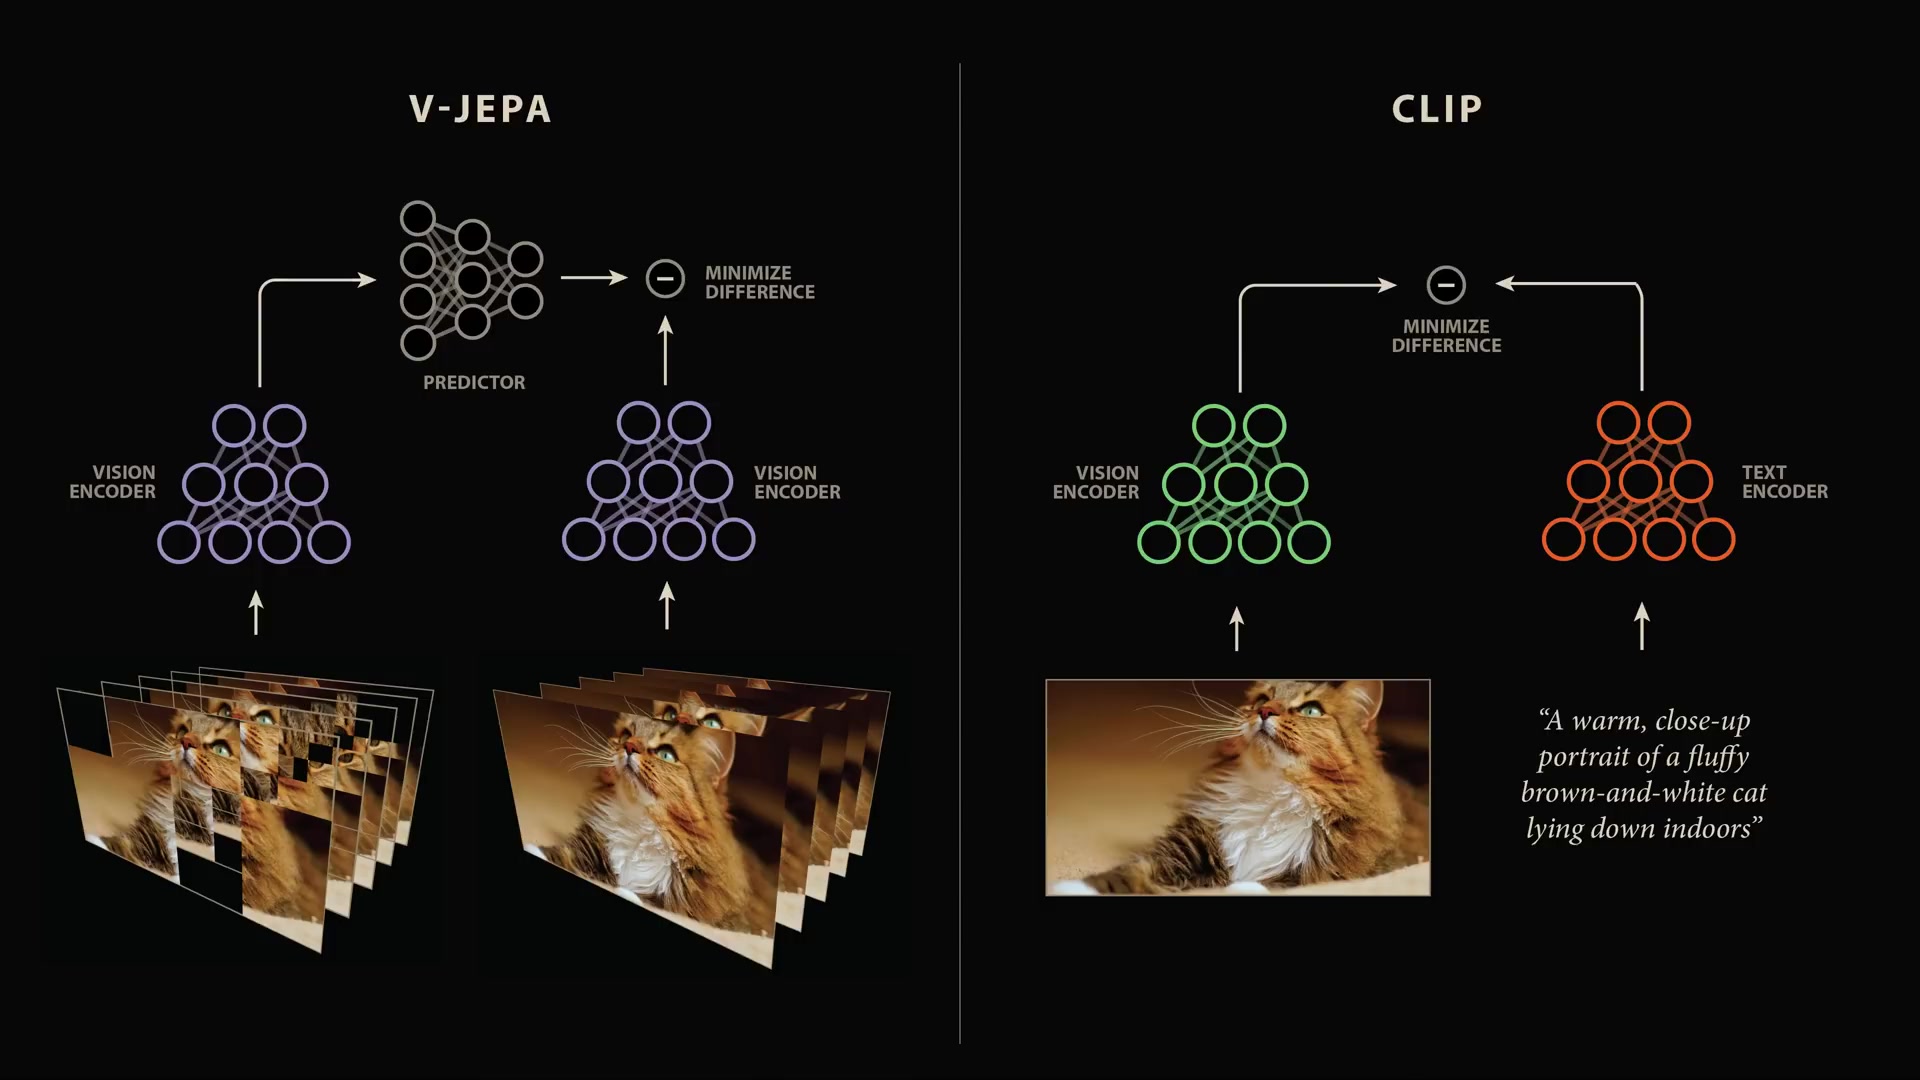
지능은 언어에서 시작되지 않는다.AMI Labs의 문제 설정
세계에서 시작된다.
통념과 반대되는 결과
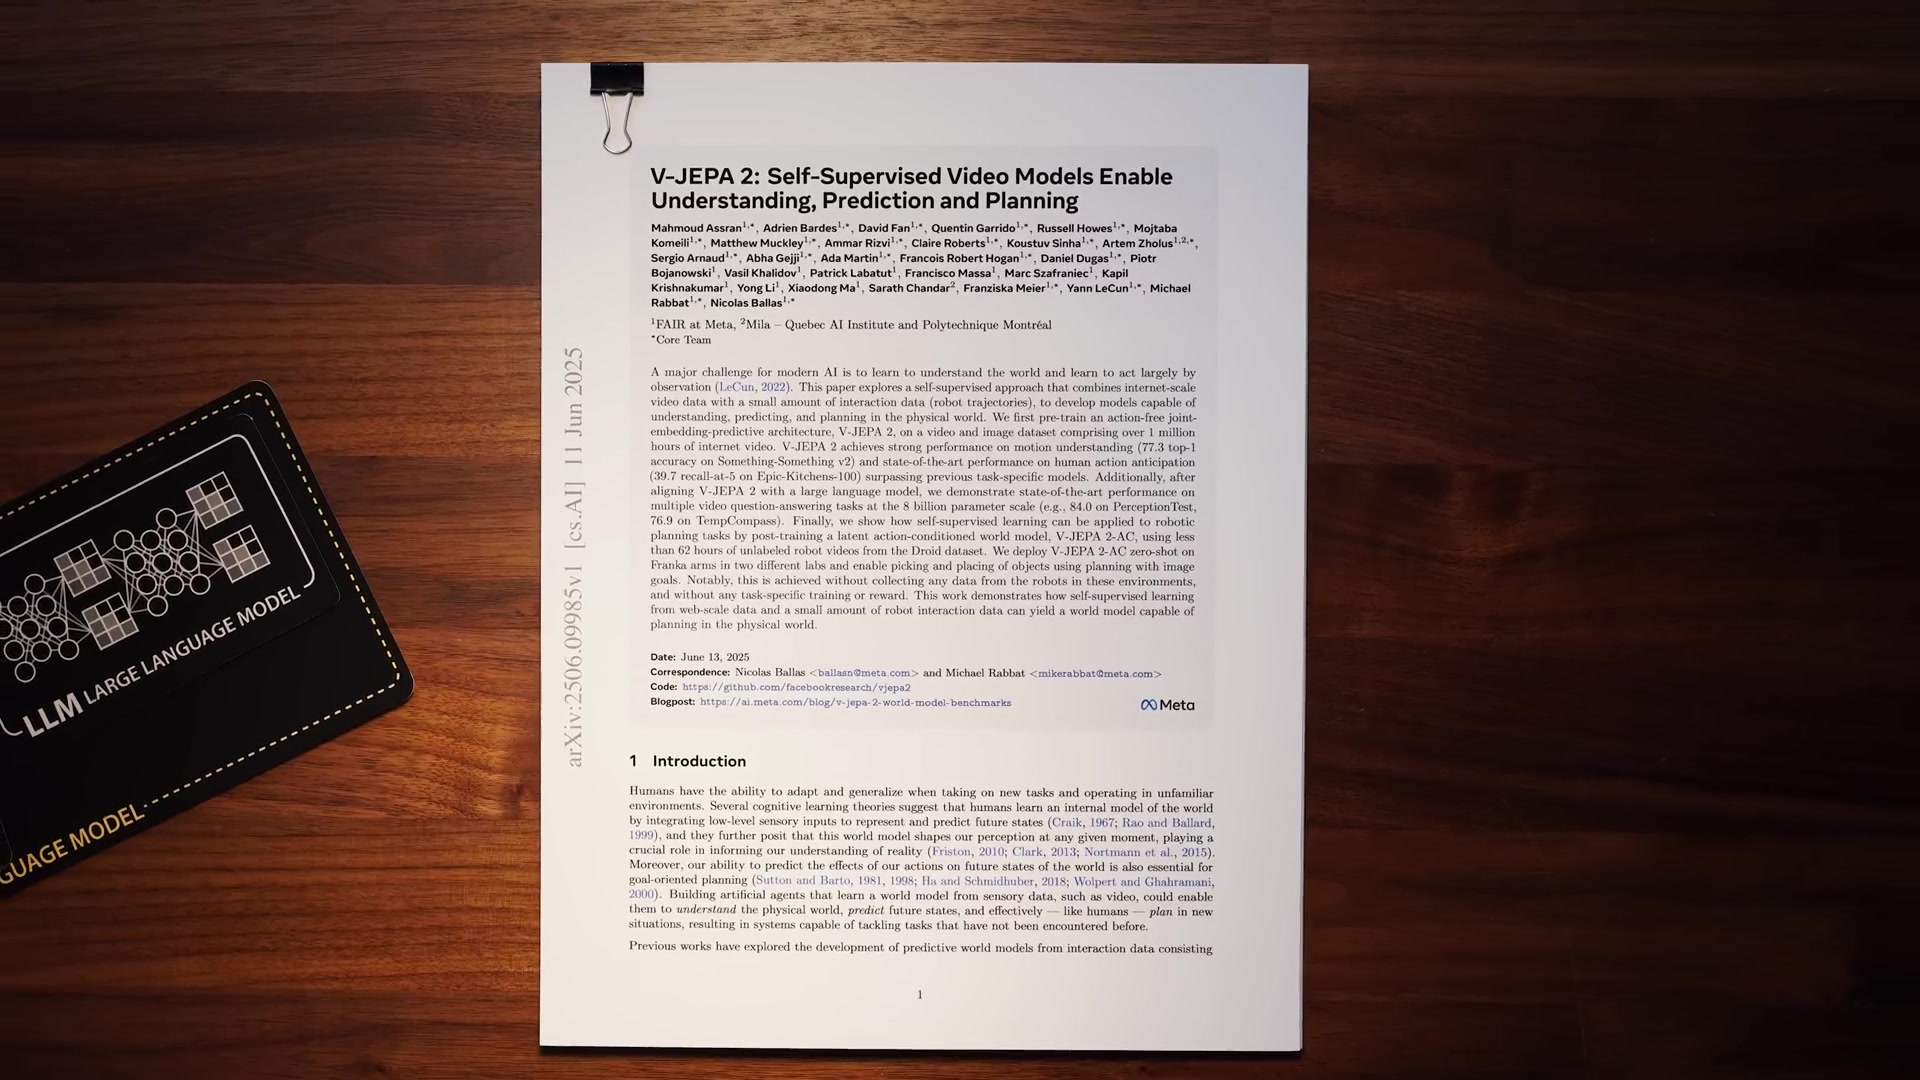
당연한 반론이 남는다. 언어 없이 자기 방식대로 학습한 표현을 언어 모델이 쓸 수 있을까? V-JEPA 2 논문은 가능하다고 답한다. 언어 감독 없이 사전학습한 비디오 인코더를 언어 모델과 정렬한 뒤 MVP 44.5, PerceptionTest 84.0, TempCompass 76.9 등의 성적을 기록했다. Epic-Kitchens-100의 행동 예측에서는 recall-at-5 39.7로 직전 최고 대비 44%의 상대 개선을 보고했다.
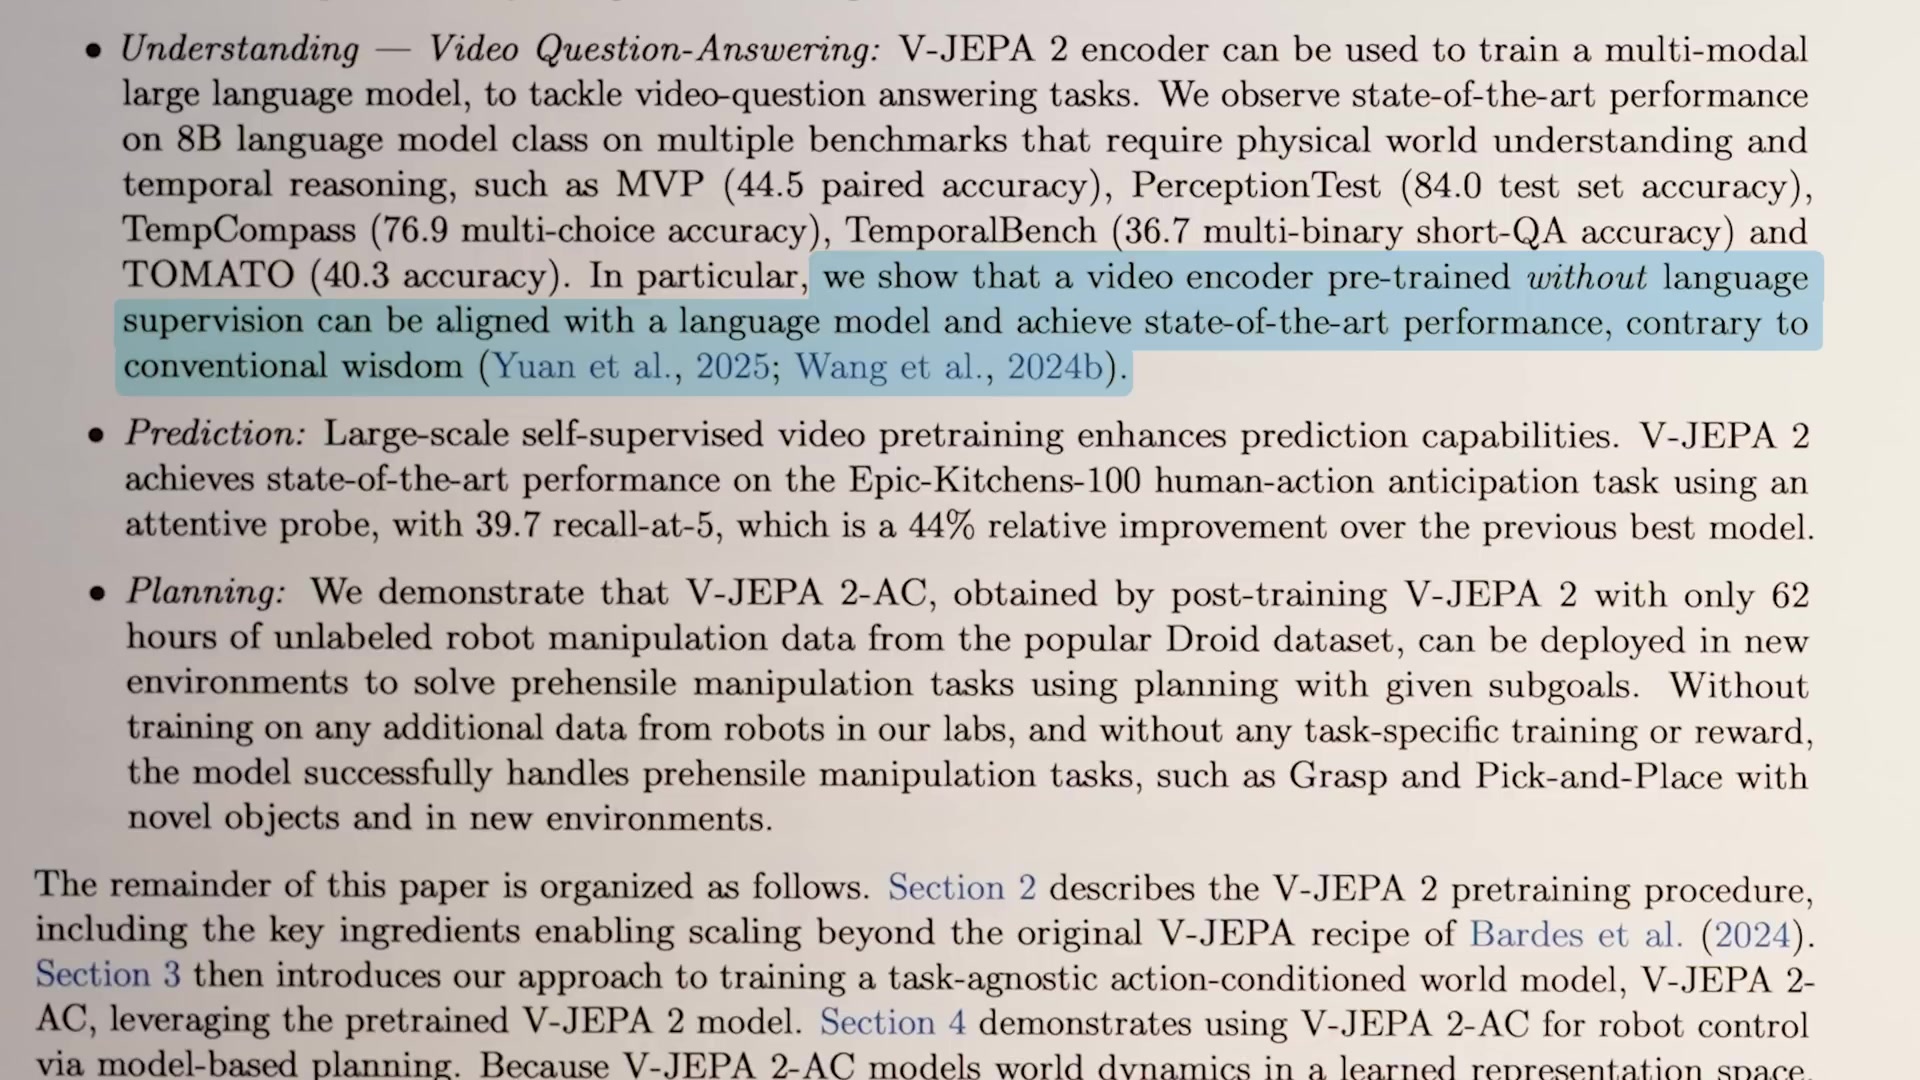
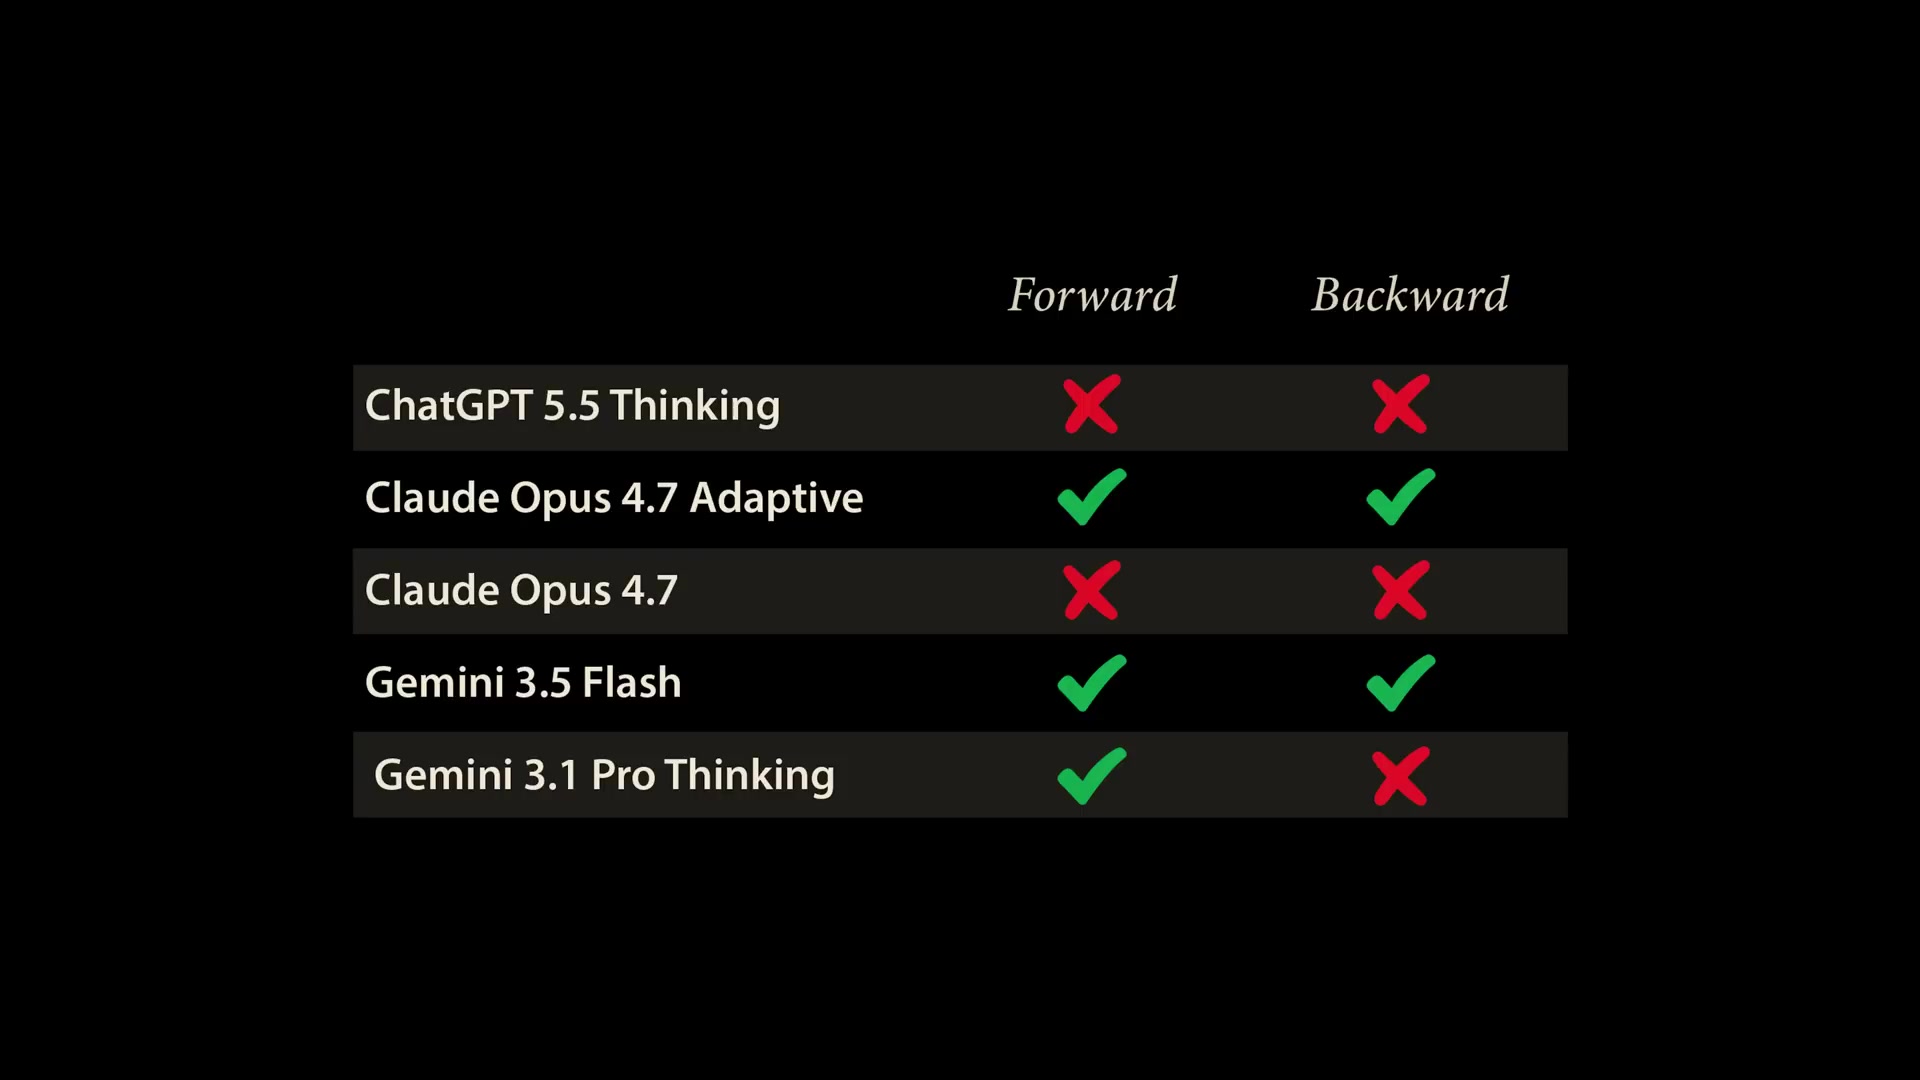
V-JEPA 2가 증명한 것은 “언어가 필요 없다”가 아니다. 언어에 정렬되지 않은 시각 표현도 나중에 언어 모델과 연결할 수 있으며, 초기 표현 학습 단계에서 언어가 유일한 감독 신호일 필요는 없다는 것이다.
03 · Vision and language
문장 대신 의미를 예측하면 무엇이 달라지는가
표준 VLM은 다음 토큰을 생성한다. VL-JEPA는 정답 텍스트 자체가 아니라 그 문장의 임베딩을 예측한다. 표현이 달라도 의미가 같으면 같은 목표로 취급할 수 있다는 것이 이 설계의 가장 중요한 효율 가설이다.
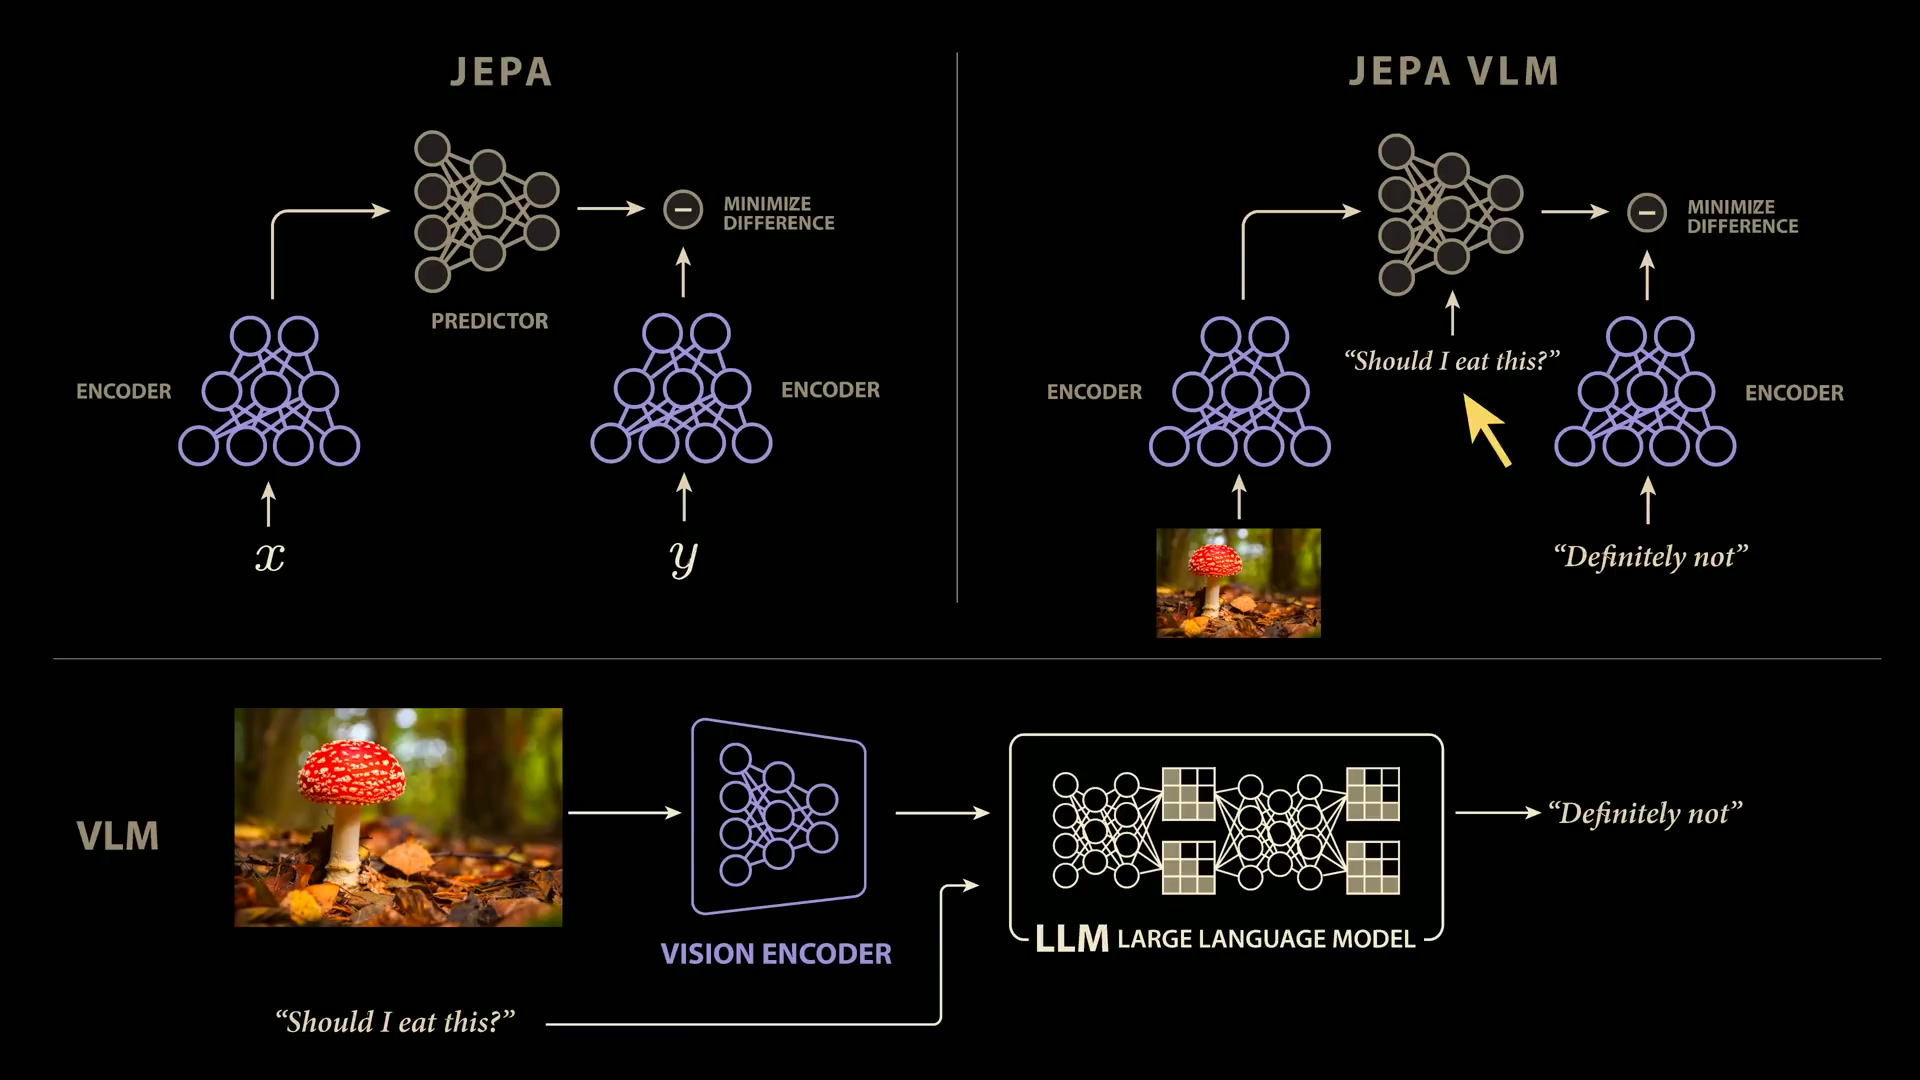
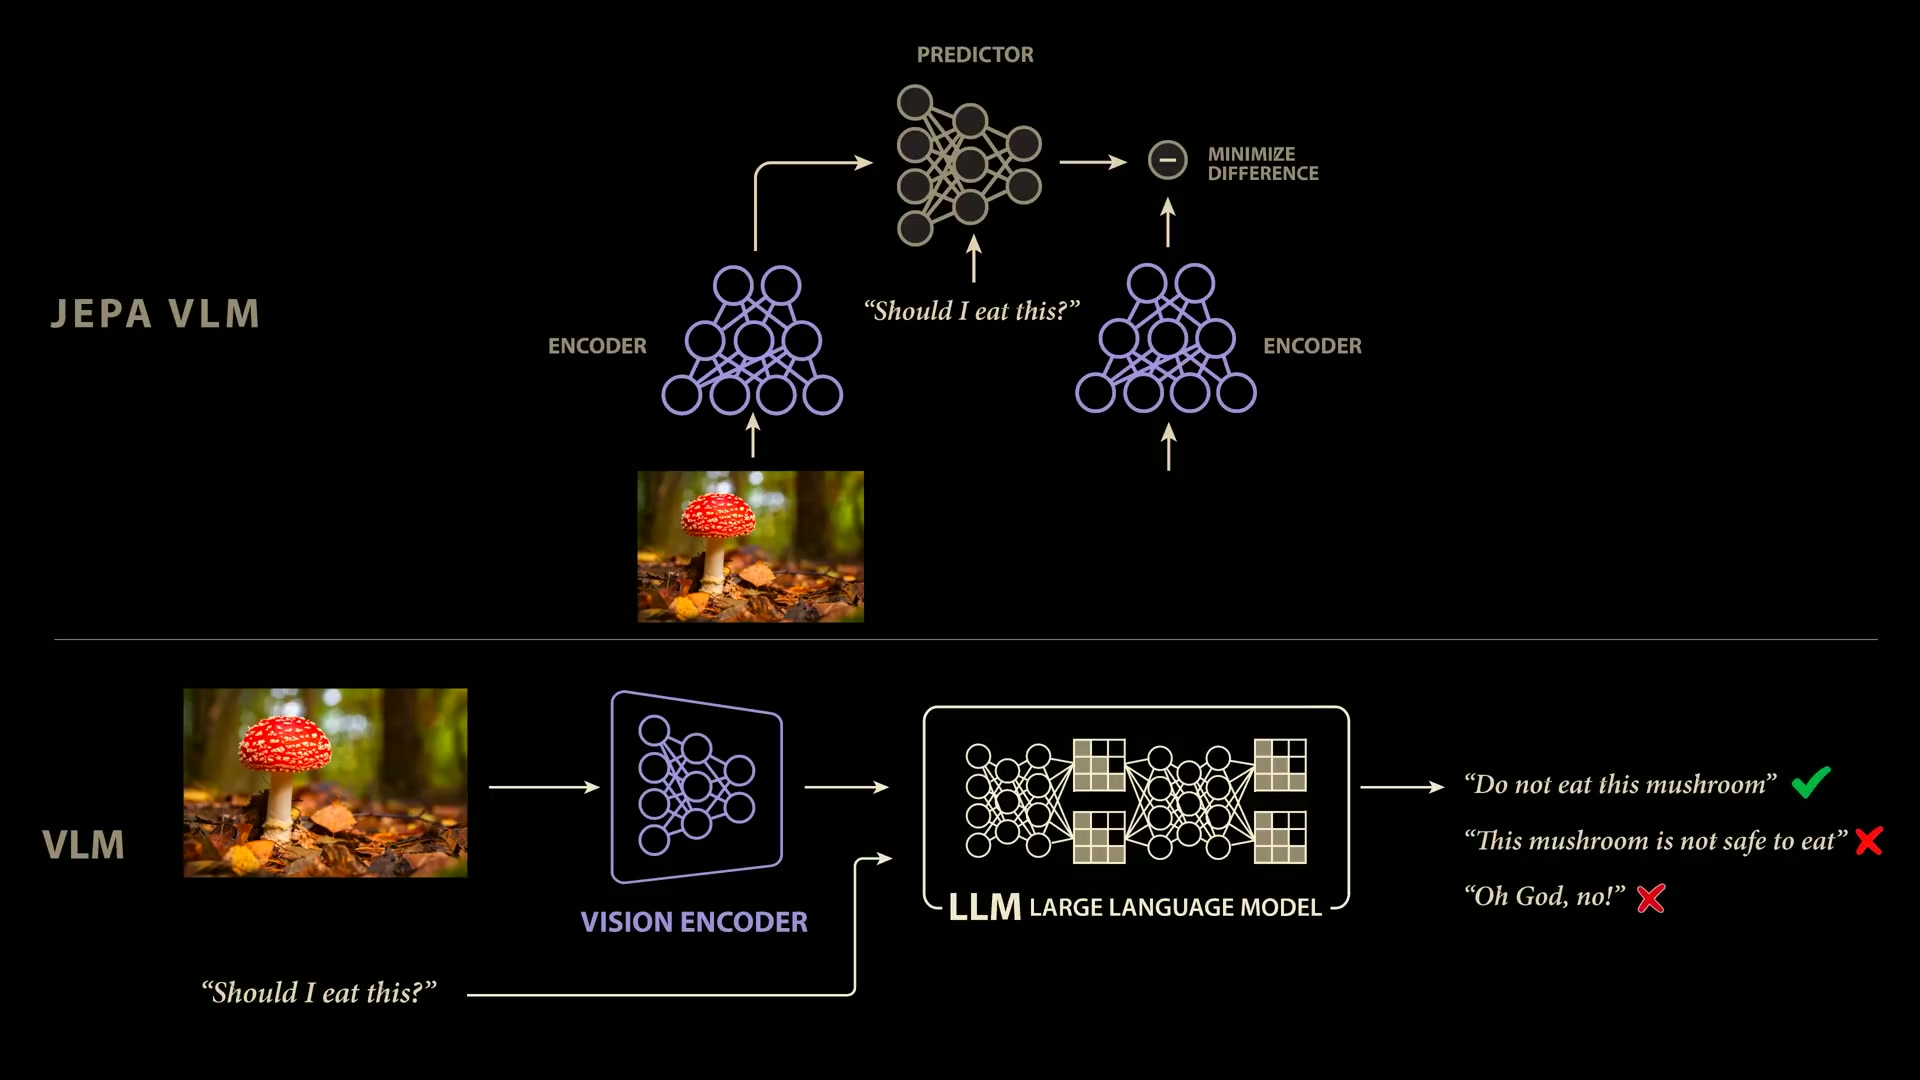
생성 모델은 데이터에 기록된 한 문장을 정답으로 삼을 때 같은 의미의 다른 문장을 불필요하게 벌줄 수 있다. 공동 임베딩 공간에서는 서로 바꿔 말한 문장들이 가까운 위치에 놓이므로, 학습 목표가 표면적 표현 차이를 자동으로 무시한다.
효율은 분명하지만, 절대 성능의 승리는 아니다
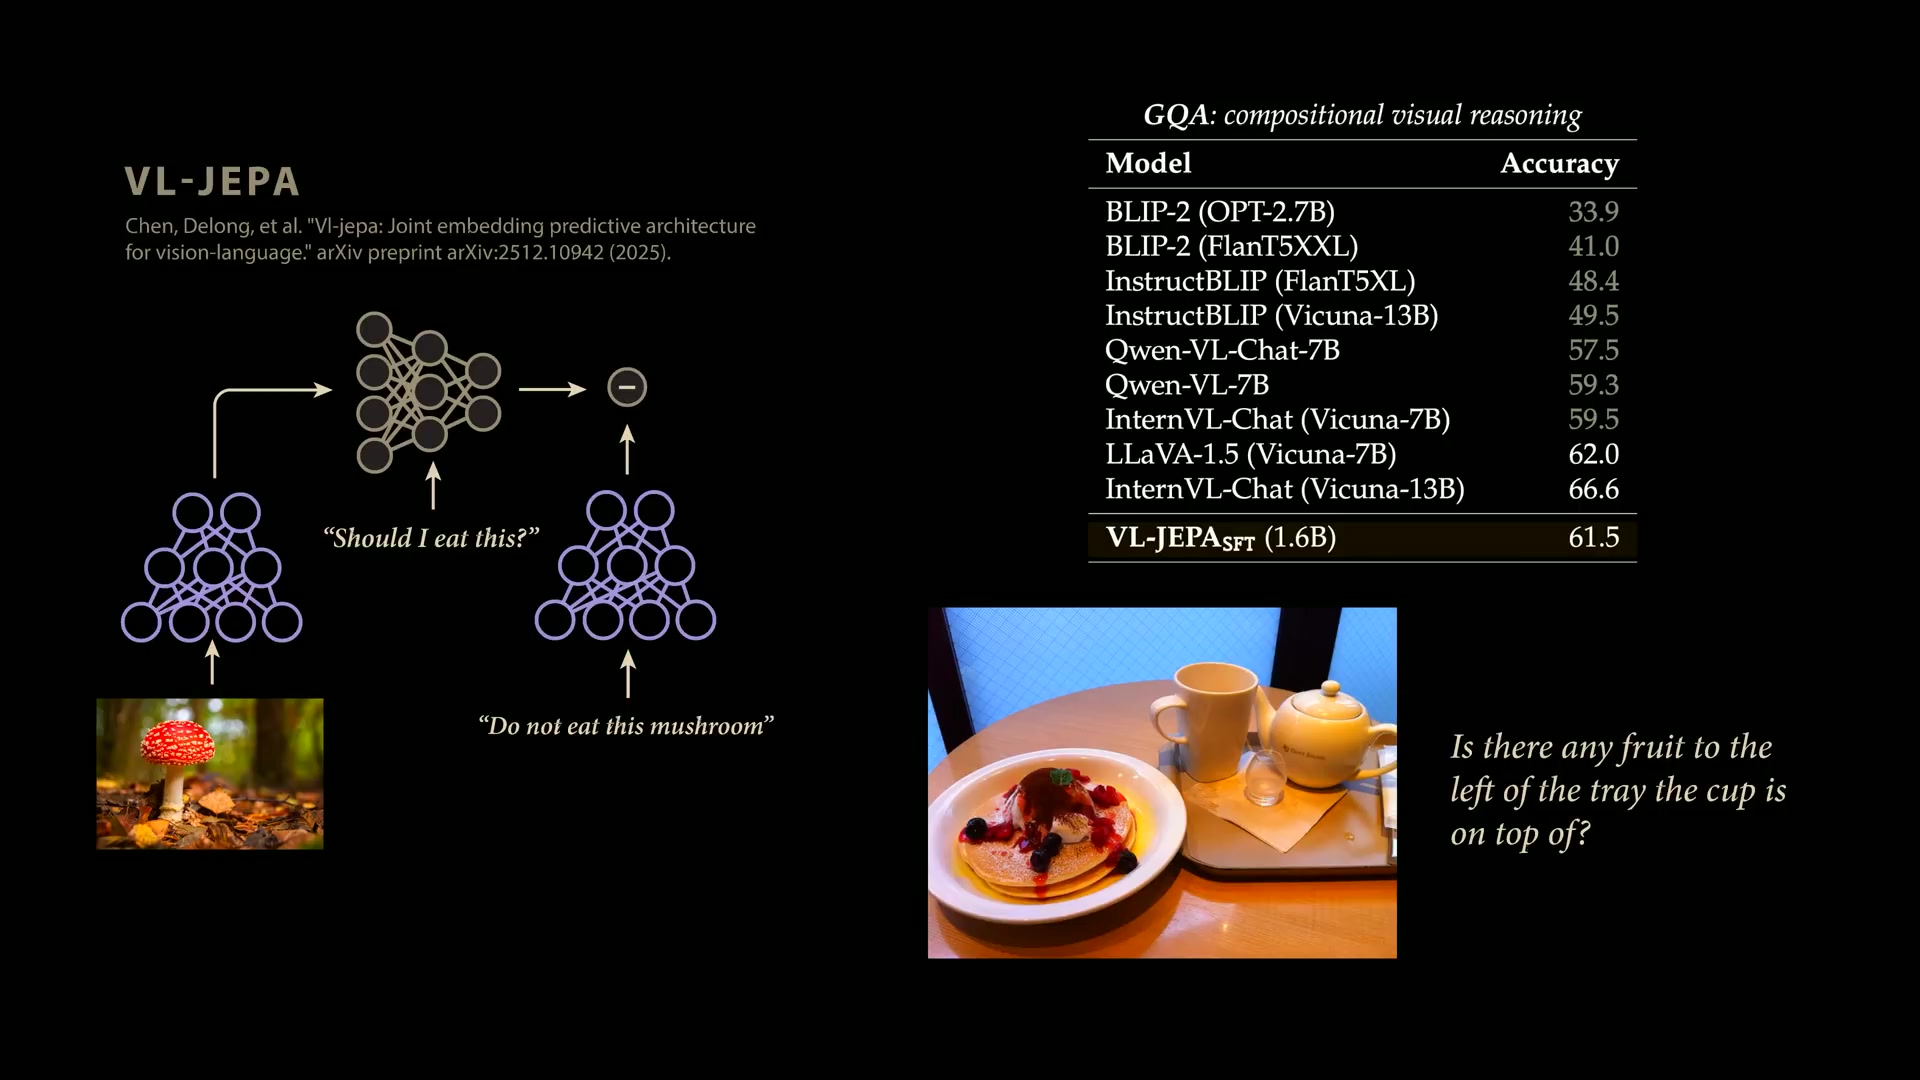
| 모델 | 규모 | GQA | VL-JEPA와 비교 |
|---|---|---|---|
| Qwen-VL | 7B | 59.3 | VL-JEPA 우세 |
| InternVL-Chat | 7B | 59.5 | VL-JEPA 우세 |
| VL-JEPA SFT | 1.6B | 61.5 | 기준 |
| LLaVA-1.5 | 7B | 62.0 | VL-JEPA 열세 |
| InternVL-Chat | 13B | 66.6 | VL-JEPA 열세 |
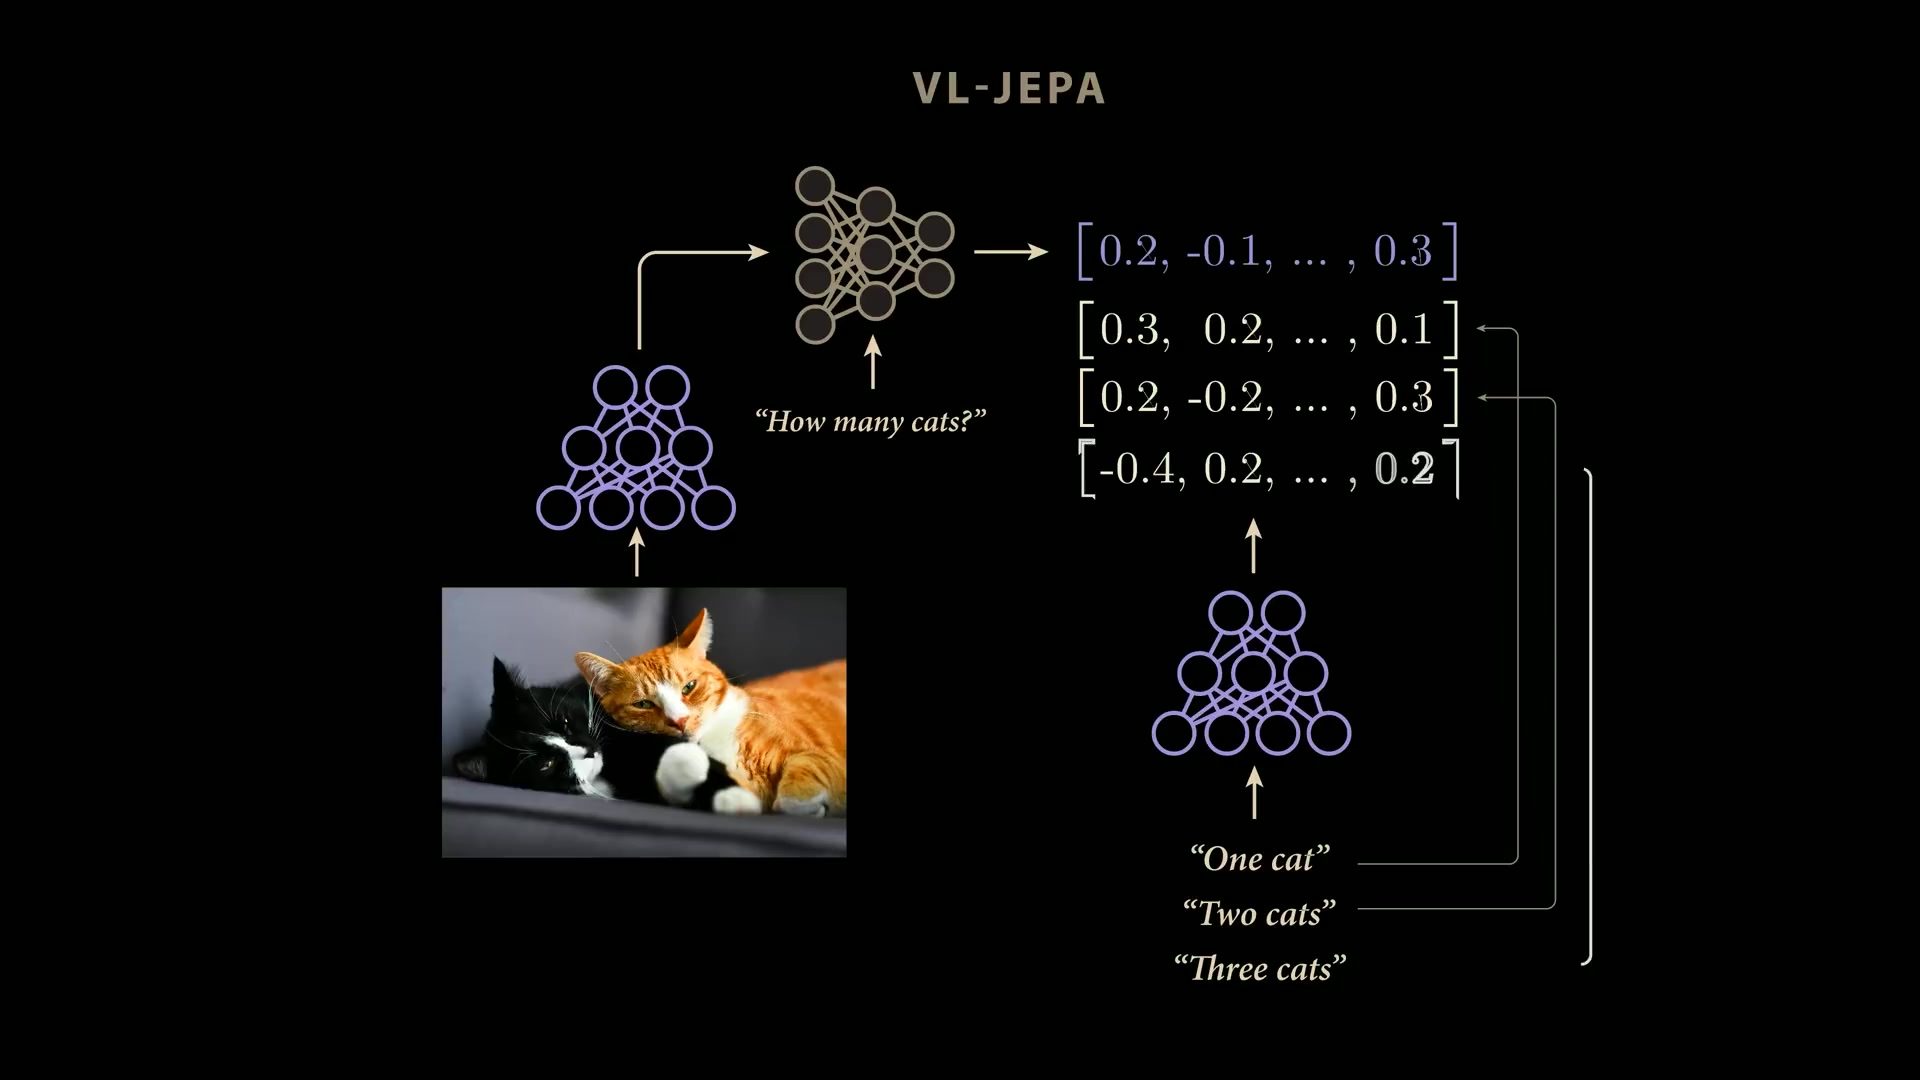
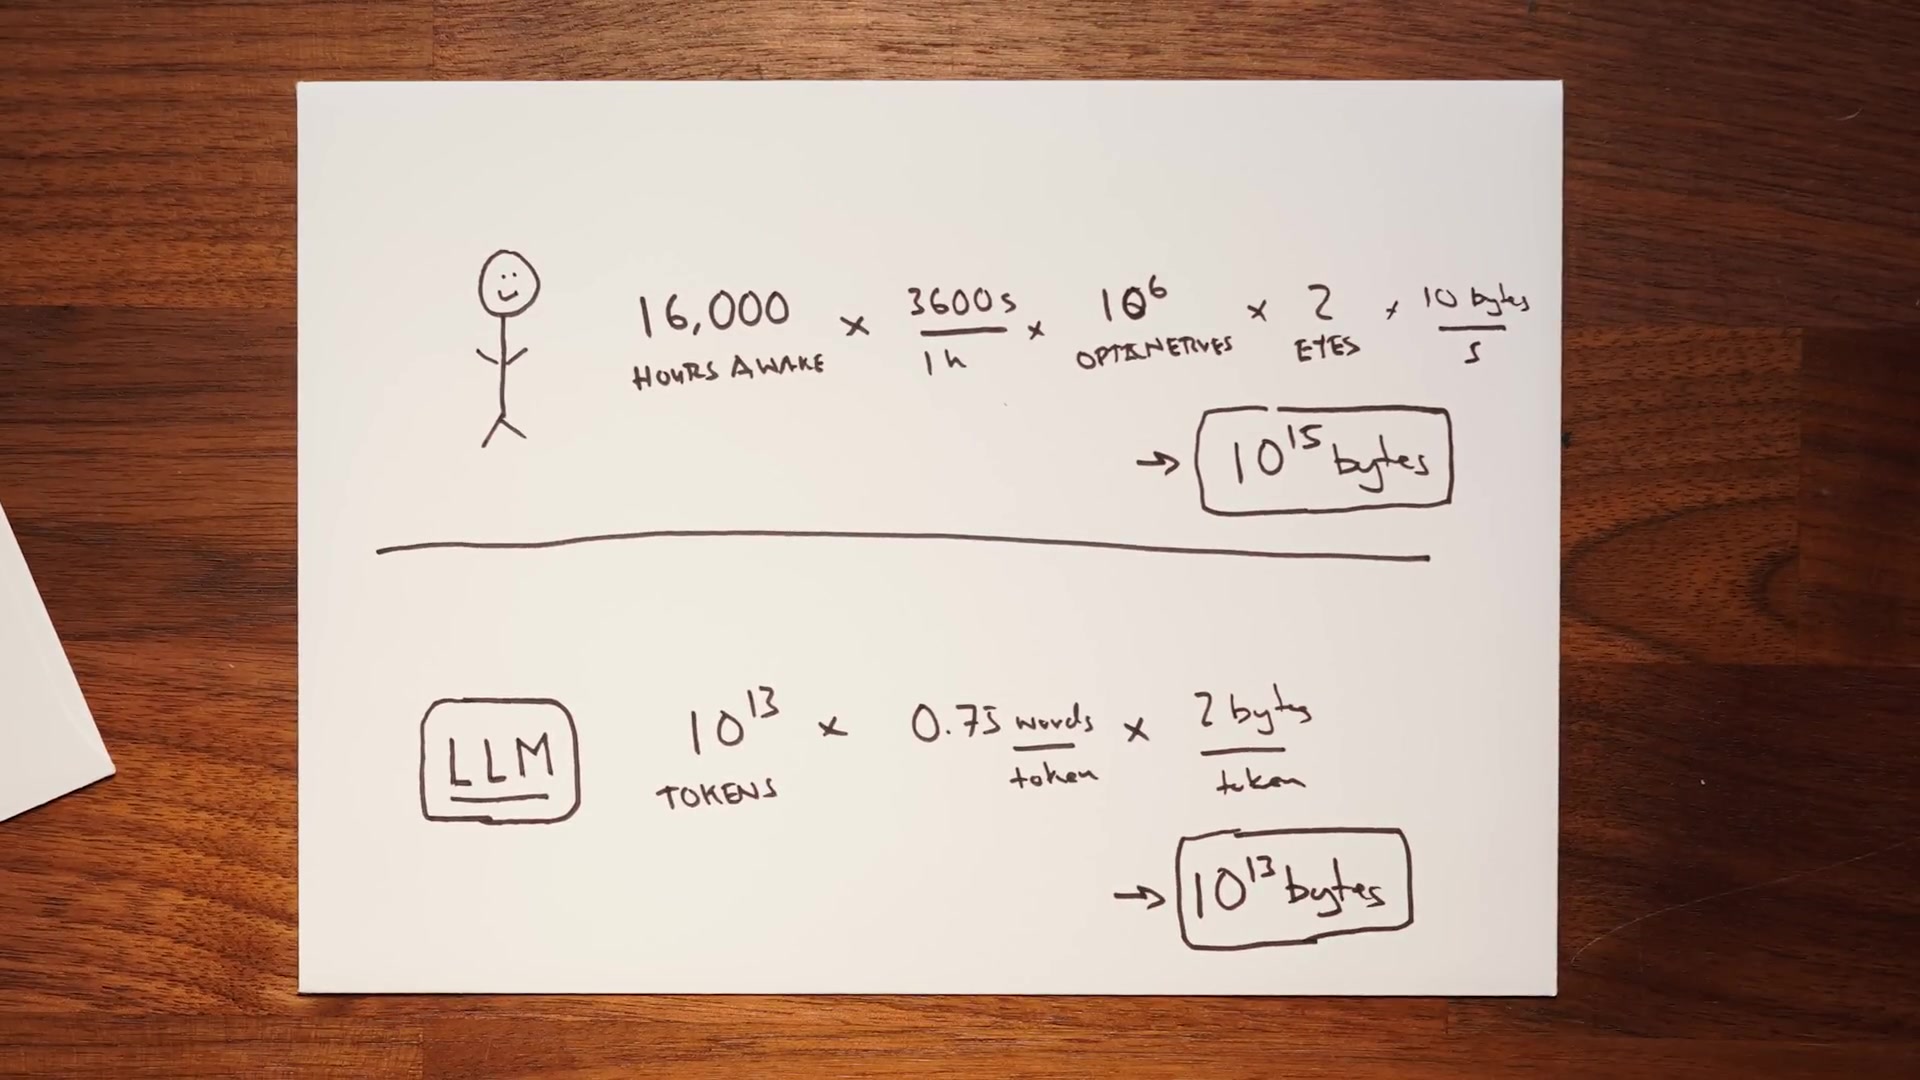
“VL-JEPA가 7B 모델들을 능가한다”는 내레이션은 화면 표의 일부에만 해당한다. 이 보고서는 서술보다 표에 적힌 값을 우선하며, 1.6B 모델의 높은 효율과 최상위 비교군 대비 열세를 동시에 기록한다.
04 · The VLA critique
“VLA는 망했다”는 주장에는 두 개의 근거가 있다
LeCun의 비판은 성능 시연을 부정하는 데 있지 않다. 그는 행동 복제의 데이터 확장성과 명시적 계획의 부재를 문제 삼는다. 첫 번째 비판에는 강한 반론이 있지만, 두 번째는 시스템 구조에 관한 더 근본적인 질문이다.
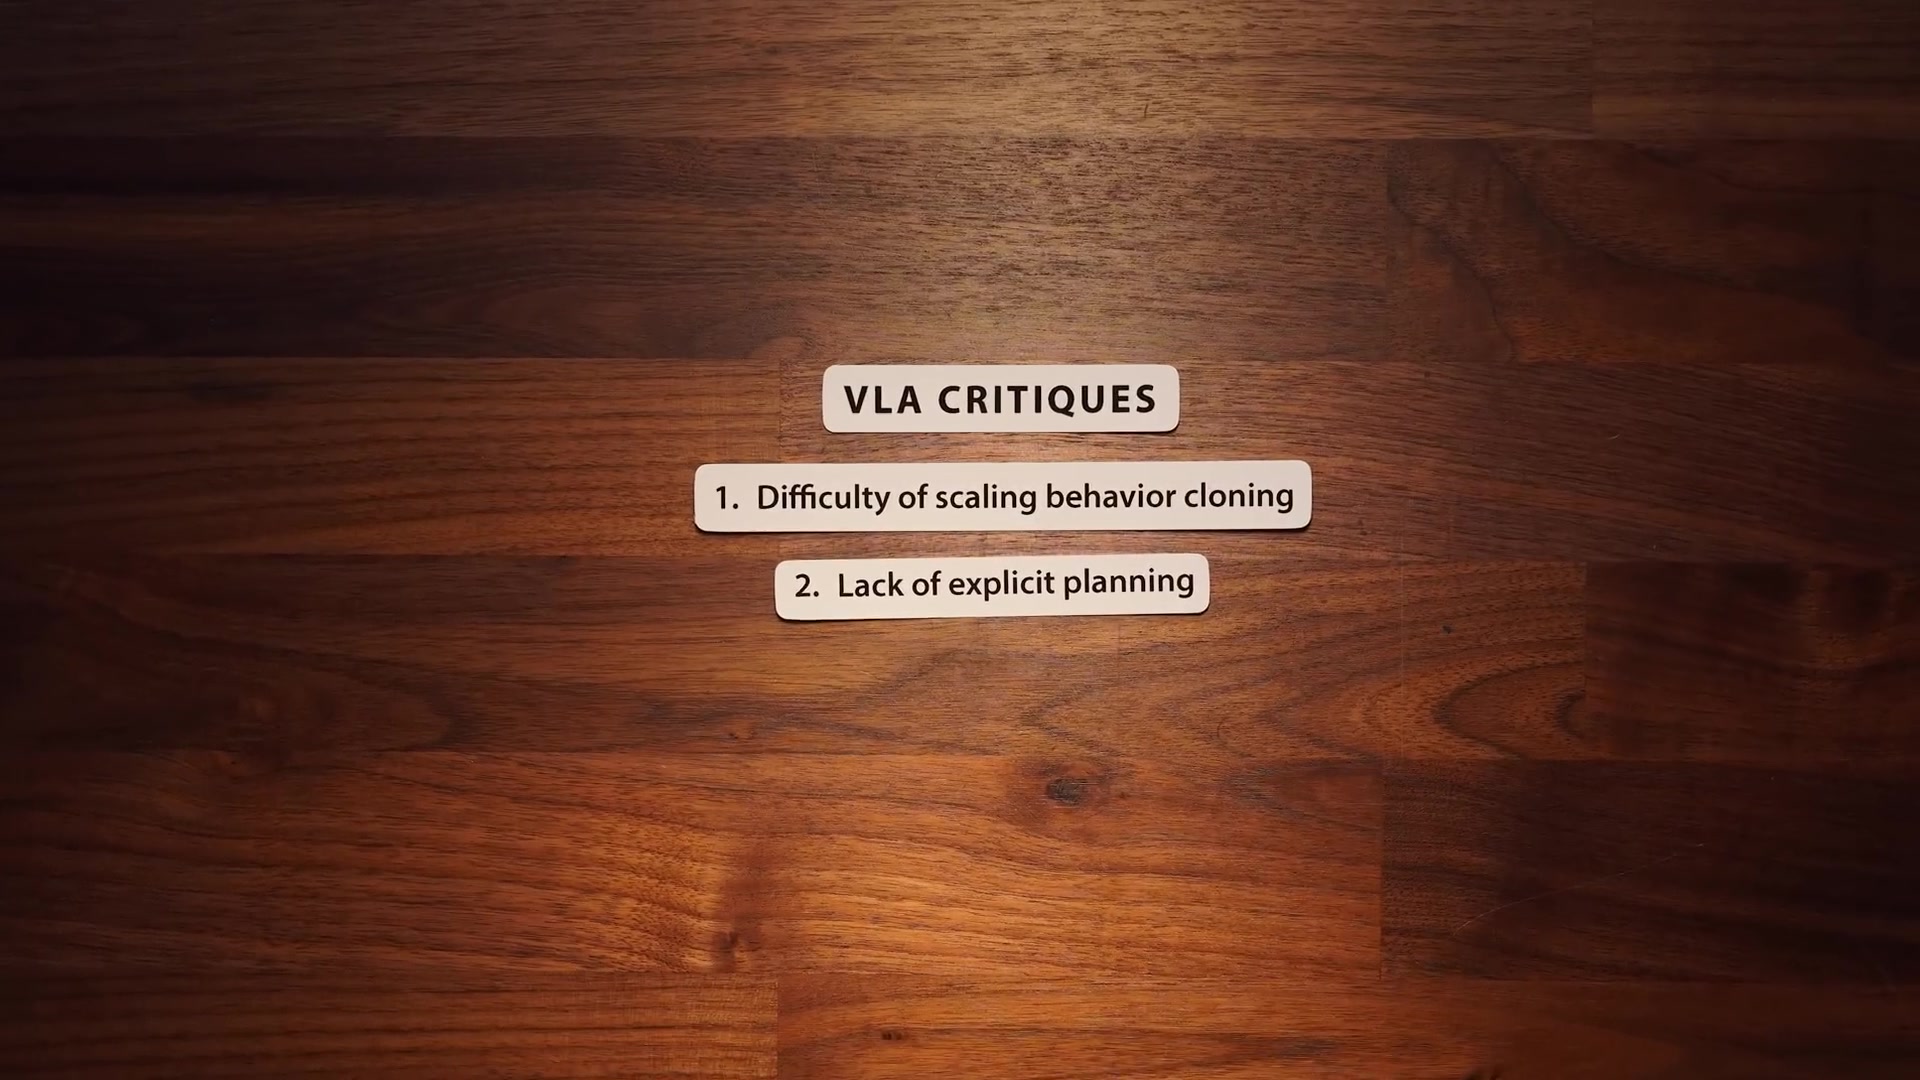
비판 ① 행동 복제는 시연 데이터에 묶인다
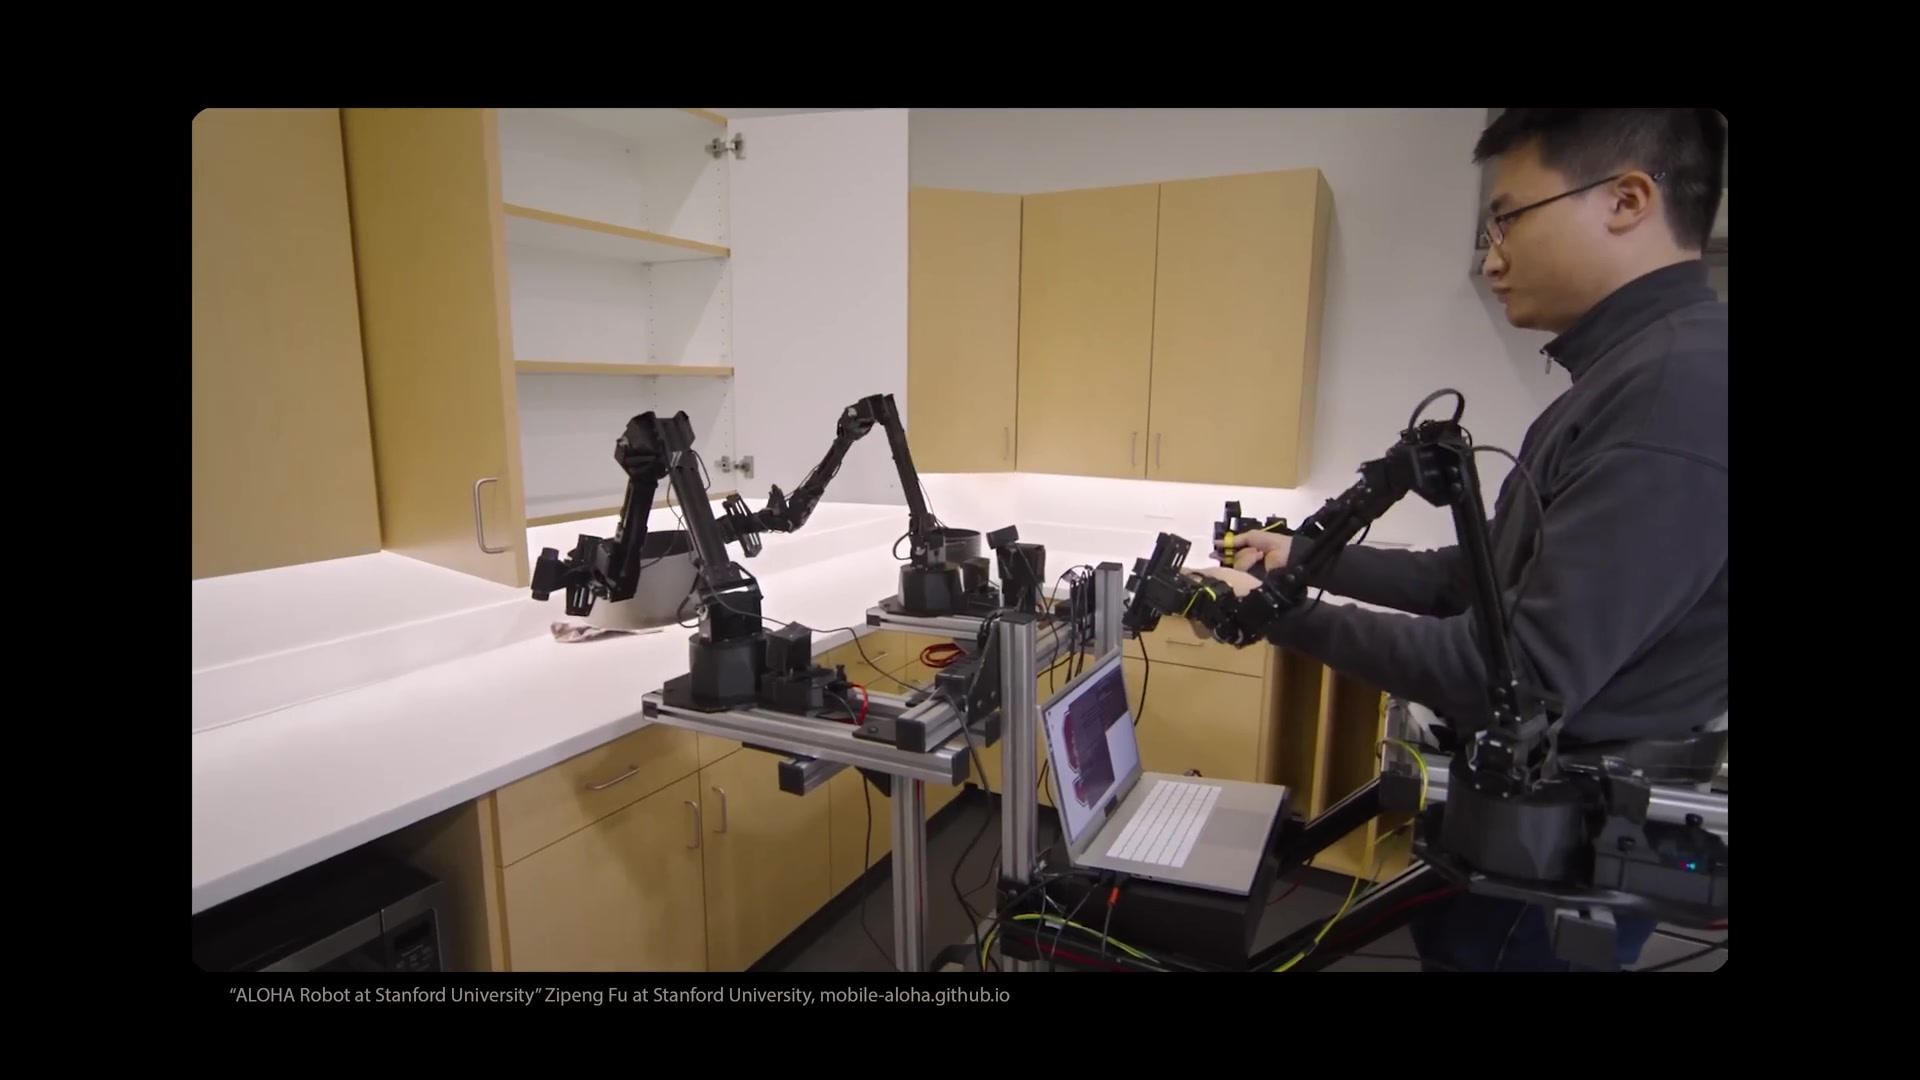
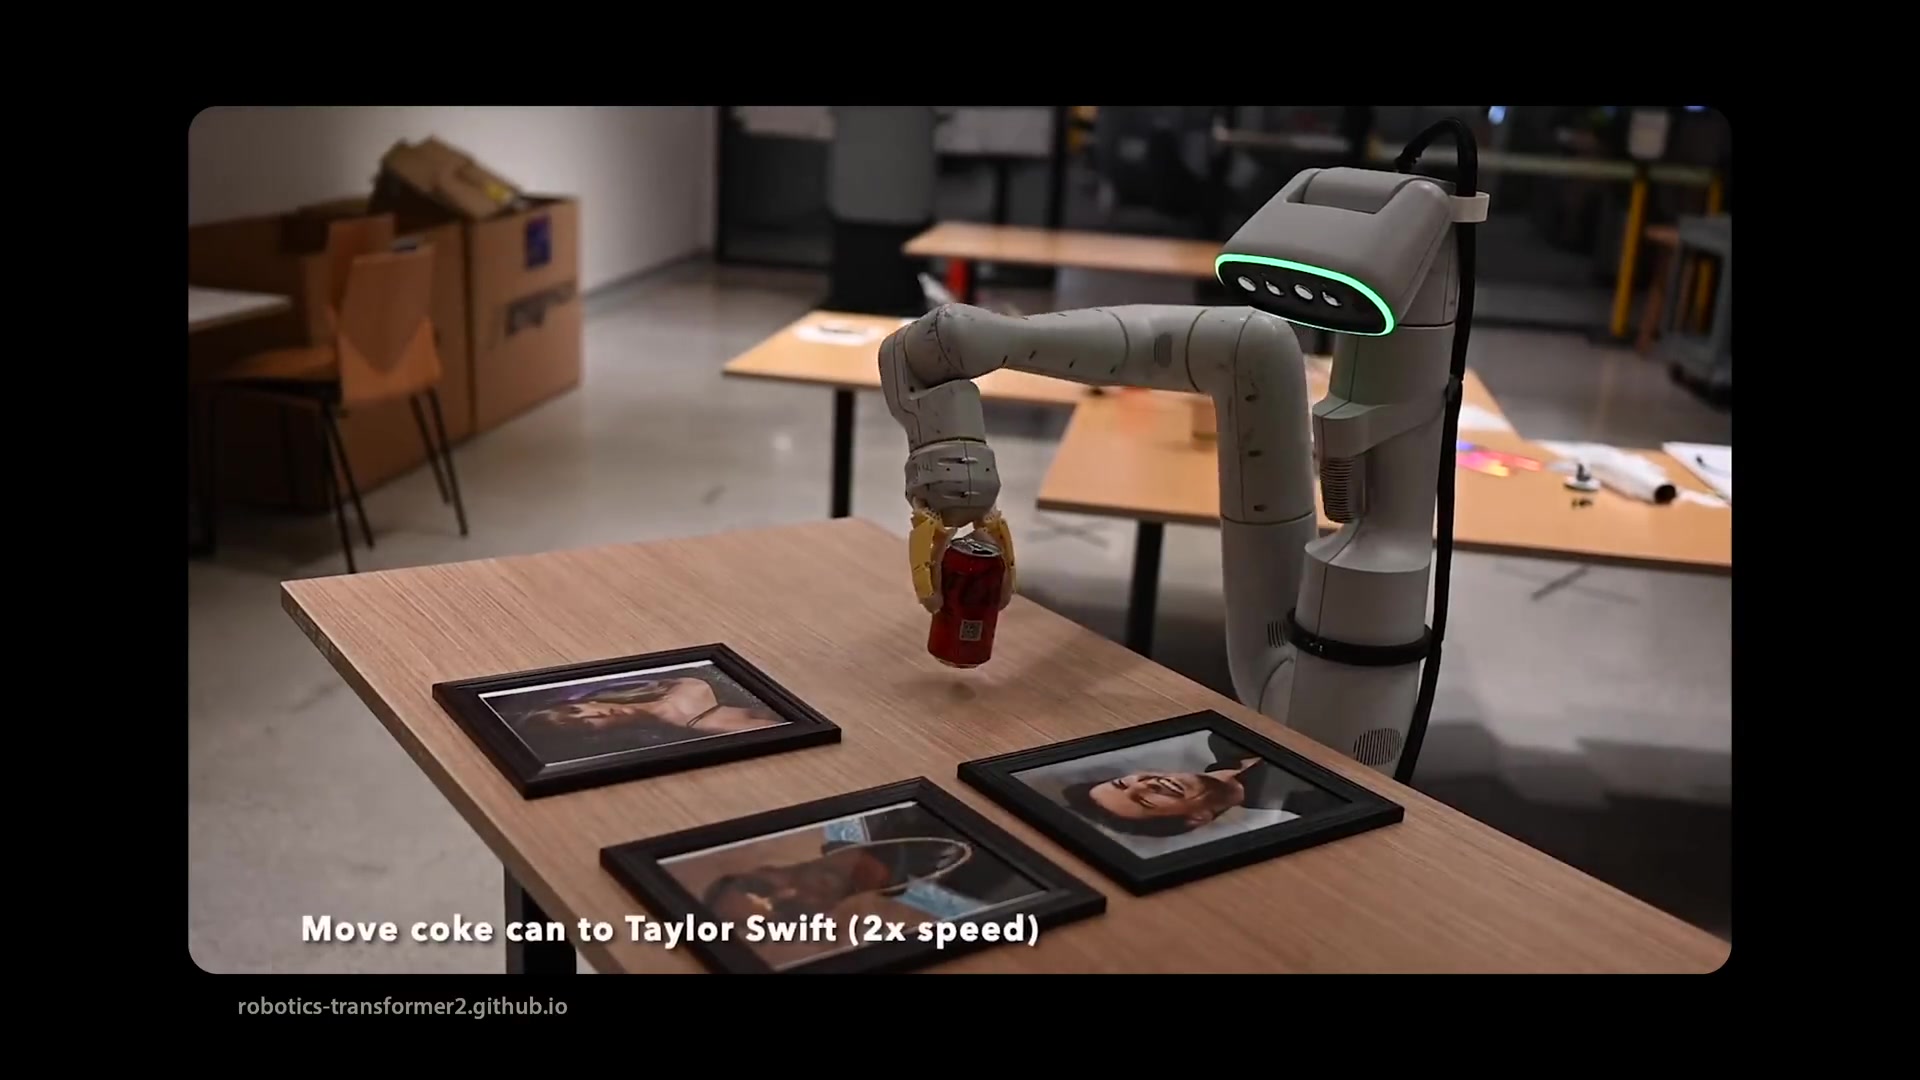
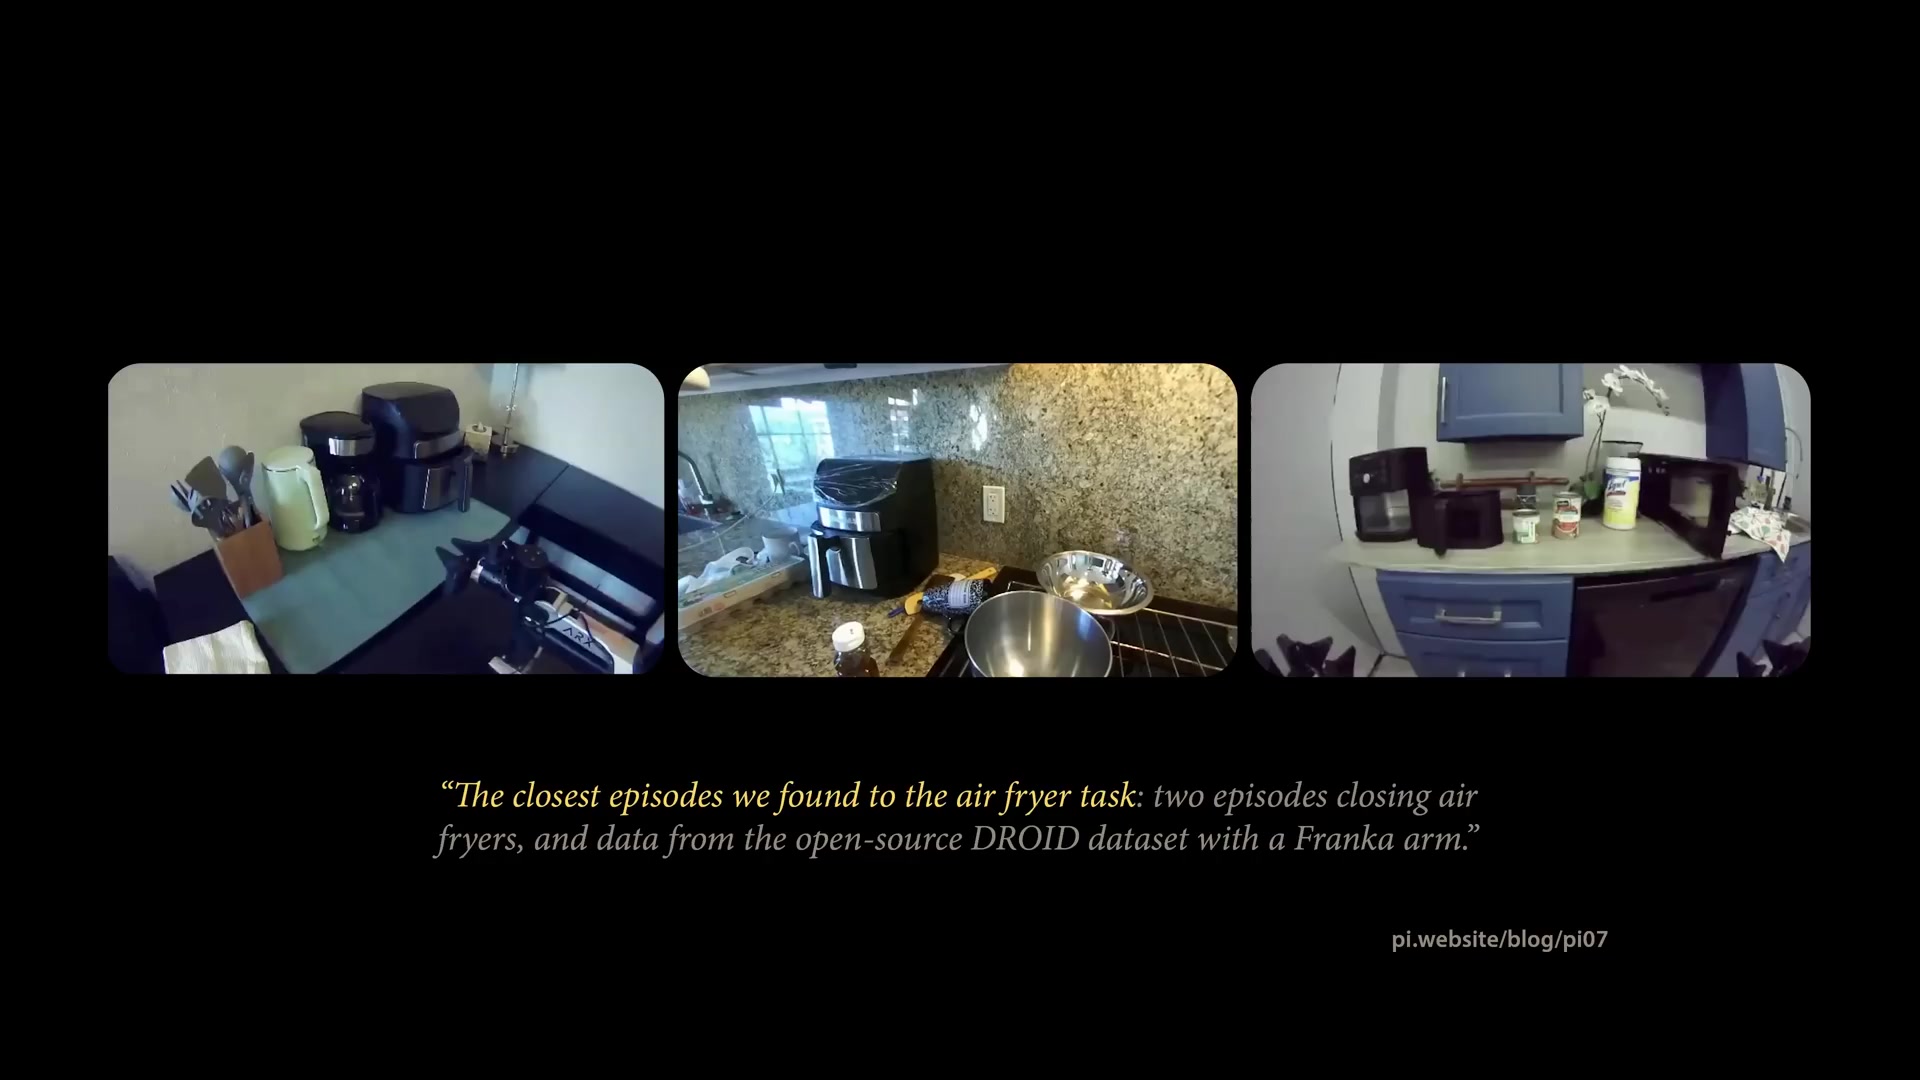
RT-2 이후의 VLA는 시연 데이터에 정확히 존재하지 않던 개념과 과제로 일반화해 왔다. 따라서 “행동 복제는 전혀 일반화하지 못한다”는 강한 명제는 유지되기 어렵다. 남는 질문은 시연 분포에서 얼마나 멀리, 얼마나 안정적으로 일반화할 수 있는가다.
비판 ② 행동하기 전에 결과를 예측하지 않는다
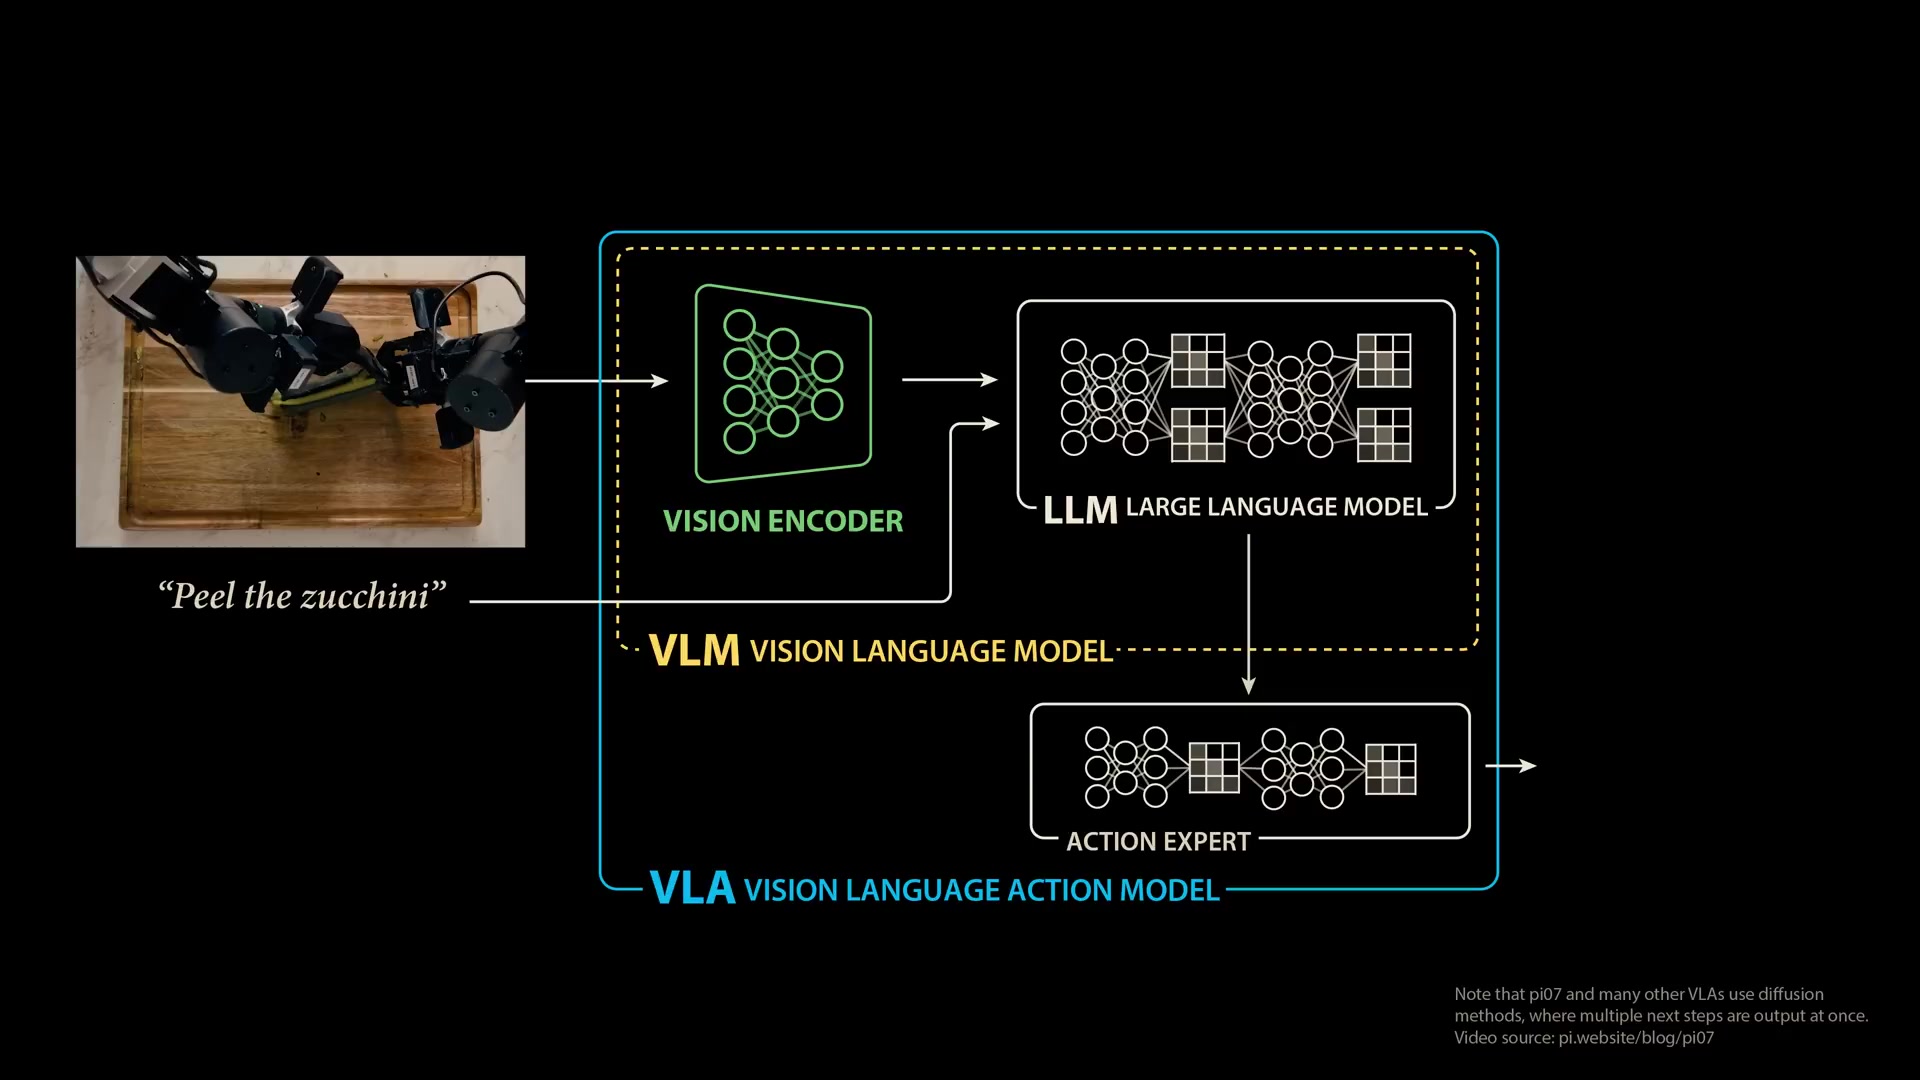
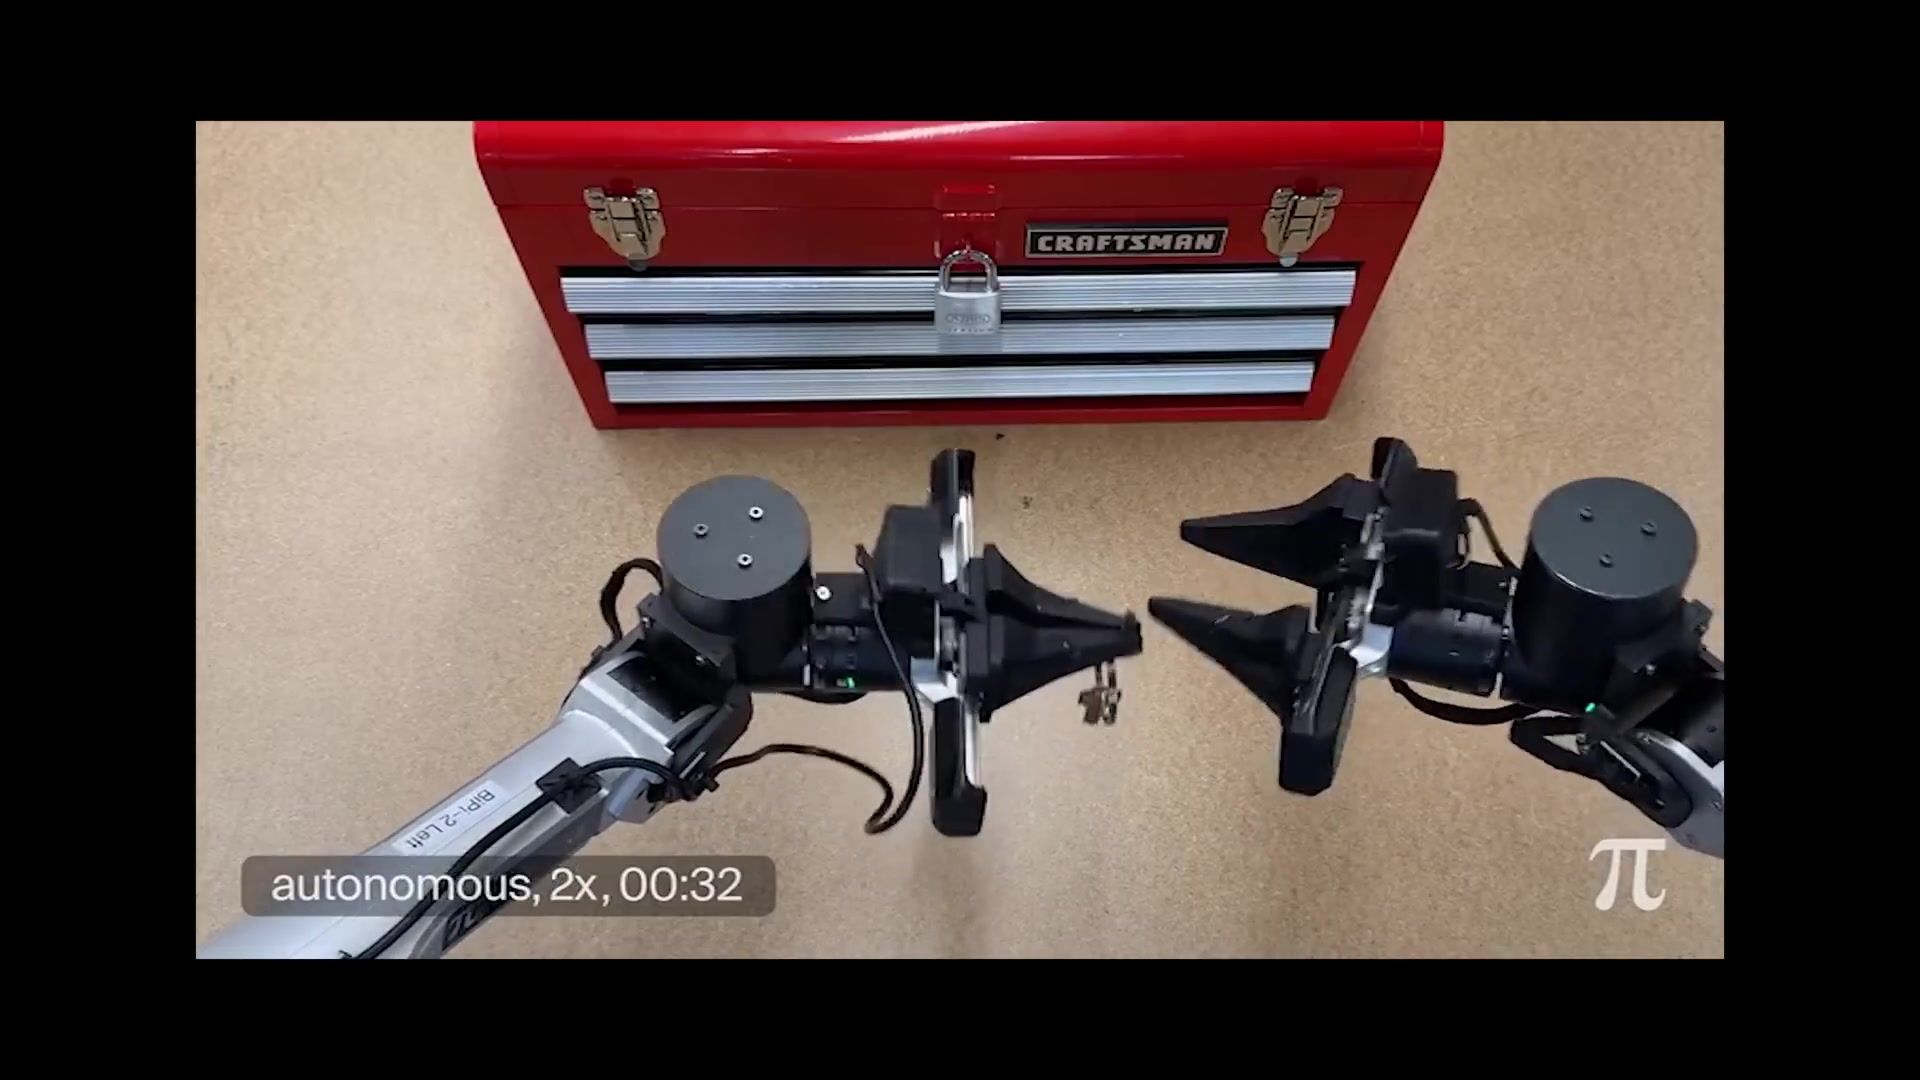
행동을 생성하는 것과생성과 계획을 가르는 구조적 차이
행동의 결과를 예측하는 것은 다르다.
05 · Planning in latent space
월드 모델은 추론을 생성에서 탐색으로 바꾼다
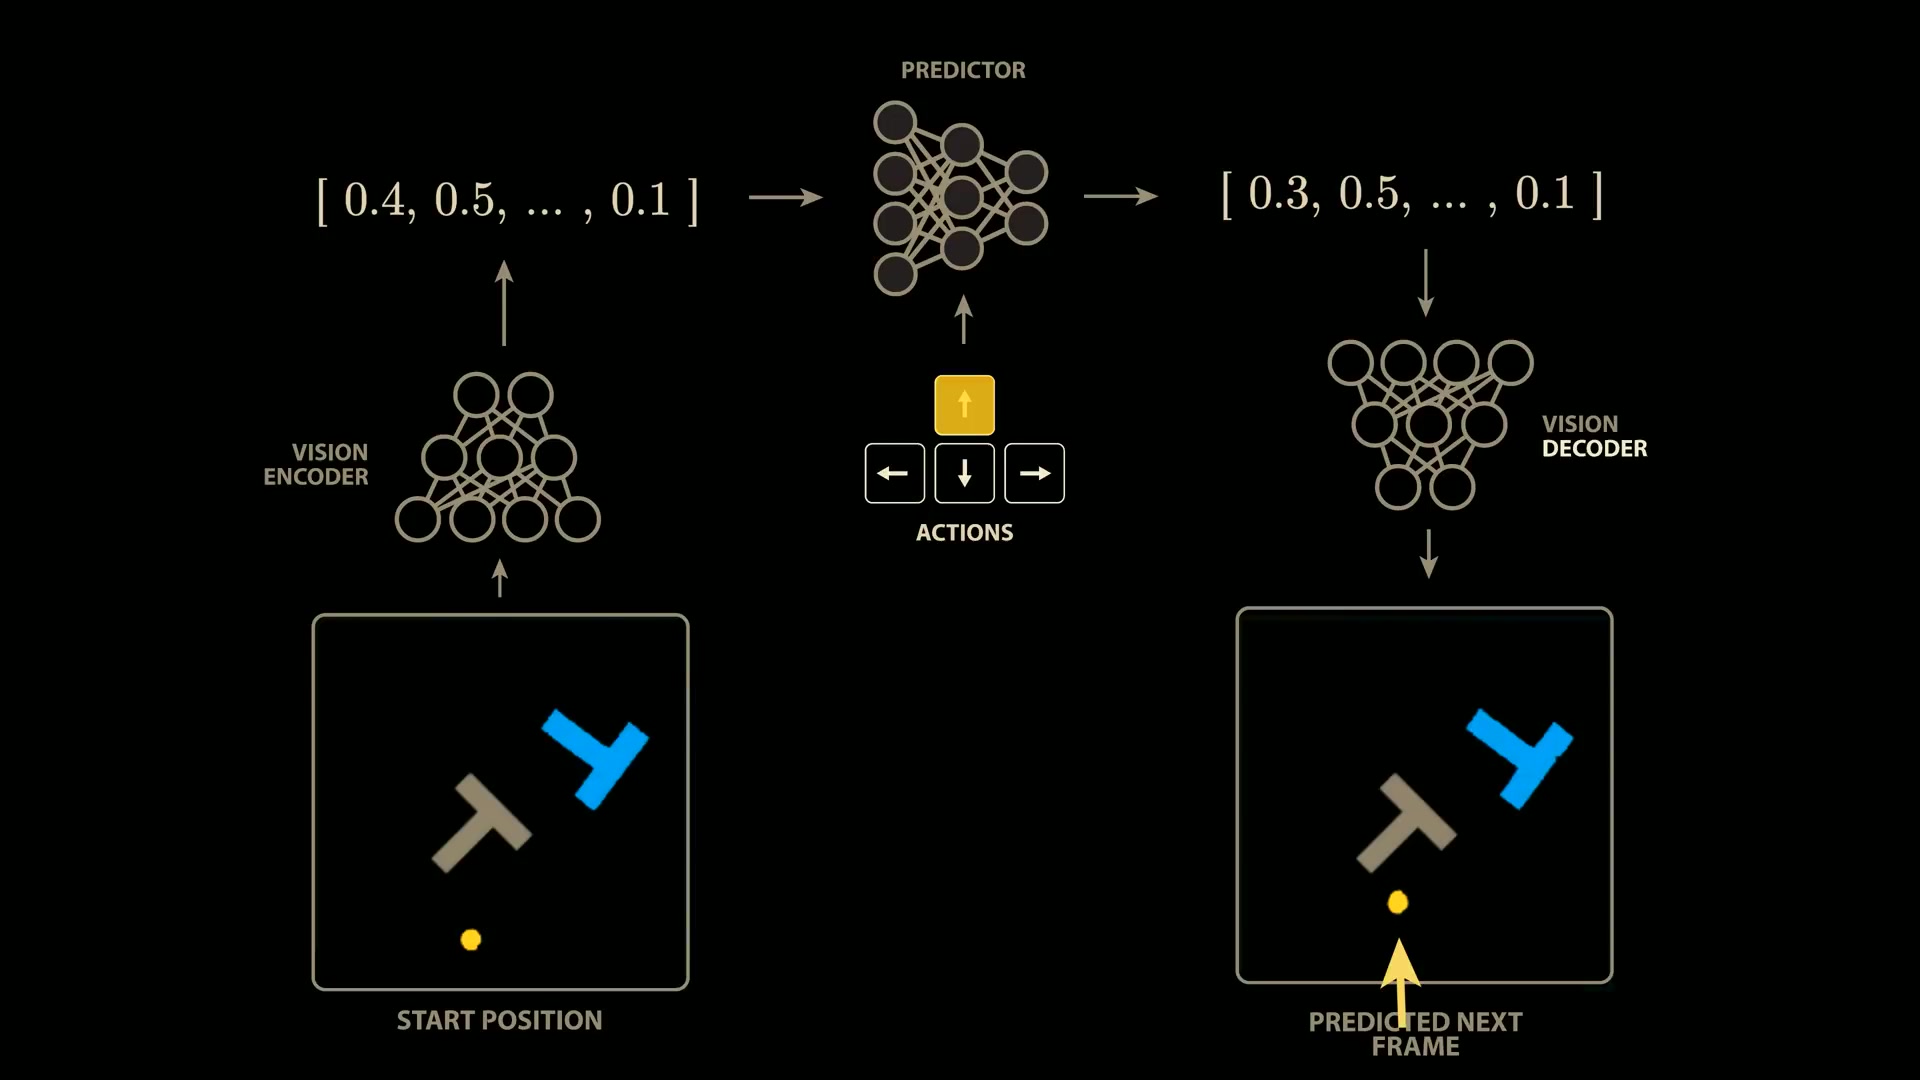
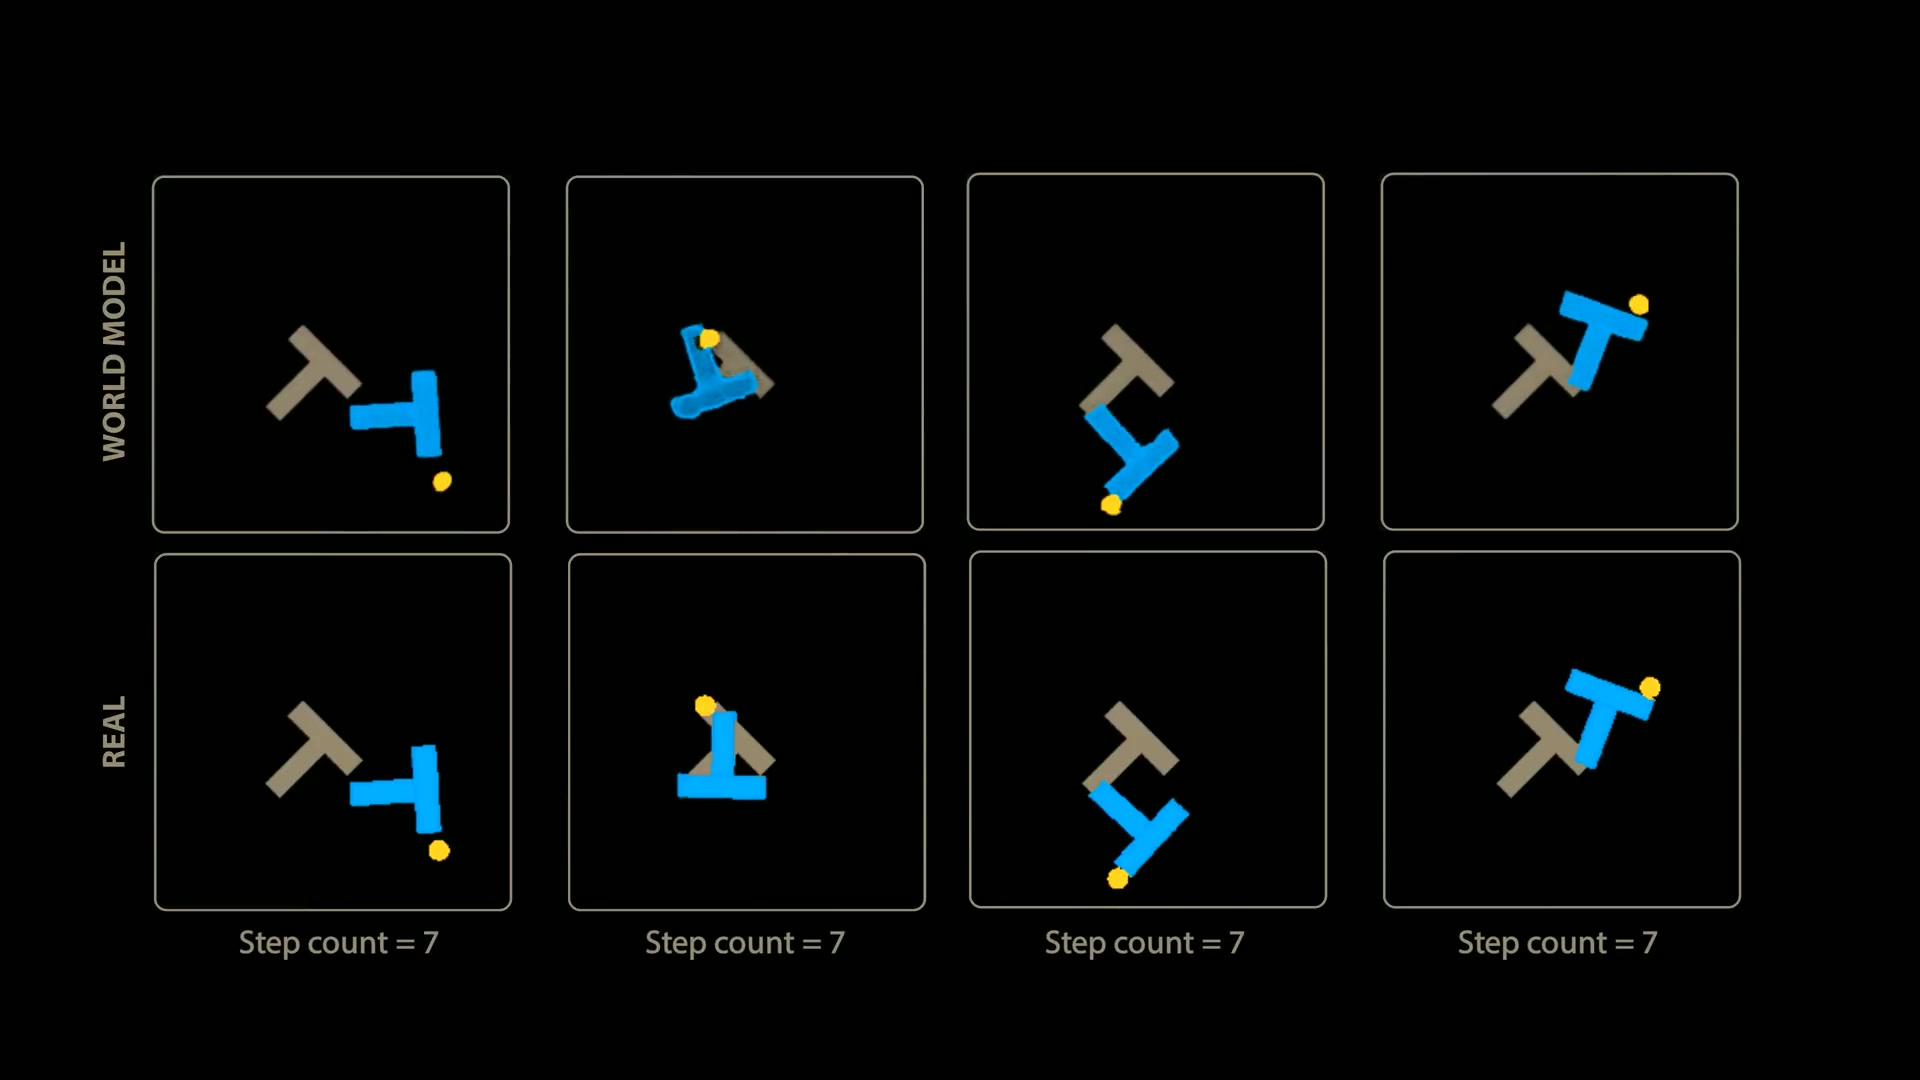
행동 조건부 월드 모델은 사람의 행동을 그대로 흉내 내지 않는다. 현재 상태에서 특정 행동을 했을 때 다음 상태가 어떻게 변할지를 학습한다. 목표가 주어지면 여러 행동 시퀀스의 결과를 미리 굴려 보고 가장 나은 경로를 선택한다.
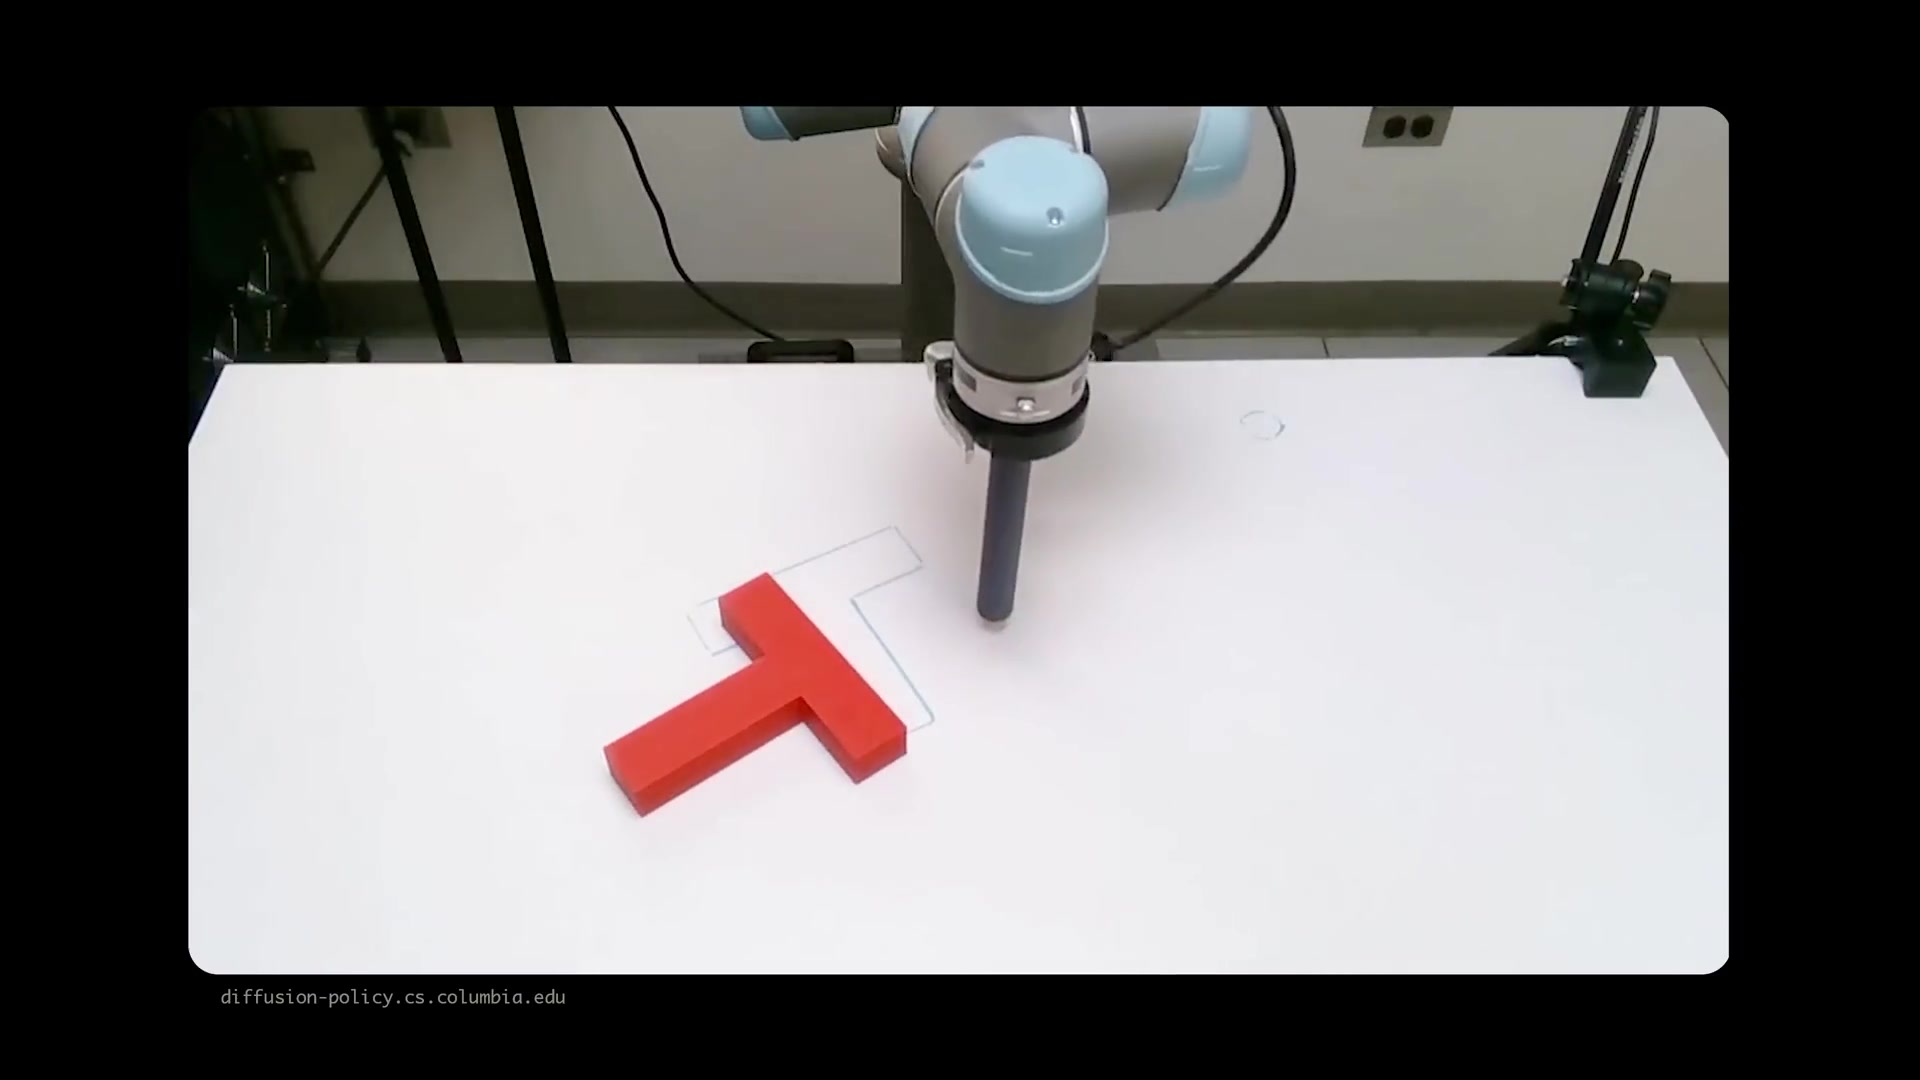
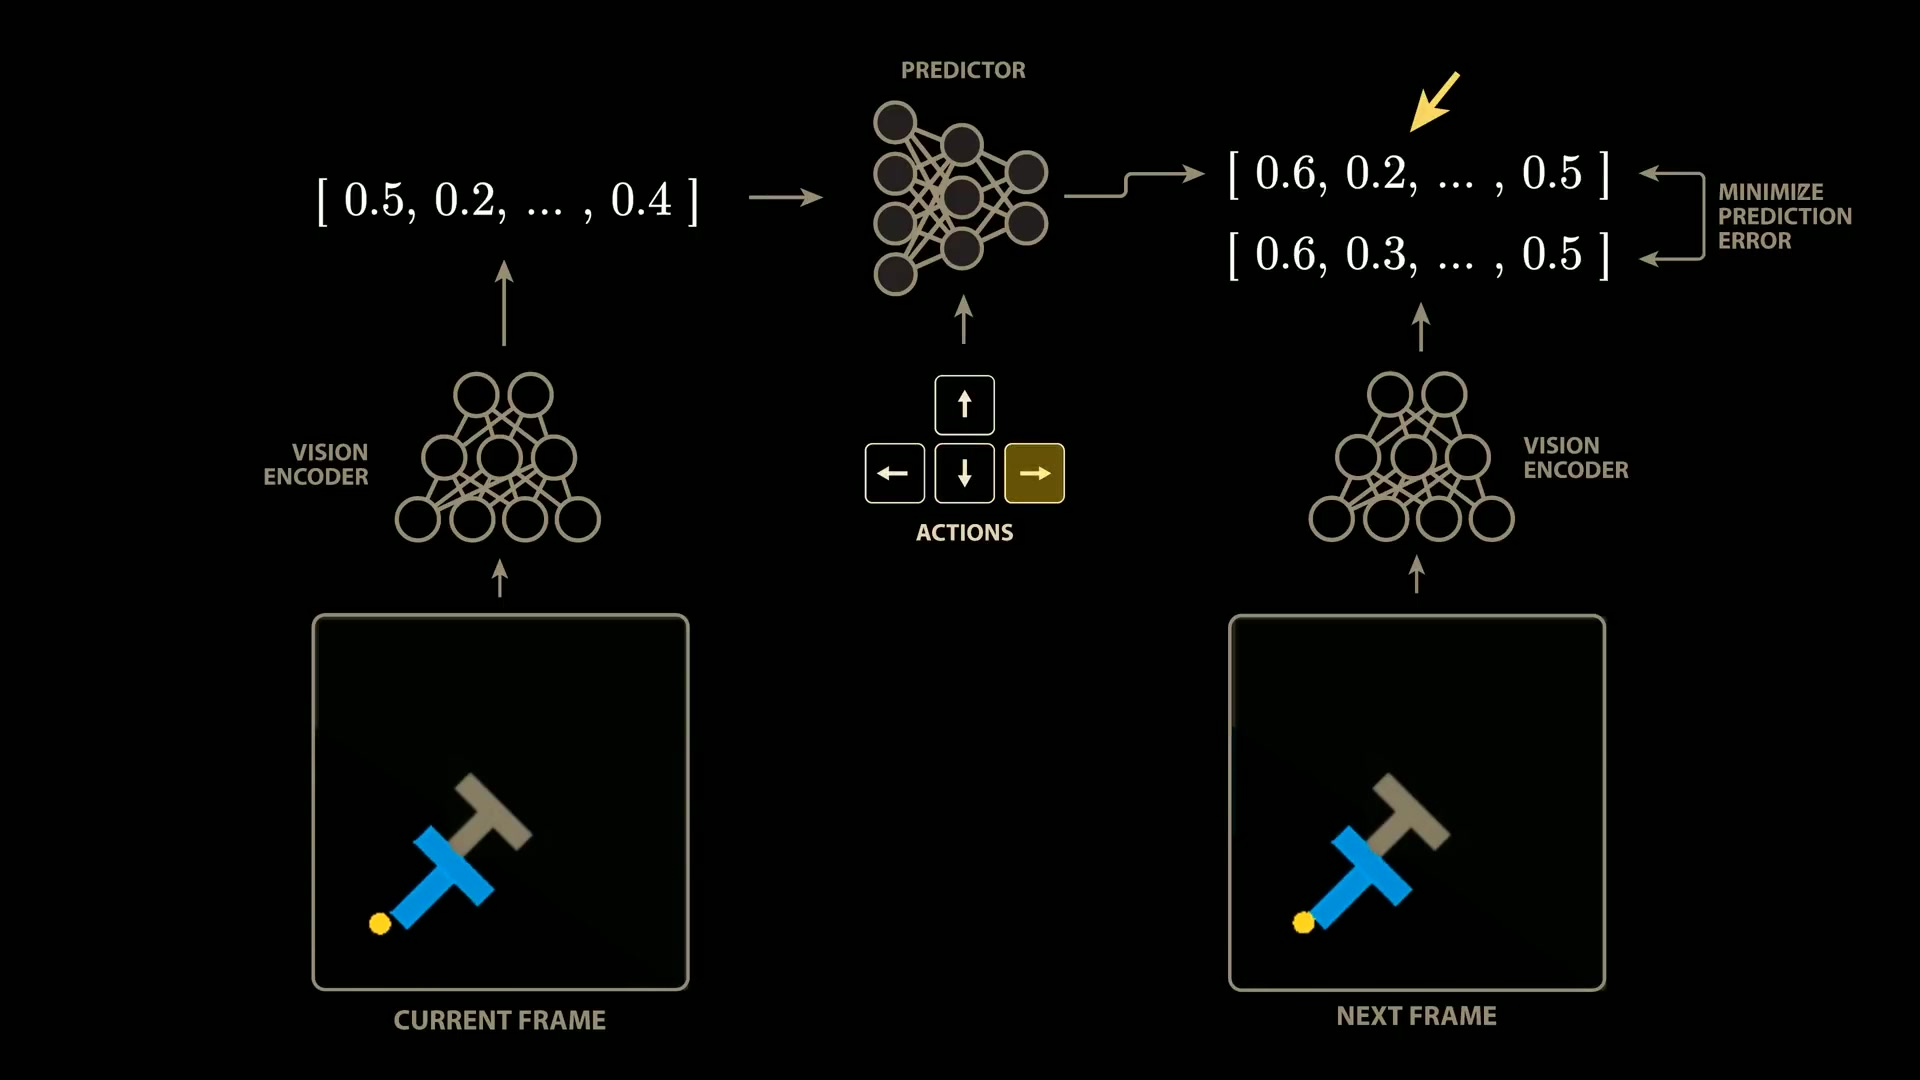
입력은 원본 픽셀과 행동뿐이다. 모델은 T가 강체라는 사실, 어디를 밀면 어떤 방향으로 회전하는지, 엔드이펙터와 물체가 어떻게 상호작용하는지를 데이터에서 배운다. 예측 결과 자체는 사람이 읽을 수 없는 벡터이므로 분석할 때만 별도 이미지 디코더를 사용한다.
CEM: 500개의 미래를 굴려 최선의 행동을 찾는다
Cross-Entropy Method · 계획 루프
500개
25스텝 예측
거리 계산
30개 선택
반복
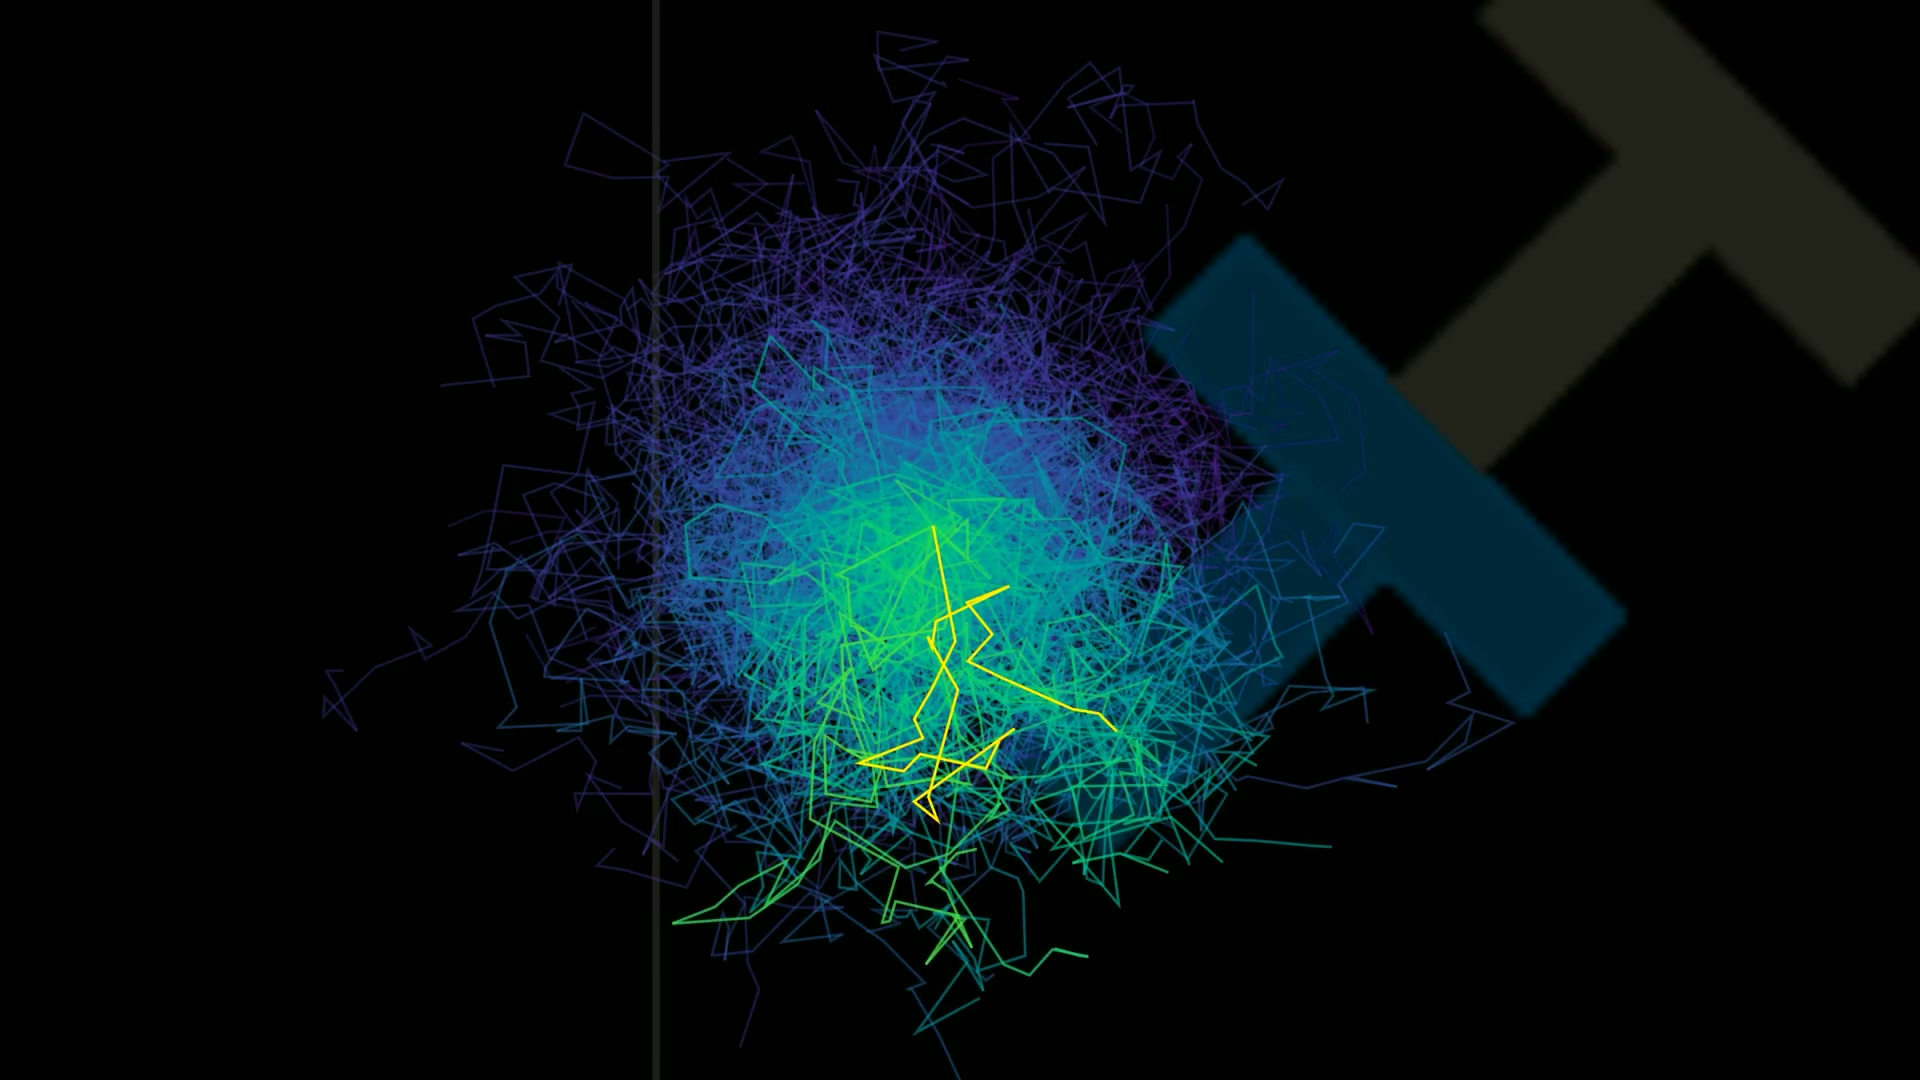
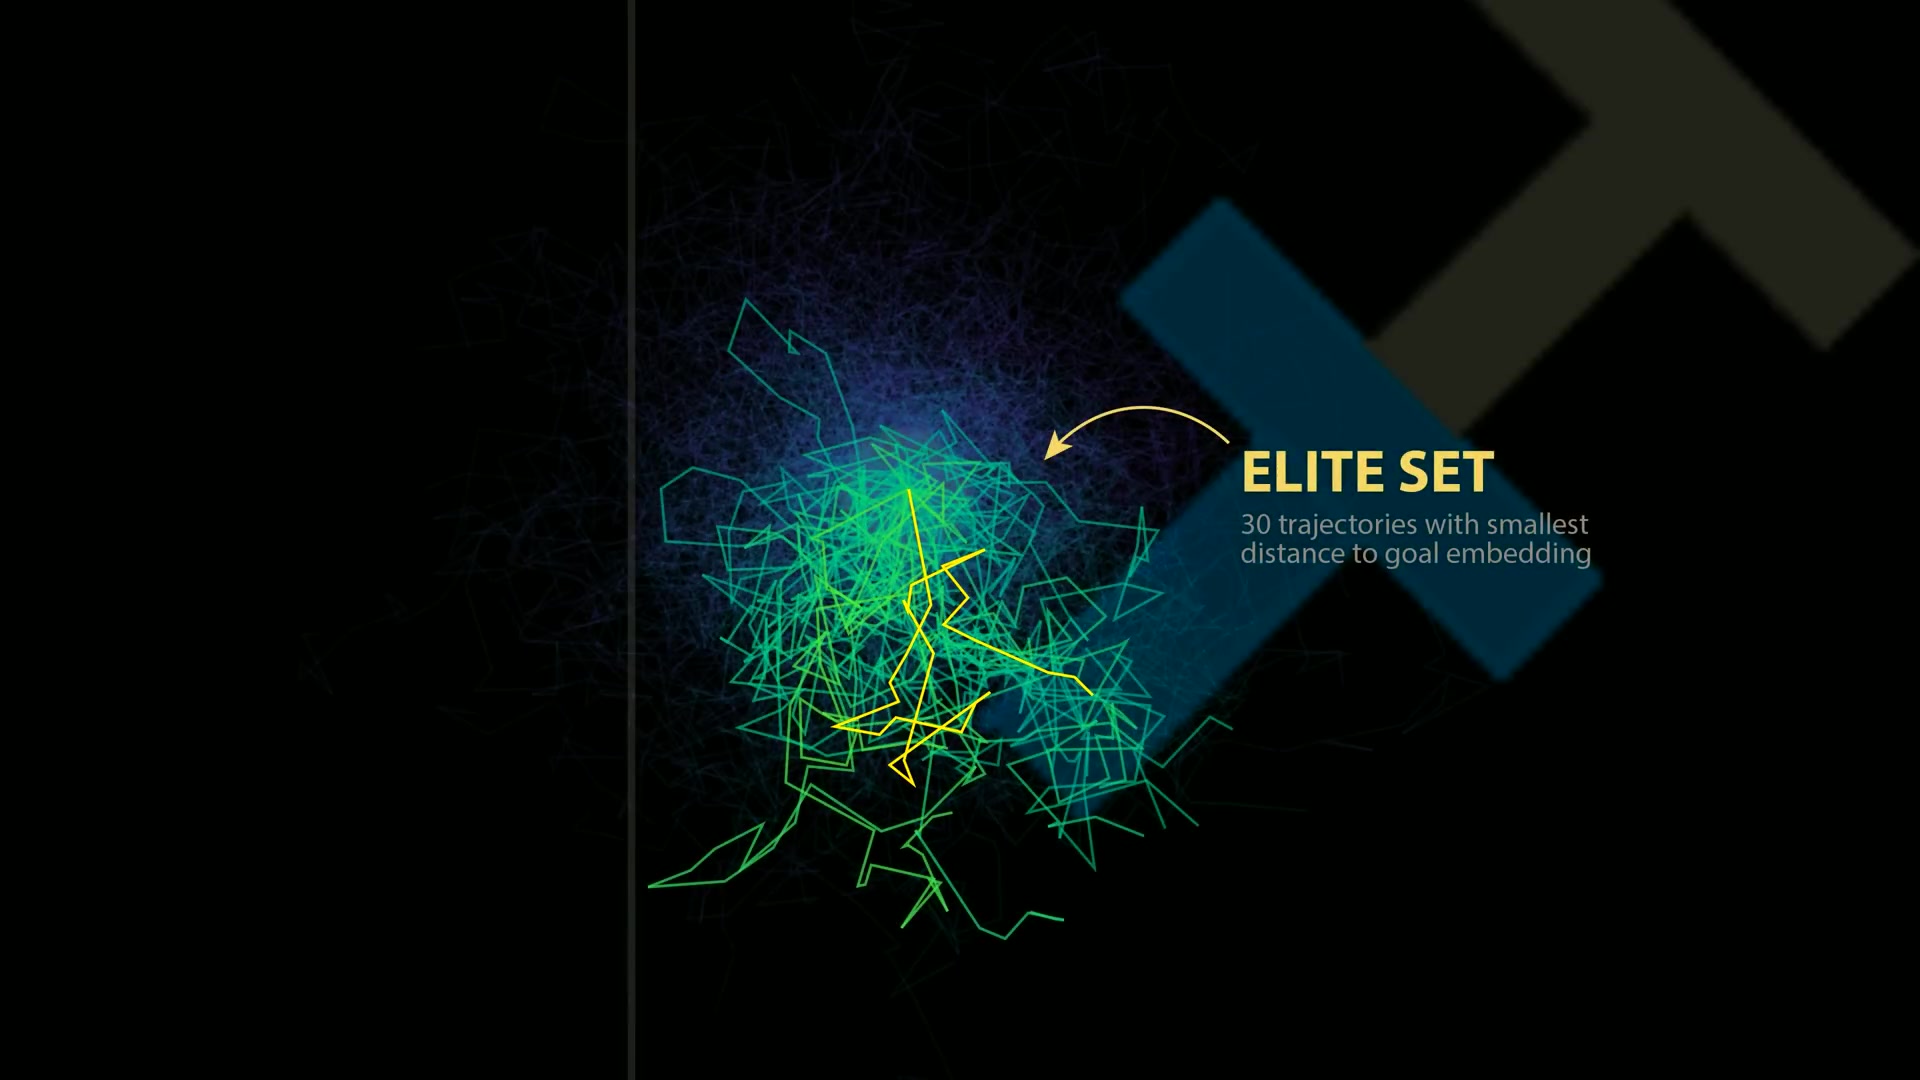
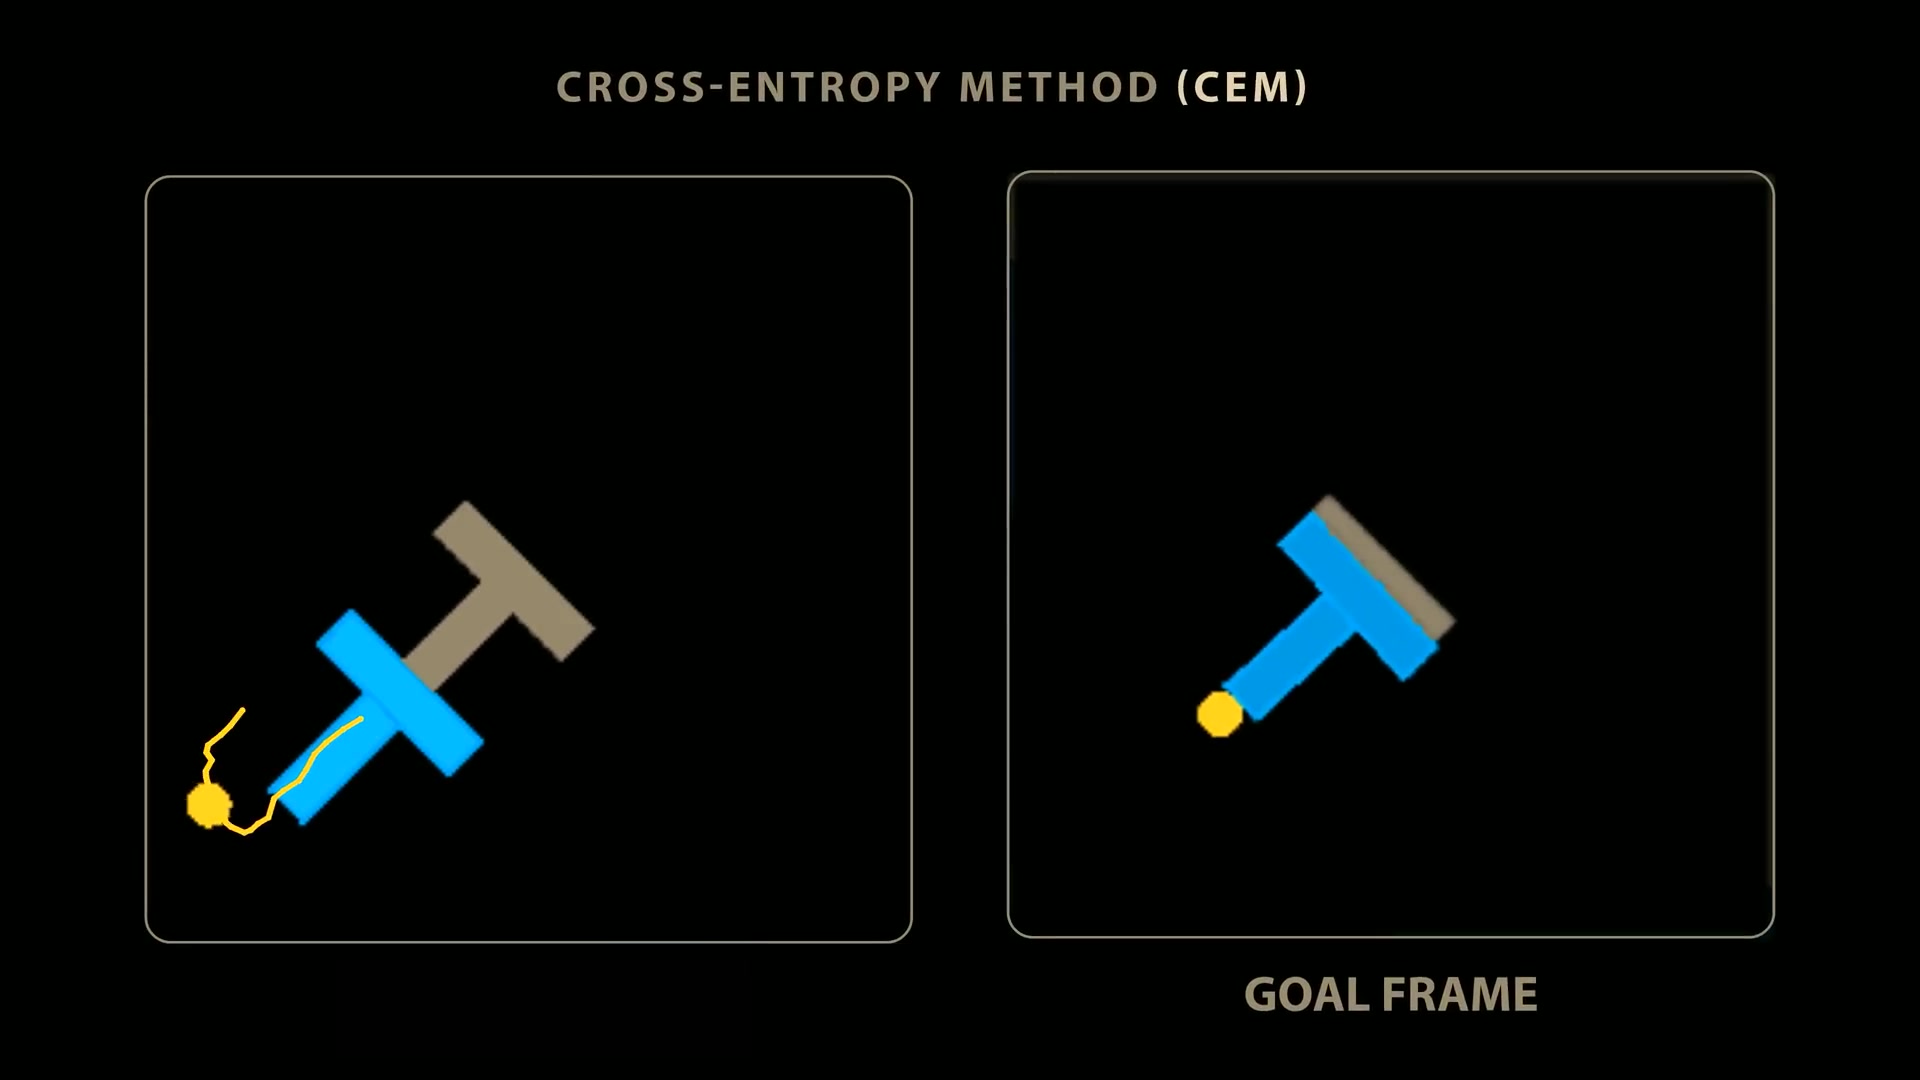
비용 함수가 사람이 작성한 복잡한 규칙이 아니라 목표 이미지 한 장으로 대체된다. 계획은 픽셀이나 언어가 아닌 학습된 임베딩 공간에서 진행된다. 구조적으로는 표현 공간에서 수행하는 모델 예측 제어(MPC)에 가깝다.
06 · The horizon problem
멀리 보려면 디테일을 버려야 한다
단일 월드 모델의 가장 큰 약점은 롤아웃 오차다. 자세한 상태를 멀리까지 예측하려 할수록 현실과 빠르게 어긋난다. 계층적 월드 모델은 상위 층에서 성긴 서브골을 예측하고 하위 층에서 짧고 자세한 행동을 채우는 방식으로 이 문제를 다룬다.
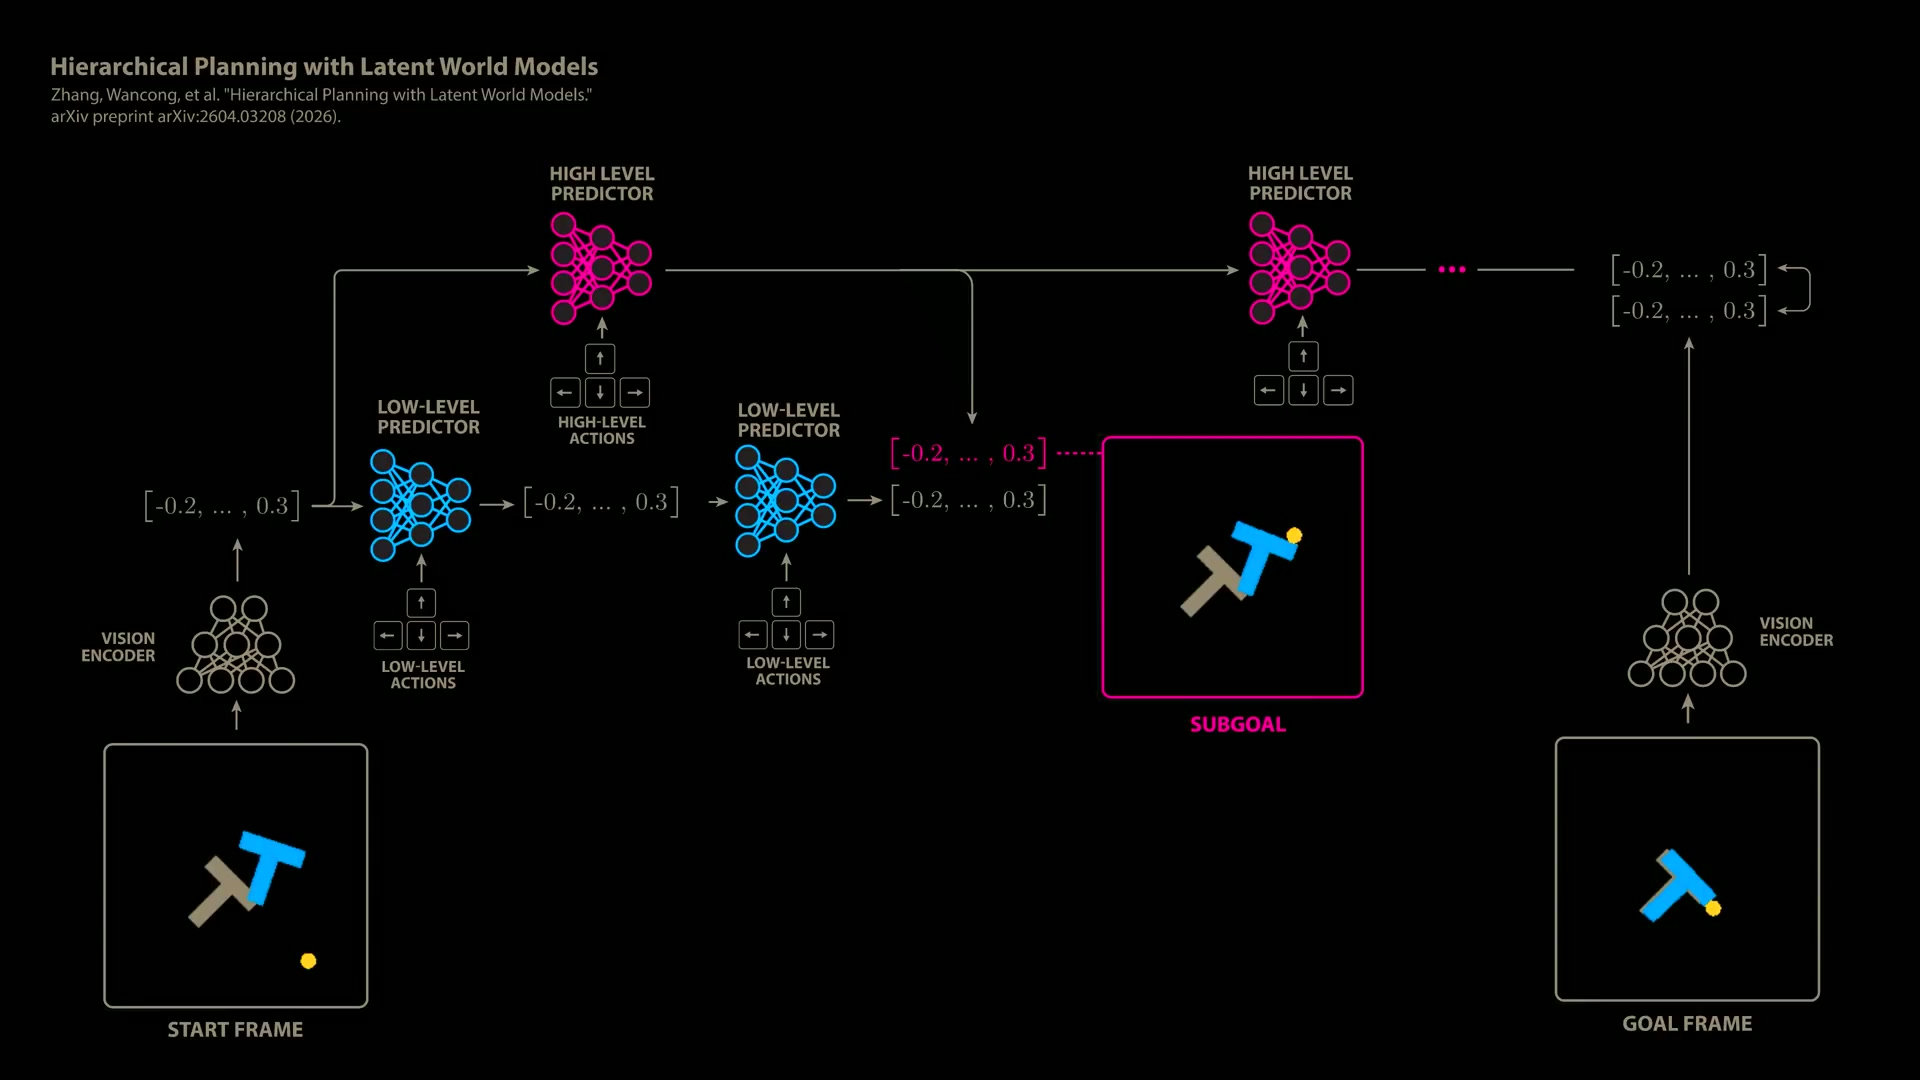
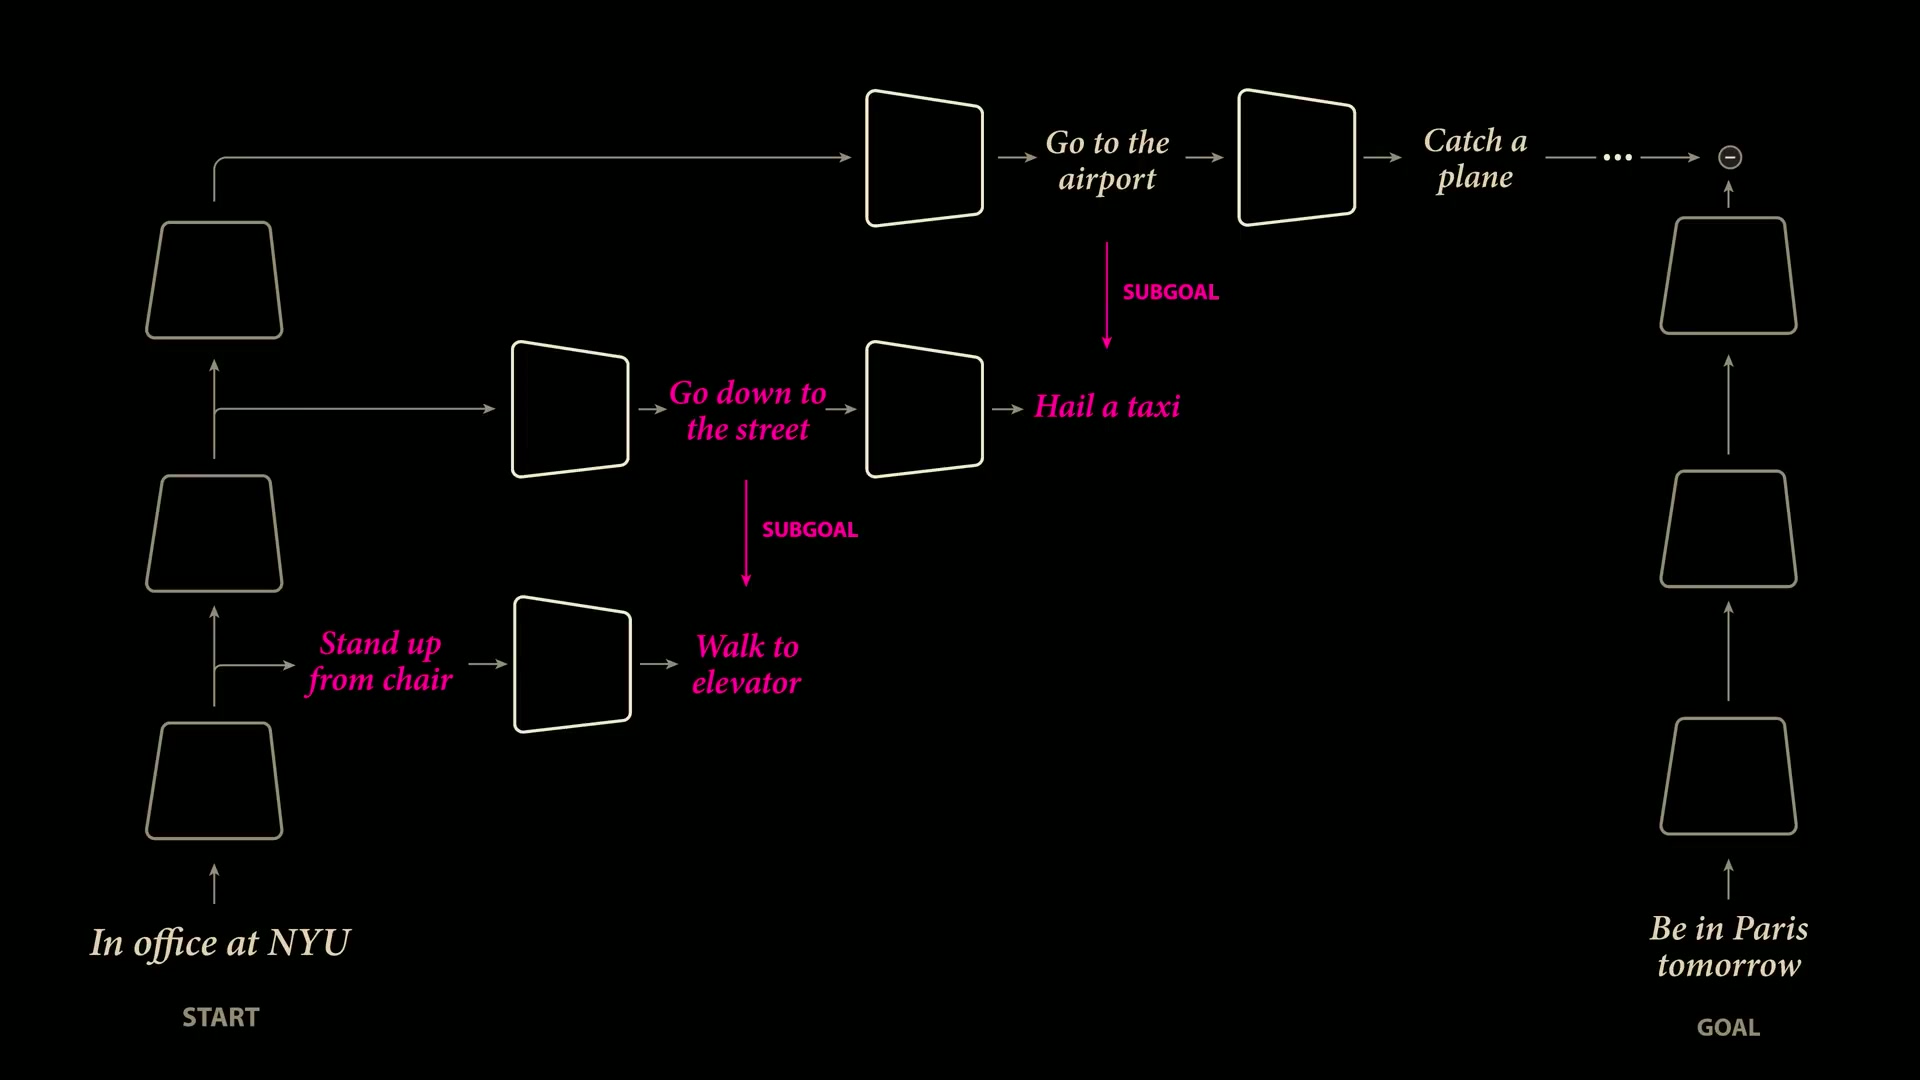
한 목표, 여러 시간 규모
계층 사이의 인터페이스가 언어일 필요는 없다. LeCun은 심층 신경망의 층 사이와 같은 종류의 학습된 표현을 상정한다. 다만 완전 무작위 행동만으로는 고수준 구조가 드러나지 않으므로, 계층을 학습하려면 준전문가 궤적이 필요하다는 조건이 붙는다.
영상이 제시한 Push-T 결과에서 계획 지평은 단일 계층 약 5회에서 2계층 15스텝으로 늘었다. 의미 있는 개선이지만 2D·완전 관측·단일 강체 환경을 넘어 실제 다자유도 로봇에 적용될지는 검증되지 않았다.
07 · Evidence ledger
수치로 다시 보는 판정
| 항목 | 값 | 근거 |
|---|---|---|
| V-JEPA 2 사전학습 비디오 | 100만 시간 | 자막 04:32 |
| V-JEPA 2 파라미터 | 최대 10억 | 자막 04:37 |
| MVP paired accuracy | 44.5 | 논문 화면 07:26 |
| PerceptionTest | 84.0 | 논문 화면 07:26 |
| TempCompass | 76.9 | 논문 화면 07:26 |
| TemporalBench | 36.7 | 논문 화면 07:26 |
| TOMATO | 40.3 | 논문 화면 07:26 |
| Epic-Kitchens-100 recall-at-5 | 39.7, 직전 최고 대비 +44% | 논문 화면 07:26 |
| V-JEPA 2-AC 사후학습 | 라벨 없는 로봇 데이터 62시간 | 논문 화면 07:26 |
| VL-JEPA 대 VLM, 500만 예시 | 35% 대 20% | 화면 12:02 |
| VL-JEPA 대 VLM, 1,500만 예시 | 약 41% 대 27% | 화면 12:02 |
| VL-JEPA SFT | 1.6B / GQA 61.5 | 화면 12:50 |
| JEPA 로봇의 컵 이동 | 60초 | 자막 00:46 |
| CEM 초기 후보 | 500개 궤적 | 화면 29:00 |
| CEM 엘리트 집합 | 30개 궤적 | 화면 29:20 |
| CEM 계획 길이 | 행동 5개씩, 총 25스텝 | 자막 27:54·28:22 |
| 단일 계층 계획 지평 | 약 5회 예측 루프 | 자막 30:33 |
| 2계층 계획 지평 | 15스텝 | 자막 32:47 |
| AMI 산업 응용 예상 시점 | 1–2년 내 | 자막 36:08 |
결론을 한 문장씩 압축하면
-
인식 층: JEPA의 가설은 이미 상당 부분 작동한다.
언어 감독 없이 학습한 비디오 표현도 LLM과 결합되며 시간적 이해 벤치마크에서 강한 결과를 낸다.
-
비전-언어 층: 목표 함수의 효율 개선은 유망하다.
텍스트 표면형 대신 의미 임베딩을 예측하면 같은 데이터에서 더 빨리 학습하지만, 전 과제에서 절대 우위가 증명된 것은 아니다.
-
제어 층: 현재 성능은 VLA가 앞선다.
월드 모델의 명시적 계획은 구조적으로 매력적이지만, 오차 누적과 짧은 지평 때문에 실제 로봇 능력은 아직 제한적이다.
-
장기 승부: 안전하고 검증 가능한 계획이 차별점이다.
행동 전 결과를 예측할 수 있다면 목표 달성뿐 아니라 안전 제약도 탐색 단계에서 평가할 수 있다.
08 · Implications
연구와 현장에 남는 다섯 가지 시사점
-
목표 이미지 기반 제어를 검토할 가치가 있다.
목표 상태를 수식으로 쓰기 어려운 굴착 형상, 적재 상태, 비정형 조작에서는 임베딩 거리 기반 MPC가 손으로 설계한 보상 함수를 보완할 수 있다.
-
장주기 작업은 처음부터 계층형으로 설계해야 한다.
롤아웃 오차는 구현상의 작은 버그가 아니라 예측 모델의 구조적 제약이다. 장기 목표와 저수준 제어를 같은 해상도로 다루기 어렵다.
-
‘방정식으로 충분히 쓸 수 없는 복잡계’가 우선 적용처다.
제트 엔진, 공정 플랜트, 혈당 제어, 줄기세포 분화, 소재·촉매·배터리 설계처럼 정확한 동역학을 쓰기 어려운 시스템이 AMI의 표적이다.
-
통제 실험의 설계를 본받을 만하다.
인코더·데이터·학습 설정을 고정하고 예측 목표만 교체한 VL-JEPA 비교는 아키텍처 효과를 분리하는 좋은 평가 템플릿이다.
-
데이터 수집에는 준전문가 궤적이 필요하다.
완전 무작위 탐색만으로는 고수준 서브골 구조가 나타나지 않는다. 반숙련 조작자의 다양한 궤적이 계층 학습의 현실적인 출발점이 된다.
이 보고서가 넘어서지 않는 한계
-
주장의 출발점 자체가 LeCun 진영에 기울어 있다.
“VLA는 망했다”는 핵심 명제는 LeCun의 발언이다. 영상은 RT-2와 π0.7 사례로 균형을 시도하지만 VLA 연구자의 직접 반론은 포함하지 않는다.
-
VL-JEPA의 효�� 우위는 제한된 통제 과제에서 측정됐다.
제로샷 비디오 분류의 학습 곡선이 다른 추론·생성·로봇 과제로 그대로 일반화된다고 볼 수 없다.
-
Push-T는 장난감 환경이다.
2D 제어, 단일 강체, 완전 관측 조건에서 얻은 5→15스텝 개선은 부분 관측과 복잡한 접촉이 있는 실제 로봇의 증거가 아니다.
-
JEPA와 VLA의 직접 대결표가 없다.
같은 로봇 과제, 데이터, 지표에서 두 접근을 비교한 정량 실험 없이 층별 대리 지표와 시연을 종합해 판단한다.
-
자동 자막과 화면 판독에 의존한다.
수동 자막이 없어 영어 자동 자막을 사용했다. 고유명사와 숫자는 화면 표기를 우선했으며 자막만 근거인 값은 시각을 함께 기록했다.
09 · Source notes
출처와 조사 방법
방법론 메모
이 글은 Welch Labs 영상의 영어 자동 자막 1,177줄과 영상 프레임을 1차 근거로 재구성했다. 자동 자막이 JEPA, V-JEPA, LeWorldModel, π0.7 등의 고유명사를 오인식하는 경우 화면에 표시된 철자와 숫자를 우선했다. 스폰서 구간 15:13–17:14와 포스터·Patreon 홍보 구간은 기술 분석에서 제외했다.
- 원본 영상: Welch Labs, “Yann LeCun’s $1B Bet Against LLMs [Part 2]”, 2026-05-30.
- 선행편: Yann LeCun’s $1B Bet Against LLMs [Part 1].
- V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning, arXiv:2506.09985.
- VL-JEPA: VL-JEPA paper, arXiv:2512.10942.
- LeWorldModel: LeWorldModel paper, arXiv:2603.19312.
- 계층적 월드 모델: Hierarchical Planning with Latent World Models, arXiv:2604.03208.
- LeJEPA와 SIGReg: LeJEPA theory, arXiv:2511.08544.
- 자기지도 학습과 스펙트럴 임베딩: 관련 이론 연구, arXiv:2205.11508.
- 월드 모델 식별가능성: LeWorldModel identifiability theory, arXiv:2605.26379.
- Physical Intelligence: π0.7 소개.
- ALOHA: Zipeng Fu의 Stanford 원격조작 영상.
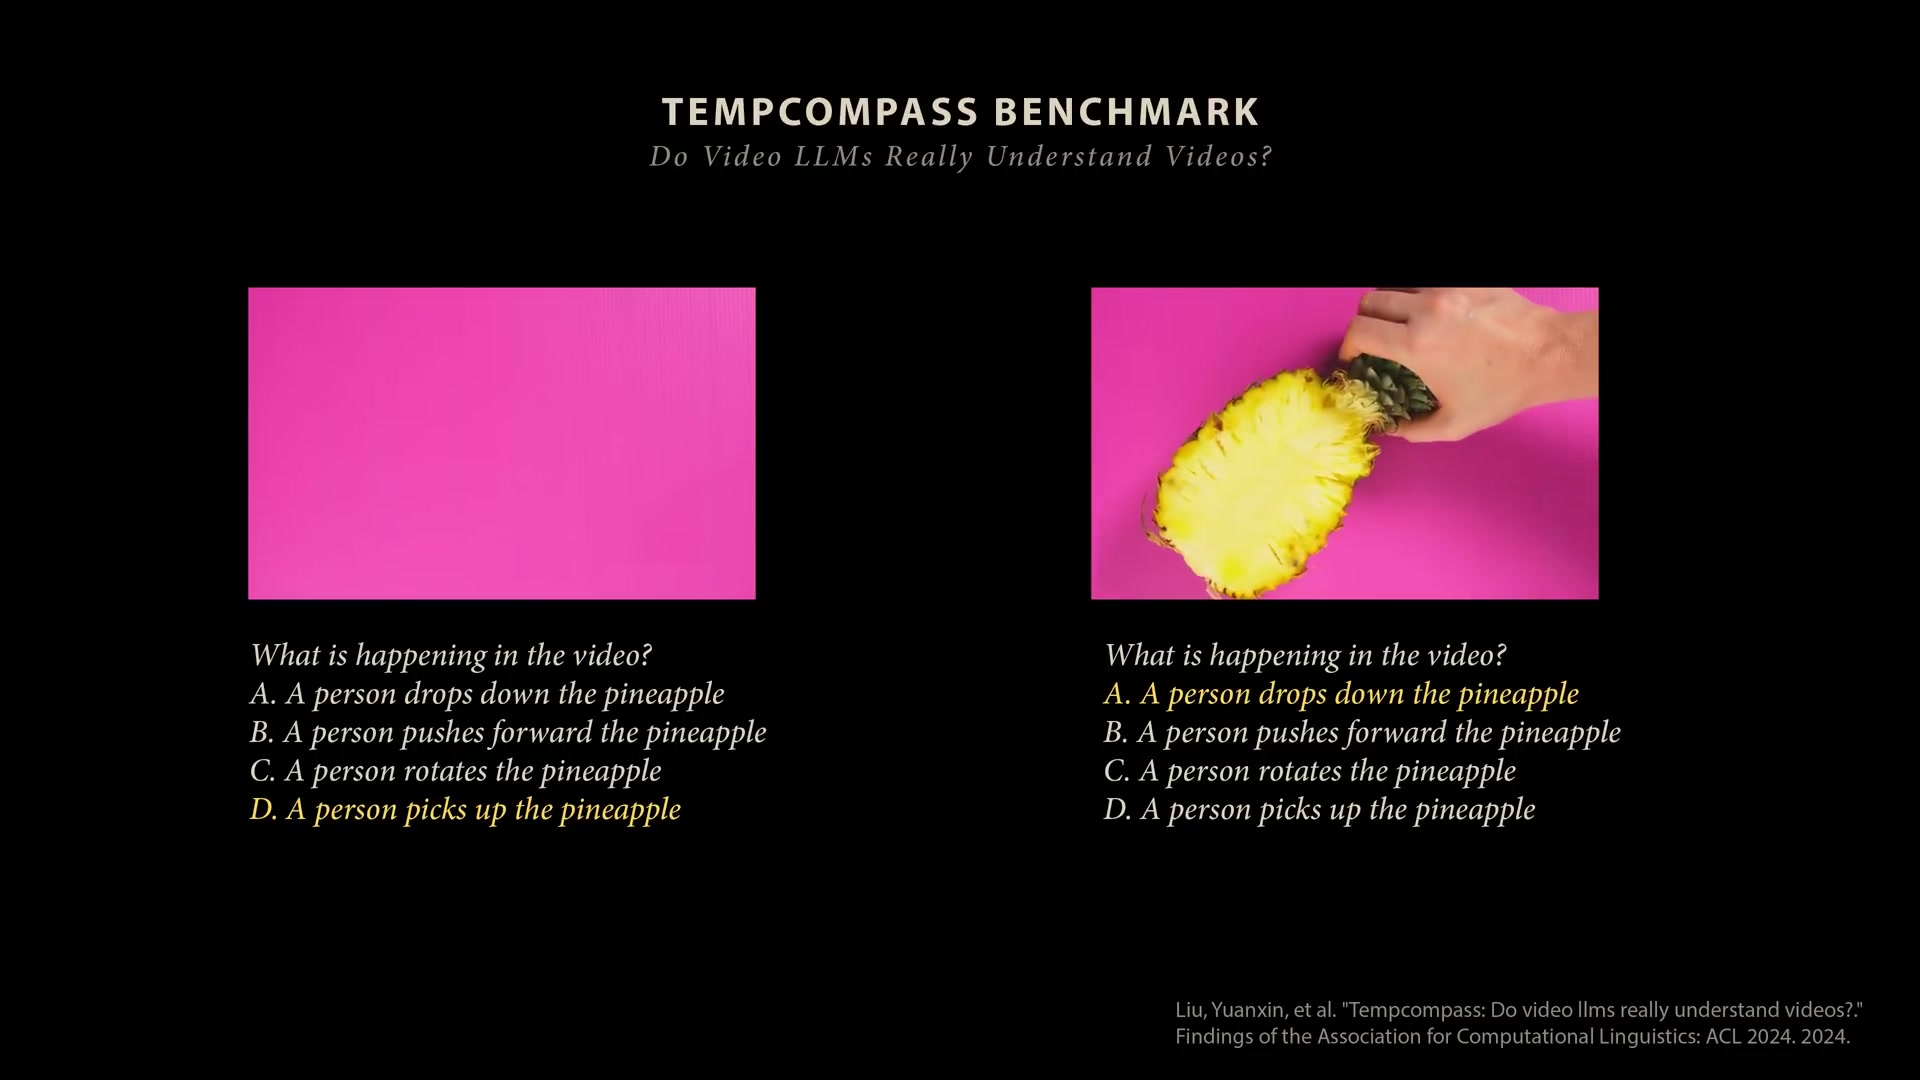
- 시간적 비디오 이해: Liu Yuanxin 외, “TempCompass: Do Video LLMs Really Understand Videos?”, ACL Findings 2024.
Final perspective
지금 앞선 모델과 오래 살아남을 구조는 같지 않을 수 있다
현재의 로봇 시연만 보면 VLA가 승자다. 월드 모델은 더 느리고, 더 단순한 과제에서, 더 짧은 미래만 예측한다. 그러나 LeCun이 거는 베팅은 장기적인 시스템 원리에 있다. 신뢰 가능한 에이전트라면 행동을 출력하는 것만으로는 부족하고, 행동이 세계를 어떻게 바꿀지 예측하며 여러 미래를 비교할 수 있어야 한다는 주장이다.
JEPA가 그 원리를 실제 규모에서 구현할지는 아직 알 수 없다. 인식 층의 성공은 고무적이지만 제어 층의 격차도 명백하다. 가장 정확한 결론은 승리 선언이 아니라 연구 의제다. 언어 밖의 세계를 학습하고, 긴 시간 규모에서 안정적으로 예측하며, 탐색 가능한 계획으로 연결할 수 있는가. 10억 달러의 베팅은 바로 그 질문에 걸려 있다.